
TL;DR
Meta hat Muse Wonder und Muse Wonder Full am 12. Oktober 2026 veröffentlicht. Wonder ist über die Meta Model API und Muse Code verfügbar, während Full in Muse Code über die Abonnements Power Usage und Maximum Usage verfügbar ist. Full führt auf mehreren veröffentlichten Benchmarks, aber die praktische Wahl hängt von API-Zugang, Aufgabenqualität und Kosten ab. Dieser Vergleich stützt sich auf veröffentlichte Quellen und beinhaltet keine unabhängigen Praxistests.
Key Takeaways
- Wonder unterstützt API-Integration; Full ist über die Muse Code Power Usage- und Maximum Usage-Abonnements verfügbar.
- Metas Launch-Diagramm meldet Artificial Analysis Intelligence Index-Werte von 52 für Wonder und 56 für Full. Der Vier-Punkte-Abstand stellt keine universelle prozentuale Leistungssteigerung bei Aufgaben dar.
- Wonder unterstützt ein Kontextfenster von 1.048.576 Token sowie Text-, Bild-, Audio-, Video- und PDF-Input mit Textausgabe.
- Die Standard-API-Preise von Meta betragen $4 Input, $0.20 zwischengespeicherter Input und $20 Output pro 1 Mio. Token; für Full gibt es keinen öffentlichen Model-API-Preis pro Token.
- Maximaler Reasoning-Aufwand wählt nicht Full aus. Beginnen Sie für Anwendungen mit Wonder; evaluieren Sie Full für anspruchsvolle interaktive Arbeit in Muse Code.
Muse Wonder vs Muse Wonder Full: Überblick und Spezifikationen
Beginnen Sie mit Wonder, wenn Sie ein aufrufbares Modell für ein Produkt oder einen automatisierten Workflow benötigen. Evaluieren Sie Full, wenn Sie Muse Code verwenden und seine Benchmark-Stärken für Ihre Aufgaben relevant sind. Der Zugriff erfordert ein Power Usage- oder Maximum Usage-Abonnement und unterliegt weiterhin den Planlimits. Der praktische Unterschied ist zuerst der Zugang, zweitens die Benchmark-Leistung.
| Decision factor | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Start testing with | Produktions-APIs, Custom Agents und Batch-Verarbeitung | Anspruchsvolle interaktive Programmierung und professionelle Arbeit in Muse Code |
| Provider access | Meta Model API und Muse Code | Muse Code Power Usage oder Maximum Usage |
| Public Meta API model ID | muse-wonder-1.0 | Keine öffentliche Model-API-Kennung |
| Context window | 1.048.576 Token | 1M Token bei Inferenz in der Model Card |
| Input and output | Text-, Bild-, Audio-, Video-, PDF-Input; Text-Output | Text-, Bild-, Audio-, Video-Input und Text-Output auf Model-Card-Ebene; Muse Code prüfen |
| Meta API input / cached input / output per 1M tokens | $4 / $0.20 / $20 | Kein öffentlicher Model-API-Preis pro Token |
| CometAPI access status | Verfügbar; Account-Route und Abrechnung bestätigen | Coming soon, Stand 16. Oktober 2026 |
| Primary selection criterion | Qualität akzeptierter Aufgaben, Zuverlässigkeit, Gesamtkosten pro Aufgabe | Qualität akzeptierter Aufgaben innerhalb des unterstützten Produkts und des Abo-Kontingents |
Die Tabelle fasst die unten diskutierten Spezifikationen, veröffentlichten Ergebnisse und kommerziellen Bedingungen zusammen. Modalitäten auf Modellebene garantieren keine identische Unterstützung an jedem Endpunkt. Das in der Model Card von Full angegebene Kontextlimit ist kein öffentliches API-Versprechen.
Beide Varianten zielen auf komplexe Programmierung sowie persönliche und professionelle agentische Arbeit ab. Die wichtigsten dokumentierten Unterschiede sind ihre veröffentlichten Leistungen und Zugriffsoptionen: Wonder ist über die Meta Model API und Muse Code verfügbar, während Full über berechtigte Muse Code-Abonnements verfügbar ist.
Muse Wonder für programmierbare Workflows
Meta hat die Muse Wonder-Modellfamilie als Frontier-AI-Systeme für persönliche und professionelle agentische Workflows vorgestellt, mit Schwerpunkt auf nachhaltigem Reasoning, Tool-Nutzung, Softwaretechnik und anspruchsvoller Wissensarbeit.
Muse Wonder ist das Standardmodell, zugänglich über Metas Model API und Muse Code. Es eignet sich für Entwickler, die Coding-Assistenten, Dokumentenanalyse, multimodale Systeme und langlaufende Agents entwerfen. Seine API-Schnittstelle ermöglicht direkte Arbeitslastmessung, nutzungsbasierte Abrechnung und Integration in Produktionssoftware.
Muse Wonder Full für anspruchsvolle interaktive Arbeit
Muse Wonder Full ist eine leistungsstärkere Variante, optimiert für besonders anspruchsvolle Workflows. Metas eigene Launch-Materialien verbinden es mit professioneller Analyse und langhorizontiger Programmierung. Beim Start ist der Zugriff an berechtigte Muse Code-Abonnements gebunden und nicht an eine separat bepreiste öffentliche API.
Die API-Spezifikation dokumentiert Wonder’s multimodale Inputs, das genaue Kontextlimit und Reasoning-Steuerungen. Full verfügt über eine familienweite Model-Card-Beschreibung, aber keinen gleichwertigen öffentlichen API-Vertrag. Geteilte Familienfunktionen begründen keine identischen Endpunktparameter oder Produkt-Upload-Limits.
Active Memory, Active Focus und Reasoning-Einstellungen
Meta beschreibt Active Memory und Active Focus als zwei Mechanismen, die nützlichen Kontext bewahren und zielgerichteten Fortschritt bei schwierigen Aufgaben erhalten sollen. Sie ersetzen nicht die Notwendigkeit von Verifizierung auf Anwendungsebene, Berechtigungen oder menschlicher Aufsicht.
Das Setzen von Wonder auf maximalen Reasoning-Aufwand macht es nicht zu Wonder Full. Der Unterschied ist ein Modellzugangsunterschied, nicht nur ein Schalter innerhalb einer Anfrage.
Muse Wonder vs Muse Wonder Full: Leistung
Veröffentlichte Benchmarks und Quellgrenzen
Wonder Full führt beim gemeldeten Kompositindex, aber Benchmark-Scores messen Leistung auf ausgewählten Evaluierungen, nicht eine universelle prozentuale Verbesserung. Vergleichen Sie dieselbe Benchmark-Version, Inferenz-Einstellungen und das Bewertungsdatum, bevor Sie Schlussfolgerungen für den Einsatz ziehen.
| Evaluation | Muse Wonder | Muse Wonder Full | Metric / reported setting |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52 | 56 | Kompositindex; Artificial Analysis; max effort |
| AutomationBench-AA | 39.1 | 45.4 | Strict pass@1; simulierte Geschäfts-Workflows; Artificial Analysis |
| SWE-Marathon | 53.1 | 57.5 | Pass@1; Projekttests; Abundant AI; Full bei xhigh |
| Terminal-Bench 4.0-AA | 52.0 | 57.1 | Accuracy; isolierte Terminal-Aufgaben mit ausführbarer Verifikation; Artificial Analysis |
| DeepSWE 1.1 | 78.8 | 79.0 | Pass@1; Funktions- und Regressionstests; Datacurve-Ergebnisse |
| MemoryBench | 85.6 | 85.5 | Interner Konversations-Memory-Benchmark; von einem LLM beurteilte Recall |
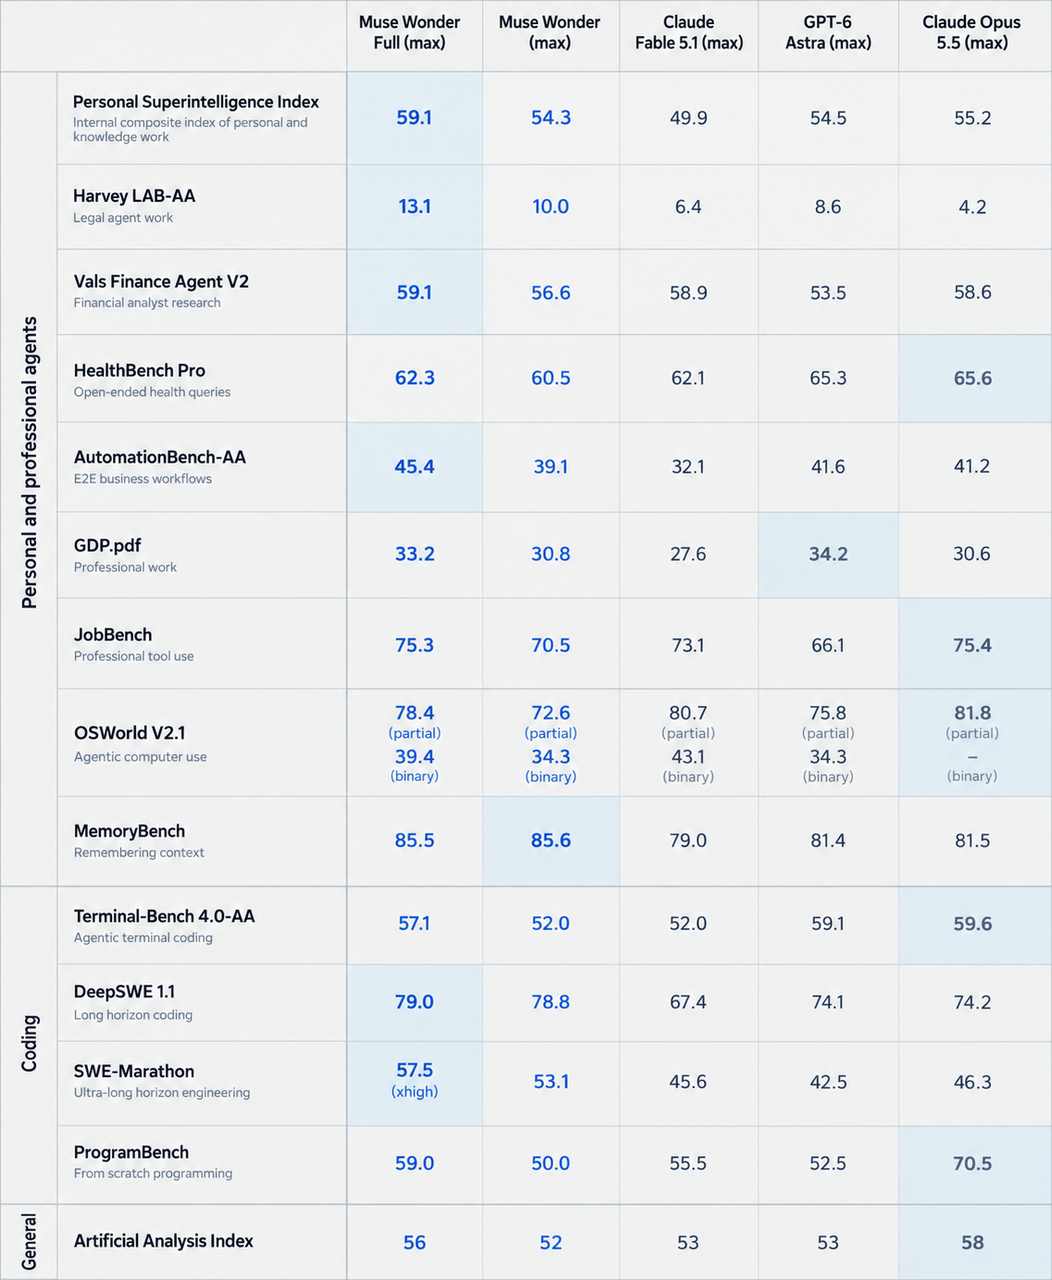
Offizielle Meta-Model-Card-Scorecard, ohne Neuzeichnung reproduziert. Die begleitende Methodik identifiziert Ergebnisquellen und Einstellungen.
Evaluationsbedingungen
Metas Evaluationsmethodik verwendet max Reasoning, sofern nicht anders angegeben. SWE-Marathon nutzt vom Anbieter berichtete Umgebungen statt eines gemeinsamen, kontrollierten Test-Harnesses über alle Modelle. Dies sind Drittanbieter-Ergebnisse, von Meta zusammengefasst; es handelt sich nicht um vier einheitlich kontrollierte interne Tests. Der Release-Snapshot ist der 12. Oktober 2026, kein Live-Leaderboard.
DeepSWE misst langhorizontige Repository-Arbeit mittels Funktions- und Regressionstests. MemoryBench misst Recall in 64K–100K-Token-Konversationen mit einem LLM-Richter. Diese Scores bewerten unterschiedliche Verhaltensweisen und verwenden verschiedene Bewertungssysteme. Die gemeldete 0,1-Punkte-Differenz bei MemoryBench ist zu klein, um ohne Informationen zur Bewertungsvariabilität eine praktische Rangfolge zu stützen.
Programmierung und Softwaretechnik
Full liegt bei den zitierten Coding-Ergebnissen vorn, aber die Lücke variiert: DeepSWE unterscheidet sich um 0,2 Punkte, SWE-Marathon um 4,4 und Terminal-Bench um 5,1. Dieses Muster unterstützt Tests von Full bei schwieriger, verlängerter Arbeit; es zeigt nicht, dass jede Code-Review oder kurze Implementierung Full benötigt. API-Verfügbarkeit bleibt eine separate Einsatzbeschränkung.
Memory und langlaufende Agents
Full führt nicht in jeder gemeldeten Messung. MemoryBench liegt bei 85,5 für Full und 85,6 für Wonder in der offiziellen Scorecard. Behandeln Sie dieses nahezu Unentschieden als Grund, tatsächliches Memory-Verhalten zu testen, einschließlich korrigierter Fakten, veralteter Anweisungen und Projektisolation. Evaluieren Sie Active Focus anhand von End-to-End-Abschluss und Erholung von Fehlversuchen statt anzunehmen, dass ein höherer Komposit-Score bessere Persistenz garantiert.
Latenz und Zuverlässigkeit
Die zitierten Materialien etablieren kein abgeglichenes Latenz-Ranking zwischen Wonder API und Full in Muse Code. Messen Sie Zeit bis zum nützlichen Output, mediane und 95. Perzentil-Aufgabendauer, Timeout-Häufigkeit, Wiederholungen und Abschluss ohne menschliches Eingreifen. Protokollieren Sie Tools, Reasoning-Einstellung, Laufzeit und Aufgabenlimits für jede Oberfläche, damit ein produktseitiger Vergleich nicht als reines Modell-Experiment präsentiert wird.
Muse Wonder vs Muse Wonder Full: Kosten
Offizielle API-Preise und Abonnement-Einheiten
Meta veröffentlicht Standard-Wonder-API-Preise von $4 Input, $0.20 zwischengespeicherter Input und $20 Output pro 1 Mio. Token. Full verwendet ein Abonnement-Zugangsmodell, daher ist dieselbe Token-Preis-Kalkulation nicht anwendbar.
Metas Power Usage- und Maximum Usage-Pläne beinhalten sowohl Wonder als auch Full in Muse Code. Leistungen und Verfügbarkeit können je nach Region variieren, daher prüfen Sie das aktuelle Angebot und die Kontingente vor der Budgetierung. Diese Abonnements bieten begrenzte interaktive Nutzung; sie beinhalten keine unbegrenzten Produktions-API-Aufrufe.
Token-Kostenbeispiel: 100.000 nicht zwischengespeicherte Eingabe-Token kosten $0.40, und 20.000 Ausgabe-Token kosten $0.40, insgesamt also $0.80. Ein mehrstufiger Agent-Run kann zusätzliche Token-Nutzung über Anfragen hinweg verursachen, plus Tool-Gebühren.
Meta listet Websuche-Grounding mit $2.50 pro 1.000 Suchanfragen, zusätzlich zu Token-Gebühren.
CometAPI-Abrechnungsbedingungen
Muse Wonder ist über CometAPI verfügbar, mit account-spezifischer, route-basierter Preisgestaltung. Bestätigen Sie Input-, Output-, zwischengespeicherte Input- und andere Abrechnungsbedingungen gesondert von Metas Listenpreisen, bevor Sie Produktionsverkehr senden. Stand 16. Oktober 2026 ist Wonder Full als Coming soon markiert, diese Angabe ist weder eine verfügbare API-Route noch ein Preisangebot oder eine Release-Zusage.
Kosten pro akzeptierter Aufgabe
Definieren Sie ein abgenommenes Deliverable, bevor Sie Kosten messen. Teilen Sie die insgesamt abgerechneten Modell- und Tool-Ausgaben, einschließlich berechneter Wiederholungen und Fallbacks, durch die abgenommenen Ergebnisse. Erfassen Sie Review-Arbeit separat oder wenden Sie einen expliziten Stundensatz an. Für Full erfassen Sie außerdem die nützliche Arbeit innerhalb des Abo-Kontingents. Monatsgebühren und Token-Preise sind unterschiedliche Einheiten, daher lässt sich aus ihren Schlagwortpreisen allein nicht der günstigere Workflow ableiten.
Muse Wonder vs Muse Wonder Full: Vergleich und Auswahl
Fähigkeits- und arbeitslastbasierte Auswahl
Wählen Sie Muse Wonder für Produktions-API-Integration, Batch-Dokumentenverarbeitung, Custom Agents und reproduzierbare A/B-Tests. Seine aufrufbare API und nutzungsbasierte Abrechnung ermöglichen Automatisierung von Workflows, Inspektion von Tool-Verhalten, Regressionstests und Messung der Kosten pro abgenommenem Ergebnis. Beginnen Sie hier, wenn Einsatzkontrolle und Wiederholbarkeit zentrale Anforderungen sind.
Wählen Sie Muse Wonder Full für komplexe interaktive Refactorings und professionelle Analysen in Muse Code, sofern Sie ein berechtigtes Abonnement haben. Seine gemeldeten Benchmark-Stärken machen es zu einem Kandidaten für schwierige, längere Aufgaben; testen Sie, ob es Korrekturen und Review-Zeit bei Ihrer Arbeit reduziert, und bestätigen Sie, dass das Abo-Kontingent zu Ihrer Arbeitslast passt.
Anwendungs- und Automations-Workflows
Muse Wonder ist eine sinnvolle Wahl für Repository-Q&A, skriptgesteuerte Code-Reviews, Dokumentenextraktion, Retrieval-basierte Assistenten und Custom Agents. Sein API-Zugang ermöglicht Teams, Latenz zu überwachen, Tool-Verhalten zu tracen, Regressionen zu automatisieren und Kostenobergrenzen festzulegen.
Für einen Service oder eine Batch-Pipeline evaluieren Sie zuerst die unterstützte Wonder-API-Route. Sie gibt der Anwendung explizite Kontrolle über Anfragen, Tool-Ausführung, Wiederholungen und Metering. Wenn die Aufgabe von Funktionen abhängt, die nur in Muse Code verfügbar sind, evaluieren Sie sie als separaten interaktiven Workflow mit eigenen Betriebsbeschränkungen.
Interaktive Programmierung und professionelle Analyse
Full lohnt sich für lange Coding-Sitzungen, Refactoring mehrerer Dateien und komplexe professionelle Analysen in Muse Code, angesichts höherer Scores auf mehreren veröffentlichten Benchmarks. Zugangsbeschränkungen bedeuten, dass diese Vorteile nicht automatisch auf Produktions-API-Anwendungen übertragbar sind.
Verwenden Sie repräsentative Refactorings, Untersuchungen und fertige Artefakte, um zu testen, ob Full Korrekturschleifen oder Review-Aufwand reduziert. Bestätigen Sie das tatsächliche Abo-Kontingent, bevor Sie es zur Abhängigkeit für wiederkehrende Arbeit machen. Ist die Verbesserung bei Ihren Aufgaben gering, erfüllt die Standardvariante möglicherweise bereits die Akzeptanzschwelle.
Kriterien für Produktionsevaluierung
Sammeln Sie für eine praktische Evaluierung mindestens drei Belegarten: End-to-End-Aufgabenerfüllung, Qualität des fertigen Artefakts und gesamter Aufwand einschließlich Wiederholungen und menschlicher Review. Ein vier Punkte höherer Komposit-Score kann für einen komplexen Agenten relevant sein, während er bei einer einfachen Klassifikationsaufgabe kaum sichtbare Unterschiede erzeugt.
Wo können Sie Muse Wonder und Muse Wonder Full nutzen?
Offizieller Provider-Zugang
Verwenden Sie die Meta Model API für das Standard-Wonder oder greifen Sie in Muse Code darauf zu. Full erfordert ein berechtigtes Muse Code-Abonnement; das Setzen des Standardmodells auf max effort ändert nicht die gewählte Variante. Bestätigen Sie die genaue Account-Berechtigung, unterstützte Anfragefunktionen und Nutzungslimits vor dem Testen.
Die CometAPI-Integration ist getrennt vom Zugriff auf Wonder Full über Muse Code. Ein Muse Code-Abonnement sollte nicht als wiederverwendbare Produktions-API-Berechtigung oder unbegrenzter Durchsatz angenommen werden.
CometAPI-Zugang
Entwickler können die Muse Wonder API in CometAPI nutzen. Die Muse Wonder Full API in CometAPI ist Stand 16. Oktober 2026 als Coming soon gekennzeichnet; dieser Status stellt weder ein Launch-Datum noch einen aufrufbaren Endpunkt dar. Bestätigen Sie Account-Preise und unterstützte Felder vor dem Einsatz.
Für CometAPI-Anfragen verwenden Sie die für Ihre gewählte Route dokumentierte Modellkennung. Prüfen Sie vor einem mehrstufigen Job die unterstützten Nachrichtenformate, Tool-Semantik und Zustandsbehandlung. Bewahren Sie validierten Task-Status in der Anwendung, damit eine Routing-Änderung nicht still Informationen verwirft, die zum Abschluss der Arbeit notwendig sind.
Conclusion
Muse Wonder und Muse Wonder Full sind eng verwandt, aber kommerziell und operativ unterschiedlich. Wonder bietet eine dokumentierte, multimodale, langkontextige API für den Aufbau von Anwendungen; Full bietet stärkere gemeldete Leistung, aber engeren interaktiven Zugang. Behandeln Sie den Komposit-Score als nützliches Indiz, nicht als universelle Entscheidungsregel. Testen Sie die Version, die Sie tatsächlich bereitstellen können, anhand Ihrer eigenen Aufgaben, Randbedingungen, Latenz und Kosten.
FAQ
Wie sollten Teams die Muse Wonder API mit Full in Muse Code vergleichen?
Verwenden Sie denselben Repository-Snapshot, Aufgabenanweisungen, Abnahmetests und Bewertungsrubrik. Protokollieren Sie für jede Oberfläche Tool-Zugriff, Reasoning-Einstellung, verstrichene Zeit, Wiederholungen und menschliche Intervention. Behandeln Sie das Ergebnis als Workflow-Vergleich: Die API-Agenten und Muse Code können unterschiedliche Tools und Ausführungsschleifen bereitstellen, daher kann ein Qualitätsunterschied nicht automatisch allein den Modellgewichten zugeschrieben werden.
Was passiert, wenn ein Muse Wonder Full-Abonnement sein Limit erreicht?
Metas Aboregeln verlangen nach Erreichen eines Limits ein Upgrade oder das Warten auf eine Auffrischung; Maximum Usage-Abonnenten müssen auf das Reset warten. Zusätzliche API-Keys werden separat im Pay-as-you-go-Modell abgerechnet, und Full wird nicht über die öffentliche Model API angeboten. Planen Sie interaktive Arbeit entsprechend dem tatsächlichen Kontingent des Accounts, statt anzunehmen, ein Abonnement biete unbegrenzten Durchsatz.
Kann die Muse Wonder API Geschäftsdatensätze über unabhängige Anfragen hinweg persistieren?
Verwenden Sie keine familienweite Memory-Funktion als Ersatz für einen Anwendungsdatenspeicher. Wenn eine Aufgabe dauerhafte Datensätze benötigt, bewahren Sie diese explizit, rufen Sie relevantes Material ab und übergeben Sie es über die unterstützte Schnittstelle. Testen Sie Isolation, Aufbewahrung und Abrufverhalten auf der tatsächlichen Provider-Route; die Kontextkapazität des Modells allein begründet keine Persistenz über Anfragen hinweg.
Wie sollten Teams die Kosten einer Muse Wonder-Agentenaufgabe schätzen?
Messen Sie Input-, zwischengespeicherten Input- und Output-Verbrauch über den gesamten Tool-Loop, einschließlich Fehlversuchen und Wiederholungen. Fügen Sie Tool-Gebühren und menschliche Review-Zeit hinzu und vergleichen Sie die Kosten pro abgenommenem Ergebnis. Bei Full erfassen Sie erledigte Arbeit und aufgewendete Zeit gegenüber dem Abo-Kontingent. Token-Preise und monatliche Abogebühren beschreiben unterschiedliche Einkaufseinheiten, daher identifiziert keiner allein den günstigeren Workflow.