
TL;DR OpenAI Bel ist ein unbestätigter interner Vortrainingslauf (Codename), der am 25. August 2026 erstmals von @synthwavedd auf X berichtet wurde. Die Behauptung beschreibt ein fertig trainiertes Basismodell mit mehr als 10 Billionen Gesamtparametern—Nachfolger eines früheren Laufs namens Doug—gedacht als Fundament für Systeme nach GPT-6 und potenziell ein „AGI-Schwellen“-Modell nach weiterem Reinforcement Learning.
Stand: 13. Oktober 2026 hat OpenAI den Namen Bel (oder Doug in öffentlichen Produktmaterialien) nie verwendet, keine Parameterzahl, kein Veröffentlichungsdatum, keine Benchmarks oder eine Systemkarte publiziert, und Bel ist weder über die API noch in ChatGPT verfügbar.
Wichtigste Erkenntnisse
- Bel geht auf einen einzelnen X-Post von @synthwavedd vom 25. August 2026 zurück; OpenAI hat ihn nie bestätigt.
- Behauptete Skalierung: >10 Billionen Gesamtparameter, laut Originalpost ähnlich der Größenklasse von GPT-4.5.
- In der Gerüchtelage als Nachfolger von „Doug“ positioniert und als Basis für Systeme nach GPT-6 / Astra nach RL.
- GPT-6 Astra ist seit Anfang September 2026 öffentlich verfügbar und OpenAIs aktuelles Flaggschiff.
- Es gibt keine unabhängigen Benchmarks, kein Veröffentlichungsdatum, keine API, keine Preise oder Gewichte für Bel.
- Claude Fable 5.5 bleibt unangekündigt; das aktuelle High-End-Claude ist Fable 5.1.
- Für den Produktionseinsatz heute: GPT-6 Astra / Sol / Luna und Claude-Modelle über einen Schlüssel auf CometAPI routen—geringere Kosten und kein Vendor-Lock-in.
Was ist OpenAI Bel?
OpenAI Bel (manchmal als „BEL“ geschrieben) ist der Codename, der in Diskussionen der KI-Community für einen angeblichen großskaligen Vortrainingslauf kursiert, den OpenAI angeblich in der zweiten Augusthälfte 2026 abgeschlossen hat. Dem ursprünglichen Bericht zufolge ist Bel ein rohes Foundation Model—kein fertiges Produkt—mit mehr als 10 Billionen Gesamtparametern. Es wird als Nachfolger eines früheren internen Projekts namens Doug gerahmt und als die vorgesehene Basis, die nach zusätzlichem Reinforcement Learning und Post-Training Systeme jenseits von GPT-6 Astra antreiben könnte und potenziell ein Leistungsniveau an der „AGI-Schwelle“ erreicht.
Wichtig: Bel ist nicht GPT-7, kein ChatGPT-Modell, mit dem Nutzer sprechen können, und nichts, was über die OpenAI API verfügbar ist. Es wird strikt als Pretraining-Artefakt beschrieben—das enorme neuronale Netz, das auf Text (und möglicherweise anderen Daten) trainiert wurde und noch umfangreiches Finetuning, Alignment und Safety-Arbeit benötigt, bevor es zu einem auslieferbaren Produkt wird.
Bel ist der angebliche Codename einer Foundation-Model-Initiative von OpenAI. Die Behauptung wird @synthwavedds Beitrag vom 25. August 2026 über einen abgeschlossenen Pretraining-Run zugeschrieben. Der reproduzierte Post behauptet mehr als 10 Billionen Gesamtparameter und ein Nachfolgerverhältnis zu Doug. Diese Details bleiben Einquellen-Aussagen: Der Screenshot dokumentiert eine Behauptung, kein verifiziertes OpenAI-Trainingsergebnis.
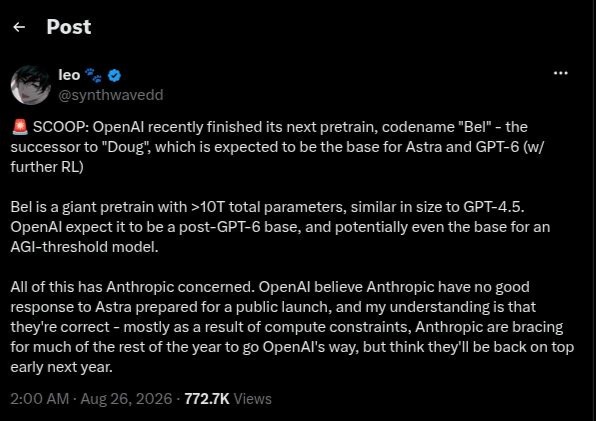
Der Screenshot ist eine Reproduktion aus Mukhtadas Erfassung des zugeschriebenen X-Posts. Er zeigt in der Jakarta-Zeit des Autors den 26. August um 2:00 Uhr, entsprechend dem 25. August um 19:00 UTC. Es handelt sich um eine Erfassung durch Dritte, nicht um eine unabhängige Bestätigung der Parameterzahl, des Trainingsstatus oder privater wettbewerblicher Behauptungen.
Die Doug–Bel-Indizien-Timeline
Der Doug-Hintergrund ist separat: SemiAnalysis’ Veröffentlichung vom 7. August reproduziert eine Notiz vom 9. Juli, in der ein größeres OpenAI-Modell namens Doug erwähnt wird. Dies liegt vor dem Bel-Post, authentifiziert jedoch weder Doug → Bel noch verbindet es einen der Codenamen mit einem veröffentlichten Produkt.
- 9. Juli 2026: Eine Forschungsnotiz, die ein größeres OpenAI-Modell namens Doug erwähnt, wurde später in dem am 7. August veröffentlichten SemiAnalysis-Artikel reproduziert. Notizdatum und Veröffentlichungsdatum sind unterschiedliche Meilensteine; dies ist Hintergrund zu Doug, keine Bestätigung von Bel.
- 7. August 2026: SemiAnalysis veröffentlichte den Artikel mit der Doug-Referenz. Er liegt vor der Bel-Behauptung, etabliert jedoch keine Doug-zu-Bel-Abstammung oder einen öffentlichen Produktnamen.
- 25. August 2026: Der zugeschriebene Post von @synthwavedd behauptete abgeschlossenes Bel-Pretraining und mehr als 10 Billionen Gesamtparameter. Eine Erfassung durch Dritte reproduziert die Behauptung; sie ist keine unabhängige Verifikation.
- 1. September 2026: Der in diesem Artikel zitierte „Path to Astra“-Bericht liefert Hintergrund zu einem separaten Modellentwicklungsprogramm. Er stellt weder die Identität von Bel, noch dessen Parameterzahl, noch eine Verbindung zu GPT-7 oder einer möglichen Bezeichnung GPT-6 Bel her.
- 23. September 2026: Eine kursierende Darstellung schreibt einem Folgepost desselben Accounts eine Wartezeit von Monaten zu. Da der Originaltext in der Quellprüfung nicht direkt zugänglich war, bleibt dies unbestätigte Timing-Orientierung und enthält keine Launch-Zusage.
- 12. Oktober 2026 — Artikel-Review-Checkpoint: Der zugeschriebene Bel-Post, die Doug-Berichterstattung und der separate offizielle Bericht belegen keine kommerzielle Identität für Bel. Weder GPT-7 noch GPT-6 Bel sind durch diese Indizienkette bestätigt; dieses Datum dokumentiert das Artikel-Review, nicht eine Modellankündigung.
Im gleichen Zeitraum diskutierte OpenAI öffentlich ein unbenanntes internes Modell, das „deutlich leistungsfähiger als GPT-6 Astra“ sei, im Zusammenhang mit mathematischer Arbeit (einschließlich Ergebnissen zu Navier-Stokes-Gleichungen).
Zwei Namenshypothesen: GPT-7 oder GPT-6 Bel?
Pretraining und Produkteinführung sind unterschiedliche Meilensteine. Ein Foundation-Checkpoint kann weiterhin Instruction Tuning, Reinforcement Learning, Safety-Evaluierung, Tool-Use-Training und Bereitstellungsoptimierung erfordern. Aus einem Foundation Model können mehrere Produkte hervorgehen, und eine öffentliche Versionsnummer identifiziert keinen Trainingslauf. OpenAIs „Path to Astra“-Bericht liefert offiziellen Hintergrund zum Reinforcement Learning, ohne die Identität von Bel festzulegen.
Hypothese 1 — GPT-7: Wenn Bel ein materiell neues Fundament jenseits der GPT-6-Generation darstellt, könnte OpenAI ein daraus abgeleitetes Modell als GPT-7 kommerzialisieren. Diese Interpretation hängt von einer neuen Generation von Fähigkeiten und einer öffentlichen Namensentscheidung ab; weder die behauptete Parameterzahl noch der gemeldete Abschluss des Pretrainings belegen dieses Ergebnis.
Hypothese 2 — GPT-6 Bel: OpenAI könnte ein Bel-abgeleitetes Produkt stattdessen in der GPT-6-Familie belassen, möglicherweise mit einer Bezeichnung wie GPT-6 Bel für ein aufgerüstetes oder spezialisiertes Angebot. Dies ist ein redaktionelles Benennungsszenario zum Vergleich, kein angekündigtes Produkt oder separat belegter Leak. Ein interner Codename muss nicht im kommerziellen Namen erscheinen.
Was ungeklärt bleibt: Derselbe Trainingsaufwand könnte mehrere Produkte, einen anderen Namen oder gar keine öffentliche Veröffentlichung unterstützen. Eine Bestätigung würde Dokumentation erfordern, die den Bel-Trainingsaufwand mit einem tatsächlichen öffentlichen Modell und seinem Namen verbindet.
OpenAI Bel im Vergleich zur vorherigen Generation: Was verbessert sich?
Da konkrete technische Details zu Bel fehlen, muss jede Verbesserungserörterung auf (1) den hochrangigen Behauptungen des Leaks, (2) der bekannten Entwicklungslinie von GPT-4o → GPT-5.x → GPT-6 Astra und (3) den Fähigkeiten des unbenannten internen Modells für Arbeiten im Maßstab der Navier-Stokes-Gleichungen beruhen. Jede potenzielle Verbesserungsdimension wird nachfolgend separat betrachtet.
Skalierung und Pretraining-Compute
Die zentrale Behauptung ist ein Sprung über frühere interne Läufe in den >10-Billionen-Parameter-Bereich. Trifft dies zu, entspräche es einer fortgesetzten Befolgung der Skalierungsgesetze bei Daten, Parametern und Compute. Bestätigt: OpenAI setzt große Trainingsläufe fort und hat öffentlich auf Modelle verwiesen, die leistungsfähiger als Astra sind. Nicht bestätigt: konkrete Parameterzahl, Trainings-FLOPs, Datenmischung oder Architekturänderungen (dicht vs. Mixture-of-Experts, neuartige Attention usw.). Realistische Erwartung auf Basis der Historie: bessere Sample-Effizienz und breitere Wissensabdeckung, aber abnehmende Grenzerträge ohne entsprechende Fortschritte im Post-Training und in der Datenqualität.
Post-Training und Alignment für langhorizontiges agentisches Verhalten
GPT-6 Astra hat mehrstufige Workflows, Computer-Nutzung und das Einhalten von Aufgabenrahmen bereits deutlich verbessert. Eine stärkere Basis plus weiteres RL könnte verlässliches agentisches Operieren von Stunden in Richtung mehrtägiger oder mehrwöchiger Horizonte mit weniger menschlicher Steuerung verschieben. Das Multi-Agent-Experiment zu Navier-Stokes (Tausende koordinierender Agenten) zeigt, dass OpenAI bereits in großem Agentenschwarm-Maßstab an schwierigen Problemen arbeitet. Bestätigte Fähigkeitsrichtung: ja. Spezifischer Bel-Beitrag: unbestätigt.
Wissenschaftliches und mathematisches Schlussfolgern
Astra selbst hat zur mathematischen Forschung beigetragen; das stärkere interne Modell erzielte ein formalisiertes Ergebnis zu einem Millennium-Preisproblem. Eine größere, besser trainierte Basis könnte die Zeit und Kosten zur Exploration schwieriger MINT-Suchräume weiter komprimieren. Bestätigt: OpenAI investiert hier stark. Bel-spezifisch: nicht bestätigt.
Computer-Nutzung, Tool-Nutzung und multimodale Zuverlässigkeit
Astra setzte neue Maßstäbe bei Computer- und Browser-Nutzung. Künftige Basen dürften Fehlerraten auf langen Trajektorien senken, visuelle Verankerung verbessern und komplexere Softwareumgebungen handhaben. Spekulativ, aber der Produkt-Roadmap entsprechend.
Effizienz, Inferenzgeschwindigkeit und Kosten
Selbst wenn die Basis größer ist, könnten Distillation, bessere Architekturen und eigenes Silizium (OpenAI hat eigene ASICs diskutiert) dennoch ein gutes Kosten-/Leistungsverhältnis liefern. Es existieren keine spezifischen Effizienzangaben zu Bel.
Wann könnten OpenAI Bel oder GPT-7 veröffentlicht werden?
Für Bel oder ein Bel-abgeleitetes GPT-7 ist in den geprüften Quellen kein offizielles Launch-Datum belegt. Eine kursierende Darstellung eines Folgeposts von @synthwavedd vom 23. September, der eine Wartezeit von Monaten beschreibt, stammt aus derselben inoffiziellen Quelle wie der ursprüngliche Leak. Sein Volltext war während dieser Prüfung nicht direkt zugänglich und sollte daher nicht zur Terminprognose herangezogen werden. Abgeschlossenes Pretraining, wenn zutreffend, könnte weiterhin von Post-Training, Evaluierungen, Bereitstellungsarbeit und gestufter Einführung gefolgt sein.
| Szenario | Was würde passieren | Was es impliziert |
|---|---|---|
| Schnellere Fertigstellung | Verbleibende Evaluierungen und Bereitstellung gelingen relativ zügig | Ein Nachfolger könnte früher erscheinen |
| Verlängerte Entwicklung | Mehr Training, Mitigation und Bereitstellungsarbeit sind erforderlich | Der Zeitplan verschiebt sich weiter nach hinten |
| Alternative Einführung | Foundation treibt spezialisierte oder anders gebrandete Systeme an | Kein Produkt zwingend namens Bel |
Das hypothetische Fable 5.5 hat in den geprüften Quellen keinen verifizierten Zeitplan, daher ist eine Vorhersage zur Veröffentlichungsreihenfolge nicht belastbar.
Könnte Bel das Kräfteverhältnis zwischen OpenAI und Anthropic verschieben?
Drei plausible Ergebnisse bleiben offen. Erstens könnte Bel einen breiten Pretraining-Sprung einführen und nachgelagerte Coding- und Reasoning-Systeme verbessern. Zweitens könnte der Vorteil schmal sein, wobei andere Anbieter weiterhin bei Agenten-Zuverlässigkeit, Latenz oder Kosten gewinnen. Drittens könnte der enorme berichtete Maßstab nicht in proportional praktische Zugewinne übersetzen. Bis reproduzierbare Evidenz vorliegt, ist die richtige Einordnung eine mögliche kompetitive Reaktion statt eines erklärten Sieges.
Praktische Empfehlungen für Entwickler und Teams (CometAPI)
Während die Branche auf eine offizielle Bestätigung von Bel oder das nächste große OpenAI-Basemodell wartet, benötigen Produktionssysteme verlässlichen Zugriff auf die Modelle, die heute tatsächlich existieren. CometAPI bietet einen einzelnen, OpenAI-kompatiblen Endpoint (https://api.cometapi.com/v1) und einen API-Schlüssel, der über 500 Modelle erreicht, einschließlich der gesamten aktuellen GPT-6-Familie (Astra, Sol, Luna und Updates) sowie Anthrophics Claude-Reihe (Fable 5.1, Opus 5.5, Sonnet 5.5 usw.).
Fazit
Die KI-Frontier bewegt sich weiterhin schnell. Bel könnte sich letztlich als wichtiger interner Meilenstein, als fehlberichter Codenamen oder als etwas dazwischen erweisen. Bis OpenAI konkrete Informationen veröffentlicht, ist es verantwortungsvoll, die Behauptungen als unbestätigt zu behandeln, während man maximalen Nutzen aus bereits verfügbaren Modellen zieht—und die Infrastruktur flexibel hält, um die nächste Generation sofort zu integrieren, sobald sie real wird. Für viele Teams lässt sich diese Flexibilität heute am einfachsten über eine einheitliche Plattform wie CometAPI erreichen.