
Kurzfassung
OpenAI Decisions API und TypeSafe Jev liefern abgegrenzte, probabilitätsgestützte Entscheidungen statt gewöhnlicher generierter Prosa. OpenAI nutzt GPT-6 Luna über einen dedizierten Endpunkt; TypeSafe Jev ist ein spezialisiertes System-One-Modell. Jev ist bei den veröffentlichten Input-Token-Preisen günstiger ($0.042 gegenüber $0.10 pro Million), während OpenAI native Bildunterstützung bietet. Die hier überprüften Anbieterangaben etablieren keinen Kopf-an-Kopf-Sieger bei Genauigkeit oder Geschwindigkeit.
Wichtigste Punkte
- Preisgestaltung: Jev ist pro Input-Token bei den veröffentlichten Basispreisen um 58% günstiger.
- Architektur: OpenAI Decisions API verwendet GPT-6 Luna; Jev ist für Entscheidungsverarbeitung zweckgebaut.
- Modalität: OpenAI unterstützt Text und Bilder; Jev konzentriert sich auf Text und strukturierte Eingaben.
- Benchmarks: Anbieter-Geschwindigkeitsangaben nutzen unterschiedliche Baselines; auf demselben gelabelten Datensatz vergleichen.
- Auswahl: Je nach Anwendung Multimodalität und OpenAI-Integration priorisieren oder text-only Durchsatz und Kosten.
Auf einen Blick: OpenAI Decisions API vs Jev
Die folgende Übersicht vergleicht die dokumentierten Decision-Endpunkte und veröffentlichten Basispreise, geprüft am 12. Oktober 2026. Modellzugang, Limits und Servicebedingungen sollten für das Einsatzkonto verifiziert werden.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (Bedingungswahrscheinlichkeit), choice (Kategorie), score (Rubrik) | Noul (Bedingungswahrscheinlichkeit), choice (Kategorie), score (Stufen) |
| Request questions | Array mit Namen | Objekt mit ID-Schlüsseln |
| Context limit | In der verlinkten Decisions-Anleitung nicht spezifiziert | 64K gesamt; state + längste Frage ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | Keine Kosten | Keine Kosten |
| Vendor speed statement | Etwa 10× schneller als Responses API | 70–500 ms End-to-End |
| Availability | Öffentliche Beta | Early Access in der Launch-Ankündigung; aktuellen Kontozugang prüfen |
| Distinct advantage | Bildbasierte Entscheidungen | Niedriger veröffentlichter Input-Preis |
| Generative reasoning / coding | Nicht das Ausgabeverhalten dieses Endpunkts | Nicht das Ausgabeverhalten dieses Endpunkts |
Viele KI-Workflows benötigen eine Kategorie, Wahrscheinlichkeit oder Punktzahl – keinen Absatz. Ein Support-Ticket muss geroutet werden; ein Agent soll eine freigegebene Aktion auswählen; eine Review-Pipeline muss unsichere Eingaben identifizieren. Beide Produkte machen solche Entscheidungen zu erstklassigen API-Ausgaben.
OpenAI veröffentlichte die Decisions API am 6. Oktober 2026 als Beta. Ihr GPT-6-Luna-Endpunkt akzeptiert Text und Bilder. Jev ist TypeSafe AIs spezialisiertes System-One-Modell für nicht-generative Evaluation mit einer Trainingsmethodik, beschrieben als Reinforcement Learning für kalibrierte Entscheidungen (RLCD).
Die Fragetypen in der Tabelle decken drei gemeinsame Aufgaben ab. OpenAIs predicate und Jevs noul schätzen, ob eine Bedingung zutrifft, etwa Rückerstattungsabsicht oder Berechtigung. Choice wählt aus vordefinierten Kategorien, etwa Billing, Technical und Shipping, für das Routing. Score bewertet eine Eingabe gegen eine Rubrik bzw. Stufen, etwa Dringlichkeit oder Priorität. Diese Beschreibungen konsolidieren die beiden Produktüberblicke; die Request-Schemata und Probability-Semantik erfordern weiterhin providerspezifische Behandlung.
Was sind OpenAI Decisions API und Jev?
OpenAI Decisions API und TypeSafe Jev sind entscheidungsfokussierte KI-Dienste, die Eingabedaten in strukturierte, abgegrenzte Outputs statt in frei formulierten Text transformieren. Anders als traditionelle große Sprachmodelle, die Erklärungen oder konversationelle Antworten generieren, evaluieren diese APIs vordefinierte Fragen und liefern Entscheidungen, Wahrscheinlichkeiten oder Punktwerte. Das macht sie besonders nützlich für automatisierte Workflows wie Kundenanfragen-Routing, Inhaltsklassifikation, Risikoabschätzung und Toolauswahl durch KI-Agenten, bei denen vorhersehbare Outputs und effiziente Verarbeitung entscheidend sind.
OpenAI Decisions API wird von GPT-6 Luna betrieben und arbeitet über den Endpunkt /v1/decisions. Sie unterstützt Text- und Bild-Eingaben mit drei Entscheidungstypen: predicate, choice und score. Ihr Hauptvorteil ist die Kombination des kontextuellen Verständnisses eines Allzweck-KI-Modells mit einer dedizierten Decision-Schnittstelle, was sie für multimodale Klassifikation und Anwendungen innerhalb des OpenAI-Ökosystems geeignet macht.
TypeSafe Jev hingegen ist ein spezialisiertes Decision-Modell, das über den Endpunkt /v1/systemone erreichbar ist. Es konzentriert sich auf textbasierte Evaluation mit drei Fragetypen: noul, choice und score. Jev setzt auf effiziente Inferenz, strukturierte Vorhersagen und Kalibrierung von Wahrscheinlichkeiten und ist damit attraktiv für großvolumige Klassifikation und automatisierte Entscheidungs-Pipelines. Obwohl beide Dienste ähnliche Probleme adressieren, können ihre Unterschiede in Architektur, Eingabefähigkeiten, Preisgestaltung und API-Design erheblichen Einfluss darauf haben, welcher Dienst für eine bestimmte Anwendung besser geeignet ist.
Modellansatz, Eingabelimits und Umfang
Der Vergleich betrifft dokumentiertes API-Verhalten und Produktpositionierung. OpenAI stellt GPT-6 Luna über einen Decision-Endpunkt bereit, während TypeSafe Jev als spezialisiertes System-One-Modell positioniert. Diese Beschreibungen allein begründen keinen Genauigkeitsvorteil und offenbaren nicht alle Implementierungsdetails.
Jev erlaubt 64K Tokens über die gesamte Anfrage, mit einem separaten 32K-Limit für state plus die längste Frage. Zählen Sie Frageanweisungen und Kriterien sowie die gemeinsame Eingabe mit. Die verlinkte OpenAI-Decisions-Anleitung nennt kein separates numerisches Kontextlimit für diesen Endpunkt; prüfen Sie die geltenden Limits, statt anzunehmen, dass sich eine allgemeine Kontextfensterzahl unverändert auf diesen Endpunkt überträgt.
Benchmarks zu generativem Reasoning und Codierung liegen außerhalb des Umfangs dieser abgegrenzten Decision-Endpunkte. Für Erklärungsgenerierung oder Codegenerierung evaluieren Sie einen passenden generativen Endpunkt separat. Ergebnisse des zugrunde liegenden Allzweck-Modells begründen keine Performance-Aussage für den Decisions-Endpunkt.
Genauigkeit und Latenz
Die zitierten Anbieterunterlagen liefern keinen abgestimmten Kopf-an-Kopf-Test, der einen Gewinner bei Genauigkeit oder Latenz feststellt. OpenAIs etwa 10×-Geschwindigkeitsangabe vergleicht Decisions mit der Responses API. TypeSafe nennt 70–500 ms End-to-End-Latenz und sagt, seine veröffentlichten Auswertungen seien im Allgemeinen von einem Laptop im Westen der USA gelaufen.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | Kein abgestimmter Test in den zitierten Quellen | Kein abgestimmter Test in den zitierten Quellen | Kein Sieger |
| Speed | Relative Anbieterangabe | Absoluter Anbieterbereich | Nicht direkt vergleichbar |
| Calibration | Wahrscheinlichkeiten; separate confidence für choice/score | Wahrscheinlichkeiten; abgeleitete confidence für choice/score | Kalibrierung empirisch messen |
| Text categorization | Unterstützt | Unterstützt | Beide geeignet |
| Visual categorization | Native Bilder | Keine native Bilder | Vorteil OpenAI |
Kalibrierung von Wahrscheinlichkeiten und Review-Schwellen
Ein Modell kann genau sein, aber schlecht kalibriert. Unter Vorhersagen mit einer Wahrscheinlichkeit von 0,90 für die ausgewählte Klasse sollten etwa 90% korrekt sein, wenn diese Wahrscheinlichkeit auf der Evaluationsverteilung kalibriert ist. Ersetzen Sie eine API-Variable namens confidence nicht durch diese Wahrscheinlichkeit, ohne ihre Definition zu prüfen. Jev leitet seine Choice-confidence aus der Wahrscheinlichkeitsverteilung ab: confidence = (p_max − 1/n) / (1 − 1/n), wobei n die Anzahl der Optionen ist. Sein Noul-Resultat hat kein separates confidence-Feld. Messen Sie ECE und Brier Score anhand der passenden Wahrscheinlichkeiten, zusätzlich zu Precision, Recall und macro F1; wählen Sie Review-Schwellen anhand gelabelter Beispiele.
Preisgestaltung und Kosten pro akzeptierter Entscheidung
OpenAI listet $0.10 pro Million Input-Tokens für /v1/decisions; Jev listet $0.042 pro Million Input-Tokens. Beide listen keine Output-Token-Gebühr für diese Decision-Services. Auf diesen Basispreisen ist Jev pro Input-Token um 58% günstiger. OpenAIs regionale Verarbeitungsaufschläge und Long-Context-Multiplikatoren können gelten; Retries, Preprocessing und Review können Workflow-Kosten hinzufügen.
Gehen Sie davon aus, dass jede Anfrage bei beiden Diensten 500 abgerechnete Input-Tokens nutzt. Dies sind illustrative Berechnungen, keine Anbieterrechnungen.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Kosten pro akzeptierter korrekter Entscheidung = (API-Ausgaben + Retry-Ausgaben + Human-Review-Ausgaben) / Anzahl akzeptierter korrekter Entscheidungen. Ein niedriger Tokenpreis kann durch eine höhere Rate an Fehlroutings oder Eskalationen aufgewogen werden.
Für einen konventionellen GPT-6-Luna-Workflow listet die CometAPI-Modellpreistabelle die folgenden USD-Raten pro Million Tokens, geprüft am 12. Oktober 2026. Dies sind Modell-Endpunkt-Raten; die verlinkte Seite zeigt ein Responses-API-Beispiel und etabliert keine native Unterstützung von /v1/decisions oder deren Preisgestaltung.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Ordentliche GPT-6-Luna-Output-Tokens bei CometAPI werden abgerechnet. Halten Sie diese Schätzung getrennt von den beiden Decision-Services oben, deren veröffentlichte Output-Token-Gebühr null ist. Beispiel: 500 Input-Tokens plus 20 Output-Tokens kosten $0.000048 pro Short-Context-Anfrage, bzw. $48 pro Million Anfragen, vor weiteren Gebühren. Bestätigen Sie die zutreffende Stufe und Kontorate im Live-Modellkatalog, bevor Sie budgetieren.
Agent-Workflows und Modalitäts-Trade-offs
Beide können einen Tool-Call routen, evaluieren, ob eine Schutzbedingung erfüllt ist, oder eine Aktion bewerten. Keiner ersetzt Autorisierung, Eingabevalidierung oder explizite Toolberechtigungen. Für visuelle Automatisierung vereinfacht OpenAIs native Bildunterstützung die Pipeline; für reines Text-Routing kann Jevs niedriger Basispreis attraktiv sein.
Die Output-Verarbeitung unterscheidet sich an der Response-Grenze. OpenAI liefert ein answers array mit Namen, die Fragen identifizieren; Jev gibt ein answers object zurück, das nach Frage-ID geschlüsselt ist. Normalisieren Sie diese Strukturen, bevor Sie gemeinsame Geschäftsregeln anwenden. Jev leitet confidence aus seiner Wahrscheinlichkeitsverteilung ab; nehmen Sie nicht an, dass gleich benannte Felder bei Anbietern identische Bedeutungen haben. Validieren Sie Labels und kalibrieren Sie Review-Schwellen anhand Ihrer Anwendungsdaten.
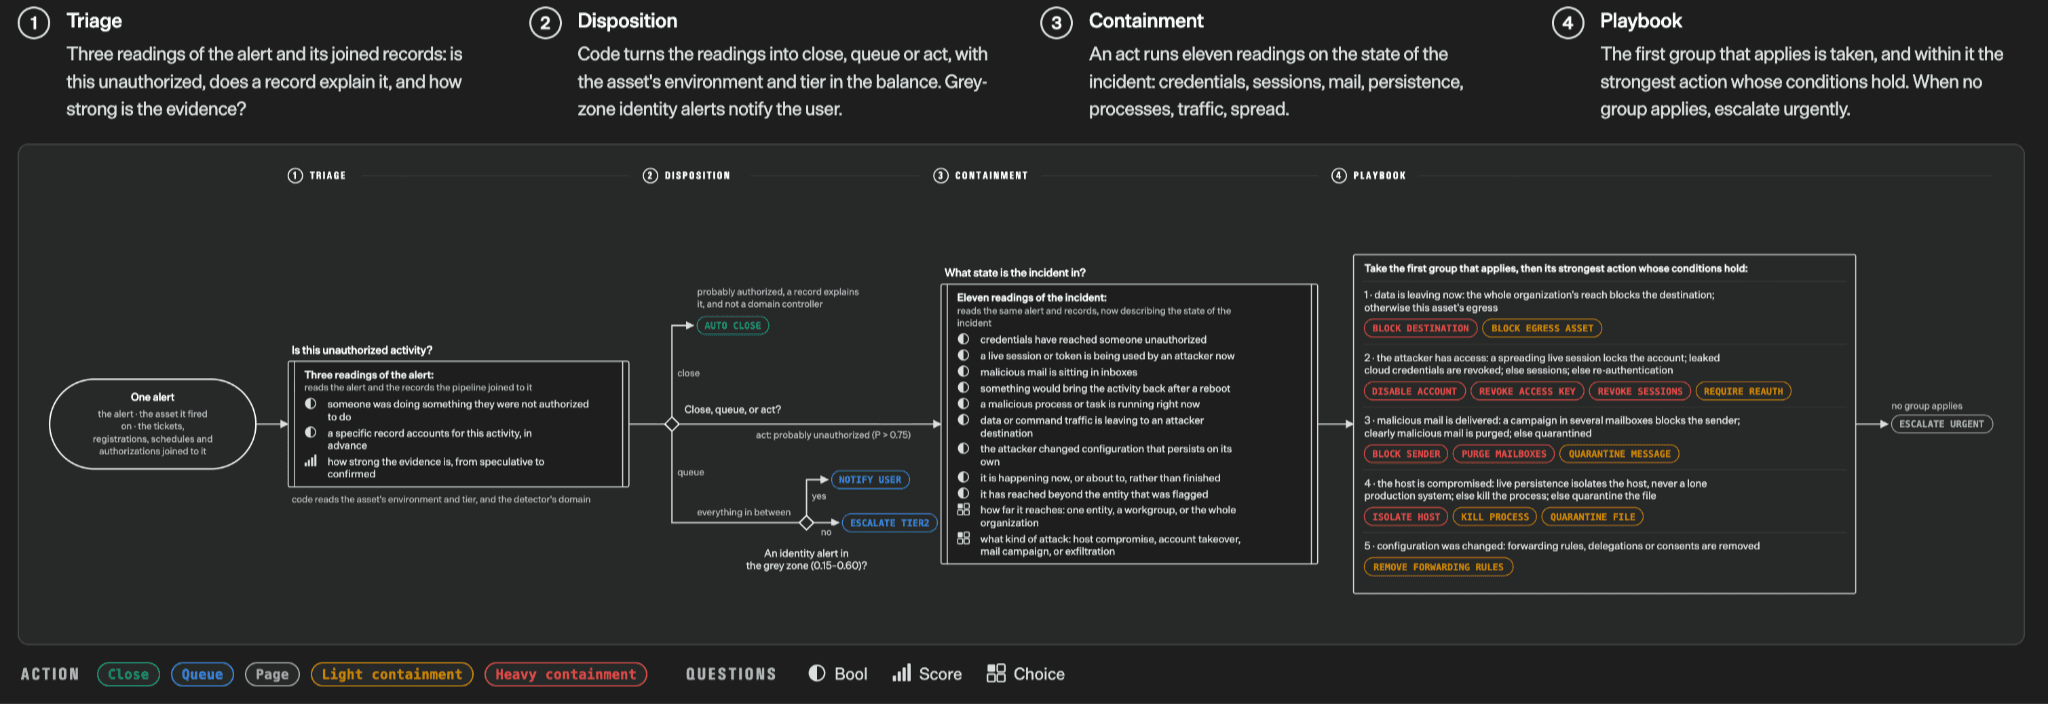
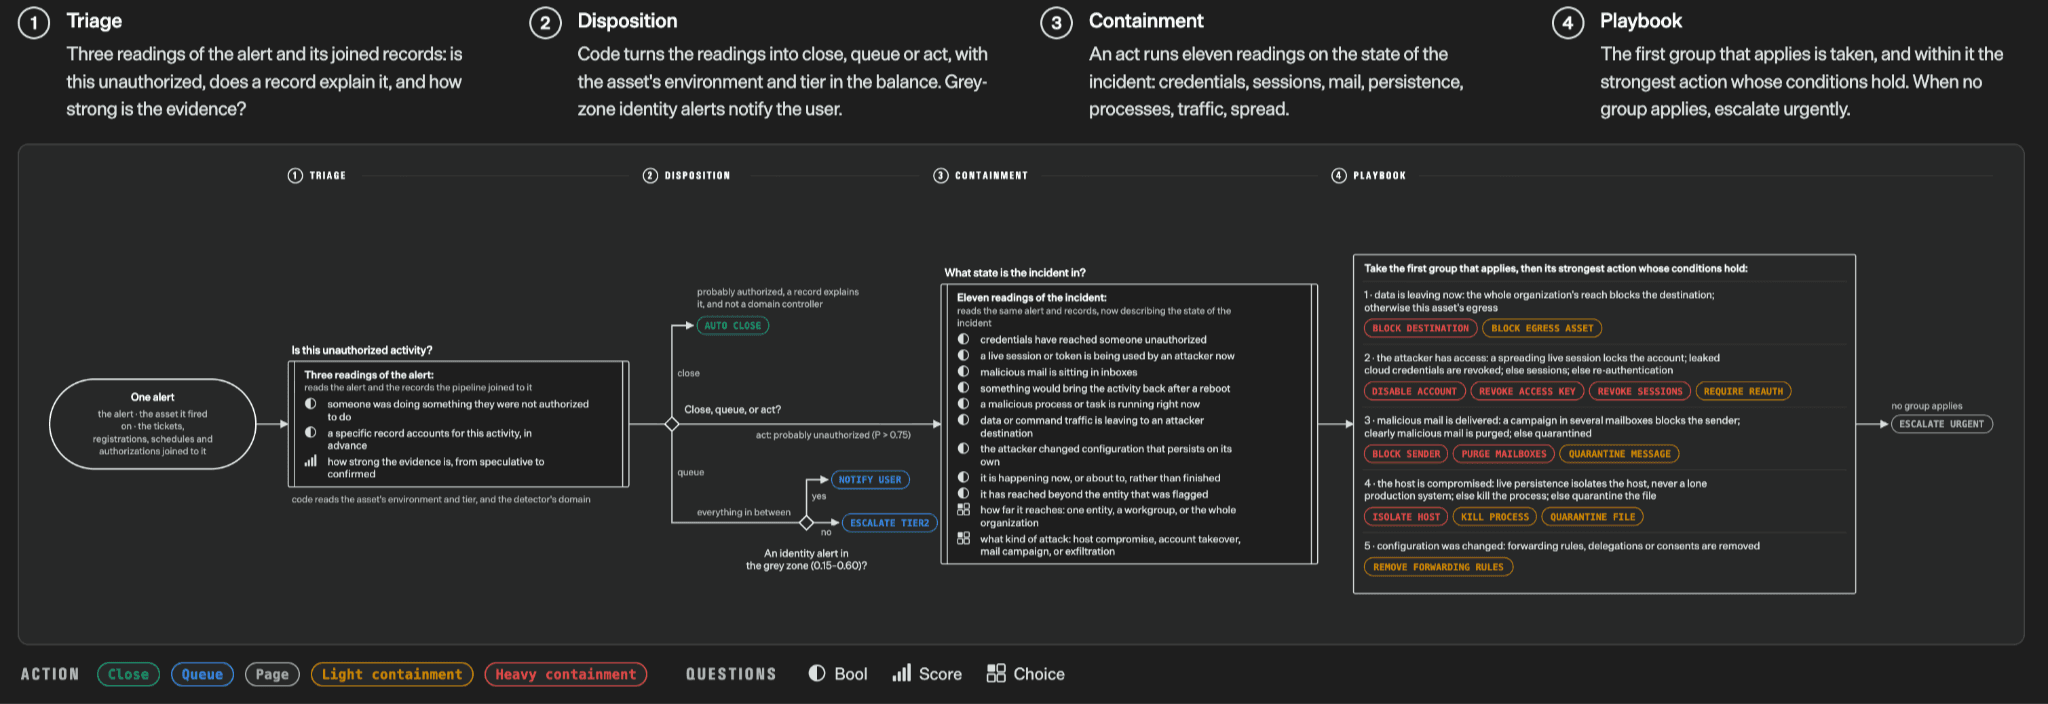
Quelle: Introducing System One Models & Jev; Originalbild. Dies veranschaulicht die Workflow-Zusammensetzung, nicht einen abgestimmten Benchmark gegen die OpenAI Decisions API.
Wie sich die API-Nutzung unterscheidet: OpenAI Decisions API vs Jev
Der Zugriff muss für jeden Anbieter separat konfiguriert werden: Jedes Beispiel unten verwendet eigenen Host und API-Key. OpenAI dokumentiert Decisions als Public-Beta-Endpunkt. Für Jev bestätigen Sie aktuellen Zugang und Anmeldedaten bei TypeSafe vor dem Deployment. Für beide Dienste prüfen Sie Kontoberechtigungen, regionale Verfügbarkeit, Quoten und Servicebedingungen; ein Beispiel-Request garantiert keinen Produktionszugang. Drittanbieterzugang zu einem generativen Modell bestätigt nicht automatisch die Unterstützung seines nativen Decision-Endpunkts.
Nutzung der OpenAI Decisions API
Die Konzepte überlappen, aber die Request-Schemata unterscheiden sich. OpenAI sendet input und ein Array benannter Fragen; Jev verwendet state und ein questions-Objekt, das nach Frage-ID geschlüsselt ist. Implementieren Sie einen providerspezifischen Adapter, bevor Sie eine gemeinsame Entscheidungsrichtlinie anwenden.
Support-Ticket mit der OpenAI Decisions API routen.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Nutzung der Jev API
Die folgende cURL-Anfrage verwendet Jevs System-One-Endpunkt, um ein Support-Ticket zu klassifizieren. Setzen Sie TYPESAFE_API_KEY in Ihrer Umgebung, legen Sie das Ticket in state ab und definieren Sie department im questions-Objekt. Die criteria-Map listet die erlaubten Routing-Labels und ihre Beschreibungen. Nach erfolgreicher Anfrage lesen Sie den Eintrag department in answers aus und validieren das ausgewählte Label vor dem Routing des Tickets. Bestätigen Sie, dass die Modellkennung Ihrem Konto zur Verfügung steht.
Support-Ticket mit TypeSafe Jev routen.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Gemeinsame Review-Policy für Wahrscheinlichkeiten der ausgewählten Klasse
Wenden Sie eine explizit kalibrierte Schwelle auf eine Wahrscheinlichkeit der ausgewählten Klasse an.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Dieses Beispiel für Python 3.10+ ist eine Anwendungsschicht für Richtlinien, kein Parser für API-Responses. Jeder Anbieter-Adapter muss die Response validieren und die Wahrscheinlichkeit der ausgewählten Klasse extrahieren. Übergeben Sie Jevs Rohfeld confidence nicht als selected_probability. Verwenden Sie eine pro Anbieter, Frage und Evaluationsdatensatz kalibrierte Schwelle; behandeln Sie Verweigerungen und Transportfehler, bevor Sie die Policy aufrufen.
OpenAI Decisions API vs Jev: So wählen Sie aus
Wählen Sie in zwei Stufen. Zuerst nach Einsatzanforderungen screenen: Bildinput, Kontozugang, Input-Limits und Integrationsaufwand. Danach die geeigneten Dienste auf derselben gelabelten Workload benchmarken. Für reines Text-Routing testen Sie, ob Jevs niedriger veröffentlichter Input-Preis zu niedrigeren Gesamtkosten führt; für bildabhängige Entscheidungen evaluieren Sie OpenAIs native Bildpfade. Vergleichen Sie Fehlroutings, Kalibrierung, Tail-Latenz, Retries und Human-Review bei einem vereinbarten Qualitätsziel. Die Tabelle unten ist eine Ausgangskurzliste, kein Beleg für einen generellen Performance-Sieger.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Unterstützt | Unterstützt | Jev zuerst bzgl. Kosten benchmarken |
| Text categorization | Unterstützt | Unterstützt | Kalibrierung vergleichen |
| Screenshot inspection | Native | Erfordert Vision-Preprocessing | OpenAI |
| Agent tool selection | Unterstützt | Unterstützt | End-to-End-Ergebnisse messen |
| Multimodal moderation | Text und Bilder | Nur Text | OpenAI |
| Existing OpenAI stack | Native | Neue Integration | OpenAI |
Für großvolumige Geschäftsautomatisierung wie Support-Routing und Textklassifikation ist Jev eine Priorität, wenn Inputkosten und Durchsatz entscheidend sind. Für multimodale Anwendungen, einschließlich Screenshot-Inspektion, visuelle Moderation und bildbasierte Entscheidungen, ist die OpenAI Decisions API aufgrund der nativen Bildunterstützung die praktischere Option. Für KI-Agenten und Unternehmensworkflows hängt die Wahl von bestehender Infrastruktur, Integrationskomplexität und den Konsequenzen falscher Entscheidungen ab. OpenAI kann für Teams mit bestehender Nutzung seines Ökosystems einen reibungsloseren Weg bieten, während Jev für großskalige, textlastige Workloads eine ernsthafte Option ist. In allen Szenarien sollte die endgültige Entscheidung auf gemessener Genauigkeit, Kalibrierung der Wahrscheinlichkeiten, Latenz und Gesamtkosten des Betriebs statt auf reinen Schlagzeilenpreisen basieren.
Wie sollten Sie OpenAI Decisions API gegen Jev benchmarken?
Beide Dienste auf denselben gelabelten realen Eingaben laufen lassen, mit abgestimmten Fragendefinitionen und identischen Client-Regionen. Genauigkeit, macro F1, ECE, Brier Score, p50/p95/p99-Latenz, Timeouts, Verweigerungen, Review-Rate und Dollar-Kosten pro akzeptierter korrekter Entscheidung verfolgen.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, Precision, Recall, macro F1 | Qualität der Labels |
| Calibration | ECE, Brier score | Zuverlässigkeit der Wahrscheinlichkeiten |
| Latency | p50 / p95 / p99 | Operative Reaktionsfähigkeit |
| Reliability | 429 / Timeout / Ablehnungsrate | Produktionsverhalten |
| Economics | Kosten pro akzeptierter korrekter Entscheidung | Reale Betriebsausgaben |
Empfohlene Vorgehensweise: einen repräsentativen gelabelten Satz aufbauen; mehrdeutige und Out-of-Distribution-Fälle einschließen; semantisch identische Aufgaben senden; Anfragen oft genug wiederholen, um Varianz zu messen; die Schwellen jedes Systems unabhängig kalibrieren; und End-to-End-Kosten einschließlich Eskalation und Retries vergleichen.
Fazit
Wählen Sie die OpenAI Decisions API, wenn die Entscheidung von Bildbelegen abhängt oder wenn eine bestehende OpenAI-Integration den Einsatzaufwand reduziert. Evaluieren Sie Jev für text-only Decision-Workloads, bei denen sein niedriger veröffentlichter Input-Token-Preis die Inferenzkosten senken kann. Messen Sie Labelqualität, Kalibrierung, Tail-Latenz und Review-Workload auf denselben Anwendungsdaten, bevor Sie wählen.
Jev hat den niedrigeren veröffentlichten Basispreis pro Input-Token; die OpenAI Decisions API hat native Bildinput-Unterstützung. Die zitierten Anbieterzahlen etablieren keinen generellen Genauigkeits- oder Geschwindigkeits-Sieger. Die beste Wahl hängt von Kosten und Qualität akzeptierter Entscheidungen im vollständigen Workflow ab.
Entwickler können die GPT-6 Luna API in CometAPI nutzen, um leichte Klassifikation in einem breiteren Multi-Modell-Workflow zu prototypisieren. Die verlinkte Modellseite liefert ein Responses-API-Beispiel. Zugriff auf diesen generativen Endpunkt bestätigt nicht die Unterstützung des dedizierten /v1/decisions-Endpunkts. Dies ist ein konventionelles Textgenerierungs-Prototyping. Es liefert nicht das native Decisions-Antwortschema oder eine kalibrierte Klassenwahrscheinlichkeitsverteilung. Validieren Sie das zurückgegebene Label gegen die erlaubten Kategorien und behandeln Sie API-Fehler, bevor Sie es mit nachgelagerten Aktionen verbinden. Bestätigen Sie native /v1/decisions-Unterstützung separat, wenn dieser Endpunkt erforderlich ist.