TL;DR: Alibaba hat am 16. November 2026 Qwen4-Max als Flaggschiffmodell der Qwen4-Generation veröffentlicht. Offizielle Bewertungen berichten von besserer Leistung bei Branchentasks und niedrigeren Ausführungskosten als Qwen3.8-Max, was Verbesserungen bei der Token-Effizienz und gesenkten API-Preisen widerspiegelt.
Wichtigste Erkenntnisse
- Modellgröße: Qwen4-Max verfügt über 2.4 Billionen Backbone-Parameter, mit 71 Milliarden aktivierten pro Token.
- Kontextfenster: Qwen4-Max unterstützt ein Kontextfenster von einer Million Token.
- Multimodale Unterstützung: Qwen4-Max akzeptiert Text, Bilder und Video und generiert Text.
- Entwicklerfunktionen: Qwen4-Max unterstützt Function Calling, strukturierte Ausgaben, Kontext-Caching und Websuche.
- Zugriffsoptionen: Nutzer können über unterstützte Qwen-Anwendungen, die nutzungsbasierte QwenCloud-API und Token-Plan-Abos auf Qwen4-Max zugreifen.
Was ist Qwen4-Max?
In der offiziellen Ankündigung beschreibt Qwen Qwen4-Max als einen KI-Teamkollegen für Arbeit, Kreation und Entdeckung. Die Fähigkeiten konzentrieren sich auf das Verstehen von Zielen, das Bedienen von Tools, das Reagieren auf Ausführungsfeedback und die Lieferung von Ergebnissen über mehrere Stufen.
Für diese Workflows liefert das Modell Reasoning und Koordination. Verbundene Anwendungen, Tools und Ausführungsumgebungen führen die Operationen aus.
Qwen4-Max-Spezifikationen
Die offizielle QwenCloud-Modellseite listet die folgenden Spezifikationen:
| Spezifikation | Qwen4-Max |
|---|---|
| Modell-ID | qwen4-max |
| Backbone-Parameter | 2.4 Billionen |
| Aktivierte Parameter pro Token | 71 Milliarden |
| Kontextfenster | 1 Million Token |
| Eingabe / Ausgabe | Text, Bilder und Video / Text |
| Grenzwerte im Standardmodus | Maximale Eingabe: 991K; maximale Ausgabe: 131K Token |
| Grenzwerte im Thinking-Modus | Maximale Eingabe: 983K; maximale Ausgabe: 262K Token |
| Maximale Reasoning-Länge | 262K Token |
| Entwicklerfunktionen | Function Calling, strukturierte Ausgaben, Kontext-Caching und Websuche |
| API-Kompatibilität | OpenAI- und Anthropic-API-Protokolle |
Kontextgröße, Eingabelimits und Ausgabelimits stellen unterschiedliche Beschränkungen dar. Anwendungen müssen alle gemeinsam einhalten und ausreichend Kapazität für generierte Antworten und Reasoning einplanen.
Was sind die Hauptfunktionen von Qwen4-Max?
Die Fähigkeiten von Qwen4-Max sind besonders relevant, wenn eine Aufgabe mehrere Dokumente, Tools und Ausführungsschritte umfasst. Ein großer Kontext bewahrt den Arbeitsrahmen, visuelles Verständnis erweitert die verfügbaren Belege, und Agentenfähigkeiten helfen, die Aufgabe zur Lieferung voranzutreiben.
Kontext mit einer Million Token und native visuelle Interpretation
Das große Kontextfenster ermöglicht es, verwandte Materialien in einem gemeinsamen Arbeitskontext zu verarbeiten. Praktische Anwendungen sind der Vergleich von Verträgen, die Analyse von Abhängigkeiten über Code-Dateien hinweg und die Prüfung von Berichten zusammen mit unterstützenden Dokumenten.
Native visuelle Interpretation erweitert dies auf Screenshots, Diagramme, gescannte Seiten und Video. Ein Nutzer kann eine technische Zeichnung oder einen Interface-Screenshot bereitstellen und das Modell bitten, ihn zusammen mit schriftlichen Anforderungen zu interpretieren.
Bei dokumentlastigen Aufgaben hilft das Beibehalten von Dateinamen, Datumsangaben und Abschnittsbezeichnungen, die Belege zu organisieren und die anschließende Analyse leichter überprüfbar zu machen.
Programmierung und professioneller Werkzeugeinsatz
Qwen4-Max unterstützt Function Calling und ermöglicht Entwicklern, es mit Datenbanken, Suchdiensten, Dateioperationen und Geschäftssystemen zu verbinden. Strukturierte Ausgaben helfen, Modellergebnisse in nachgelagerte Softwareprozesse zu übergeben.
Offizielle Demos zeigen breitere Software-Workflows. In der Spieleentwicklung nutzt das Modell Engines wie Unity, Unreal Engine und Godot, um Szenen aufzubauen, Gameplay zu implementieren und die Ergebnisse durch Tests zu verfeinern. In Blender koordiniert es Geometrie, Materialien, Beleuchtung und Rendering.
Die Reproduktion dieser Workflows erfordert die entsprechende Software, Assets und Ausführungsberechtigungen. Die Demos zeigen, was das Modell innerhalb dieser Umgebungen leisten kann.
Langfristige Agenten und Live Delivery
Lange Aufgaben werden schwer zu steuern, wenn Nutzer den Fortschritt erst am Ende einsehen können. Qwens Live-Delivery-Ansatz liefert zunächst ein nutzbares Ergebnis, dem sukzessive Updates folgen.
Bei einer Forschungsaufgabe könnte ein Agent zuerst vorläufige Erkenntnisse und eine Quellenliste liefern, dann die Analyse ausbauen und Diagramme hinzufügen. Nutzer können jede Version prüfen und die anschließende Arbeit neu ausrichten.
Qwen hat außerdem das Qwen-Live-Delivery-Plugin veröffentlicht. Bei Workflows, die Stunden oder länger dauern, schafft eine gestufte Lieferung praktische Checkpoints zur Qualitätsprüfung und Kurskorrektur.
Architektur und Token-Effizienz
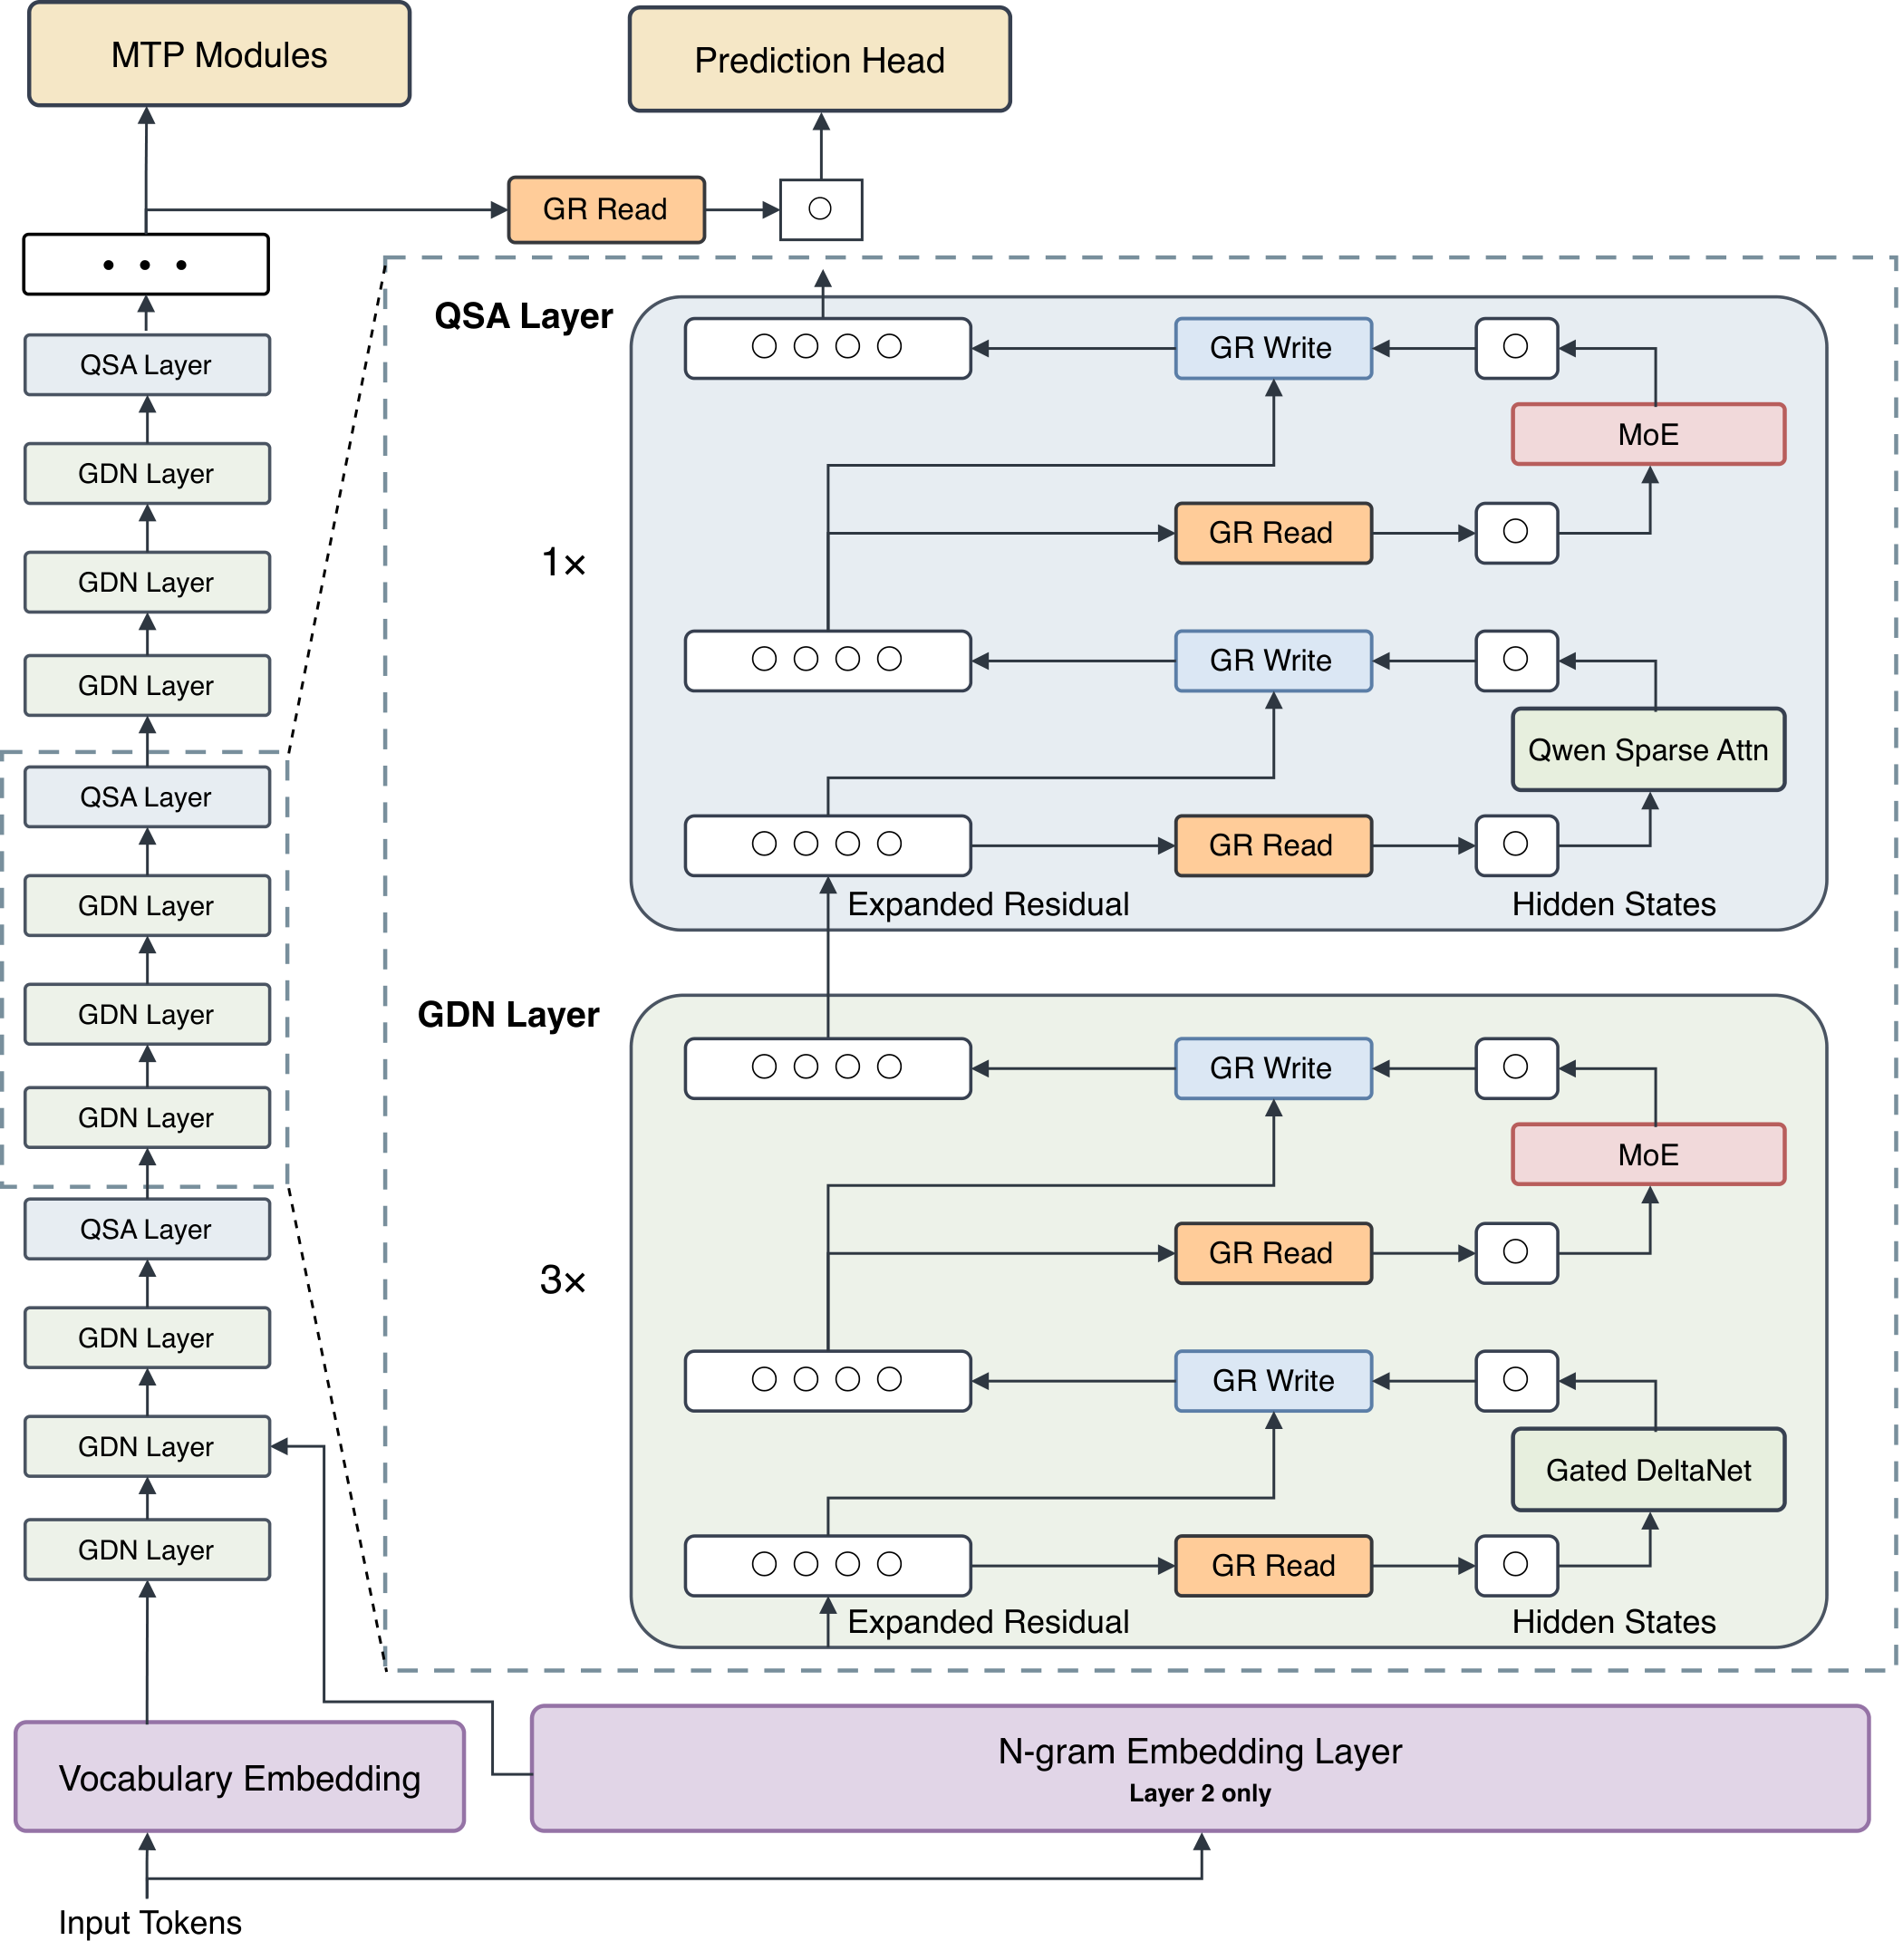
Qwen4-Max führt mehrere Änderungen an seiner sparsamen Mixture-of-Experts-Architektur ein:
- Gated DeltaNet und Qwen Sparse Attention: Kombinieren Kompression historischer Informationen mit selektiver Aufmerksamkeit für relevanten Kontext und reduzieren so die Berechnung bei langen Sequenzen.
- Gated Residual: Nutzt vier parallele Residual-Zweige und dynamische Gates, um den Informationstransfer und die Trainingsstabilität zu verbessern.
- N-gram Embedding: Fügt 328 Milliarden Embedding-Parameter hinzu, um lokale Token-Muster über Lookup-Operationen zu repräsentieren und die Kapazität mit relativ geringem zusätzlichen Rechenaufwand zu erweitern.
Für Nutzer ist der Praxistest, ob diese Änderungen die Ressourcen reduzieren, die benötigt werden, um ein akzeptables Ergebnis zu liefern. Qwens veröffentlichte Messungen zum Token-Verbrauch liefern Hinweise auf Verbesserungen bei den bewerteten Aufgaben.
Wie performt Qwen4-Max? Offizielle Benchmarks und Beispiele
Qwens veröffentlichte Benchmarks messen Aufgabenleistung, Token-Verbrauch und Ausführungskosten, während Demos praktische Workflows illustrieren.
Qwen4-Max-Benchmark-Ergebnisse
Die folgenden Ergebnisse vergleichen Qwen4-Max mit Qwen3.8-Max:
| Metrik | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Work360-Score | Gestiegen von 47.74 auf 52.69 |
| Work360-Tokenverbrauch | Reduziert um ca. 24% bei Xhigh und 35% bei High |
| Terminal-Bench 4.0-Tokenverbrauch | Reduziert um ca. 48% bei Xhigh und 49% bei High |
| Durchschnittliche Work360-Task-Kosten | Gesunken von RMB 26.58 auf RMB 11.16, ca. 58% niedriger |
Die Kostensenkung spiegelt sowohl geringeren Token-Verbrauch als auch überarbeitete API-Preise wider.
Bei Anwendungen mit wiederholten Tool-Aufrufen ist die Kostenkennzahl pro erfolgreich abgeschlossener Aufgabe aussagekräftiger als reine Token-Preise. Eine günstiger bepreiste Anfrage bringt nur begrenzte Einsparungen, wenn der Workflow viele Wiederholungen oder manuelle Korrekturen erfordert.
Beispiele in Finanzforschung und Fertigung
Mehrere offizielle Beispiele liefern konkrete Artefakte und messbare Ergebnisse.
In der Finanzforschung kombiniert das Modell Marktdaten-Tools und Suche, um Excel-Arbeitsunterlagen und bearbeitbare PowerPoint-Berichte zu erstellen. Quellenlinks und abgeglichene Diagramme ermöglichen Prüfern, die Berichtsergebnisse auf die zugrunde liegenden Daten zurückzuführen.
In einem Fertigungsbeispiel kombiniert das Modell parametrisierte Modellierung, Werkzeugweg-Generierung und Simulationsfeedback. Der gemeldete menschliche Programmieraufwand für ein Werkstück sank von etwa 475 Minuten auf 24 Minuten. Dieses Ergebnis beschreibt das demonstrierte Werkstück und die Tool-Umgebung und bietet einen nützlichen Ausgangspunkt für die Bewertung ähnlicher Prozesse.
Wie die Ergebnisse zu interpretieren sind
Der Work360-Score von Qwen4-Max stieg von 47.74 auf 52.69, ein Plus von 4.95 Punkten. Dies weist auf eine stärkere Leistung über die bewerteten Branchentasks hin, auch wenn einzelne Aufgaben variieren können. Die Reduktionen beim Token-Verbrauch liefern ein separates Effizienzmaß mit unterschiedlichen Einsparungen bei den Reasoning-Einstellungen High und Xhigh.
Die gemeldete Senkung der durchschnittlichen Work360-Task-Kosten um 58% kombiniert niedrigeren Token-Verbrauch mit überarbeiteten API-Preisen. Für Entwickler ist die relevante Frage, ob diese Einsparungen bis zur erfolgreich abgeschlossenen Aufgabe nach Wiederholungen und manuellen Korrekturen durchschlagen.
Anwendungsdemos liefern zusätzliche Belege zu spezifischen Workflows und Ergebnissen. Nutzen Sie sie, um testwürdige Aufgaben zu identifizieren, und vergleichen Sie dann Abschlussqualität, Prüfaufwand und Gesamtkosten unter konsistenten Tool-Bedingungen.
Qwen4-Max-Preise: API-Kosten und Token-Plan-Optionen
Qwen4-Max ist über nutzungsbasierte API-Abrechnung und Token-Plan-Abos verfügbar. Die passende Option hängt davon ab, ob Sie eine Anwendung bauen oder ein interaktives KI-Tool verwenden.
Offizielle nutzungsbasierte API-Preise
QwenCloud listet die folgenden Preise für die Region Singapur:
| Abrechnungsposten | Preis pro 1 Million Token |
|---|---|
| Standard-Eingabe | $1.50 |
| Ausgabe | $4.50 |
| Implizite Cache-Eingabe | $0.075 |
| Explizites Cache-Lesen | $0.075 |
Die Erstellung eines expliziten Caches kostet $1.875 pro Million Token für einen Fünf-Minuten-Cache und $3.00 für einen Ein-Stunden-Cache.
Eine Aufgabe mit 100,000 nicht zwischengespeicherten Eingabetoken und 10,000 berechenbaren Ausgabetoken kostet $0.195 an Modell-Token-Gebühren, ohne zusätzliche kostenpflichtige Tools oder Dienste.
Zwischengespeicherte Eingaben sind 95% günstiger als Standard-Eingaben. Anwendungen, die wiederholt dieselben Anweisungen, Tool-Definitionen oder Dokumentpräfixe senden, können die Eingabekosten durch bessere Cache-Nutzung senken.
Wie der Token Plan funktioniert
Token Plan nutzt Aboabrechnung und Credits-Abzüge. Er führt derzeit qwen4-max unter den unterstützten Modellen.
Stand 17. November 2026 zeigt die Seite für die Region Singapur die folgenden individuellen Monatspläne:
| Plan | Monatlicher Preis | Monatliche Credits |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
Die Seite bewirbt außerdem eine Neukundenaktion ab $3. Anspruch und Endbetrag werden beim Checkout angezeigt.
Credits sind Abrechnungseinheiten eines Abos und kein direktes Token-Kontingent. Der Verbrauch hängt von den geltenden Modell- und Tool-Regeln ab.
Laut der Token-Plan-Dokumentation ist der Dienst für die interaktive Nutzung in kompatiblen KI-Tools gedacht und derzeit in der Region Singapur verfügbar.
So greifen Sie auf Qwen4-Max zu
Es gibt drei praktische Wege: ein Qwen-Produkt nutzen, direkt über QwenCloud verbinden oder ein kompatibles KI-Tool konfigurieren. Jeder hat unterschiedliche Einrichtungsvoraussetzungen, insbesondere bei Zugangsdaten und Endpunkten.
Qwen-Anwendungen verwenden
Die offizielle Ankündigung nennt Qwen Studio, die Qwen-App, QwenWork und Qoder als Zugangskanäle.
Diese Produkte bieten einen bequemen Startpunkt zum Testen von Dokumentanalyse, Coding-Unterstützung und Office-Workflows. Entwickler, die Anfragen, Tools und Ergebnisverarbeitung kontrollieren müssen, können zur direkten API-Integration wechseln.
Zugriff auf die QwenCloud-API
Um auf Qwen4-Max zuzugreifen, melden Sie sich bei QwenCloud an, holen einen API-Schlüssel für Ihre ausgewählte Region und konfigurieren den entsprechenden Endpunkt mit der Modell-ID qwen4-max. QwenCloud bietet OpenAI-kompatiblen Zugriff. Nutzer, die aus der Vorschau migrieren, sollten auch ihre Anfrageparameter und die Abrechnungskonfiguration prüfen.
Coding- und Agenten-Tools konfigurieren
Die Token-Plan-Dokumentation bietet Integrationshinweise für Tools wie Qwen Code, Cline, Cursor und OpenCode.
Die Konfiguration erfordert in der Regel einen dedizierten API-Schlüssel, die passende Base-URL und den Modellnamen. Der Token Plan verwendet die separate Endpunkt-Domain token-plan.maas.qwencloudapi.com, und seine Schlüssel sind nicht mit nutzungsbasierten API-Schlüsseln austauschbar.
Folgen Sie der Anleitung für Ihr gewähltes Tool und validieren Sie die Einrichtung mit einer Aufgabe, die Lesematerial, eine Operation und eine Ergebnisprüfung umfasst.
Für wen eignet sich Qwen4-Max?
Qwen4-Max ist eine Prüfung wert, wenn ein wiederkehrender Workflow umfangreichen Kontext, mehrere Tools und ein verifizierbares Ergebnis erfordert.
- Entwickler können Qwen4-Max für Codeänderungen über mehrere Dateien, Frontend-Entwicklung und Agenten mit externen Tools evaluieren.
- Office- und Forschungsteams können es für die Analyse von Dokumenten, die Organisation von Daten und die Erstellung von Berichten mit nachvollziehbaren Quellen einsetzen.
- Design- und Content-Teams können es für 3D-Modellierung, Spielprototypen und Videoworkflows in Verbindung mit professioneller Software testen.
- Enterprise-Teams können wiederkehrende Prozesse mit definiertem Datenzugriff, Tool-Schnittstellen und Abnahmekriterien evaluieren.
Für finanzielle, rechtliche und medizinische Workflows sollte es zur Belegverarbeitung und analytischen Unterstützung genutzt werden; folgenschwere Schlussfolgerungen sind von qualifizierten Fachleuten zu prüfen.
FAQ
Liegt das Ausgabelimit von Qwen4-Max bei einer Million Token?
Nein. Kontextfenster und maximale Ausgabelänge sind separate Limits. QwenCloud listet maximale Ausgaben von 131K Token im Standardmodus und 262K Token im Thinking-Modus. Anfragen müssen zudem die jeweiligen Eingabe- und Kontextlimits einhalten.
Sollte ich die Qwen4-Max-API oder den Token Plan wählen?
Wählen Sie die nutzungsbasierte API, wenn Sie Qwen4-Max in eine Anwendung oder einen Backend-Dienst integrieren. Der Token Plan ist für die interaktive Nutzung in kompatiblen KI-Tools gedacht und verwendet Abo-Credits. Beide Optionen erfordern separate Zugangsdaten und Endpunkte.
Kann ich Qwen4-Max kostenlos nutzen?
Offizieller API-Zugang und Token Plan sind kostenpflichtige Dienste. Kostenloser Zugriff über Qwen-Anwendungen, sofern angeboten, richtet sich nach den jeweiligen Konto- und Nutzungsregeln der Produkte; er begründet kein kostenloses API-Kontingent.
Kann ich Qwen4-Max für die lokale Bereitstellung herunterladen?
Stand 17. November 2026 hat Qwen keine offenen Gewichte für Qwen4-Max bereitgestellt, sodass die offizielle Veröffentlichung kein herunterladbares Modell für die lokale Bereitstellung bietet. Qwen hat angekündigt, kleinere Modelle der Qwen4-Serie schrittweise zu open-sourcen.
Fazit
Qwen4-Max ist ein starker Kandidat für Langdokumentanalyse, komplexes Coding und Workflows mit mehreren Tools. Offizielle Bewertungen zeigen höhere Scores und niedrigere Task-Kosten als Qwen3.8-Max bei den berichteten Workloads.
Beginnen Sie mit einer repräsentativen Aufgabe, die bereits klare Abnahmekriterien hat. Vergleichen Sie Ausgabequalität, manuelle Korrekturzeit, Ausführungszeit und Gesamtkosten. Verbesserungen über diese Maße bieten eine praktische Grundlage, Qwen4-Max auf ähnliche Workflows auszuweiten.