
TL;DR
Muse Ember ist Metas kleinstes multimodales Reasoning-Modell, entwickelt für hochvolumige Agentenaufgaben wie Routing, Extraktion, Tool-Aufrufe und fokussiertes Coding. Meta hat Muse Ember am 9. November 2026 vorgestellt.
Das Kontextfenster mit 1,048,576 Token nimmt umfangreiches Ausgangsmaterial auf. Meta bietet Zugriff über die Model API und Muse Code; CometAPI führt muse-ember, der Aktivierungsstatus ist unten beschrieben. Starten Sie mit einer wiederholbaren Aufgabe, deren Output Sie prüfen können, und vergleichen Sie dann die Kosten pro erfolgreichem Ergebnis, einschließlich Reasoning, Tools und Retries.
Key Takeaways
- Rolle: Muse Ember ist für die wiederholte Ausführung durch Agenten gebaut, darunter Klassifikation, Extraktion, Tool-Aufrufe und begrenzte Coding-Aufgaben.
- Eingaben und Kapazität: Muse Ember akzeptiert Text, Bilder, Audio und Video, mit einem 1M-Token-Kontextfenster und bis zu 512K Output-Token.
- Performance: Metas Ergebnisse sprechen Muse Ember auf mehreren Agenten-Benchmarks Vorteile zu, während unabhängige Analytik-Tests zeigen, dass niedrige Tokenpreise nicht immer zu den niedrigsten Aufgabenkosten führen.
- Pricing: Anfragen über 200K Eingabe-Token wechseln in eine höhere Preistufe; die Gesamtkosten pro Aufgabe hängen auch von Reasoning und Tool-Nutzung ab.
- Zugriff: Meta Model API und Muse Code sind verfügbar; CometAPI listet das Modell derzeit als Coming soon.
Wofür eignet sich Muse Ember am besten?
Muse Ember übernimmt Ausführungsschritte in einem Agenten-Workflow, während ein größeres Modell die Planung steuert. Es passt zu hochvolumigen Aufgaben mit klaren Eingaben, begrenztem Umfang und einem Ergebnis, das Ihre Anwendung verifizieren kann. Die Kernaufgaben sind:
- Klassifikation und Routing: Anfragen labeln und an die richtige Queue bzw. den richtigen Dienst senden.
- Extraktion: Dokumente und Medien in strukturierte Felder mit Quellnachweisen überführen.
- Tool-Aufrufe: Eine Funktion auswählen und die Argumente liefern, die Ihre Anwendung ausführt.
- Batch-Verarbeitung: Eine wiederholbare Operation über Dateien oder Datensätze anwenden.
Support-Ticket-Routing
Ein praktischer Support-Workflow kann Ember anweisen, eine Bestellreferenz zu extrahieren, eine Kategorie zuzuweisen und fehlende Informationen zu markieren. Ihre Anwendung kann die Referenz gegen ihre Datensätze validieren, bevor das Ticket geroutet wird. Halten Sie Rückerstattungen, Kontoänderungen und andere folgenschwere Aktionen hinter den eigenen Autorisierungsprüfungen der Anwendung zurück.
Dokumentenextraktion mit Evidenz
Für Rechnungs- oder Vertragsverarbeitung bitten Sie sowohl um den extrahierten Wert als auch um die Seite bzw. Passage, die ihn stützt. Behandeln Sie fehlende und unlesbare Felder als explizite Ergebnisse, statt das Modell zum Raten einzuladen. So entstehen Datensätze, die Prüfer einsehen können, ohne jedes Dokument erneut zu lesen.
Fokussierte Programmierarbeit
Geben Sie einem Coding-Worker einen kleinen Verantwortungsbereich: die Dateien, die er ändern darf, das beizubehaltende Verhalten und die Tests, die die Fertigstellung definieren. Metas Beispiel für parallele Code-Migration veranschaulicht diese Arbeitsteilung. Der umgebende Agent führt Befehle aus und prüft Ergebnisse; die Antwort des Modells allein ist kein Beleg dafür, dass eine Änderung ihre Tests bestanden hat.
Metas Launch-Visual zu Muse Ember begleitet die Anleitung zur Kombination eines Ausführungsmodells mit einem größeren Planungsmodell.
Meta sagt, Muse Ember sei das erste Modell, das mit Muse Wonder Full trainiert wurde, und setze damit die Strategie fort, größere Modelle zu nutzen, um spezialisierte Modelle zu entwickeln.
Muse-Ember-Spezifikationen
Die Kernspezifikationen sind:
| Spezifikation | Muse Ember |
|---|---|
| Entwickler | Meta Superintelligence Labs |
| Ankündigungsdatum | 9. November 2026 |
| Modellkategorie | Multimodales Reasoning und Agenten-Ausführung |
| Kontextfenster | 1,048,576 Token |
| Maximaler Output | 524,288 Token |
| Eingabemodalitäten | Text, Bilder, Audio, Video |
| Dateieingaben | Unterstützt über die Responses API |
| Ausgabemodalität | Text |
| Reasoning-Aufwand | Minimal, Low, Medium, High, XHigh, Max |
| Standard-Reasoning-Aufwand | Max |
| Tool-Aufrufe | Unterstützt |
| Strukturierte Ausgabe | Unterstützt |
| Search Grounding | Unterstützt über die Model API |
Meta hat weder die Gewichte von Muse Ember veröffentlicht noch die Parameteranzahl offengelegt. Die Anfrage- und Tokenlimits gelten pro Team, wobei alle API-Schlüssel eines Teams das Modellkontingent teilen.
Kontext und multimodale Eingaben
Für PDF-Workflows extrahiert Meta Text aus den ersten 100 Seiten und Bilder aus den ersten 50, daher sollten längere Dateien vor der Verarbeitung aufgeteilt werden. Senden Sie das für die Aufgabe benötigte Material; Reasoning-Token teilen sich das Output-Kontingent von 524,288 Token mit der finalen Antwort.
Verwenden Sie Screenshots, wenn das Layout wichtig ist, Scans für Dokumentenextraktion, Audio für Besprechungsanalysen und Video für Ereignisse, die sich über die Zeit entfalten. Ein Transkript reicht für eine reine Textzusammenfassung. Dateien werden über die Responses API unterstützt, und die Ergebnisse werden als Text zurückgegeben.
Konfigurierbarer Reasoning-Aufwand
Muse Ember bietet sechs Reasoning-Stufen: Minimal, Low, Medium, High, XHigh und Max. Meta setzt standardmäßig auf Max; keine dieser Stufen ist nicht unterstützt, andernfalls gibt es HTTP 400. Beginnen Sie mit Routine-Routing und -Klassifikation auf einer niedrigeren Stufe und erhöhen Sie sie nur, wenn der Gewinn an akzeptierten Antworten die zusätzliche Latenz und den Output-Token-Verbrauch rechtfertigt.
Tool-Aufrufe und strukturierte Ausgabe
Muse Ember unterstützt Tool-Aufrufe und strukturierte Ausgabe. Tool-Aufrufe verbinden Modellentscheidungen mit Anwendungsfunktionen, während strukturierte Ausgabe extrahierte Felder leichter validierbar macht und an den nächsten Schritt übergibt.
Dieses illustrative Support-Ticket-Ergebnis liefert einer Routing-Anwendung eine Kategorie, eine Priorität und eine Prüfflagge:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Die Meta Model API unterstützt außerdem Search Grounding und Computer-Use-Workflows. Die verbundene Anwendung stellt die Tools bereit, führt Aktionen aus und steuert Berechtigungen.
Wie schneidet Muse Ember auf Benchmarks ab?
Metas Launch-Ergebnisse nutzen maximalen Reasoning-Aufwand. Agents’ Last Exam umfasst den Linux-Teil in Metas interner Bewertung, während Terminal-Bench jeweils das beste veröffentlichte Harness eines Modells nutzt. Sie kombinieren extern gemeldete Artificial-Analysis-Ergebnisse mit Metas internen Bewertungen; der Personal Superintelligence Index ist Metas interne Kompositgröße, kein separates unabhängiges Ranking.
Muse-Ember-Benchmark-Ergebnisse
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 verwendet für Muse Ember mini-swe-agent, für Haiku 5.5 Claude Code und für GPT-6 Luna Codex. Das sind nicht identische Ausführungsumgebungen. OSWorld 2.1 berichtet sowohl Teilgutschrift- als auch Binärwerte, während PerceptionBench Tools einschließt. Die Ergebnisse des Artificial Analysis Intelligence Index stammen aus Version 5, veröffentlicht am 9. November 2026.
Analyse der Muse-Ember-Benchmark-Ergebnisse
Agenten-Ausführung ist Muse Embers stärkstes Feld.
Auf AutomationBench-AA erzielt Muse Ember 37.8, gegenüber 13.9 für Haiku 5.5 und 20.2 für GPT-6 Luna. Das stützt Metas Positionierung von Muse Ember als Modell für End-to-End-Geschäftsworkflows und wiederholte Agentenoperationen.
Coding-Leistung ist wettbewerbsfähig, aber nicht überall überlegen.
Muse Ember erzielt 40.9 auf Terminal-Bench 4.0 und 46 auf dem Coding Agent Index-AA. Auf FrontierCode 2.0-AA erreicht es jedoch 27.2, unter Haiku 5.5 mit 34.9. Das deutet darauf hin, dass Muse Ember ein nützlicher Kandidat für begrenzte Coding-Subtasks ist, während anspruchsvollere Ingenieursarbeit gegen stärkere Alternativen getestet werden sollte.
Multimodale Ergebnisse und Computer-Use sind vielversprechend.
Muse Ember erzielt 80.6 auf PerceptionBench mit Tools und 69.5 auf OSWorld 2.1 mit Teilgutschrift. Diese Ergebnisse stützen die Positionierung für Workflows mit visueller Verständnisleistung und Computerinteraktion.
Allgemeine Intelligenz ist vergleichbar mit Haiku 5.5.
Muse Ember und Haiku 5.5 runden beide auf 36 im Artificial Analysis Intelligence Index, vor GPT-6 Luna mit 28. Für die Auswahlentscheidung sollte dieser breite Vergleich mit den oben genannten aufgabenspezifischen Resultaten kombiniert werden.
Muse-Ember-Intelligenz vs. Kosten pro Aufgabe
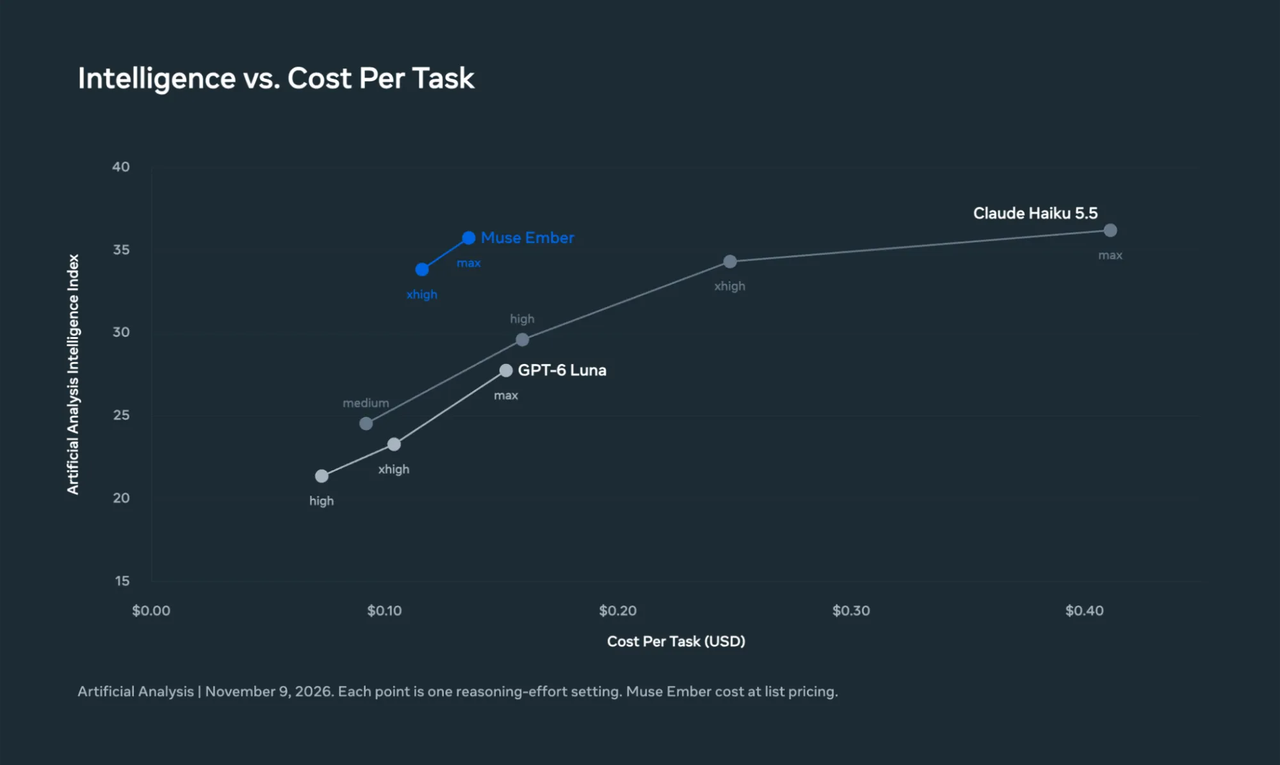
Metas Diagramm vergleicht Artificial-Analysis-Intelligence-Index-Werte mit geschätzten Kosten pro Aufgabe bei verschiedenen Reasoning-Aufwandsstufen.
Bei maximalem Reasoning-Aufwand erreicht Muse Ember auf dem Artificial Analysis Intelligence Index 35.8 bei geschätzten $0.136 pro Aufgabe. Haiku 5.5 erreicht 36.2 bei $0.411, während GPT-6 Luna 27.8 bei $0.152 erzielt. Auf diesem Benchmark kommt Ember nahe an Haikus Score bei etwa einem Drittel der Aufgabenkosten heran und übertrifft Lunas Score bei leicht geringeren Kosten.
Diese Schätzungen nutzen den Tokenverbrauch des Benchmarks und Listenpreise. Die nächste Bewertung zeigt, warum Tool-Aktivität bei der Wahl eines Modells für einen spezifischen Workflow wichtig ist.
Unabhängige Datenanalyse-Ergebnisse
Plotlys Datenanalyse-Bewertung vom 10. November 2026 testete 43 Fragen in Plotly Studio Embedded gegen einen synthetischen Windenergie-Datensatz. Muse Ember lief über OpenRouter; die angegebenen Kosten nutzen die Preise, die zum Laufzeitpunkt jedes Modells galten. Es handelt sich um workload-spezifische Ergebnisse, keinen Meta-nativen API-Abrechnungstest.
| Bewertungsmetrik | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Bestandene Fragen | 38/43 | 38/43 | 37/43 |
| Gesamtkosten des Tests | $1.04 | $0.13 | $0.38 |
| Medianzeit pro Frage | 28 Sekunden | 18 Sekunden | 14 Sekunden |
Für diese Datenanalyse-Workload lieferte GPT-6 Luna dieselbe Trefferzahl von 38/43 wie Ember zu einem Achtel der Gesamtkosten, bei geringerer medianer Antwortzeit. Haiku war mit 14 Sekunden pro Frage am schnellsten, mit 37/43 Treffern. Luna ist der stärkere Startkandidat für einen ähnlichen, kostenempfindlichen Analytics-Workflow; Embers niedriger Tokenpreis allein macht es nicht automatisch zur günstigeren Wahl.
Plotly stellte fest, dass Muse Ember bei Fragen mit verborgenen Mustern durchschnittlich 78 Abfragen auslöste, verglichen mit einem Median von 25 über die getesteten Modelle. Die zusätzliche Tool-Aktivität erhöhte den Tokenverbrauch und die Gesamtkosten.
Der Test zeigte auch Stärken: Muse Ember beantwortete alle 20 klar definierten Analytics-Fragen, alle fünf mehrdeutigen Fragen, alle fünf unmöglichen Anforderungen und alle drei Datenqualitätsprüfungen korrekt. Am meisten tat sich das Modell mit verborgenen Mustern in den Daten schwer.
Plotly ließ jedes Modell einmal laufen und beobachtete bei anderen Modellen Schwankungen bis zu drei Fragen bei Wiederholungen. Behandeln Sie die 38-gegen-37-Trefferzahlen als nahe beieinander; der klarere Unterschied hier ist die Tool-Nutzung und die Gesamtkosten.
Muse Ember vs Muse Wonder vs Muse Spark
Wählen Sie ein Muse-Modell nach der Verantwortung aus, die es übernimmt: Planung, die Haupt-Agentenschleife oder wiederholte Ausführung.
| Dimension | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Primäre Rolle | Frontier-Reasoning und komplexes Engineering | Hauptmodell für Coding und Agenten | Hochvolumige Ausführung |
| Hauptstärke | Planung, Langläuferaufgaben, komplexes Coding | Coding- und agentische Workflows | Wiederkehrende Subtasks und Tool-Aufrufe |
| Typische Workload | Engineering auf Repository-Ebene | Haupt-Agentenausführung | Klassifikation, Routing, Extraktion |
| API-Model-ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Kontextfenster | 1M Token | 1M Token | 1M Token |
| Standard-Reasoning | Max | High | Max |
| Standardpreis Input / 1 Mio. | $4.00 | $1.25 | $0.10 |
| Standardpreis Output / 1 Mio. | $20.00 | $4.25 | $0.50 |
Die Tabelle verwendet Metas Tokenpreise im Standardmodus. Embers Preise gelten hier für Anfragen bis 200K Eingabe-Token; Wonder und Spark haben nicht Embers Langkontext-Aufschlag.
Auswahl des Muse-Modells
Wählen Sie Wonder für schwierige Planung, Engineering auf Repository-Ebene und Erholung über lange Schrittfolgen. Wählen Sie Spark, um die Haupt-Coding- oder Agentenschleife auszuführen. Wählen Sie Ember für wiederholte Subtasks mit unabhängig verifizierbaren Outputs, z. B. Routing, Extraktion und gezielte Dateiänderungen.
Bei einer Repository-Migration kann z. B. die Abhängigkeitsanalyse an ein größeres Modell gehen und eine eng umrissene Dateiänderung an Ember. Die Übergabe sollte die Dateien, das erwartete Verhalten und Akzeptanzprüfungen benennen. Diese Arbeitsteilung ist nur dann nützlich, wenn Koordination und Review der kleineren Aufgaben weniger kosten, als den gesamten Job mit dem Hauptmodell abzuschließen.
Um zwischen ihnen zu wählen, lassen Sie dieselben repräsentativen Aufgaben mit denselben Akzeptanzprüfungen durch Ihre Kandidaten laufen. Verwerfen Sie zuerst Konfigurationen, die Ihre geforderte Erfolgsrate oder Latenz nicht erreichen. Unter den verbleibenden vergleichen Sie die Gesamtausgaben dividiert durch akzeptierte Ergebnisse, einschließlich Retries und Tool-Aufrufe. Weisen Sie Ember die Aufgabentypen zu, bei denen es diese Kosten senkt, und leiten Sie ungelöste Fälle zurück an Spark oder Wonder.
Wie viel kostet Muse Ember?
Die Tabelle kombiniert Metas offizielle Tarife mit einer 20%-Rabatt-Schätzung für CometAPI, in USD pro Million Token. Jede Zelle zeigt Meta / Rabatt-Schätzung. CometAPIs Listing veröffentlicht noch keinen Live-Tarif; nutzen Sie die rabattierten Werte für die Budgetplanung.
| Nutzung pro 1 Mio. Token (Meta / 20%-Rabatt) | Bis 200K Eingabe-Token | Über 200K Eingabe-Token |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Cacher Input | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
Die gesamten Eingabe-Token einer Anfrage, einschließlich gecachter Eingaben, bestimmen die Stufe. Eine Anfrage über 200K Eingabe-Token verwendet die höheren Sätze für die gesamte Anfrage, einschließlich Output. Mit Metas previous_response_id zählt gespeicherte Gesprächshistorie zum Eingabetotal.
Typische Muse-Ember-Anfragekosten
Bei ungecachter Eingabe und 20K abgerechneten Output-Token, einschließlich Reasoning, kostet eine Anfrage mit 200K Input $0.0300 zu Metas Tarifen oder $0.0240 im 20%-Rabatt-Szenario. Erhöht man die Eingabe auf 220K, wechselt die gesamte Anfrage in die höhere Stufe: derselbe 20K-Output führt dann zu Gesamtkosten von $0.0960 nach Metas Tarifen bzw. geschätzten $0.0768 mit Rabatt. Diese Beispiele schließen separate Tool-Gebühren aus. Relevanten Kontext innerhalb der niedrigeren Stufe zu halten, kann mehr sparen als ein 20%-Rabatt allein.
| Szenario | Eingabe-Token | Abgerechnete Output-Token | Meta-Kosten | CometAPI-Kosten |
|---|---|---|---|---|
| Standardanfrage | 200K | 20K | $0.0300 | $0.0240 |
| Langkontext-Anfrage | 220K | 20K | $0.0960 | $0.0768 |
Reasoning-Token zählen als abgerechneter Output. Für Metas native API kostet Web Search Grounding zusätzlich $2.50 pro 1,000 Abfragen, und Ember hat keine Contributor-Mode-Variante. Der obenstehende Tokenpreisvergleich wendet den 20%-Rabatt nicht auf separate Tool-Gebühren an.
Wie greifen Sie auf Muse Ember zu?
CometAPI-Listing: die Modellseite identifiziert das Modell als muse-ember, der Katalogstatus ist Stand 16. November 2026 Coming soon. Folgen Sie der Seite für Aktivierung und Preise; für sofortigen Zugriff nutzen Sie Meta Model API oder Muse Code.
Über die Meta Model API: verwenden Sie muse-ember-1.0 mit https://api.meta.ai/v1. Die native API unterstützt Responses-, Chat-Completions- und Messages-Formate. Dateieingaben nutzen Responses. Halten Sie beim Konfigurieren Ihres Clients die Endpunkte und Modellkennungen des jeweiligen Providers zusammen.
Native API-Limits und anderer Zugriff: Meta listet 3,000 Anfragen pro Minute und 4,000,000 Token pro Minute pro Team, geteilt von den API-Schlüsseln des Teams. Muse Ember ist auch in Muse Code verfügbar. Prüfen Sie die Limits Ihres gewählten Zugangswegs bei der Batch-Planung und verwenden Sie Metas Integrationsleitfaden für das Setup der nativen API.
Was sind die Einschränkungen von Muse Ember?
Drei Faktoren bestimmen, ob Ember für Ihren nächsten Workflow geeignet ist:
- Komplexes Engineering bleibt workload-abhängig. Ember liegt auf FrontierCode 2.0-AA hinter Haiku 5.5, trotz stärkerem Terminal-Bench-Ergebnis. Ein enger Coding-Sieg belegt nicht die Eignung für jede Änderung auf Repository-Ebene.
- Langer Kontext und niedrige Tokenpreise garantieren keine niedrigen Aufgabenkosten. Große Anfragen wechseln in eine höhere Preisstufe, und wiederholte Tool-Nutzung kann genug Token verbrauchen, um den niedrigen Preis pro Token zu überwiegen.
- Tool-Unterstützung benötigt weiterhin eine Anwendung. Das umgebende System führt Aufrufe aus, steuert Berechtigungen und validiert Ergebnisse. Die Fähigkeit eines Modells, eine Aktion anzufordern, liefert für sich genommen keinen verlässlichen Workflow.
Fazit
Setzen Sie Ember dort ein, wo die Abnahmekriterien klar genug sind, um sie zu messen. Ein sinnvoller Ersteinsatz ist ein hochvolumiger Schritt mit bereits bekanntem Ergebnis, z. B. das Routing gelabelter Tickets oder das Extrahieren von Feldern aus geprüften Dokumenten. Vergleichen Sie Kosten pro erfolgreiche Aufgabe, Fehlerraten und Latenz mit Ihrem aktuellen Modell, bevor Sie die Rolle ausweiten. Diese Evidenz zeigt, ob Ember die Kosten Ihres Workflows senkt und dabei die nötige Qualität bewahrt.
FAQ
Wie sollten Sie Muse-Ember-Extraktionsergebnisse validieren?
Bauen Sie einen Referenzsatz von Dokumenten mit menschlich geprüften Antworten auf, einschließlich fehlender Felder, unlesbarer Scans und widersprüchlicher Werte. Messen Sie Genauigkeit feldweise, statt jede gültige JSON-Antwort als Erfolg zu behandeln. Prüfen Sie, ob jeder extrahierte Wert durch die zitierte Quellenpassage gestützt wird, und senden Sie Fehlzuordnungen zur Überprüfung. So trennen Sie Formatzuverlässigkeit von faktischer Zuverlässigkeit.
Wann sollte ein Muse-Ember-Subtask an den Hauptagenten zurückgegeben werden?
Definieren Sie Eskalationsbedingungen vor der Ausführung: Eine benötigte Datei liegt außerhalb des zugewiesenen Umfangs, die Quellen widersprechen sich, eine Akzeptanzprüfung schlägt wiederholt fehl oder die Aufgabe erfordert eine Entscheidung, zu der der Worker nicht autorisiert war. Geben Sie Evidenz, unternommene Schritte und die offene Frage an den Hauptagenten zurück. Eine klare Übergabe ist hilfreicher, als den Worker seinen Auftrag unbegrenzt ausweiten zu lassen.
Was sollten Sie loggen, wenn Sie Muse Ember in der Produktion testen?
Protokollieren Sie den exakten Provider und die Modellkennung, die Reasoning-Einstellung, Eingabe- und abgerechnete Output-Token, gecachte Token, die Anzahl der Tool-Aufrufe, Retries, Latenz und das finale Akzeptanzresultat. Halten Sie das Validierungsergebnis zusammen mit dem Nutzungsdatensatz fest, damit Sie Kosten pro akzeptierter Aufgabe berechnen können. Vergleichen Sie ähnliche Aufgabentypen getrennt; ein Durchschnitt über Routing, Coding und Langdokumente kann verschleiern, wo das Modell hilft oder Kosten verursacht.
Wie können Sie doppelte Aktionen in einem Muse-Ember-Workflow verhindern?
Lassen Sie die Anwendung für Aktionsidentität und Abschlusszustand verantwortlich sein. Weisen Sie für eine Operation wie das Erstellen eines Tickets einen stabilen Operationsschlüssel zu, prüfen Sie, ob sie bereits abgeschlossen wurde, und nutzen Sie die Idempotenz-Unterstützung der Ziel-API, wo verfügbar. Nach einem Timeout inspizieren Sie den Status der Aktion, bevor Sie erneut versuchen. Dieses Design vermeidet, eine unsichere Antwort als Beweis zu behandeln, dass die ursprüngliche Aktion nie stattgefunden hat.