TL;DR
MiMo-V2.6 ist Xiaomis neue Familie offen verfügbarer, nativ multimodaler, agentenorientierter Reasoning-Modelle. MiMo-V2.6-Pro verwendet ein sparsames MoE-Design mit insgesamt 1,02 Billionen Parametern und etwa 42 Milliarden aktivierten Parametern pro Token, während MiMo-V2.6-Flash 309 Milliarden Gesamtparameter und etwa 15 Milliarden aktivierte Parameter nutzt. Beide unterstützen ein Kontextfenster von 1M Tokens sowie multimodale Eingaben einschließlich Text, Bilder, Video und Audio.
Zentrale Erkenntnisse
- MiMo-V2.6-Pro ist ein Sparse-MoE-Modell mit 1,02T Parametern und etwa 42B aktivierten Parametern pro Token; Flash nutzt 309B insgesamt und etwa 15B aktivierte Parameter.
- Beide Modelle unterstützen ein 1M-Token-Kontextfenster, multimodale Eingabe und bis zu 128K Ausgabetokens über Xiaomis API.
- Die Familie ist ausgelegt auf Reasoning, Tool-Nutzung, Websuche, strukturierten Output und langlaufende Agent-Workflows.
- Xiaomi hat V2.6 mit gemischtem Reinforcement Learning über Coding, allgemeine Agenten, visuelle Tasks und Cybersicherheitsumgebungen trainiert.
- Offizielle Ergebnisse positionieren Pro als Option mit höherer Fähigkeit und Flash als kostengünstige, skalierbare Option; arbeitslastspezifische Evaluierung bleibt notwendig.
Was ist Xiaomi MiMo-V2.6?
MiMo-V2.6 ist die neueste Generation von Xiaomis MiMo-Modellfamilie. Der Fokus liegt nicht nur auf besseren Antworten, sondern auf der Ausführung langer Aktionssequenzen: Umgebung inspizieren, Tools aufrufen, Ergebnisse beobachten, Fehler korrigieren und fortfahren, bis ein Ziel erreicht ist. Xiaomi rahmt die Veröffentlichung mit Recursive Self-Improvement (RSI), also einem RL-Trainingsloop, in dem das Modell wiederholt Umgebungen erkundet, reichere Belohnungssignale erhält, Trajektorien vergleicht und effektivere Strategien lernt. Dies sollte nicht so interpretiert werden, dass das Modell autonom seinen eigenen Nachfolger umschreibt und trainiert.
Pro vs Flash vs UltraSpeed: Was ist der Unterschied
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positionierung | Flaggschiff-Reasoning | Hohe Stückzahl / Preis-Leistung | Flaggschiff mit niedriger Latenz |
| Gesamtparameter | 1.02T | 309B | Gleiches Pro-Modell |
| Aktive Parameter | 42B | 15B | Gleiche Pro-Fähigkeit |
| Architektur | Sparse MoE | Sparse MoE | Pro-Serving-Modus |
| Kontext | 1M | 1M | 1M |
| Maximale Ausgabe | 128K | 128K | 128K |
| Text-/Bild-/Video-/Audioeingabe | Yes | Yes | Yes |
| Tiefes Reasoning / Tool-Aufrufe | Yes | Yes | Yes |
| Strukturierter Output / Kontext-Caching | Yes | Yes | Yes |
| Hauptvorteil | Maximale Fähigkeit | Kosteneffizienz | Bis zu 20× schnelleres Serving |
MiMo-V2.6-Pro oder Flash: Welches sollten Sie verwenden?
Pragmatische Wahl: Wählen Sie MiMo-V2.6-Pro für anspruchsvolle, langlaufende Aufgaben in Engineering, Forschung, Cybersicherheit und hochwertigen Agent-Workloads; wählen Sie MiMo-V2.6-Flash für hochvolumige Automatisierung, Dokument- und multimodale Verarbeitung sowie kostenempfindliche, wiederholte Aufrufe; wählen Sie MiMo-V2.6-Pro-UltraSpeed, wenn Pro-Level-Reasoning benötigt wird, aber Latenz dominiert. UltraSpeed ist eine Serving-Stufe und kein Modell mit anderen Fähigkeiten; es wird mit bis zu 20× der Ausgabegeschwindigkeit des Standard-Pro beworben.
Wie funktioniert Xiaomi MiMo-V2.6?
Sparse Mixture-of-Experts-Architektur
MiMo-V2.6 aktiviert nicht den gesamten Parametersatz für jedes Token. Das Flaggschiff-Checkpoint Pro enthält 1,02 Billionen Gesamtparameter, aber pro Token sind nur etwa 42 Milliarden aktiv. Die Model Card von Xiaomi beschreibt 70 Transformer-Schichten, 384 geroutete Experten und acht gleichzeitig aktivierte Experten. Flash ist deutlich kleiner mit 309B insgesamt / 15B aktiv, 48 Transformer-Schichten und 256 gerouteten Experten.
| Architektur-Spezifikation | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Gesamtparameter | 1.02T | 309B |
| Aktivierte Parameter | 42B | 15B |
| Transformer-Schichten | 70 | 48 |
| Hidden Size | 6,144 | 4,096 |
| Geroutete Experten | 384 | 256 |
| Aktivierte Experten | 8 | 8 |
| Maximale Kontextlänge | 1M | 1M |
| MiMo ViT | 681M Params | 681M Params |
| AudioTokenizer | 308M Params | 308M Params |
| Audio Patch Encoder | 127M Params | 127M Params |
| Spekulativer Decoder | 5 Schichten | 5 Schichten |
Die Architektur kombiniert Sliding-Window-Attention mit Global-Attention-Schichten und umfasst einen fünfstufigen spekulativen Decoder für Multi-Token-Prediction. Praktisch bedeutet das: Schlagzeilen-taugliche Parameterzahl und pro-Token-Compute sind sehr unterschiedliche Größen; Sparse Routing erlaubt es Xiaomi, einen großen Experten-Pool zu unterhalten, ohne für jedes Token eine dichte Inferenz über alle Gewichte auszuführen.
Native multimodale Verarbeitung
MiMo-V2.6 nutzt Xiaomis MiMo ViT mit 681M Parametern zur visuellen Kodierung sowie dedizierte Audio-Komponenten. So kann derselbe Agent Textanweisungen, Screenshots, Fotos, Video und Audio verarbeiten. Für Computer-Use-Agenten ist native Multimodalität wichtig, weil Wahrnehmung und Entscheidungsfindung im selben Reasoning-Loop stattfinden können, statt auf getrennte, nutzerorientierte Modelle verteilt zu sein.
Warum ist Reinforcement Learning für MiMo-V2.6 so wichtig?
Xiaomi berichtet, dass sowohl Flash als auch Pro in einem sechstägigen öffentlichen Trainingsexperiment etwa 30 RL-Schritte und rund 750.000 Trajektorien durchliefen. Die gemeldeten Trainingskosten lagen bei etwa 850.000 $ für Flash und 2,62 Millionen $ für Pro. Jedes Update nutzte 1.568 Trainingsbeispiele, einzelne Trainingsschritte erreichten etwa 3,5–3,7 Milliarden Tokens. Der Task-Mix umfasste Code, allgemeine Agenten, visuelle Tasks, Cybersicherheit und mehrere Agent-Harnesses.
Während dieses RL-Prozesses stieg laut Xiaomi die Out-of-Sample-DeepSWE-v1.1-Score von 48.8 auf 65.7 für Flash und von 58.4 auf 72.6 für Pro. Diese Zahlen beschreiben das Live-RL-Experiment und sollten nicht mit allen finalen Benchmark-Scores für die veröffentlichten Checkpoints verwechselt werden, da sich die Evaluations-Setups unterscheiden können.
Gruppenweise agentische Bewertung
Für das Agenten-Training kann eine binäre Pass/Fail-Belohnung bedeutsame Unterschiede zwischen zwei erfolgreichen Trajektorien verschleiern. Eine Lösung kann mit wenigen Tool-Aufrufen schnell zum Ziel kommen, während eine andere Dutzende Schritte vergeudet. Xiaomi beschreibt daher Groupwise Reward Synthesis und Groupwise Advantage Redistribution als Mechanismen, um Trajektorien innerhalb einer Gruppe zu vergleichen und das Lernsinal zugunsten saubererer Lösungen umzuverteilen. Ziel ist es, nicht nur die Aufgabenerfüllung, sondern auch die Effizienz des eingeschlagenen Pfads zu verbessern.
Wie gut ist Xiaomi MiMo-V2.6 auf Agent-Benchmarks?
Die stärksten öffentlichen Belege für V2.6 konzentrieren sich auf agentische Benchmarks statt auf konventionelle Multiple-Choice-Tests. Xiaomis offizielle Grafik vergleicht Pro und Flash mit MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol und Fable 5 über Coding-, General-Agent-, Cybersecurity- und Visual-Agent-Tasks hinweg.
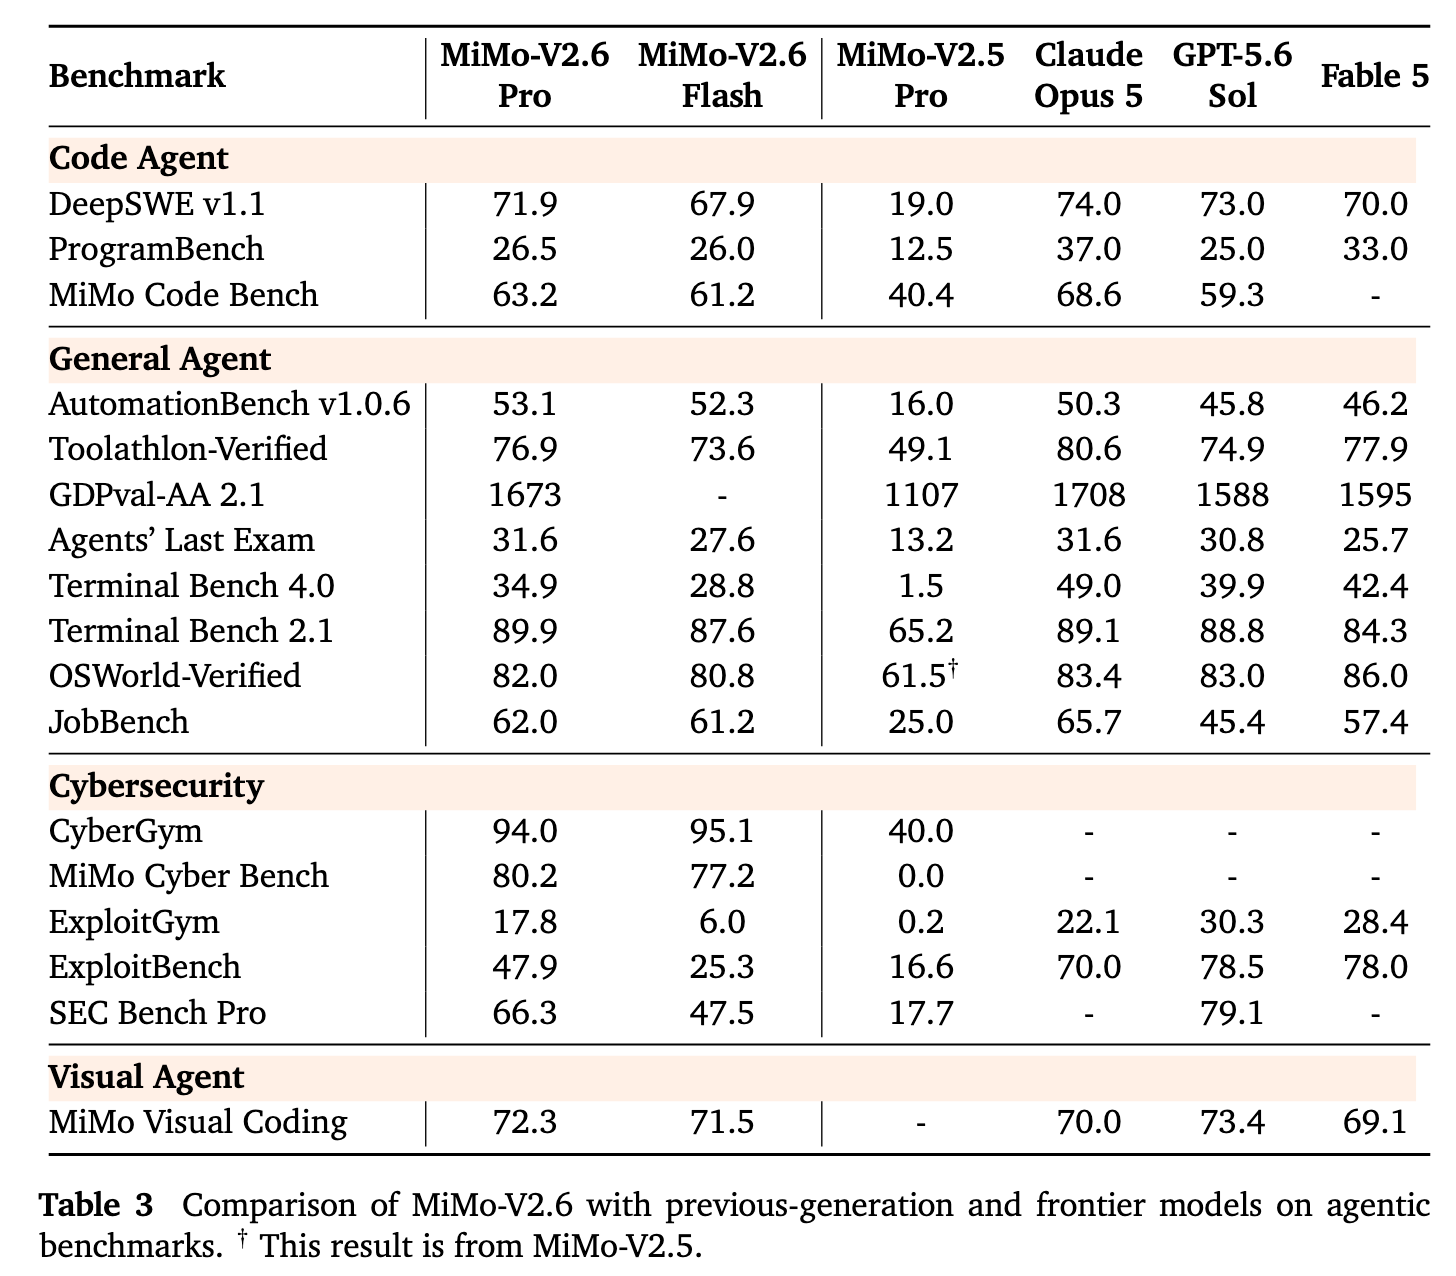
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding-Fortschritt
Die Coding-Gewinne zeigen sich am deutlichsten in langlaufender Ausführung. Während des Live-RL-Laufs berichtet Xiaomi, dass die Out-of-Sample-DeepSWE-v1.1 von 48.8 auf 65.7 für Flash und von 58.4 auf 72.6 für Pro stieg. In der veröffentlichten Cross-Model-Tabelle erreicht Pro 71.9 auf DeepSWE v1.1 und 63.2 auf MiMo Code Bench, während Flash 67.9 bzw. 61.2 erreicht. Pro gewinnt nicht jeden Coding-Test—Claude Opus 5 liegt bei DeepSWE, ProgramBench und MiMo Code Bench vorn—doch V2.6 kombiniert wettbewerbsfähige Performance im Repository-Maßstab mit offenen Gewichten und deutlich niedrigeren API-Preisen.
Reasoning- und Agentik-Fortschritt
Der Reasoning-Fortschritt ist eher als verbesserte Planung, Tool-Nutzung und Recovery zu verstehen denn als einzelner abstrakter Intelligenzwert. Pro verzeichnet 89.9 auf Terminal Bench 2.1, 53.1 auf AutomationBench und 76.9 auf Toolathlon-Verified; Flash erreicht 87.6, 52.3 und 73.6. Pro liegt leicht über den aufgeführten Ergebnissen von Claude Opus 5 und GPT-5.6 Sol auf Terminal Bench 2.1, während beide V2.6-Modelle diese Vergleichsmodelle auf AutomationBench anführen. Xiaomi schreibt die Verbesserung gruppenweisem Trajektorienvergleich, reicheren Gradern, Multi-Harness-Training und Belohnungssignalen zu, die kürzere, sauberere Lösungswege bevorzugen.
Wissen und Forschungsfortschritt
Wissensintensive Fortschritte werden eher durch agentische Bewertungen und Demos als durch eine konventionelle Wissensprüfungs-Suite gestützt. Pro erreicht 31.6 auf Agents' Last Exam, gleichauf mit Claude Opus 5, und 62.0 auf JobBench. Xiaomi berichtet außerdem über Materialforschungs-Workflows mit Literatur- und Patentrecherche, Hypothesengenerierung und computergestütztem Screening sowie ein Lean-4-Formaliserungsprojekt mit über 6.000 verifizierten Zeilen. Diese Beispiele deuten auf stärkere Retrieval-, Synthese-, formale Reasoning- und Tool-gestützte Wissensarbeit hin, sollten jedoch nicht als unabhängiger Beweis universeller Wissensüberlegenheit gelten.
Overall: Der Fortschritt von V2.6 ist breit, aber uneinheitlich. Am stärksten ist der Nachweis verbesserter langlaufender Coding- und Agentenausführung, während Aussagen über allgemeines Reasoning und Wissen an spezifische Benchmarks, Harnesses und Demonstrationen gebunden bleiben sollten.
Benchmark-Hinweis: Sofern nicht anders angegeben, stammen die folgenden Cross-Model-Ergebnisse aus Xiaomis MiMo-V2.6-Model Card. Scores können von Benchmark-Versionen, Agent-Harnesses, Tool-Konfigurationen, Inferenzbudgets und Evaluationsprotokollen abhängen und sollten nicht als unabhängig reproduzierte Rangliste interpretiert werden.
MiMo-V2.6 vs MiMo-V2.5: Was hat sich geändert?
| Dimension | MiMo-V2.5-Generation | MiMo-V2.6-Durchbruch |
|---|---|---|
| Trainingsfokus | Starke multimodale Agenten, langer Kontext, Token-Effizienz | Deutlich größeres gemischtes RL-Programm über Code, allgemeine Agenten, Vision, Cybersicherheit und mehrere Harnesses |
| Agentenfähigkeit | V2.5-Pro zielte auf schwierige, langlaufende Arbeit | Xiaomi berichtet, dass V2.6-Flash V2.5-Pro über die eigene Agenten-Benchmark-Suite hinweg umfassend übertrifft |
| Lerneffizienz | Vorheriger Produktions-Checkpoint | Etwa 750.000 Trajektorien über 30 RL-Schritte; Held-out-DeepSWE-Gewinne von rund 17 Punkten für Flash und 14 Punkten für Pro im Training |
| Offenheit | Offene Gewichte und Ökosystem-Support | Ergänzt vollständigen RL-Code, 7.000+ Task-Umgebungen, Trainings-Framework, leichte Harnesses und einen 9B-Distillations-Checkpoint |
| Ökonomie | Bestehendes V2.5-API-Preisniveau | Höhere gemeldete Intelligenz bei gleichen offiziellen API-Preisen; verschiebt die Capability-Cost-Frontier nach außen |
Coding und Agentenausführung
Gegenüber V2.5 ist die deutlichste Änderung eine stärkere Agenten-Policy statt eines längeren Kontextfensters. Xiaomi berichtet, dass V2.6-Flash V2.5-Pro über die eigene Agenten-Benchmark-Suite hinweg übertrifft. Während des V2.6-Trainingslaufs verbesserte sich die Held-out-DeepSWE v1.1 von 48.8 auf 65.7 für Flash und von 58.4 auf 72.6 für Pro; diese Trainingslauf-Scores sind nicht direkt mit der oben stehenden Benchmark-Tabelle der veröffentlichten Modelle austauschbar.
Reasoning, Wissen und Trainingsbreite
V2.6 erweitert Reinforcement Learning über Coding, allgemeine Agenten, Vision, Cybersicherheit und mehrere Harnesses. Xiaomi berichtet über rund 750.000 Trajektorien über etwa 30 RL-Schritte. Das unterstützt breitere Planung, Tool-Nutzung und Recovery, belegt jedoch für sich genommen keinen universellen Gewinn auf jedem Wissens- oder Reasoning-Benchmark; vergleichen Sie abgestimmte Tasks und Evaluations-Setups.
Migration und Offenheit
Die Veröffentlichung ergänzt außerdem RL-Code, mehr als 7.000 Task-Umgebungen, Trainingsinfrastruktur und einen 9B-Distillations-Checkpoint. Das 1M-Token-Kontextfenster und multimodale Eingaben sind Kontinuitäten aus V2.5, keine neuen V2.6-Durchbrüche.
Die praktische Änderung ist daher nicht ein neues Kontextfenster—das 1M-Kontextfenster und volle Multimodalität gab es bereits in V2.5—, sondern eine stärkere Agenten-Policy, trainiert mit deutlich mehr Reinforcement-Learning-Compute und breiteren verifizierbaren Umgebungen. Xiaomi hat angekündigt, dass die Modellnamen V2.5 und V2.5-Pro am 21. Oktober 2026 nicht mehr funktionieren; neue Deployments sollten auf V2.6 zielen, und bestehende Deployments sollten Migrations-Tests planen.
Wie V2.6 im Vergleich zu anderen Spitzenmodellen abschneidet
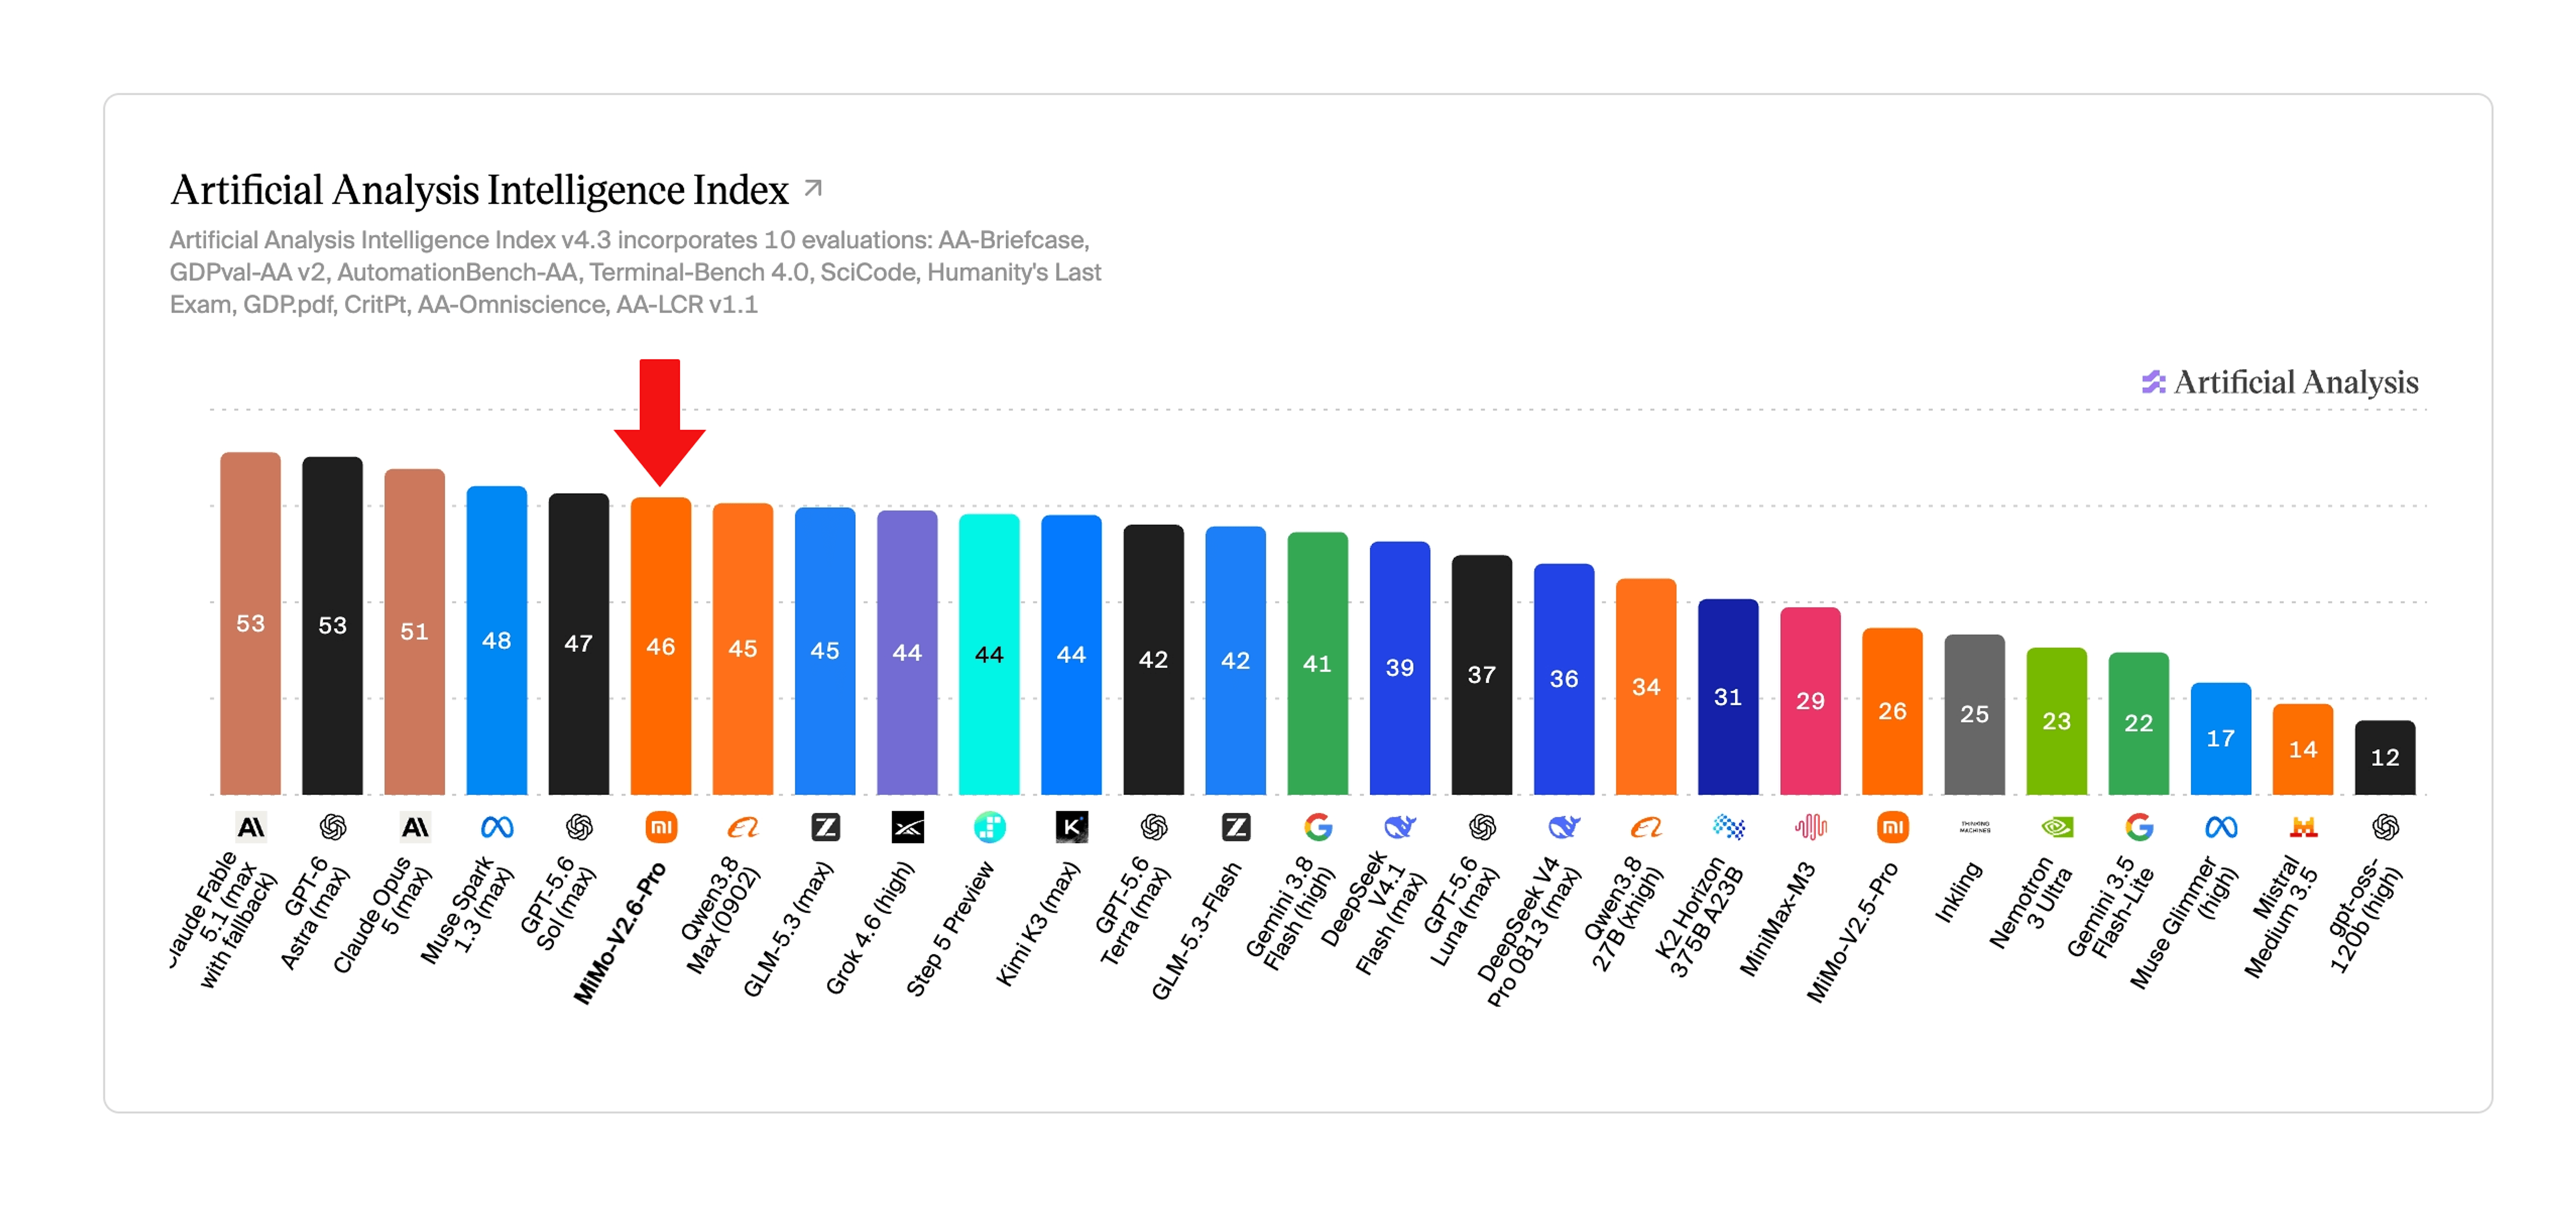
| Dimension | MiMo-V2.6-Pro | Geschlossene Spitzenmodelle | Andere Open-Weight-Modelle |
|---|---|---|---|
| Gewichte | Offene Gewichte | Typischerweise geschlossen | Modellabhängig |
| Verifizierter MiMo-Kontext | 1M Tokens | Jeweilige offizielle Modellseite prüfen | Jeweilige Model Card prüfen |
| Verifizierte MiMo-Modalitäten | Text, Bild, Video, Audio | Anbieterabhängig | Modellabhängig |
| Agentenfokussiertes RL | Starker Veröffentlichungsfokus | Abhängig von Modell und System | Abhängig von Modell und Checkpoint |
| Self-Hosting | Ja, mit erheblicher Infrastruktur | In der Regel nein | Häufig möglich bei offenen Checkpoints |
| Primärer MiMo-Vorteil | Offene Gewichte, native Multimodalität, niedrige API-Kosten | Anbieter-Ökosystem und Managed-Tooling | Variiert je nach Lizenz, Größe, Deployment-Stack |
Für einen aktuellen Vergleich evaluieren Sie MiMo-V2.6 gegenüber Claude Opus 5.5 für langlaufende agentische Programmierung, Claude Fable 5.1 für die schwierigste autonome Arbeit, GPT-6 Sol und Gemini 4 Pro. Verfügbarkeit und Preise der Modelle sind dynamisch; Produktionsvergleiche sollten den Live-Katalog sowie abgestimmte Prompts, Tools, Budgetgrenzen und Akzeptanzkriterien verwenden.
Was kann Xiaomi MiMo-V2.6 tatsächlich?
Coding- und Software-Engineering-Agenten
MiMo-V2.6 ist für lange Software-Engineering-Trajektorien ausgelegt: Repositories inspizieren, Code ändern, Terminal-Tools verwenden, Tests ausführen, Fehler diagnostizieren und fortfahren, bis ein Ziel erfüllt ist. Die Ergebnisse auf DeepSWE, Terminal Bench, AutomationBench und Toolathlon deuten darauf hin, dass Xiaomi auf Ausführung statt nur Codevervollständigung optimiert. Praktische Workloads umfassen Coding-Agenten, automatisiertes Debugging, Repository-Refactoring, CI-Issue-Resolution und Multi-Tool-Engineering-Workflows.
Computerbedienung
Xiaomi demonstriert ausdrücklich einen Computer Use Agent (CUA). Das Modell kann grafische Oberflächen interpretieren, Informationen abrufen, Inhalte bearbeiten, Daten verarbeiten, Ergebnisse inspizieren, Probleme diagnostizieren und nach visueller Rückmeldung die nächsten Aktionen ändern. In diesem Workflow ist die Modellausgabe oft nicht das Endprodukt; sie bestimmt stattdessen die nächste Software- oder Browseraktion.
3D-Welten und Blender-Workflows
Unter dem Konzept „Vibe World“ kann MiMo-V2.6 Text-, Bild- oder Video-Referenzen aufnehmen und eine 3D-Anforderung in Szenenkonstruktion, Interaktionsprogrammierung und visuelle Verifikation zerlegen. Xiaomi demonstriert zudem, wie das Modell Blender steuert, um 3D-Objekte und -Szenen aus Beschreibungen oder Referenzbildern zu erstellen. Dies erweitert Vibe Coding über Anwendungscode hinaus in interaktive Umgebungen.
Robotik und embodied Agents
Xiaomi demonstriert MiMo-V2.6 in einer verkörperten Simulationsumgebung mit Multiview-Kamerabildern und einem Franka Panda-Roboterarm. Beispielaufgaben umfassen Objekte greifen, Farbabgleich und präzises Platzieren. Das etabliert V2.6 nicht als universelles Robotik-Foundation-Modell, zeigt aber, wie native Vision und langlaufende Entscheidungsfindung mit verkörperten Kontrollschleifen verbunden werden können.
Wissenschaftliche Forschung und formales Reasoning
Xiaomi berichtet über einen materialwissenschaftlichen Fall, in dem MiMo-V2.6-Pro Forschende bei Metall-Organischen Gerüsten (MOFs) für PFAS-Adsorption unterstützte, einschließlich Literatur- und Patentrecherche, Kandidatenformulierung und Aufrufen von Rechen-Tools. In einem weiteren Experiment half das Modell, den Hauptsatz aus „Period Three Implies Chaos“ in Lean 4 zu formalisieren. Xiaomi berichtet über ein abgeschlossenes Projekt mit über 6.000 Zeilen Lean-Code, vom Lean-Kernel ohne unbelegte Platzhalter verifiziert. Diese Beispiele sind am besten als Demonstrationen agentischer Forschungs-Workflows zu verstehen, nicht als Beweis autonomer wissenschaftlicher Entdeckung.
Websites, Präsentationen, Video und Musik
MiMo-V2.6 kann Frontend-Coding, Design-Workflows, Folien, SVG-Assets, Video-Pipelines und Musikproduktions-Tools koordinieren. Xiaomi demonstriert die Orchestrierung mit spezialisierten Mediensystemen, einschließlich Sprachsynthese via MiMo-V2.5-TTS, statt zu behaupten, dass V2.6 selbst jeden Bild-, Video- oder Audiogenerator ersetzt. Das Modell passt sich daher natürlich als Orchestrator der kreativen Produktion ein.
Die in diesem Abschnitt genannten Use Cases sind Xiaomi-Demonstrationen, kein unabhängiger Beleg dafür, dass jede Implementierung dieselben Ergebnisse reproduziert. Produktionsteams sollten das Modell mit eigenen Tools, Berechtigungen, Fehlertoleranzen und Evaluationskriterien testen.
Wie viel kostet Xiaomi MiMo-V2.6?
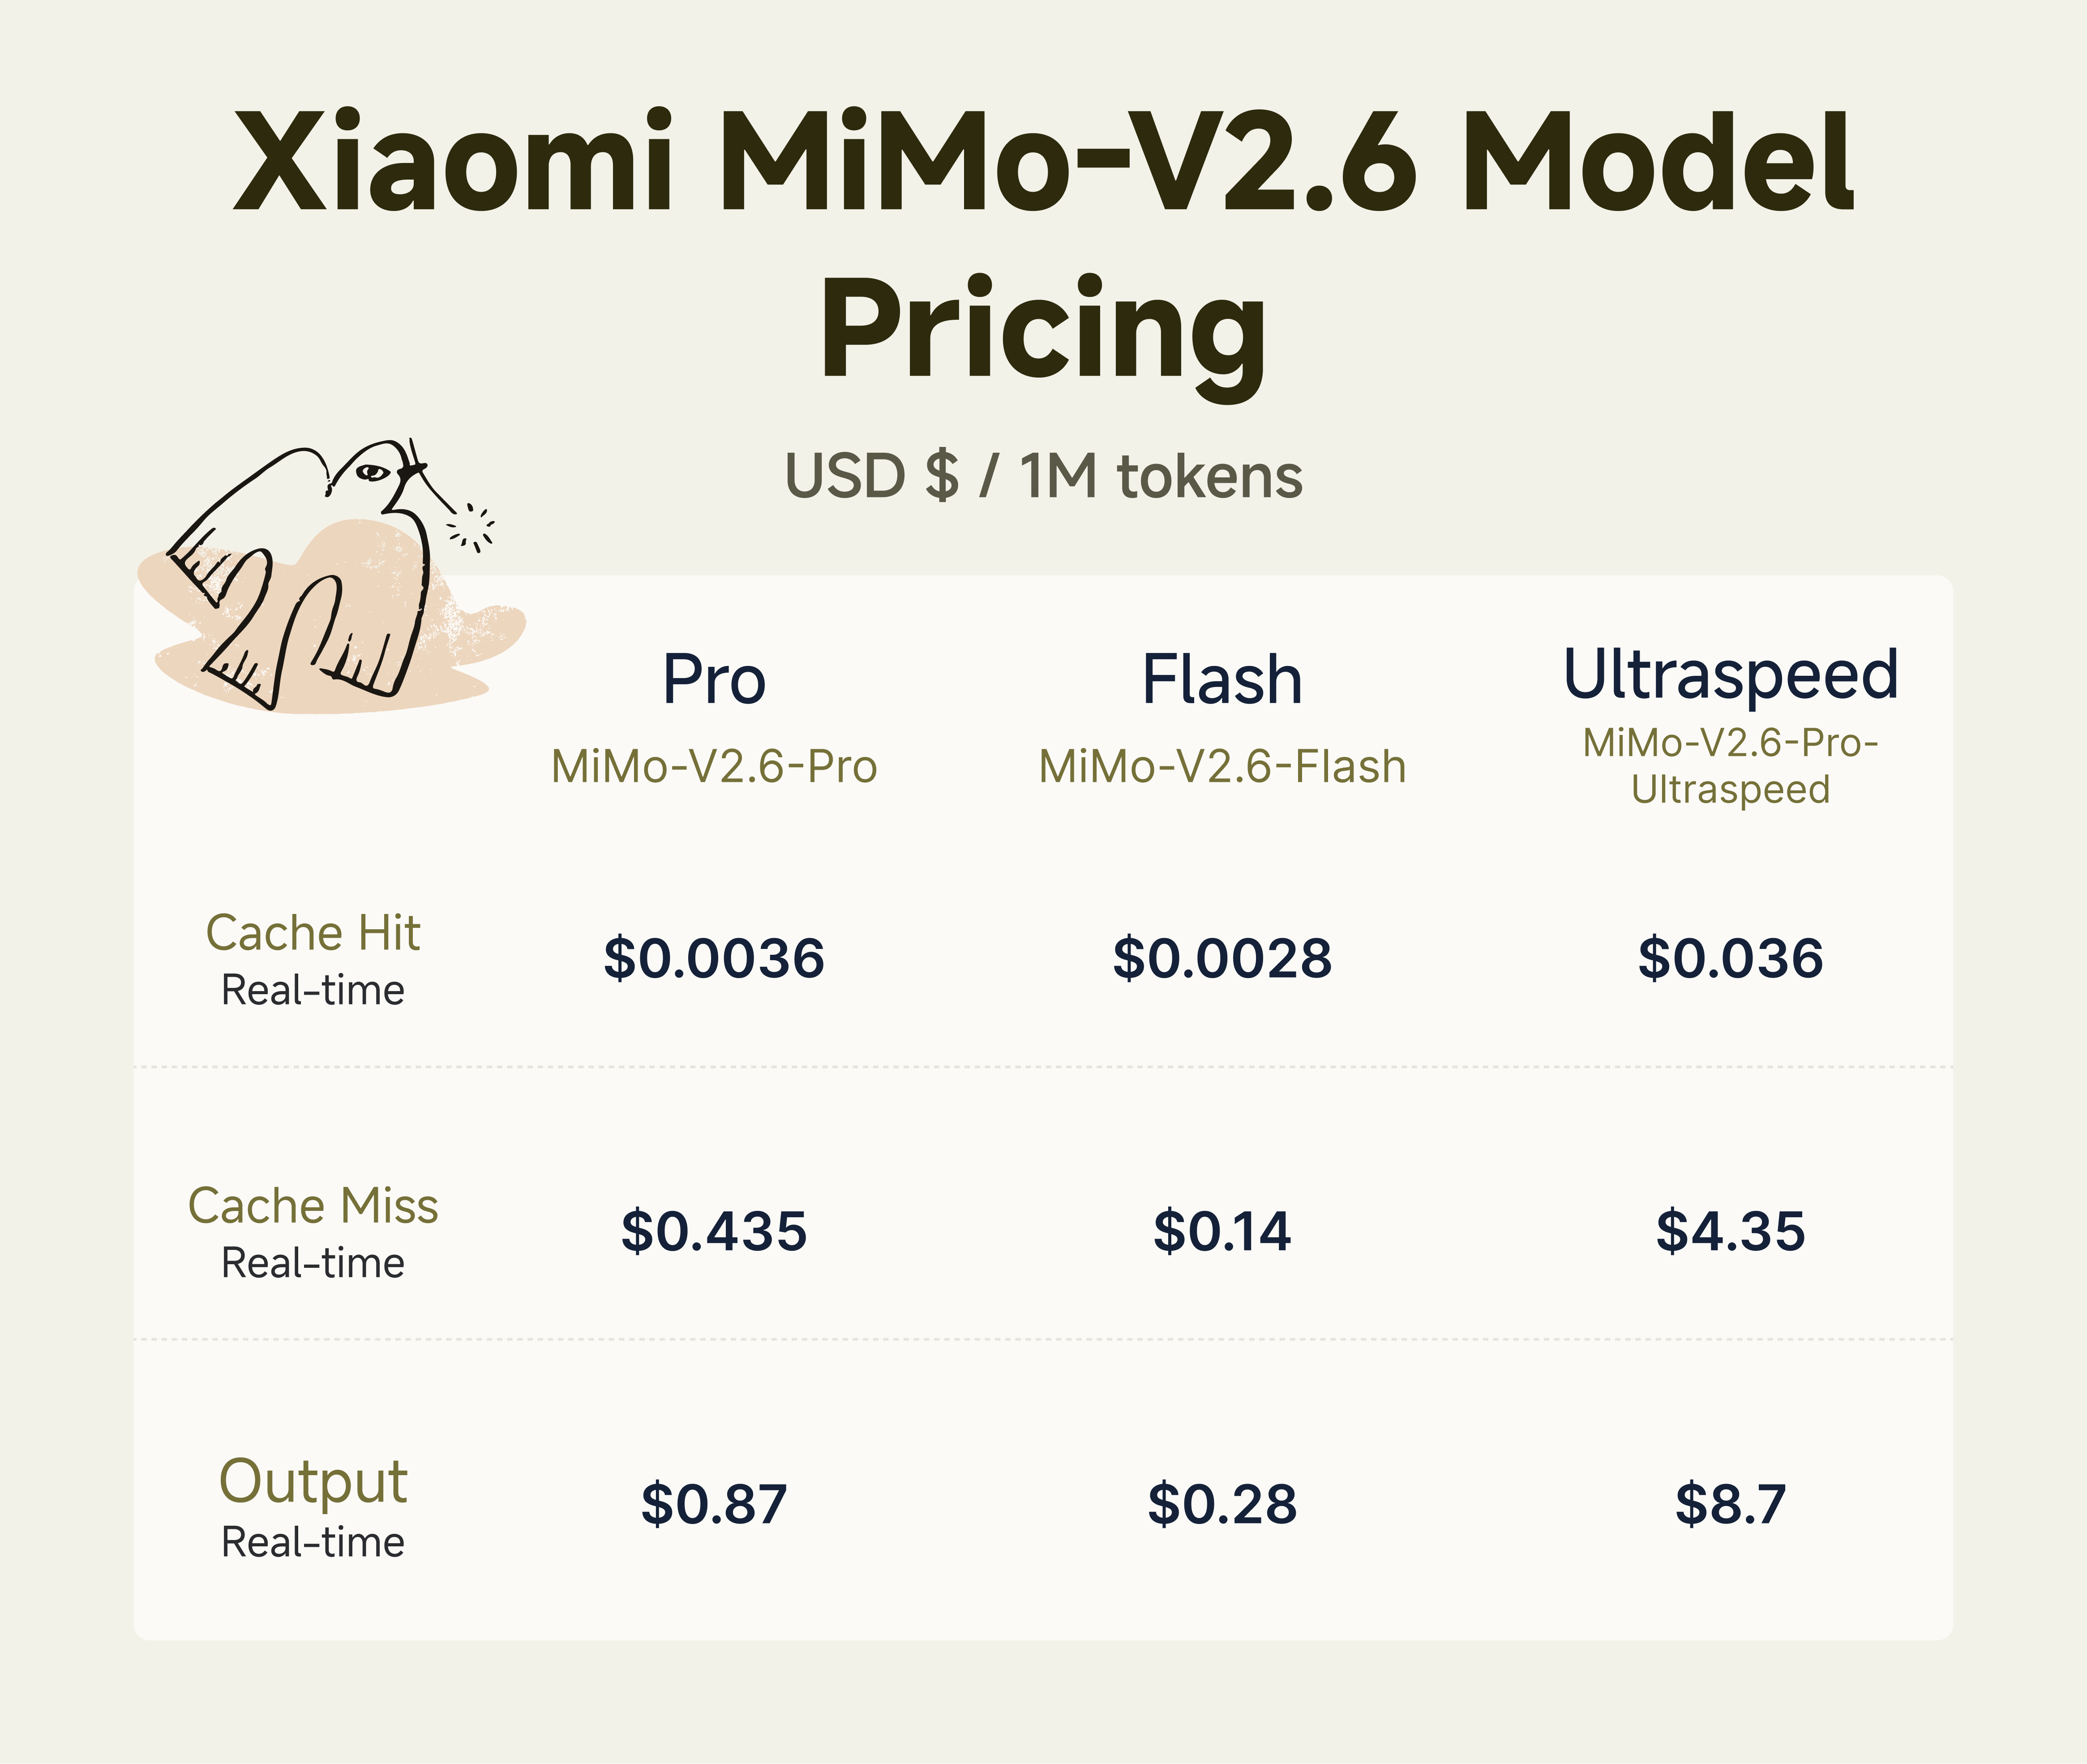
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Gecachter Input / 1M Tokens | $0.0036 | $0.0028 | $0.036 |
| Ungecachter Input / 1M Tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M Tokens | $0.87 | $0.28 | $8.70 |
Xiaomi hält die V2.6-API-Preise auf dem gleichen groben Niveau wie die V2.5-Generation. Flash ist besonders für hochvolumige Workloads bemerkenswert: Die offiziellen Xiaomi-Preise zeigen $0.14 pro Million ungecachter Input-Tokens und $0.28 pro Million Output-Tokens.
CometAPI-Preise und Verfügbarkeit
| CometAPI-Route | Input / 1M | Output / 1M | Katalogstatus |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Verfügbar; 20% unter den gelisteten offiziellen ungecachten Sätzen |
| mimo-v2.6-pro | $0.348 | $0.6960 | Verfügbar; 20% unter den gelisteten offiziellen ungecachten Sätzen |
| mimo-v2.6-flash | $0.112 | $0.2240 | Verfügbar; 20% unter den gelisteten offiziellen ungecachten Sätzen |
Wie können Entwickler auf Xiaomi MiMo-V2.6 zugreifen?
Xiaomi stellt die Modelle über eine OpenAI-kompatible API bereit und dokumentiert Kompatibilität mit dem Anthropic-Protokoll auf den offiziellen Modellseiten. Die offiziellen Bezeichner sind mimo-v2.6-pro, mimo-v2.6-flash und mimo-v2.6-pro-ultraspeed. Xiaomi dokumentiert Tool-Aufrufe, strukturierten Output, Streaming, Reasoning-Kontrollen, Kontext-Caching und Websuche. Die OpenAI-kompatible Schnittstelle nutzt thinking.type-Werte wie enabled oder disabled, wobei Deep Thinking bei V2.6-Modellen standardmäßig aktiviert ist.
Entwickler haben drei praktische Zugangswege. Erstens, laden Sie den offenen Gewichts-Checkpoint für Pro oder Flash für eine Self-Hosted-Integration herunter, vorbehaltlich erheblicher Serving-Anforderungen. Zweitens, nutzen Sie Xiaomis verwaltete API mit einem Xiaomi-Schlüssel und dem dokumentierten Endpoint. Drittens, verwenden Sie eine unterstützte CometAPI-Route mit einem CometAPI-Schlüssel und Base-URL; das kann Multi-Model-Evaluierung und Abrechnung vereinfachen. Coding-Assistenten wie Claude Code können eine Anthropic-kompatible Route nutzen, wenn diese Route und das Modell unterstützt werden, aber Kompatibilität muss getestet und darf nicht vorausgesetzt werden.
Zugriff auf MiMo-V2.6 über CometAPI
CometAPI bietet einen einheitlichen Endpoint und eine Abrechnungsschicht für unterstützte Modelle. Der Hauptbetriebsvorteil ist Migrationssimplichkeit: Teams können ein vertrautes SDK beibehalten, nur die Base-URL und Model-ID ändern, MiMo mit anderen Spitzenmodellen im selben Account vergleichen und Nutzung, Preise und Verfügbarkeit zentralisieren. Das ist nützlich für Multi-Model-Routing, Fallback-Strategien, konsolidierte Rechnungen und Evaluierungen mit identischen Prompts über Anbieter hinweg.
CometAPI dokumentiert drei Textanfrage-Formate auf Plattformebene: OpenAI Chat Completions, Anthropic Messages und OpenAI Responses. Für ein kompatibles SDK bedeutet Migration in der Regel, Base-URL, API-Schlüssel und Model-ID zu ändern, statt die gesamte Anwendung neu zu schreiben. Endpoint- und Parameter-Support können je nach Modell variieren, daher testen Sie die genaue MiMo-V2.6-Variante und das Anfrageformat, bevor Sie behaupten, dass alle drei Routen dafür funktionieren.
Stand 23. September 2026 verfügt MiMo-V2.6-Pro-UltraSpeed über eine verfügbare Katalogroute mit gelisteten Input- und Output-Preisen. Die dedizierten Pro- und Flash-Seiten zeigen „Coming soon“ in ihren Katalog-Snapshots, obwohl ihre API-Health-Panels „Available“ anzeigen. Behandeln Sie dies als inkonsistentes Seitensignal, nicht als bestätigte Produktionsverfügbarkeit oder Preisgestaltung. Prüfen Sie den Live-Katalog, das Dashboard und eine Testanfrage vor dem Deployment.
Das folgende Beispiel folgt dem veröffentlichten Anthropic-SDK-Muster von CometAPI und ruft die derzeit gelistete UltraSpeed-Route auf. Speichern Sie den API-Schlüssel in einer Umgebungsvariable.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analysieren Sie dieses Projekt und schlagen Sie die nächsten Umsetzungsschritte vor.' }],
});
Ist Xiaomi MiMo-V2.6 Open Source?
Xiaomi hat Modellgewichte, technische Materialien, RL-Ressourcen, Trainingsumgebungen und verwandte Infrastruktur veröffentlicht. Die Veröffentlichung umfasst mehr als 7.000 RL-Task-Umgebungen über Software Engineering, Verwundbarkeitsreproduktion, wissensintensive Arbeit sowie Webdesign/-entwicklung. Xiaomi hat außerdem MiMo-V2.6-Distill-Qwen-9B veröffentlicht, damit Forschende die RL-Pipeline in deutlich kleinerem Maßstab untersuchen können.
Offizielle Model Cards: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
Was sind die Einschränkungen von Xiaomi MiMo-V2.6?
Die Billionen-Parameter-Schlagzeile sollte nicht als Beweis gewertet werden, dass V2.6 geschlossene Spitzenmodelle universell übertrifft. Xiaomis eigene Benchmark-Tabelle zeigt ein gemischtes Bild: Claude Opus 5 bleibt bei einigen Coding-, Tool-Use- und OS-Benchmarks vorn, während GPT-5.6 Sol ebenfalls bei ausgewählten Tests führt. Arbeitslastspezifische Evaluierung ist daher aussagekräftiger als ein pauschales Gewinnerlabel.
Self-Hosting des vollständigen Pro-Checkpoints ist zudem eine infrastrukturlastige Aufgabe. Offene Gewichte bedeuten nicht einfache Workstation-Deployments. Darüber hinaus hängen mehrere Schlagzeilen-Demonstrationen—Forschung, verkörperte Kontrolle, 3D-Welten und Videoproduktion—von externen Tools und Agent-Harnesses ab. MiMo-V2.6 sollte als Modell in einem System evaluiert werden, nicht nur als eigenständiges Chatmodell.
Warum ist Xiaomi MiMo-V2.6 wichtig?
MiMo-V2.6 kombiniert drei wichtige Richtungen: sehr große Sparse-MoE-Modelle, native Multimodalität und Reinforcement Learning über reale Agentenumgebungen. Die Zahl 1,02T zieht Aufmerksamkeit auf sich, aber die bedeutendere Designentscheidung ist Xiaomis Investition in wiederholte Interaktion mit Umgebungen, Trajektorienbewertung, Tool-Nutzung und Selbstkorrektur.
Wenn dieser Ansatz weiter skaliert, könnten offene Modelle zunehmend nicht nur dadurch differenziert werden, wie viel statisches Wissen sie enthalten, sondern wie effektiv sie handeln, bewerten, sich erholen und lange Aufgaben abschließen. MiMo-V2.6 ist daher am besten als offenes agentenorientiertes Foundation-Modell zu verstehen und nicht einfach als weiterer Chatbot mit Billionen Parametern.
Fazit
MiMo-V2.6 ist eine substanzielle Open-Weight-Veröffentlichung, weil sie native Text-, Bild-, Video- und Audioeingabe mit langem Kontext, Sparse-MoE-Inferenz und Reinforcement Learning über reale Agentenumgebungen kombiniert. Pro passt besser für schwierige, langlaufende Aufgaben; Flash zielt auf hochvolumige und kostenempfindliche Workloads; UltraSpeed tauscht einen deutlich höheren API-Preis gegen geringere Latenz.
Die Modellfamilie ist auf mehreren vom Anbieter gemeldeten Agenten-Benchmarks wettbewerbsfähig, führt jedoch nicht jede Evaluation an und sollte nicht als universeller Ersatz für geschlossene Spitzenmodelle betrachtet werden. Der verlässlichste Adoptionspfad ist, MiMo-V2.6 gegenüber den exakten Tools, Latenzzielen, Fehlermodi und Kostenprofilen des vorgesehenen Produktions-Workflows zu testen.
FAQ
Was sollten Teams testen, bevor sie MiMo-V2.6 in die Produktion übernehmen?
Testen Sie das komplette System statt nur das Modell. Messen Sie Aufgabenerfüllung, Genauigkeit von Tool-Aufrufen, Recovery nach fehlgeschlagenen Aktionen, Latenz, Tokenverbrauch, Kontextmanagement und Berechtigungsgrenzen. Agenten-Benchmarks bieten Orientierung, aber interne Evaluierungen sollten dem tatsächlichen Repository-, Browser-, Dokument- oder Forschungs-Workflow entsprechen.
Warum kann Self-Hosting von MiMo-V2.6-Pro trotz sparsamer Architektur schwierig sein?
Sparsame Aktivierung reduziert den Pro-Token-Compute relativ zu einem dichten Billionen-Parameter-Modell, aber der vollständige Checkpoint hat immer noch einen sehr großen Speicher- und verteilten Serving-Footprint. Produktionsdeployment kann Multi-Node-Inferenz, Expertenparallelisierung, spezialisierte Kernel und sorgfältige Kapazitätsplanung erfordern.
Wie sollten Entwickler Xiaomis Cross-Model-Benchmark-Tabelle interpretieren?
Betrachten Sie sie als vom Anbieter gemeldete Evidenz, nicht als unabhängig reproduzierte universelle Rangliste. Ergebnisse können sich mit Agent-Harness, Inferenzbudget, Tools, Umgebungsimage, Sampling-Methode und Benchmark-Version ändern. Vergleichen Sie Trends über mehrere Tasks und reproduzieren Sie intern die relevantesten Workloads.
Wann ist MiMo-V2.6-Flash die bessere Wahl als Pro?
Flash ist die stärkere Default-Option, wenn Aufrufvolumen und Kosten dominieren, insbesondere für Dokumentverarbeitung, multimodale Analyse und wiederholte Agentenschritte. Pro ist geeigneter, wenn schwieriges Reasoning oder langlaufende Ausführung genug Geschäftswert schafft, um den höheren Preis zu rechtfertigen.
Beseitigt ein 1M-Token-Kontextfenster den Bedarf an Retrieval oder Prompt-Management?
Nein. Ein größeres Fenster erhöht die Kapazität, aber unnötige Historie kann Latenz und Kosten erhöhen und relevante Evidenz verwässern. Retrieval, Zusammenfassung, strukturierter Speicher und Kontextkürzung bleiben wichtig für zuverlässige Produktionsagenten.