Spécifications techniques de Qwen3.8-Flash
| Spécification | Qwen3.8-Flash |
|---|---|
| Fournisseur | Alibaba / Qwen |
| Famille de modèles | Qwen3.8 |
| ID du modèle | qwen3.8-flash |
| Type de modèle | Modèle de raisonnement multimodal |
| Modalités d’entrée | Texte, image, vidéo |
| Modalité de sortie | Texte |
| Fenêtre de contexte | 1,000,000 jetons |
| Sortie maximale | 128,000 jetons |
| Budget de raisonnement maximal | 262,144 jetons |
| Mode de raisonnement | Pris en charge |
| Appel de fonctions | Pris en charge |
| Outils intégrés | Pris en charge |
La documentation API actuelle de Qwen répertorie qwen3.8-flash comme un modèle Qwen3.8 de production avec une fenêtre de contexte de 1M de jetons et une sortie maximale de 128K. Il prend en charge les entrées texte, image et vidéo, l’appel de fonctions, les outils intégrés et la sortie structurée.
Pour les charges de travail visuelles, les limites documentées incluent jusqu’à 16 mégapixels par image, jusqu’à 2,048 URL d’images ou 250 images Base64, et jusqu’à 64 vidéos, avec des vidéos jusqu’à 2 heures.
Qu’est-ce que Qwen3.8-Flash ?
Qwen3.8-Flash est le modèle de raisonnement multimodal économique d’Alibaba au sein de la famille Qwen3.8, conçu pour le codage, les workflows agentiques, l’analyse de long contexte et la compréhension visuelle. Il offre la même classe de contexte de 1M de jetons que Qwen3.8-Max tout en visant un coût d’API nettement inférieur. Les recommandations de Qwen à destination des développeurs préconisent explicitement Qwen3.8-Flash lorsque des capacités similaires sont souhaitées à moindre coût, tandis que Qwen3.8-Max est positionné comme l’option offrant le meilleur raisonnement.
Le modèle est particulièrement intéressant car « Flash » ne signifie pas un simple petit modèle. Le modèle API de production combine raisonnement sur long contexte, entrées multimodales, utilisation d’outils et sortie structurée dans un point de terminaison relativement peu coûteux.
Quelles sont les principales fonctionnalités de Qwen3.8-Flash ?
- Contexte de 1M de jetons : Qwen3.8-Flash peut traiter des documents et bases de code extrêmement longs, ce qui le rend adapté à l’analyse de dépôts et aux sessions d’agents de longue durée.
- Compréhension multimodale : L’API accepte le texte, les images et la vidéo, permettant aux développeurs de combiner code, captures d’écran, graphiques, documents et vidéo dans un même workflow.
- Mode de raisonnement : Le modèle prend en charge le mode de réflexion de Qwen, avec un budget de raisonnement maximal documenté de 262,144 jetons.
- Prise en charge des agents et des outils : L’appel de fonctions et les outils intégrés sont pris en charge, y compris des capacités telles que la recherche web, l’exécution de code et les outils hébergés par Qwen.
- Sortie structurée : Les développeurs peuvent demander des réponses structurées, ce qui facilite l’intégration du modèle dans des applications nécessitant du JSON ou des résultats contraints par un schéma.
- Compréhension de vidéos longues : La documentation de l’API visuelle répertorie des entrées vidéo jusqu’à deux heures, rendant Qwen3.8-Flash utile pour l’analyse vidéo, et pas seulement pour des tâches de légendage d’images courtes.
Quelles sont les meilleures utilisations de Qwen3.8-Flash ?
Programmation et ingénierie logicielle
La fenêtre de contexte de 1M de jetons est utile pour les grands dépôts, les longues sessions de débogage et l’analyse de code multi-fichiers. La prise en charge de l’appel de fonctions et du raisonnement rend également le modèle adapté aux agents de codage, et pas seulement à l’autocomplétion.
Workflows agentiques
Qwen3.8-Flash prend en charge l’appel de fonctions et les outils intégrés, permettant à une application de laisser le modèle récupérer des informations, exécuter du code ou interagir avec des systèmes externes.
Analyse de documents longs
Une fenêtre de contexte d’un million de jetons rend le modèle approprié pour de grands contrats, de la documentation technique, des collections de recherche et des bases de connaissances d’entreprise où il serait autrement nécessaire de fragmenter à répétition l’information.
Analyse vidéo et visuelle
Qwen3.8-Flash accepte les images et la vidéo. Les limites actuelles de l’API visuelle autorisent des vidéos jusqu’à deux heures, ce qui le rend pertinent pour des enregistrements de réunions, tutoriels, cours, démonstrations et l’analyse de contenus visuels longs.
IA de production sensible aux coûts
C’est probablement le plus grand avantage commercial du modèle. Qwen recommande explicitement Flash comme alternative moins coûteuse à Qwen3.8-Max, ce qui le rend adapté aux applications à fort volume où un raisonnement de niveau phare n’est pas nécessaire à chaque requête.
Quelles sont les limites de Qwen3.8-Flash ?
Qwen3.8-Flash ne doit pas être interprété comme le modèle le plus performant de la famille Qwen3.8 simplement parce qu’il partage la fenêtre de contexte de 1M avec Qwen3.8-Max.
Le principal compromis est capacité contre coût : Qwen recommande Qwen3.8-Max lorsque les performances de raisonnement les plus élevées sont requises.
Une seconde considération est qu’une fenêtre de contexte de 1M ne signifie pas que chaque requête doit contenir un million de jetons. De grands contextes augmentent les besoins de traitement, et les développeurs devraient utiliser la recherche, la mise en cache et la gestion de contexte lorsque l’intégralité du contexte n’est pas nécessaire.
Enfin, les développeurs doivent distinguer le qwen3.8-flash hébergé du Qwen3.8-Flash-Next à poids ouverts. Ce dernier est l’aperçu architectural et dispose de poids et d’une architecture documentés séparément ; le modèle API de production doit être documenté selon ses propres spécifications API.
Qwen3.8-Flash convient-il aux applications API de production ?
Oui, en particulier lorsque l’application nécessite un raisonnement multimodal, un long contexte, l’utilisation d’outils et un coût en jetons relativement faible.
C’est un meilleur candidat pour la production que Flash-Next lorsque l’exigence est simplement d’appeler une API Qwen hébergée, car qwen3.8-flash est explicitement exposé comme un modèle de production dans la documentation API de Qwen, avec des limites définies de contexte, de sortie, d’outils et de multimodalité.
Pour une qualité de raisonnement maximale, Qwen3.8-Max reste le choix le plus approprié. Pour des charges à haut volume où le coût et le débit comptent davantage, Qwen3.8-Flash est l’option la plus économique.
Paramètres de l’API Qwen3.8-Flash
Une requête standard compatible OpenAI peut utiliser des paramètres tels que :
| Paramètre | Objectif |
|---|---|
| model | qwen3.8-flash |
| messages | Conversation et entrée multimodale |
| temperature | Contrôle de l’échantillonnage |
| max_tokens | Sortie maximale générée |
| stream | Réponses en streaming |
| tools | Définitions de fonctions/outils |
| tool_choice | Comportement de sélection des outils |
| response_format | Configuration de la sortie structurée |
| enable_thinking | Active le mode de raisonnement dans les API Qwen prises en charge |
La documentation de démarrage rapide utilise le SDK OpenAI avec l’identifiant de modèle qwen3.8-flash. L’exemple active le raisonnement avec extra_body={"enable_thinking": True}.
Comment utiliser l’API qwen3.8-flash dans CometAPI
Étape 1 : Obtenir l’accès à l’API
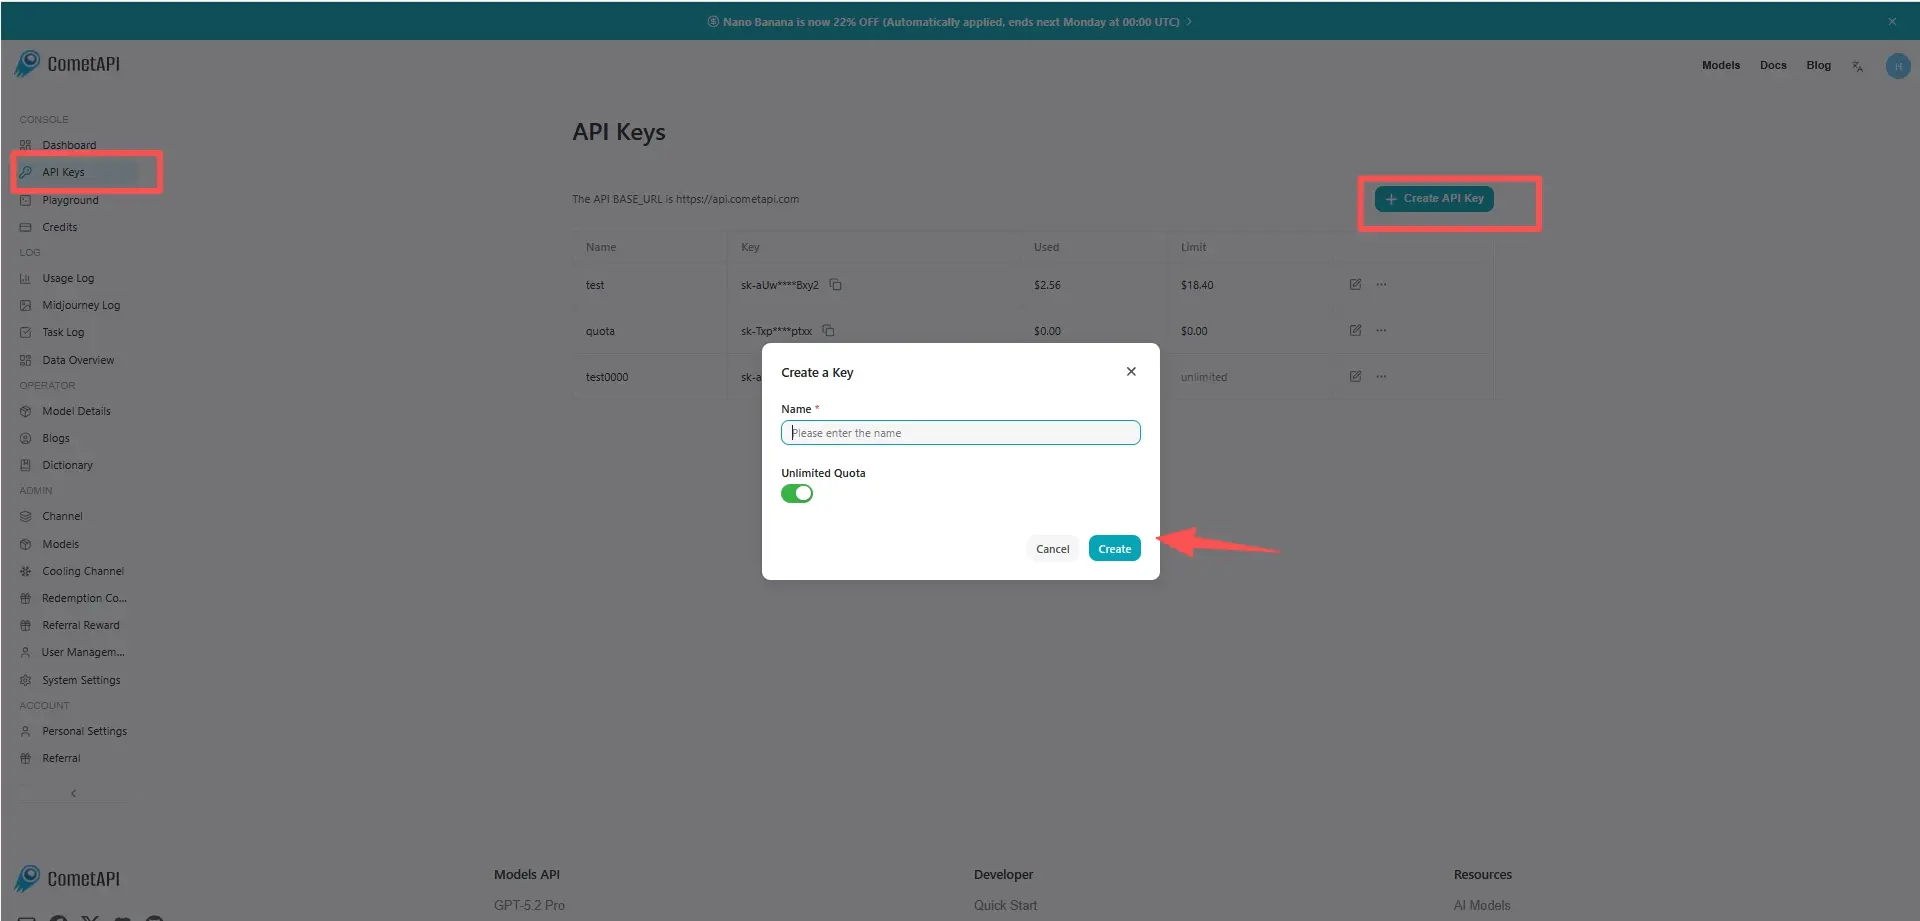
Connectez-vous à cometAPI. Si vous n’êtes pas encore notre utilisateur, veuillez d’abord vous inscrire. Connectez-vous à votre CometAPI console. Obtenez la clé API d’accès de l’interface. Cliquez sur “Add Token” dans la section API token du centre personnel, obtenez la clé de jeton : sk-xxxxx et soumettez.
Étape 2 : Envoyer des requêtes à l’API qwen3.8-flash
Sélectionnez le point de terminaison “qwen3.8-flash” pour envoyer la requête API et définissez le corps de la requête. La méthode et le corps de la requête sont disponibles dans la documentation API de notre site web. Notre site fournit également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle issue de votre compte.
Insérez votre question ou votre demande dans le champ content — c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée. Elle prend en charge l’AI SDK, OpenAI Chat Completions, OpenAI Responses et les interfaces compatibles Anthropic Messages.
Étape 3 : Traiter les réponses
L’API renvoie des réponses candidates structurées incluant le texte généré, des citations, des métadonnées de sécurité et, en option, des résultats d’outils. Pour les requêtes multimodales, le contenu du message peut être structuré avec des entrées texte et image lorsque le point de terminaison CometAPI sélectionné expose la capacité de vision du modèle.