

TL;DR
Claude Opus 5.5 は、$4/百万入力トークン、$20/百万出力トークンという大幅に低いトークン単価で提供されつつ、公開済みの複数の評価で Fable 5.1 に匹敵または上回る結果を示しているため、有力な開始候補です。対して Fable 5.1 は $10 と $50。
Fable 5.1 は、特に難易度が高い、長時間実行、リトライが高コスト、あるいは綿密な監督なしで動作させたいタスクで依然として有用です。実務的なルールは単純です。まず Opus 5.5 から始め、代表的な本番テストで Fable 5.1 が失敗・修正・リトライのコストを十分に下げ、そのプレミアムを正当化できると確認できた場合のみエスカレートします。
Claude Opus 5.5 と Claude Fable 5.1 の早見表
| Dimension | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Release date | 2026年9月22日 | 2026年9月1日 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-to-Rust migration | 9.5時間、タスクコスト51%削減 | 12時間、ベースラインのタスクコスト |
| Speed option | Fast mode、通常の最大2.5倍の速度 | 同等の起動モードなし |
| Effort starting point | ミディアム志向 | 高め |
| Best default use | 日常のフロンティア級コーディング、エージェント、監督下の本番運用、高ボリュームAPI | 最高価値・高難度・長時間・無人の自律作業 |
| API access | Anthropic API と CometAPI を含む互換プロバイダ | Anthropic API と CometAPI を含む互換プロバイダ |
注意書き: ベンチマークの数値は Anthropic による報告であり、エフォートレベル、ハーネス、セーフガード、タスクリリース、試行回数、標準誤差に依存します。一致した評価条件の下でのみ比較してください。
重要なポイント
- Opus 5.5 の標準的な入力・出力レートは、Fable 5.1 より60%低い。
- 両モデルとも 1M トークンのコンテキストと最大 128K の出力に対応。名目上のコンテキストサイズより、コスト、エフォート設定、ワークロード適合性が重要。
- 公開結果では、Opus 5.5 は多くのコーディング/エージェント系評価で優位。ただしベンチマーク設定に結果は大きく左右される。
- 独立評価でも Opus 5.5 のフロンティア性を支持しつつ、絶対値は異なることを報告。条件を揃えたテストの必要性が強化される。
- 監督下の本番作業の大半では、Opus 5.5 がより強力な出発点。Fable 5.1 は自動的なデフォルトではなく、エスカレーション層。
Claude Opus 5.5 とは?
Claude Opus 5.5 は、Anthropic 初の Claude 5.5 モデルで、エージェント的なコーディング、長時間エージェント、プロフェッショナルな知識作業、エンタープライズワークフロー、財務分析、ビジョン、コンピュータ操作を想定しています。
API モデル ID は「claude-opus-5-5」。適応的思考は常時有効で、開発者は low/medium/high/xhigh/max のエフォート設定で推論強度を制御できます。Anthropic は Fast mode も提供しており、通常の最大 2.5 倍の速度で $8/M 入力、$40/M 出力で実行可能です。
Claude Fable 5.1 とは?
Claude Fable 5.1 は、数時間にわたるコーディング、複雑なリサーチ、ブラウザ操作、自律エージェント、複数アプリにまたがるワークフローなど、要求が厳しく長時間のプロジェクト向けに位置づけられています。
API モデル ID は「claude-fable-5-1」。適応的思考を採用し、API の初期エフォート設定は高めで、失敗やリトライの期待コストが追加の推論コストを上回るときに選ぶプレミアムな選択肢として扱うのが最適です。
単純化すれば、Opus 5.5 は Fable の標準トークン価格の約 40% でほぼ同等の性能包絡を提供する、と読めます。ですが、まさにこの点でスペック表だけの単純比較は誤解を招きます。
コードとベンチマークの比較
Anthropic は、Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0、GDPval-AA v2.1、AutomationBench、Humanity's Last Exam(ツール有り)、Terminal-Bench-Science、OSWorld 2.0、Chartography で Opus 5.5 が Fable 5.1 を上回ると報告しています。
ベンチマーク結果の読み方
Anthropic は、Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0、GDPval-AA v2.1、AutomationBench、Humanity's Last Exam(ツール有り)、Terminal-Bench-Science、OSWorld 2.0、Chartography において、Opus 5.5 が Fable 5.1 を上回ると報告しています。これらの数値は評価結果であり、設定に依存しないモデルの定数ではありません。
Opus 5.5 の注目スコアの多くは max エフォート、Terminal-Bench 4.0 は xhigh エフォートで測定されています。ハーネス設計、ツール設定、セーフガード、試行回数、標準誤差、フォールバック挙動、コスト上限は結果を左右します。Anthropic 自身も、ベンチマークの差分は実務上の差を過大評価し得ると注意喚起しています。
コーディング性能
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretation |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 端末ベースのエージェントタスクで 10.6 ポイントのリード |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | 本番経済性を考慮しても medium の Opus 5.5 は競争力を維持 |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | medium エフォートで報告の Fable 結果を僅差で上回る |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | プロフェッショナルなエージェント作業で優位性を示す |
これらの数値は Anthropic が報告したベンチマーク結果です。以下のセクションにある評価設定上の注意点および公式の Claude Opus モデルページと併せて読む必要があります。
最初の3つの結果が際立つのは、商業的に Claude の重要性が増しているワークロード、すなわち「ソフトウェアエンジニアリング・エージェント」をカバーしているためです。Terminal-Bench 4.0 は 10.6 ポイントの絶対差、FrontierCode は 4.1 ポイント、CursorBench 4.0 は 6 ポイントです。
プロフェッショナルなエージェント作業を測る GDPval-AA でも、Opus 5.5 が 1846 Elo、Fable 5.1 が 1735 Elo と報告されています。もしこれらが全てなら、製品の序列は逆転して見えるでしょう。話はそれほど単純ではありません。
独立評価
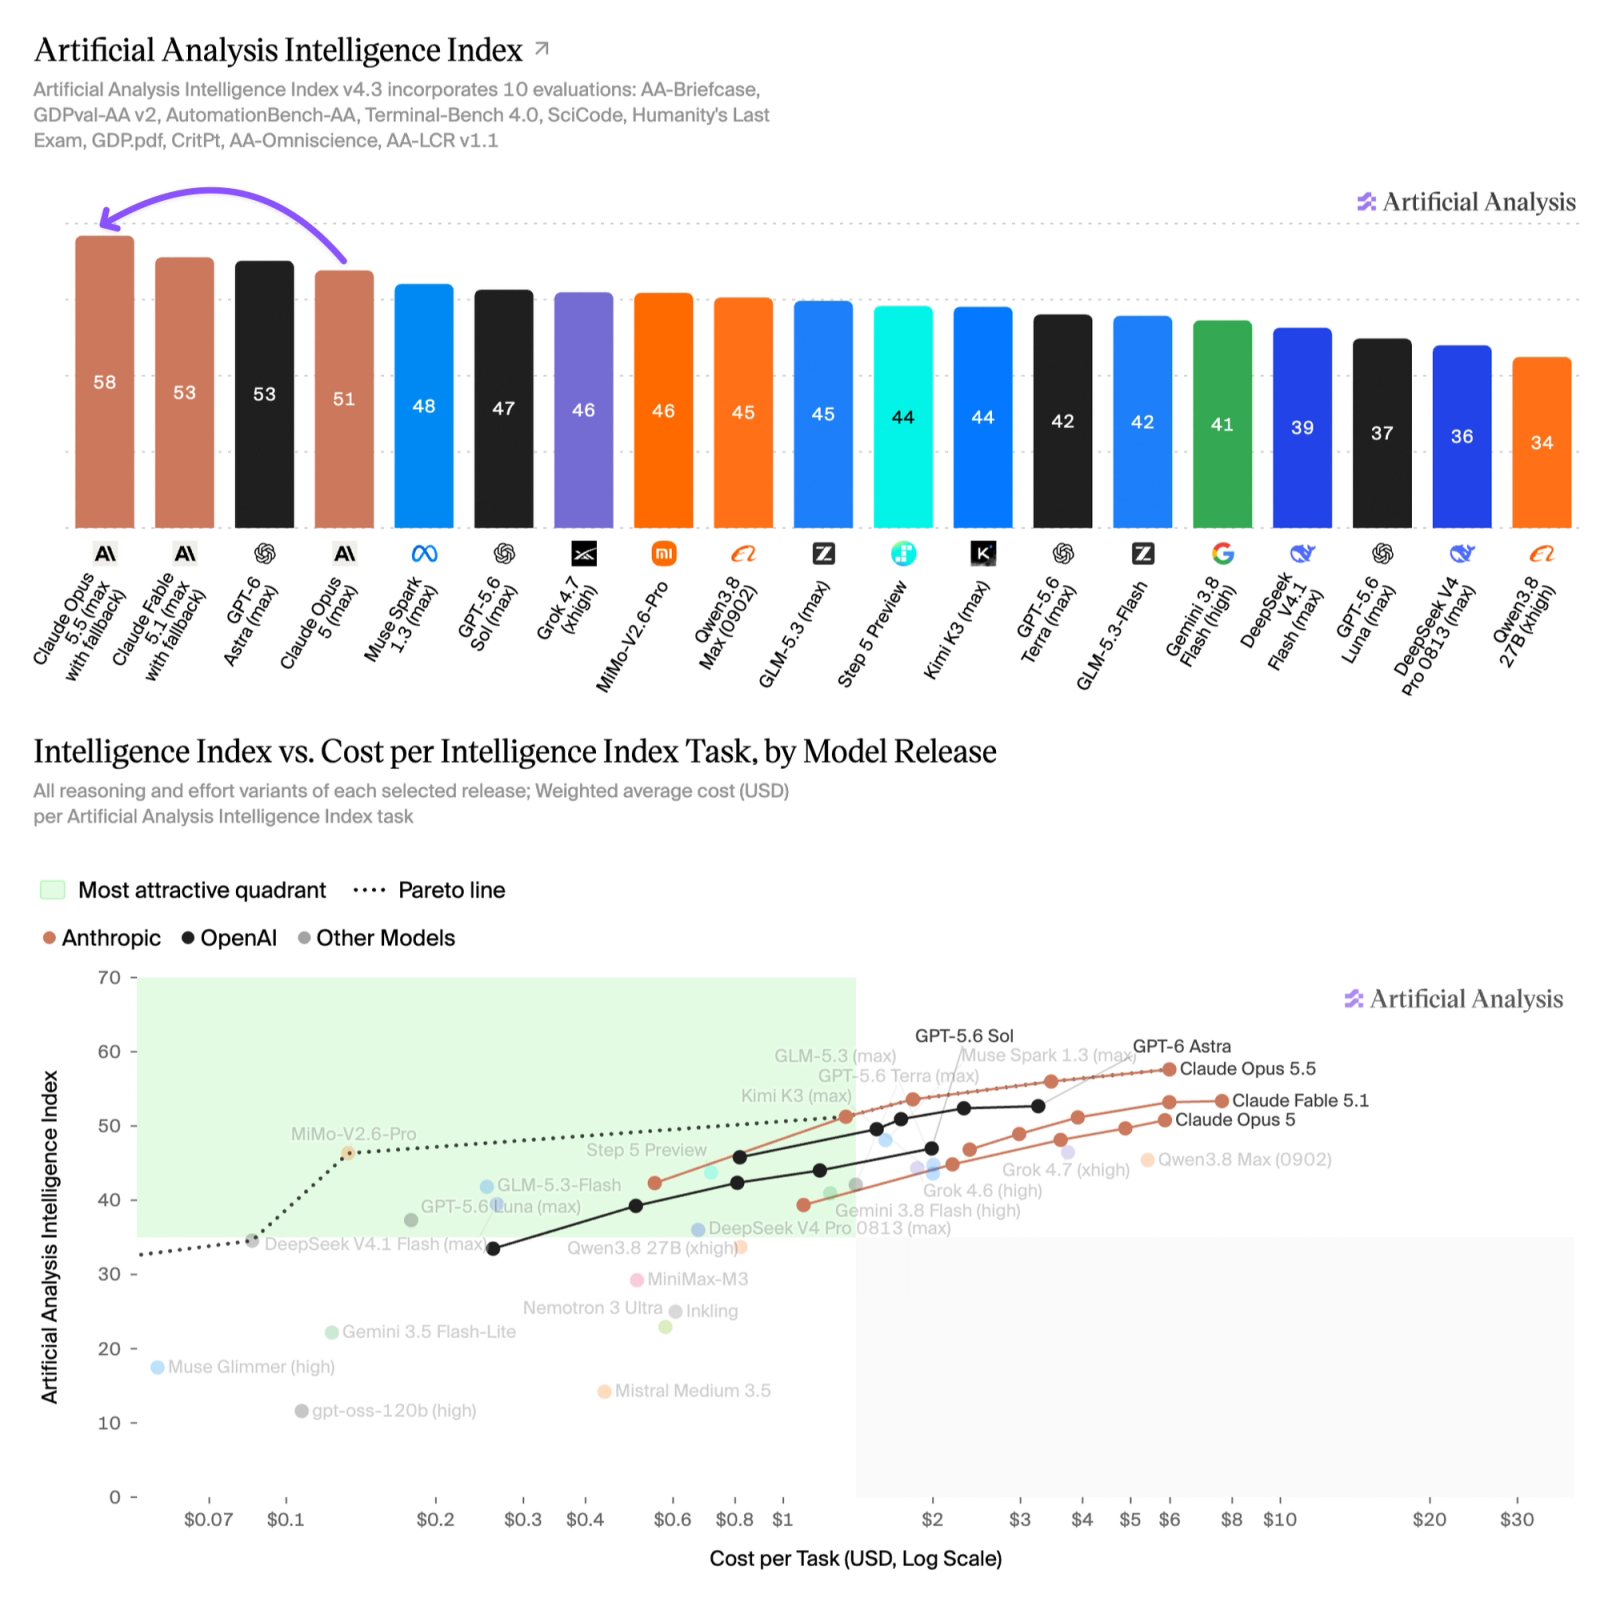
Artificial Analysis は、Opus 5.5 Max を Intelligence Index で 58 と位置づけ、AA-Briefcase、GDPval-AA、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam で強い結果を報告しました。Terminal-Bench 4.0 は 59.6% で、Anthropic の 66.4% を下回り、スコアが一致しない場合にはモデルバージョン、エフォート設定、ハーネス、ツール、試行回数、コスト上限を記録すべき理由を示しています。
価格とタスク完了コストの比較
CometAPI は公式料金より低いトークン価格を提供しており、標準のメッセージリクエスト形式で公式 API と同等の性能を達成できます。
トークン価格
| Pricing | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache write | $5 | $12.50 |
| 1-hour cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch input/output | 50% discount | 50% discount |
あるワークロードが新規の入力トークンを 1,000 万、出力トークンを 200 万消費するとします。キャッシュ効果なしの場合:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
この前提では、Opus 5.5 のコストは「60% 少ない」。ただし、これは「Opus 5.5 の運用コストが Opus 5 に比べ約 40% 低い」という Anthropic の記述と混同してはいけません。
両者は全く別の比較です。40% の数値は、Opus 5.5 の Opus 系列としての低価格「に加えて」Opus 5 と比べてタスク当たりのトークン消費が減少したことを含みます。60% の数値は、Opus 5.5 と Fable 5.1 の標準価格を直接比較した結果です。
タスク完了あたりのコスト
モデル API が販売しているのはトークンではありません。開発者が購入するのは「完了した仕事」です。
コーディングチームは、モデルが 620 万トークンを消費したかどうかを気にしません。バグが修正されたか、マイグレーションが完了したか、テストスイートに合格したか、リサーチタスクが仕上がったかを気にします。
Anthropic は「Opus 5.5 でタスクがいくらかかるか」でこの点を直接論じています。価格が似通う 2 つのモデルでも、ターン数、再読コンテキスト、リトライ頻度、思考トークン量が違えば「タスクコスト」は大きく変わります。
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
最後の項目は見落とされがちです。安価なモデルでも 2 回失敗すれば、1 回で完了する高価なモデルより高くつくことがあります。同様に、リトライ 10 回を防ぐ高いエフォート設定は、結果的に総コストを下げる場合があります。
プロンプトキャッシュの経済性
キャッシュ重視のエージェントは、ツール定義、リポジトリの文脈、システム指示、会話履歴、テスト出力を繰り返し再利用します。キャッシュ読み取りは Opus 5.5 が $0.20/M、Fable 5.1 が $0.25/M のため、差は新規入力価格の $6/M よりずっと小さいことになります。したがって、チームは新規入力、キャッシュ読み取り、キャッシュ書き込み、出力、ツールターン、リトライを個別にトラッキングすべきです。
エフォートレベルの経済性
可能性はあります。Artificial Analysis は Opus 5.5 の 5 つのエフォート設定をテストし、明確な能力—コスト曲線を示しました。
| Opus 5.5 effort | Artificial Analysis Intelligence Index | Cost per Index task |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
ルーチンなコード変更、既知のリファクタ、監督下のデバッグには medium が妥当な出発点です。あいまいなシステム障害、夜間マイグレーション、誤った計画が大規模な手戻りを生むタスクでは、high や xhigh が正当化される場合があります。
セーフティと信頼性の比較
能力ベンチマークだけで、いずれかのモデルをより安全と断定すべきではありません。妥当な比較には、プロンプト、ツール、権限、エフォート設定、リトライ上限、受け入れ基準を揃える必要があります。能力の高さは偶発的エラーを減らし得ますが、自律性の増大や長時間の実行は、不適切な計画、プロンプトインジェクション、危険なツール呼び出し、気付かれないドリフトの影響を拡大します。
| Safety dimension | Practical comparison | Production control |
|---|---|---|
| Reasoning and effort | Opus 5.5 は複数のエフォートレベルを公開し、Fable 5.1 はより高いエフォートの姿勢から開始します。推論量はポリシー強制の代替にはなりません。 | ワークロードごとにエフォートポリシーを固定し、変更時には安全性挙動を再テスト。 |
| Long-running autonomy | Fable 5.1 は難易度が高い無人運用を想定。Opus 5.5 もエージェントワークフローをサポート。リスクは実行時間、権限、不可逆アクション数に応じて増加。 | チェックポイント、承認ゲート、時間とコスト上限、自動ロールバック/シャットダウン条件を設定。 |
| Tool and computer use | 両モデルともツール操作が可能。モデル選択だけではデータ露出や破壊的アクションを制御できません。 | 最小権限、許可リスト、サンドボックス、シークレット分離、外部/不可逆アクション前の確認を適用。 |
| Evaluation and auditability | 公開ベンチマークスコアは、拒否品質、プロンプトインジェクション耐性、本番インシデント率を立証しません。 | ツール呼び出しとポリシー判断をログ化。危険なコンプライアンス率、誤拒否、インジェクション成功率、シークレット漏えい、破壊的試行、リカバリ品質を測定。 |
実務的な安全ルール: タスクを満たす中で最小権限の Opus 5.5 構成から開始し、同じ安全スイートを通過した後にのみ Fable 5.1 へエスカレート。高影響のワークフローでは、能力テストで高得点でも人間の承認を必須に。
- 実際の本番ツールセットで敵対的プロンプトインジェクション/データ流出テストを実施。
- 読み取り、書き込み、公開、削除、支払い権限を統合せず分離。
- ポリシー違反、ツール失敗の繰り返し、想定外のスコープ拡大、コスト超過に対するロールバックトリガーを定義。
- モデル、システムプロンプト、エフォート、ツール、権限、ルーティングの変更後は再検証。
Opus 5.5 と Fable 5.1 の選び方
| Workload | Recommended starting point | Escalation condition |
|---|---|---|
| 日常のコーディングとコードレビュー | Opus 5.5、medium | 異常に難しい/高リスクなケースのみエスカレート |
| 複数ファイルの機能開発 | Opus 5.5、medium または high | 計画失敗の繰り返しがコストを支配する場合は Fable を使用 |
| リポジトリ全体の移行 | まず Opus 5.5 の high または xhigh をテスト | 最難関の無人プロジェクトではエスカレート |
| 夜間の自律実行 | 厳格なチェックポイントを備えた Opus 5.5 | 誤った方向性のコストが極めて大きい場合は Fable を優先 |
| 高ボリュームの API トラフィック | Opus 5.5 | 失敗しやすい少数のタスクのみエスカレート |
| 既存の検証済み Fable デプロイ | テスト中は現行デプロイを維持 | Opus が同じ受け入れ基準を満たした後にのみ切り替え |
実務的な本番テスト
同一の代表タスク、プロンプト、ツール、エフォートポリシー、受け入れ基準、リトライ上限で両モデルを実行します。受理率、レイテンシ、新規/キャッシュ入力、出力/思考トークン、ツール呼び出し、リトライ、人手修正、受理結果あたりの総コストを記録。ルーチンと難易度の高い失敗ケースの双方を含めます。
既存 Claude Opus 5 ユーザー向け移行ガイダンス
既存の Opus 5 ユーザーは、モデル ID の置き換えがリスクフリーだと仮定せず、後継として Opus 5.5 をテストすべきです。計画の深さ、ツール呼び出しパターン、応答長、フォーマット順守、レイテンシ、プロンプトキャッシュ挙動、ツール失敗からの回復、安全ルーティング、タスク完了コストを比較してください。ロールバック基準と既存モデルは、Opus 5.5 が本番に近い受け入れ基準を通過するまで維持します。
既存の Fable 5.1 ユーザーに汎用的な移行セクションは不要です。Opus 5.5 を候補最適化として扱い、同じ本番受け入れ基準で評価した上で、検証済みのデプロイを変更してください。
CometAPI 経由でのアクセス
いずれのモデルを評価する開発者も、Claude Opus 5.5 と Claude Fable 5.1 に関する CometAPI ガイドを参照できます。互換 API プロバイダを統合する際は、正確なモデル ID、対応するエフォートパラメータ、キャッシュ挙動、レート制限、地域提供状況、最新価格を本番前に確認してください。
Opus 5.5 には「claude-opus-5-5」、Fable 5.1 には「claude-fable-5-1」を、サポートされている場合に使用してください。すべてのワークロードを 1 つの固定エフォートレベルにサイレントにルーティングしないでください。モデル選択とエフォートポリシーは独立して構成すべきです。
Python — Anthropic Messages API through CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
結論
Claude Opus 5.5 は、Anthropic の日常的なフロンティアモデルとプレミアムなエスカレーション層の実務上の境界を変えます。標準トークン単価が大幅に低く、多くのコーディング/エージェント系ベンチマークでリードし、幅広い本番レンジをカバーできるだけのエフォート柔軟性を提供します。
Claude Fable 5.1 は、タスクが難しく高価値・長時間・無人で、失敗コストが推論コスト増を上回る場合に引き続き有用です。ほとんどのチームにとって、ベストな方針は Opus 5.5 から始め、タスク完了結果を測定し、選択的にエスカレートすることです。
FAQ
チームは Opus 5.5 と Fable 5.1 の本番 A/B テストをどう設計すべきですか?
同一の代表タスク、プロンプト、ツール、エフォートポリシー、受け入れ基準、リトライ上限で両モデルを実行します。受理率、レイテンシ、新規/キャッシュ入力、出力/思考トークン、ツール呼び出し、リトライ、人手修正、受理結果あたりの総コストを記録。ルーチン作業と難しい失敗ケースの両方を十分な件数で実施してください。
低いトークン価格でもタスク総コストが下がらないのはどんな場合ですか?
ターン数が増える、コンテキストの再読が増える、思考トークンが増える、リトライが繰り返されると、低価格モデルでも総コストが上がり得ます。キャッシュ挙動も重要で、長いセッションでキャッシュ読み取りが支配的になると入力価格差は縮小します。標準価格だけでなく、タスク完了コストを比較してください。
ベンチマーク結果が食い違うとき、何を記録すべきですか?
モデルバージョン、エフォートレベル、ハーネス、フォールバックと安全設定、試行回数、タスクリリース、標準誤差、コスト上限を記録します。各結果は公式か独立かを明記し、設定が一致しないスコアを単一ランキングに混在させないでください。
既存の Fable 5.1 ユーザーが監視すべき移行リスクは?
計画の深さ、ツール呼び出しパターン、応答長、フォーマット順守、レイテンシ、プロンプトキャッシュ挙動、失敗からの回復、安全ルーティングに注意。評価中は現行デプロイを維持し、ロールバック基準を設け、Opus 5.5 が本番に近いタスクで同じ受け入れ基準を満たしてから移行してください。
SEO メタデータ
Meta title: Claude Opus 5.5 と Fable 5.1: コード、コスト、ベンチマーク比較
Meta description: Claude Opus 5.5 と Claude Fable 5.1 を、コーディングベンチマーク、API 価格、速度、キャッシュ、エフォート設定、タスク完了コスト、ワークロード適合性の観点で比較。
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude コーディングベンチマーク, Claude API 価格, CometAPI, AI コーディングモデル
URL slug: claude-opus-5-5-vs-claude-fable-5-1