
TLDR: DeepSeek-V4.1-Flash-1017は、DeepSeekのV4.1-Flashモデルに対する2026年10月17日の小規模ながら非常に影響の大きいアップデートです。推論、コーディング、エージェント、ビジョン各種ベンチマークでの結果を強化しつつ、出力を短くし、タスク完了を高速化—性能とコストのパレートフロンティアを前進させます。
重要ポイント
- DeepSeek-V4.1-Flash-1017 は2026年10月17日に既存の
deepseek-flashAPIエンドポイントへの無料アップグレードとして公開—既存ユーザーはコード変更不要。 - ベンダー報告では、9月の V4.1-Flash と比較した掲載11ベンチマークすべてで向上、特にエージェント系とコーディングタスクで大幅な伸び。
- アーキテクチャ:Causal Encoder-Decoder設計の552BパラメータMixture-of-Experts(入力/プリフィル時は約8B、デコード/出力時は約16Bのアクティブパラメータ);100万トークンのコンテキストウィンドウ;最大384K出力トークン;ネイティブなビジョン対応。
- 価格は据え置き:オフピークは1M入力(キャッシュミス)/出力トークンあたり$0.15/$0.60(ピークは2倍);キャッシュヒットは最安$0.003。CometAPIは公式レートから20%引き。
- 新しいSearch & Fetch APIが全開発者に開放($0.75/1,000コール;2026年10月31日まで特定のサーバーサイドツール経由は無料)。
- エンドツーエンドのプロジェクト生成(ゲーム、3Dシーン、完全リポジトリ)に強い「願望駆動プログラミング」能力。多くの本番ワークロードでより安価かつ高速で、より大規模なクローズドモデルに対してエージェント/コーディング系ベンチで競争力。
- Hugging Face のオープンソースMITウェイト およびModelScopeによりセルフホスティングとファインチューニングが可能。
- 本番用途では、CometAPIのようなプラットフォームがDeepSeekを含む500+モデルへOpenAI互換の便利なアクセスを提供し、競争力ある価格や容易な切替を実現。
DeepSeekは効率的で高性能なオープンAIモデルの限界を押し広げ続けています。2026年10月17日、同社はDeepSeek-V4.1-Flash-1017をリリースしました(初版は2026年9月10日)。推論、コーディング、エージェント能力、視覚理解で大幅な改善を提供しつつ、タスク実行時間と出力長を短縮するとしてマーケティングされており、現実のエージェントやコーディング用途に向けた、同社史上最も強力な効率モデルとして位置づけられています。
このモデルはDeepSeekのウェブサイト、モバイルアプリ、API(名称は引き続き deepseek-flash)で利用可能です。ウェイトはMITライセンスで公開されており、フロンティア級のエージェント性能を低コストで求める開発者にとって、最も強力なオープンウェイトの選択肢の一つです。
DeepSeek V4.1-Flash-1017とは何か?
DeepSeek-V4.1-Flash-1017は、V4.1-Flashファミリーの日時付きチェックポイント(“1017”は10月17日のリリース日を示す)です。DeepSeekはこれを「小規模なアップデート」と説明しつつも、改善は広範で意味があります:すべての報告ベンチマークカテゴリでのスコア向上、タスクの高速完了、短い出力。同社は、性能とコスト効率の両面で優れる真のパレート改善として位置づけています。
V4.1-Flashで導入された革新的アーキテクチャを継承しています:
- Mixture-of-Experts(MoE)設計で総背骨パラメータは約552B(レポートによっては追加のEngramパラメータ)。新しいCausal Encoder-Decoderアーキテクチャにより、プリフィル/入力処理ではトークンあたり約8B、デコード/出力生成では約16Bのパラメータのみがアクティブ。
- 高圧縮のKVキャッシュ(前世代比でHBMは1/4、SSDは1/8のストレージ削減と主張)により、長文脈やマルチターンのエージェント対話のコストを劇的に低減。
- ネイティブなマルチモーダル対応(テキスト+画像入力→テキスト出力)。100万トークンのコンテキストウィンドウと最大出力長384Kトークン(推奨サンプリングでは≥256Kの上限設定が用いられることが多い)。
- 思考/非思考モード、ツール呼び出し、JSON出力、推論努力の調整に対応。
このモデルは、エンドツーエンドのプロジェクト開発を改善するための自己フィードバックループを含む強化学習手法で訓練されています。これにより、「願望駆動プログラミング」—高レベルの自然言語目標から、ウェブゲーム、3Dシーン、完全なコードリポジトリなどの、完成した機能的プロジェクトを生成する能力—がより確実になりました。
アプリケーション開発者にとって、評価の観点が変わります。モデルがそれらしい関数を出せるかではなく、既存のコードベースを理解し、協調的な編集を行い、チェックを実行し、誤りを修正できるかを試験してください。説得力のあるデモは、試す価値のある能力を示しますが、任意のリポジトリでの信頼性を保証するものではありません。
このアップデートは、回答品質とは別に出力効率を測定する価値も高めます。短い応答は生成コストを削減できますが、タスクに必要な実装、説明、根拠を保っている場合に限ります。有用な検証が省かれるなら、トークン料金が下がっても退歩です。
DeepSeek V4.1-Flash-1017のAPI仕様
| 仕様 | DeepSeek V4.1-Flash-1017 |
|---|---|
| ネイティブAPI識別子 | deepseek-flash |
| コンテキストウィンドウ | 1Mトークン |
| 最大出力 | 384Kトークン |
| 入力対応 | テキストと画像 |
| 推論モード | 思考モードと非思考モード |
| 開発者向け機能 | ツール呼び出し、JSON出力、Responses API |
| アーキテクチャ | Causal Encoder–Decoder MoE |
| ファミリーの公称パラメータ数 | 552B |
| アクティブパラメータ | 入力時8B;出力時16B |
ベンチマークでのDeepSeek V4.1-Flash-1017の性能は?
独立した初期テスト(例:DeepSeek V4 Proとの並走比較)では、1017が実務タスクで同等の品質を示しつつ、顕著に高速かつ低コストで、さらにProの一部構成で欠けていたビジョン対応を追加したことが確認されています。
ここでは9月版と10月17日版のベンダー報告を比較します。
| 公式ベンチマーク結果 | 9月版 | 10月17日版 | 絶対スコア変化(ポイント) |
|---|---|---|---|
| HLE(ツールなし) | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography(ツール使用) | 78.9 | 83.0 | +4.1 |
これらはベンダー報告であり、独立再現ではありません。DeepSeekはTerminal-Bench 4.0にClaude Code、DeepSWE v1.1にMini-SWE-V2を使用しています。HLEはツールなしのメインスコアを用いており、別途記載のテキストのみサブセットではありません;Chartographyはツール使用です。引用元のリリース表は他のベンチマークの各行で完全な構成(推論予算、ハードウェア、停止条件)を提供していないため、同等条件は仮定できません。上記の変化は単純なスコア差であり、相対的なパーセンテージ改善ではありません。
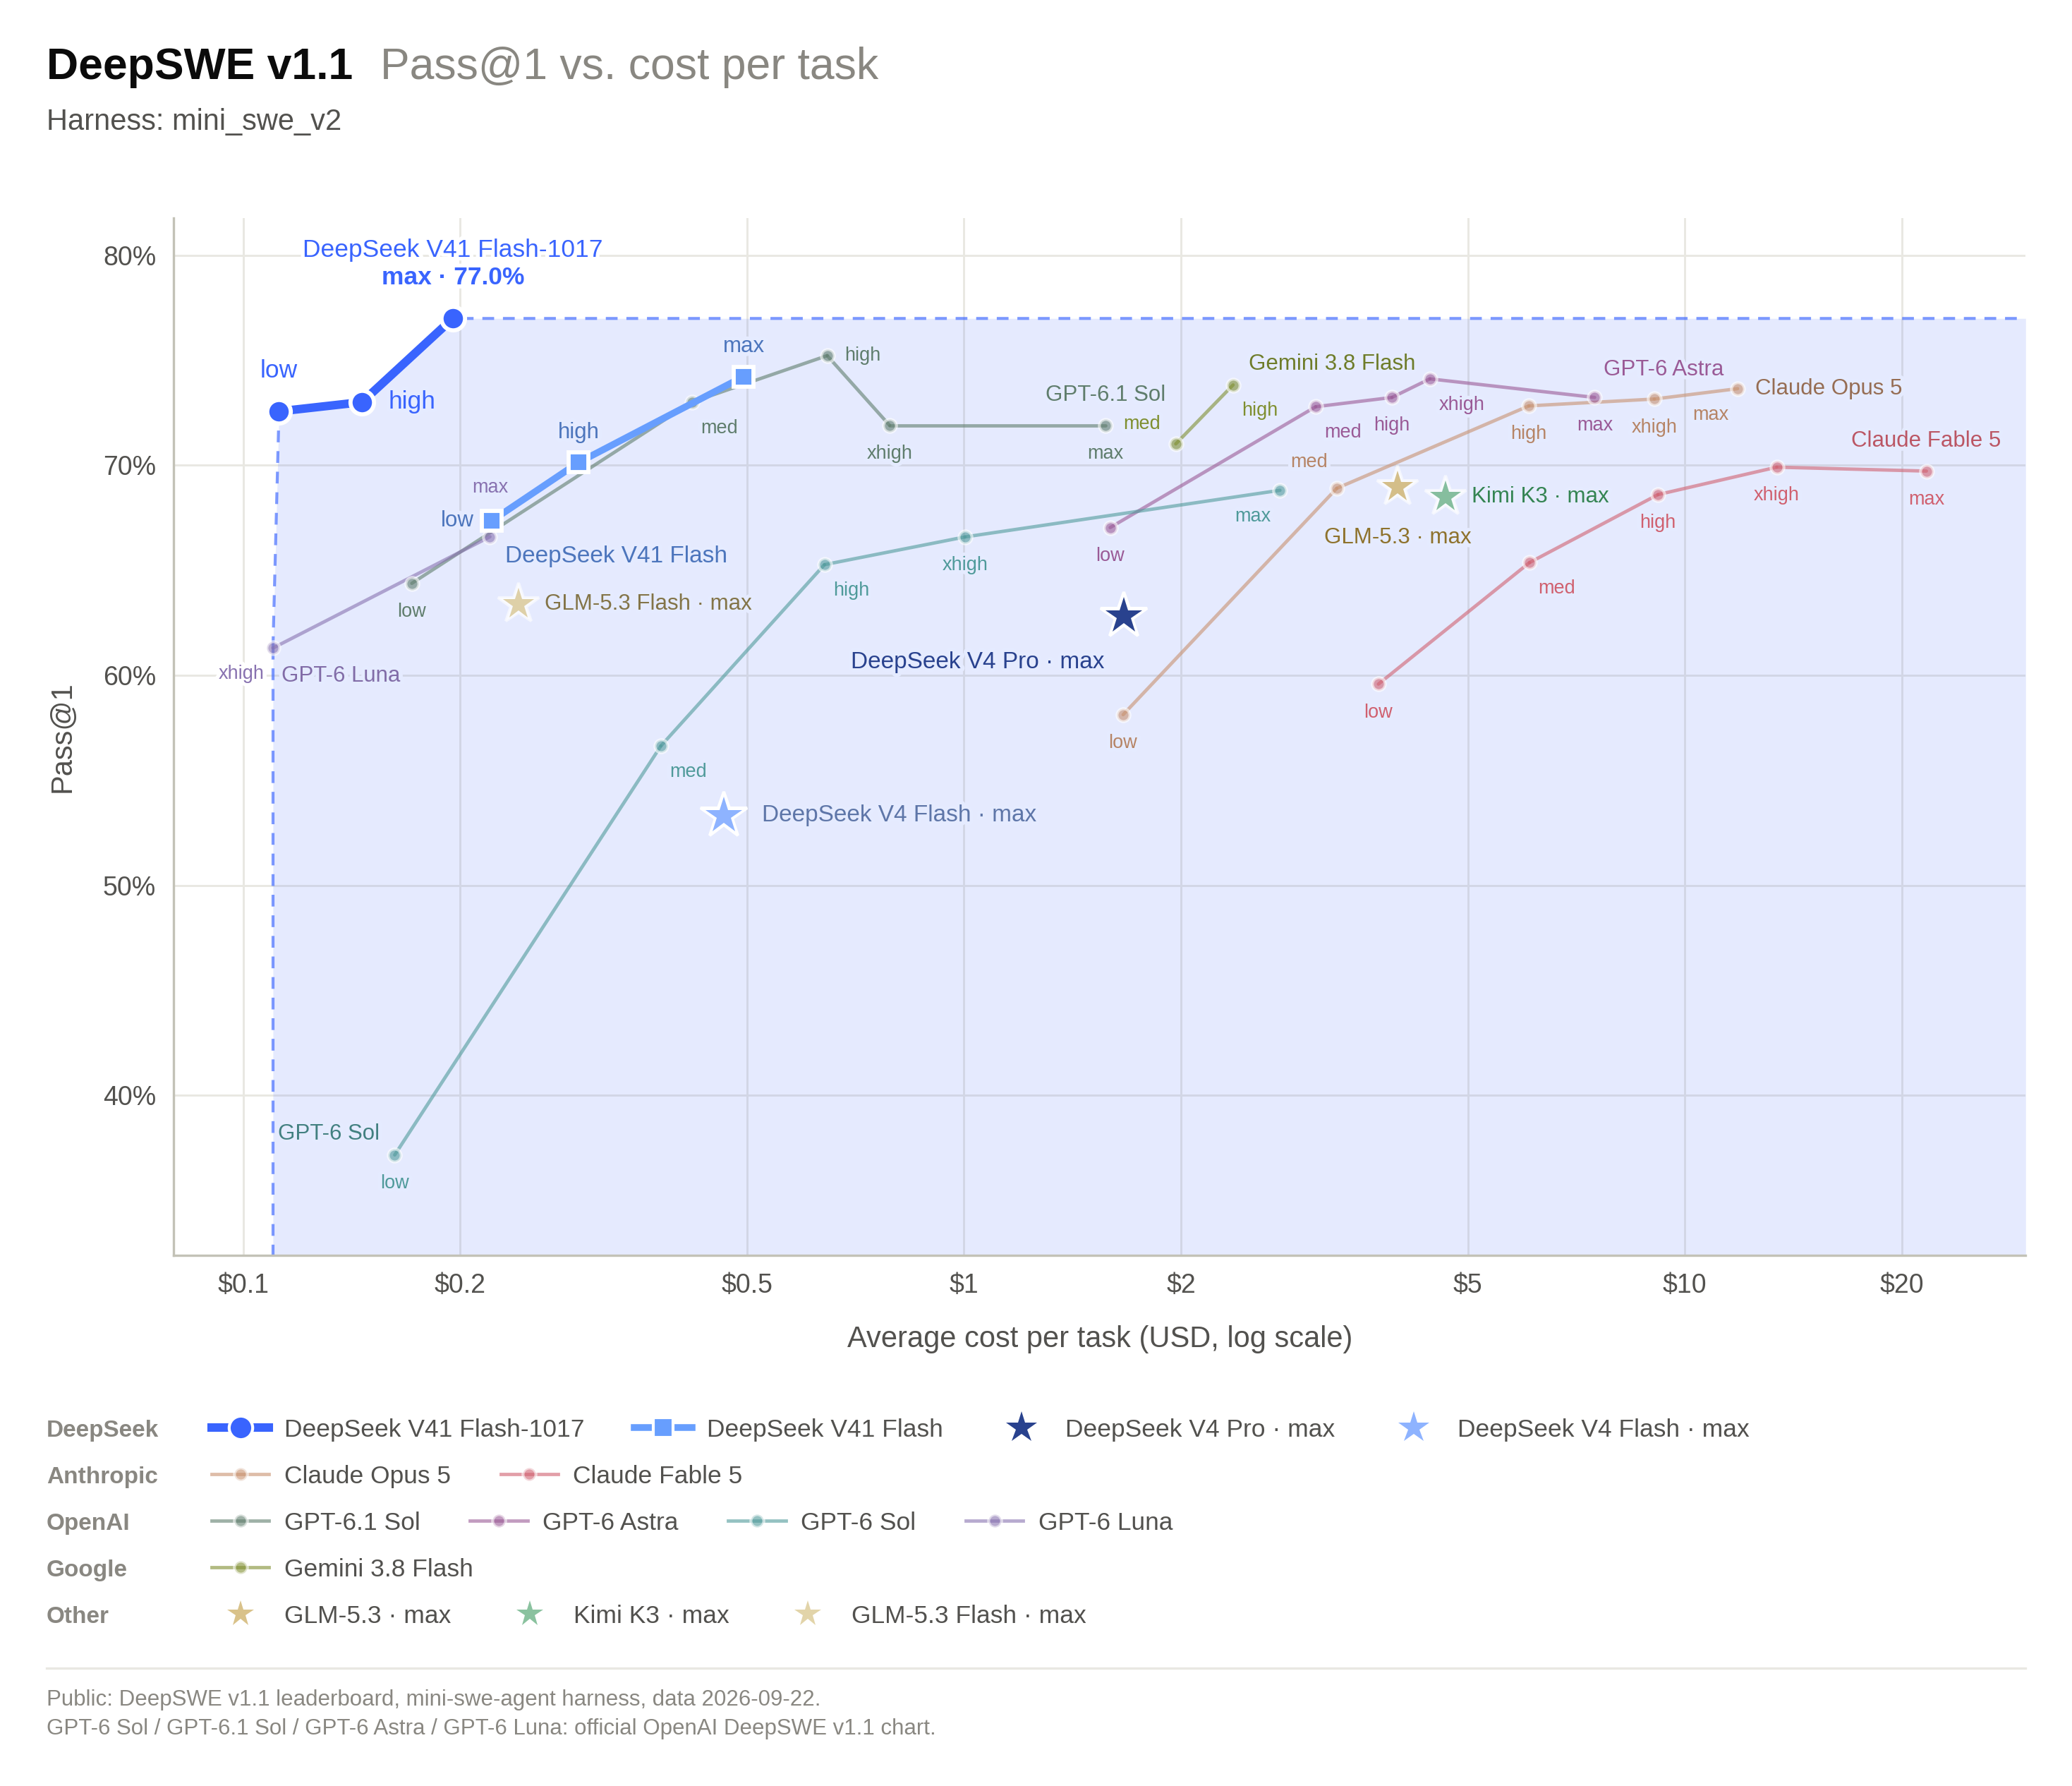
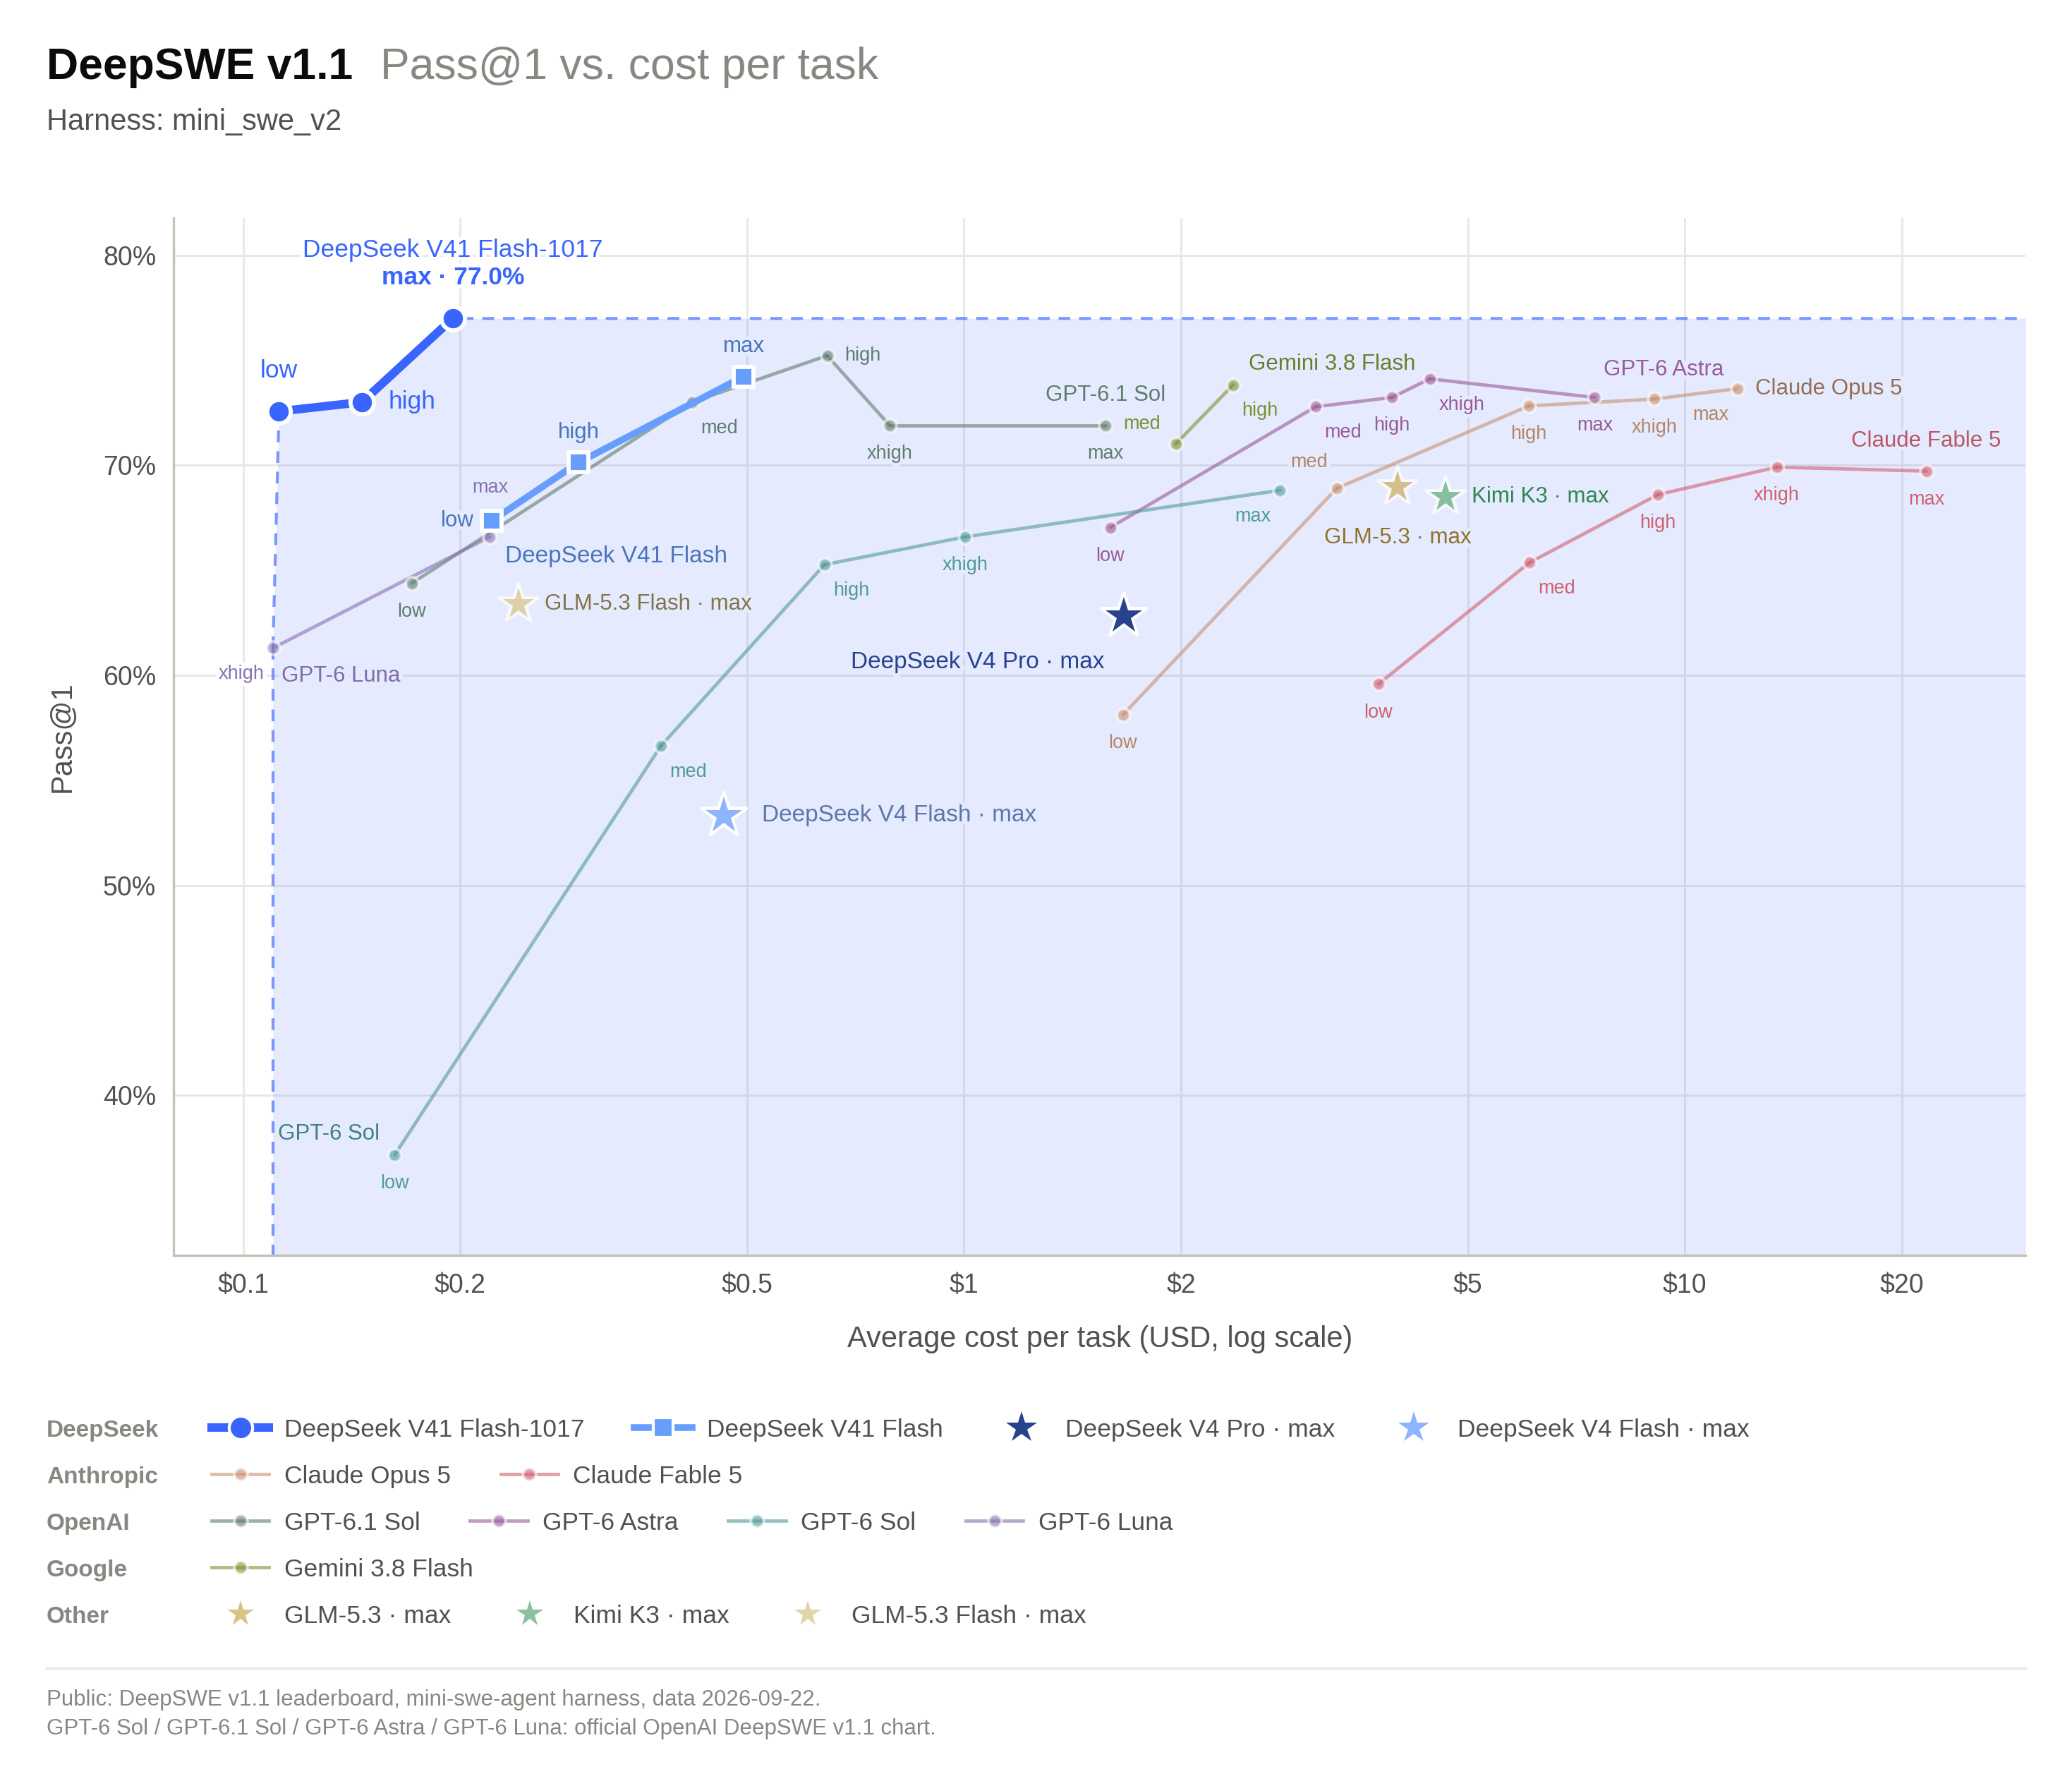
DeepSeekのDeepSWE v1.1の性能対コストチャートは、Mini-SWE-V2ハーネスを用いてPass@1とUSDの平均タスクコストを対数軸でプロットしています。推論設定ごとに別点で描かれるため、コスト結論を出す前に、適切な成功率と構成を比較してください。
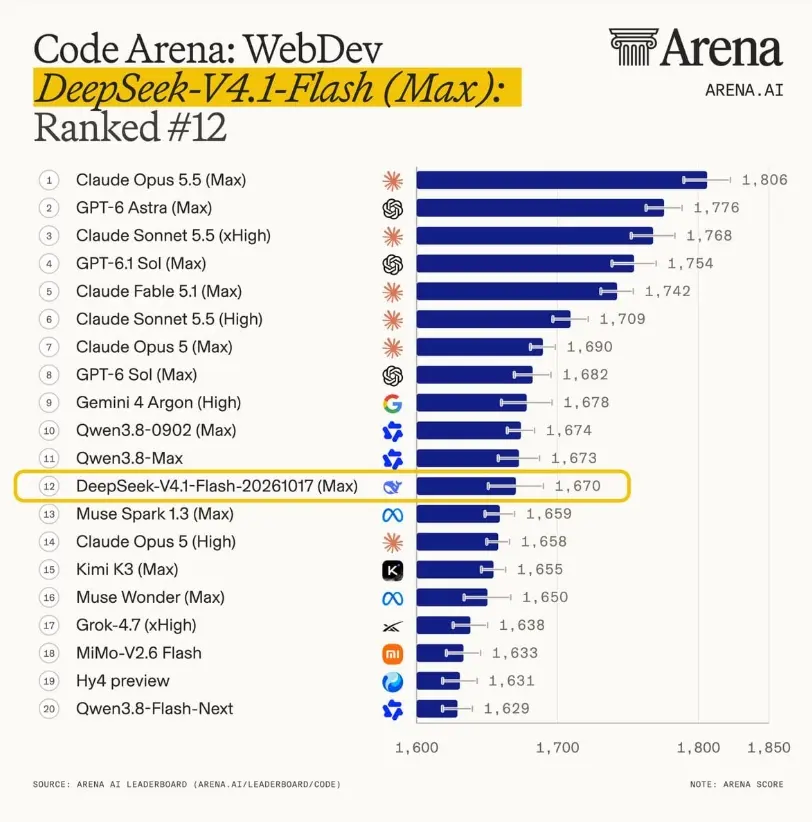
Code Arena: WebDev リーダーボード – オープンソースモデルのトップ
最新のWebDevフロンティアのコーディング/ウェブ開発ベンチ評価において、DeepSeek-V4.1-Flash-1017は高評価のKimi K3(Max)を上回っただけでなく、推論コスト効率を桁違いに改善—運用費が約1/10—しました。DeepSeek-V4.1-Flash-20261017(Max)はCode Arena: WebDevリーダーボードで公式にトップの座を獲得し、「ナンバー1のオープンソースモデル」の称号を得ています。
総合リーダーボードではスコア1670で12位を獲得。この高順位帯では、クローズドソースのリーディングモデルClaude Opus5(High)を上回り、トップ級モデルGPT-6Sol(Max)との差を10ポイント以内に縮めています。
10月版は9月版とどう違う?
9月版と比べ、10月17日版は選択したコーディング系ベンチで最も明確な伸びを示します:Terminal-Bench 4.0は31.2から42.3(+11.1ポイント)、ProgramBenchは20.3から29.1(+8.8ポイント)。DeepSWE v1.1は74.2から77.0(+2.8ポイント)。これらのベンダー報告は、ターミナルワークフローや広範なプログラミングタスクにおけるアップデートの評価を支持しますが、すべてのコードベースで同等の生産性向上を意味するものではありません。
リリースは、自己フィードバック強化学習による完全なプロジェクト開発をより重視しています。速度とトークン節約はタスク依存であり、その具体例は次節の2例が示す通りです。既存のネイティブAPI統合ではモデル識別子はdeepseek-flashのままです。したがって実務上のアップグレード判断は、代表的な作業での受理タスク数、総コスト、エンドツーエンド時間に基づくべきです。
DeepSeek V4.1-Flash-1017の費用は?
コスト面の優位性は非常に大きく、Flashはトップのクローズドモデルに比べてトークン単価が通常10~40倍安価で、短い出力によりマルチステップのエージェントでは節約効果がさらに増幅されます。前任版に対しては、1017は報告指標のすべてで純粋に向上しつつ価格を維持—完全なアップグレードです。
USD/100万トークン(2026年10月19日の記事ソースに記録)。CometAPIのピークラテは公開されている2×係数を適用。
| トークンカテゴリ | DeepSeekネイティブ:オフピーク | DeepSeekネイティブ:ピーク | CometAPIのDeepSeek V4.1 Flash API:ベース | CometAPI:2×ウィンドウ |
|---|---|---|---|---|
| 入力(キャッシュヒット) | $0.003 | $0.006 | $0.0024 | $0.0048 |
| 入力(キャッシュミス) | $0.15 | $0.30 | $0.12 | $0.24 |
| 出力 | $0.60 | $1.20 | $0.48 | $0.96 |
両プロバイダーは平日のピーク時間帯をUTC 01:00–04:00および06:00–10:00と記載。DeepSeekは中国の祝日を除外します;CometAPIの表示条件にはその免除が明記されていません。その他の時間帯はオフピーク/ベースレートです。CometAPIの2×列は同社の公開ベース価格から計算。
ネイティブDeepSeek APIで、未キャッシュの入力トークン1,000万+出力トークン200万のコストは:
- オフピーク: (10 × $0.15) + (2 × $0.60) = $2.70.
- ピーク: (10 × $0.30) + (2 × $1.20) = $5.40.
パイロット予算では、すべての試行に関わるトークンとツールの料金を受理タスクで割って算出してください。キャッシュ再利用とピーク時間帯を含め、インフラおよび人手によるレビューコストは別途報告。上記例はモデルトークンのみをカバーします。
SearchとFetchの料金
DeepSeekのSearchとFetch APIは、それぞれ成功リクエスト1,000件ごとに$0.75。課金はモデルトークン使用とは別で、失敗リクエスト、空の検索結果、タイムアウトはドキュメント記載のルール下では課金対象外です。
DeepSeek API利用者向けに、DeepSeek Harness、Claude Code、Codex経由のサーバーサイドSearch/Fetch呼び出しは公式課金方針の下で一時的に無料。これらの呼び出しの課金開始は2026年10月31日 16:00 UTC(北京時間の11月1日 0時と同等)。この限定的な免除は、すべてのスタンドアロンのSearch/Fetch APIリクエストを無料にするものではありません。
DeepSeek V4.1-Flash-1017は常に速くて安いのか?
いいえ。EmpirioLabsの2タスク試験では、水族館アニメーションで時間と出力トークンが低下した一方、スカイラインアニメーションでは上昇しました:
| EmpirioLabsの実測コーディングテスト | 9月版 | 10月17日版 | 観測結果 |
|---|---|---|---|
| 水族館の完了時間 | 162秒 | 124秒 | 10月版の方が高速 |
| 水族館の出力トークン | 41,833 | 33,149 | 10月版の方が少ない |
| スカイラインの完了時間 | 163秒 | 177秒 | 10月版の方が低速 |
| スカイラインの出力トークン | 37,928 | 42,907 | 10月版の方が多い |
両バージョンは、EmpirioLabsのAPIプラットフォーム上で2026年10月18日にこれらのテストで動作するアニメーションを生成しました。各タスクは同一プロンプトを使用し、外部ライブラリやアセットなしで、CSSとJavaScriptをインラインで含む自己完結型のHTMLファイルを1つ要求。両モデルともデフォルト設定、思考をデフォルトの予算で有効、出力上限は65,536トークン。各タスクは並行実行、モデルごとに1回の試行。時間はリクエスト全体をカバーし、推論トークンを含む出力トークン数はAPI使用レポートに基づきます。スクリーンショットはヘッドレスブラウザで6秒後にレンダリング。この2例はワークロードのばらつきを示すものであり、一般的な順位を確立するものではありません。
DeepSeek V4.1-Flash-1017へのアクセス方法
- 公式DeepSeek API — https://api.deepseek.com. でモデル名
deepseek-flashを使用 - オープンウェイト — セルフホスティング向けにHugging FaceまたはModelScopeからダウンロード
- CometAPI — CometAPIがDeepSeek-V4.1-Flash-1017を追加 モデル詳細を見る モデルID:deepseek-v4.1-flash-1017
ネイティブDeepSeek APIを使う
DeepSeekのAPIクイックスタートおよびCometAPIは、deepseek-flashが現在10月17日版を提供し、呼び出し方法が変わらないことを確認しています。
PythonでAPI経由のプロジェクト計画リクエストを送信します。OpenAIのPythonパッケージをインストールし、実行前に環境変数でAPI_KEYを設定してください。
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
これによりモデルの応答が生成されます。プロジェクトを自動的に構築/検証するには、ファイルアクセス、コマンド実行、テストフィードバック、適切な権限を備えたエージェント環境が別途必要です。
CometAPI 推奨:CometAPIは既に各種DeepSeekモデルを掲載しており、Claude、GPT、Gemini、Grok、特化型コーディング/ビジョンモデルと並行してV4.1-Flash-1017を試す優れた方法です。登録してAPIキーを取得し、既存のOpenAI SDKをCometAPIのベースURLに向けてください。このアプローチは、サブタスクを最も費用対効果の高い、または最高性能のモデルへルーティングできるエージェントフレームワークに特に有効です。
結論
DeepSeek-V4.1-Flash-1017は、オープンAIの能力を賢く効率的に前進させる一歩です。重要なエージェント/コーディング系ベンチマークでの性能を改善しつつ、出力長とタスク時間を同時に短縮—しかも低価格据え置き—することで、性能対価格の競争でのDeepSeekの優位を強化します。自律ソフトウェアエージェント、マルチモーダルアプリケーション、コスト最適化された本番システムを構築する場合、このモデルは真剣な評価に値します。
CometAPIのような便利なアクセスレイヤーと組み合わせることで、開発者はV4.1-Flash-1017のような最先端モデルを、複数ベンダーのワークフローに摩擦少なく統合できます。独立評価が増え、ツール群(Harness、CodeBuddyなど)が成熟するにつれ、このチェックポイントは2026年後半以降、多数の高ボリューム・高知性ワークロードのデフォルト選択になると期待されます。