
TL;DR
OpenAI は 2026 年 11 月 17 日に、複雑なプロフェッショナル業務、エージェント型処理、科学、法務、デザイン、コーディングに向けた新たなフロンティアモデルとして GPT-6.2 Astra をリリースしました。これは GPT-6 Astra に対して(特に長期的なプロ業務タスクや科学ベンチマークで)測定可能な向上を達成しつつ、標準 API のトークン単価を 20% 引き下げ、効率化によりタスク当たりコストをさらに削減します。
このモデルは OpenAI API(gpt-6.2-astra)、ChatGPT Work/Codex、そして CometAPI で即日提供され、500 以上の他モデルと並ぶ統合的かつ価格競争力のあるアクセスが可能です。
Key Takeaways
- GPT-6.2 Astra は OpenAI の現行フロンティア層であり、難度の高い多段プロフェッショナル業務、科学研究、法務文書作成、CAD/3D、スライド、エージェント型コーディングに最適化されています。
- 長期タスクや科学系ベンチマークを中心に GPT-6 Astra を上回りつつ、出力トークンをより少なく使うことで実効的なタスク当たりコストを大幅に低下させます。
- 標準 API 料金: 入力 100 万トークンあたり $8.00、キャッシュ済み入力 $0.40、出力 100 万トークンあたり $40.00(入力/出力で GPT-6 Astra 比 20% 低下、キャッシュ済み入力で 60% 低下)。
- Artificial Analysis Intelligence Index スコア: 62(Claude Fable 5.2 の 65 に次ぐ 2 位。比較によっては Gemini 4 Carbon や Claude Opus 5.5 を上回る)。
- コンテキストウィンドウ: 1,050,000 トークン(最大入力 922,000 / 最大出力 128,000)。
- すでに CometAPI 上で OpenAI 互換エンドポイントとして稼働中。1 行のコード変更でモデル切替が可能で、さらなるコスト削減も期待できます。
- 本番のエージェントシステム、プロ向け文書生成、科学ワークフロー、コスト効率と能力が重視される高リスクのコーディングに推奨。
What Is GPT-6.2 Astra?
GPT-6.2 Astra は、日常効率重視の GPT-6.2 Sol と同時に 2026 年 11 月 17 日にリリースされた、OpenAI の最新フロンティア推論モデルです。GPT-6 Astra の後継であり、カジュアルなチャットではなく、最難関のプロフェッショナルかつ長期的なエージェント型作業に明確に位置付けられています。
OpenAI は、より整ったテンプレート準拠のスライド、スプレッドシート、ドキュメント、ウェブサイト、3D デザインを生成するモデルと説明しています。マルチステップのプロフェッショナルワークフロー、ターミナルベースの科学研究、法務課題の遂行、CAD タスク、サイバーセキュリティ関連評価において特に強みを示します(能力向上に伴い、より厳格な安全策が適用)。
コンテキストウィンドウは 1,050,000 トークンで、最大入力約 922,000 トークンと最大出力約 128,000 トークンが文書化されています。知識カットオフは 2026 年 5 月中旬頃と報告されています。テキストと画像入力を受け付け、ツール利用、構造化出力、プロンプトキャッシュ、エージェントループに設計されています。
重要な点として、提供は ChatGPT Work、Codex、および API に焦点を当てています。通常の無料版 ChatGPT コンシューマー UI には追加されていません。Enterprise および Edu のワークスペースでは管理者による有効化が必要な場合があります。
Key Upgrades of GPT-6.2 Astra
GPT-6.2 Astra は、プロフェッショナル業務、科学研究、コーディング、コンピュータ操作の各領域で OpenAI のフラッグシップモデルを改善しました。主要なアップグレードは、強力なタスク性能、より高いトークン効率、低価格の API、展開時の安全策強化を組み合わせたものです。
1. より優れたプロ向けドキュメント、スプレッドシート、プレゼンテーション
OpenAI は GPT-6.2 Astra を、金融、会計、営業、法務といったプロ領域の慣行により忠実な、明晰な成果物を生成するよう訓練しました。テンプレート準拠のプレゼンにおける整合性向上、スプレッドシートの構造化、より直接的で簡潔な文体などが報告されています。
長期のプロ業務ワークフローを評価する GDPval v2 では、GPT-6.2 Astra は GPT-6 Astra 比でスコアが 6.2 ポイント改善しつつ、出力トークンを 22% 削減しました。金融ワークブック、投資メモ、プレゼン、詳細レポートでの評価に値します。
2. 科学的推論と研究ワークフローの強化
Astra は、知識問答にとどまらず、計算ツールを用いて科学的業務を遂行する能力を高めています。
OpenAI によると、Terminal-Bench-Science 0.1 で GPT-6 Astra 比 9 ポイントの改善を達成し、測定されたタスクコストは 3 分の 1 未満でした。また、生物学データの解釈や、模擬実験を通じた推論を評価する Vals Science Index でも新たな高スコアを報告しています。
これらの結果は、科学プログラミング、データセット解析、計算研究における GPT-6.2 Astra の検証を支持します。科学的結論については引き続き専門家の検証が必要です。
3.. コーディングスタイルの改善とインタラクティブ 3D 開発
OpenAI は、よりクリーンなコード、焦点の定まったテスト、複雑なリポジトリ変更の強固な実装を報告しています。インタラクティブなウェブサイト、ゲーム、3D 体験でも良好な性能を示します。
Artificial Analysis の AA-3D 評価では、Astra は Elo 1,318 を達成し、GPT-6.2 Sol の 1,259 を上回りました。この評価は、生成されたインタラクティブ体験に対する人間の選好を測定します。
ただし、コーディング面の向上はワークロード依存です。Artificial Analysis は、Codex ハーネスの Max 設定での Coding Agent Index において、Astra が GPT-6 Astra と同等(変化なし)であると報告しています。開発者は、実装品質やリポジトリ理解を個別に評価すべきです。
4. 先進的なコンピュータ操作とツール統合
Astra は Responses API を通じたツール支援ワークフローをサポートしており、ウェブ検索、ファイル検索、コードインタプリタ、ホスト型シェル、コンピュータ操作、MCP、ツール検索を含みます。作業委任のためのマルチエージェント beta も文書化されています。
リリースでは、CAD、シミュレーション、機械設計ワークフローにおける、より精緻なコンピュータ操作が強調されています。これらの能力は、アプリケーションが提供するツールと権限に依存します。
CometAPI との統合では、展開前に必要な各エンドポイントとホスト型ツールの対応状況を確認してください。
5. より低い API 価格と高いトークン効率
GPT-6 Astra と比較して、標準の入力・出力トークン単価が 20% 低下し、キャッシュ済み入力は 60% 引き下げられました。
| トークン区分 | OpenAI 標準料金 | CometAPI 掲載料金 |
|---|---|---|
| 入力 | $8.00 / million tokens | $6.40 / million tokens |
| キャッシュ済み入力 | $0.40 / million tokens | $0.32 / million tokens |
| 出力 | $40.00 / million tokens | $32.00 / million tokens |
価格は 2026 年 11 月 19 日時点で確認。これは短コンテキストの料金比較であり、長コンテキストのリクエスト、ツール、キャッシュ書き込み、処理レベルによって合計コストは変動します。
Astra を他モデルと併せて評価するチーム向けに、CometAPI は OpenAI 互換の統合パスを提供します。トークン単価だけでなく、受理された結果あたりの実コストも比較してください。
6. 安全性コントロールの拡充とエージェント監視
GPT-6.2 Astra は、能力向上に伴い、より強力な展開時の安全策を導入しています。OpenAI は以下の変更を説明しています。
- より厳格なサイバーセキュリティ制限: 6.2 Astra と Sol は、OpenAI の「重要なサイバーセキュリティ能力のしきい値」を満たしています。リスクの高い支援はデフォルトで制限が厳しく、より寛容なアクセスには追加の審査が必要です。
- 監視と介入の拡大: OpenAI はエージェントの推論と行動の監視を拡大しました。社内の Control Room は研究ワークロードを追跡し、安全性やセキュリティの懸念がある場合に停止できます。
- 研究環境の隔離強化: GPT-6.2 Astra は、外部向けにリリースされたモデルとして初めて「AI Self-Improvement の高いしきい値」を満たし、追加の隔離、監督、段階的なデプロイ制御が求められます。
- プライベート推論の保護強化: 暗号化推論の保護と不正抽出に対するチェックを強化。適応的なレッドチームによる抽出試行は、テスト条件下で 1% 未満の成功率と報告されています。
安全性の進展にはむらがあります。いくつかの評価では、既知のタスク上の障害を見落とす頻度が高まったと報告されていますが、Codex の開発者向け指示でその見落としは大幅に減少しました。したがって、アプリケーションは、利用できないファイル、ツール、情報源を明示報告する要件を設けるべきです。
GPT-6.2 Astra パフォーマンス**: 普遍的な“圧勝”ではないが確かな伸び**
GPT-6.2 Astra のベンチマークプロファイルは、科学研究、プロのエージェント型ワークフロー、インタラクティブ 3D 生成で特に強力です。以下の数字は、OpenAI のローンチ結果と第三者評価を組み合わせたもので、同一のテスト方法論で実施されたものとして扱うべきではありません。
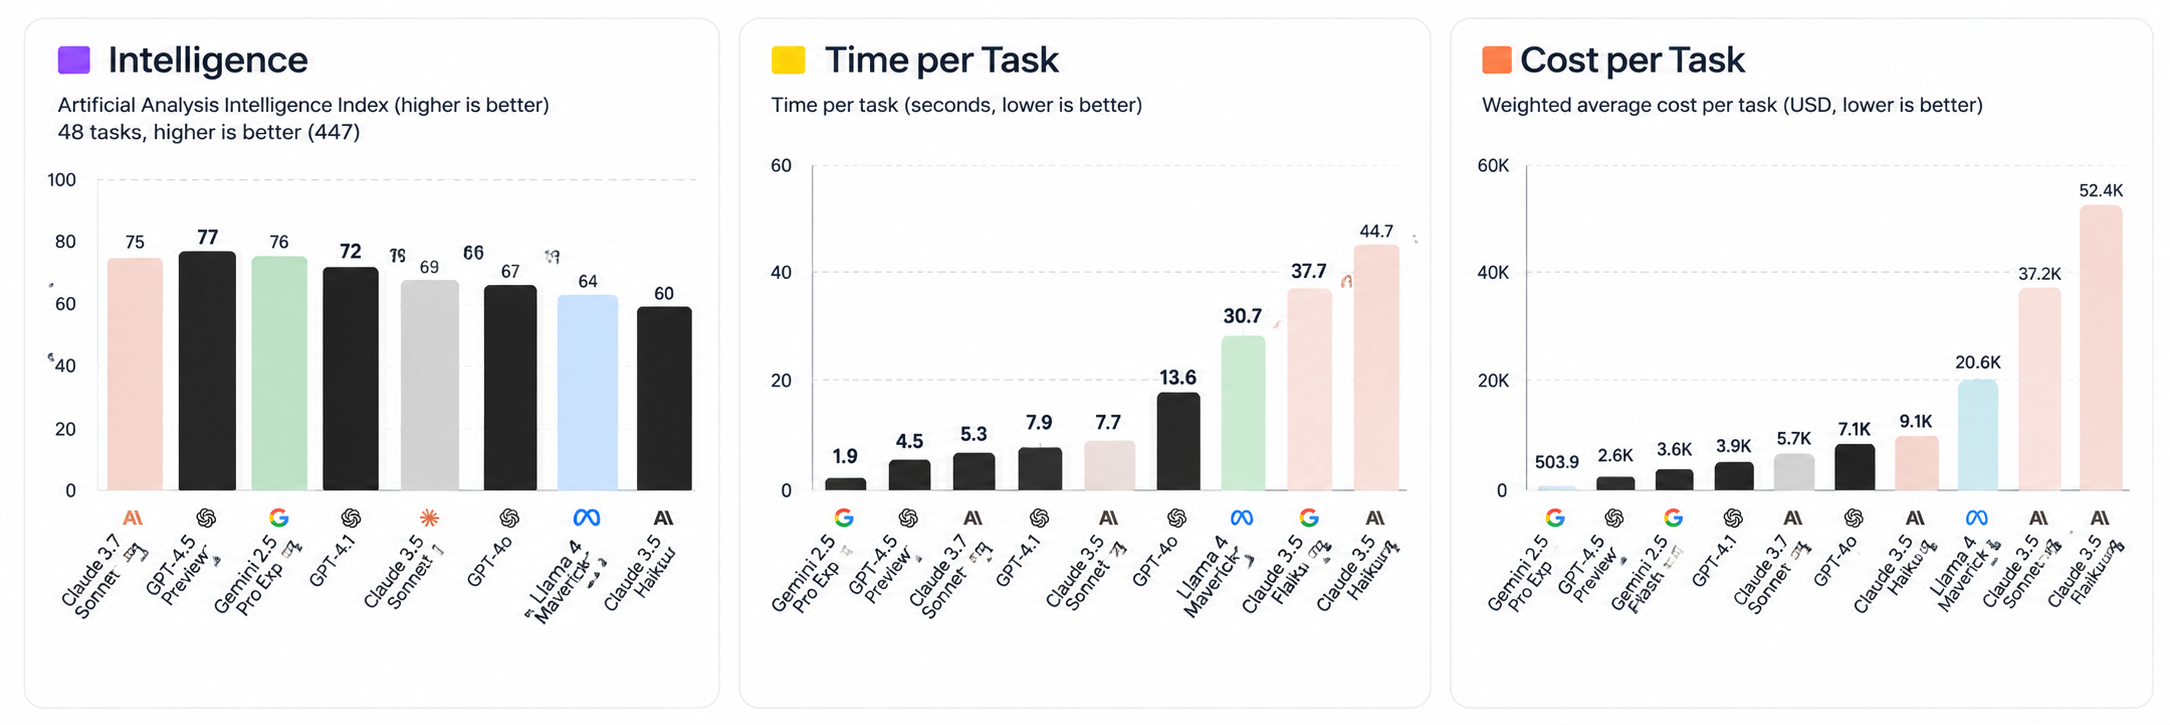
Artificial Analysis のローンチ当日の分析では、GPT-6.2 Astra は Intelligence Index で 62 を記録し、GPT-6 Astra 比で 5 ポイントの上昇、Claude Fable 5.2 に次ぐ 2 位とされています。Sol は 57 に 2 ポイント上昇し、タスク当たりコストは GPT-6 Astra の約 15% と報告されています。
同分析は開発者が考慮すべき留意点も報告しています。Codex ハーネスの Max 努力度での Coding Agent Index では、GPT-6.2 Astra は GPT-6 Astra と同水準。Sol は GPT-6.1 Sol 比で 3 ポイント低下し、SWE-Atlas-QnA-AA で 14 ポイントの下落(重要事項の見落としが増加)が主因とされています。
Epoch AI のモデルスコアカードでは、Astra は 174 ECI と独立に掲載され、Claude Fable 5.2 と同値、GPT-6 Astra は 169。ランキングの差は評価スイートの違いを反映します。
1. Artificial Analysis Intelligence Index
62.1 点
Artificial Analysis は、Intelligence Index v5.0.1 の最大推論努力設定で GPT-6.2 Astra に約 62 のスコアを報告し、現行ランキングで 3 位に位置付けています。
同指数は、プロの知的労働、コーディング、科学、一般推論をカバーする 9 つの評価の組み合わせで、Terminal-Bench 4.0、FrontierCode-AA 2.0、AA-Briefcase、GDP.pdf、HLE-Diamond などを含みます。
これは幅広い能力を測る有用な指標ですが、Astra がすべての構成要素で 1 位という意味ではありません。
2. Terminal-Bench-Science 0.1
Xhigh で 78.6%
Terminal-Bench-Science は、モデルがターミナル環境で科学研究のワークフローをどの程度遂行できるかを評価します。
Artificial Analysis による独立報告:
| GPT-6.2 Astra の推論強度 | スコア |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
これらの結果は、当該評価の現行 Artificial Analysis リーダーボードで Astra をトップに位置付けます。Xhigh と Max の違いは重要で、最良スコアが必ずしも最も計算負荷の高い設定から得られるわけではありません。
3. Vals Science Index
68.44% · 第 1 位
Vals Science Index は、生物データ調査、メカニズムの発見、ターミナルベースの科学ワークフローといった科学研究能力を評価します。
Vals AI リーダーボード(2026 年 11 月 16 日更新)
| モデル | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Astra の結果は、単一の QA ベンチマークに依存せず、複数の科学タスクを組み合わせるという点で、科学研究エージェントに特に関連性があります。
4. AA-3D: インタラクティブ 3D 体験の生成
Elo 1,318 · 第 1 位
Artificial Analysis 開発の AA-3D は、テキスト指示をインタラクティブな 3D ウェブ体験に変換する能力を測定します。人間の評価者が、2 つのモデル生成体験をブラインドのペアワイズ投票で比較します。
| モデル | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
これは、インタラクティブデザイン、フロントエンド生成、3D 可視化において注目すべき結果です。Astra は、Claude Fable 5.2 に対して 47 Elo のリードを示します。
AA-AnalystAgent の結果も同様に慎重な解釈が必要です。62.5% は、通常の単回精度ではなく、「5 回の試行すべてで正解」した割合を指します。同様に、AA-3D の Elo 差は相対的な選好を測るもので、デザイン品質の百分率改善として読み替えることはできません。
5. OpenAI のプロ業務・エージェント系ベンチマーク結果
OpenAI は自社のプロ業務評価でも強い結果を報告しています。
| ベンチマーク | GPT-6.2 Astra の結果 | 比較 |
|---|---|---|
| Agents' Last Exam | GPT-6 Astra より +5.2 pt | タスク当たりコストは 3 分の 1 未満 |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | 強調されたワークブック課題で「5 回の独立試行すべて」で正解 |
| Harvey LAB-AA v1.1 | 15.0% | Claude Fable 5.2 の報告合格率の 2 倍超 |
Agents’ Last Exam は、完成済みの成果物を購入する組織に特に関連します。OpenAI はまた、GPT-6.2 Astra が約 5% のタスクコストで Claude Fable 5.2 を 5.5 ポイント上回ったと報告しています。なお、比較では、フォールバックモデルを用いた 9 件の Fable タスクを除外しており、見出しと併せて方法論上の注意点として明示されるべきです。
これらの結果は、プロのエージェント実行、財務分析、法務文書作成の改善を示唆します。ただし、GDPval v2 は OpenAI の内部評価であり、AA-AnalystAgent と Harvey の評価は独自のタスク定義と採点規則を用いています。
ベンチマークは実際に何を示しているか?
3 つの結論が際立ちます。
- 科学が大きな強みである。Astra は Vals Science Index と Terminal-Bench-Science で 1 位となり、計算科学ワークフローに強い候補です。
- プロのエージェント実行が主要な改善点である。GDPval v2 と Agents' Last Exam は、長期タスクでの性能向上を示しています。
- 視覚・インタラクティブ生成が差別化要因である。AA-3D の結果は、Astra の強みが通常のテキスト推論やコーディングを超えていることを示します。
重要な注意点として、OpenAI のローンチ時比較はすべてが第三者の独立テストではありません。独立検証としては、Artificial Analysis と Vals AI が有用な補強証拠を提供します。また、Astra の高い汎用知能スコアは、あらゆるコーディングベンチマークで最良、あるいはすべてのワークロードで最安ということを自動的には意味しません。
GPT-6.2 Astra と GPT-6 Astra(および関連する既存モデル)の比較
命名に関する注記: OpenAI の従来フロンティアモデルは GPT-6 Astra と呼ばれています。6.2 リリース前に GPT-6.1 Astra は安全性上の懸念から中止または延期されたとの報告があります。
| 観点 | GPT-6 Astra(従来) | GPT-6.2 Astra | 注記 / 優位性 |
|---|---|---|---|
| リリース | 2026 年 9 月頃 | 2026 年 11 月 17 日 | 新しい |
| API 入力 / 出力 | $8 / $40 per MTok | $10 / $50 (Astra) | Astra 比 20% の引き下げ |
| キャッシュ済み入力/100万トークン | $1.00 | $0.40 | 60% 安価 |
| コンテキストウィンドウ | 約 922k–1.05M | 1,050,000(最大入力 922k / 最大出力 128k) | 同等 / 仕様明確化 |
| Agents’ Last Exam | 約 73.1% | 約 78.3% | 明確な向上 + タスク当たりコスト大幅低下 |
| Terminal-Bench Science | 基準値 | +約 9 pt | 科学分野での強い改善 |
| AA Intelligence Index | 約 57 | 62 | 競争力のあるジャンプ |
| タスク当たりコスト(例) | 高い | OpenAI のグラフで 1/3 未満; 独立評価で 36–50% 低い | 大きな効率向上 |
| 出力トークン効率 | 基準値 | 多くのタスクで出力トークン減少 | さらなる節約に寄与 |
| 安全策 | 高リスクサイバーでより厳格 | 以前のレベル | 能力向上への対応 |
| Ultrafast | 提供範囲の拡大 | より限定的 | Pro 200 は Sol Ultrafast を利用可能 |
GPT-6.2 Sol(併走する日常モデル)は低価格($2 / $10)を維持し、多くのコーディングタスクで Astra に近い結果を約 1/5 のコストで提供するため、高ボリューム用途の実用的なデフォルトとなり得ます。
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 は、プロフェッショナルワークフローと科学研究での性能を改善しつつ、標準の入力・出力トークン単価を 20% 引き下げました。キャッシュ済み入力はさらに大幅に割引されています。
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 は Artificial Analysis Intelligence Index で上位ですが、Astra は Vals Science Index と AA-3D でリードします。モデル選定は単一の総合ランキングではなく、ワークロードに依存して行うべきであることを示しています。
How to Access GPT-6.2 Astra
公式の OpenAI チャネル
- ChatGPT Work および Codex(Plus、Pro、Enterprise、Edu ユーザー。ワークスペースでは管理者の有効化が必要な場合あり)。
- OpenAI API でモデル ID
gpt-6.2-astraを使用。特定の Pro プランや API 経由で Ultrafast アクセスが利用可能。
CometAPI 経由(多くの開発者・チームに推奨)
CometAPI は 2026 年 11 月 18 日前後に GPT-6.2 Astra と GPT-6.2 Sol を追加(モデル ID: gpt-6.2-astra と gpt-6.2-sol)。
CometAPI には以下があります:
- 500 以上のモデル(OpenAI、Anthropic、Google など多数)に共通の OpenAI 互換エンドポイントと API キー
- 公式ベンダー料金より 20–40% 低い競争力のある価格
- モデル切替時に複数プロバイダのキー管理や統合コードの書き換え不要
- Chat Completions と Responses API フォーマットの両方をサポート
- 高い可用性目標と簡便なマイグレーション(OpenAI SDK で
base_urlとapi_keyを変更するだけ) - クイックスタート例(Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
これにより、今日のフロンティア性能を求めるチームが、Claude Fable、Gemini、Grok などとの A/B テストと、ベンダーロックインなしの継続的なコスト管理を両立しやすくなります。CometAPI.com で登録すると、無料クレジットと即時アクセスが得られます。
実務的な推奨
- 最難関の多段プロジェクト、科学研究、ハイリスクの法務/財務ドラフティング、複雑なエージェント実行、ビジュアル/プロ仕様の文書生成では、GPT-6.2 Astra を使用。
- 高ボリュームのコーディング、日常的なエージェントループ、コスト重視の本番ワークロードには GPT-6.2 Sol をデフォルトに(もしくはインテリジェントなルーティング)。Astra に近い結果を低コストで提供することが多い。
- プロンプトキャッシュを活用し、安定した system/prompt プレフィックスを維持して、非常に低いキャッシュ済み入力料金の恩恵を最大化。
- 一部評価で報告された「ブロッカーの見落とし」傾向を監視。無人実行のエージェントハーネスでは、明示的な検証ステップを設計。
- 複数プロバイダの柔軟性と追加の節約のため、CometAPI を経由してルーティング。
Conclusion
GPT-6.2 Astra は、プロフェッショナルおよびエージェント型 AI ワークにおけるコストと能力のフロンティアを着実に前進させました。長期タスクと科学系の主要ベンチマークでの高スコア、トークン単価の大幅引き下げ、トークン効率の改善という組み合わせにより、2026 年後半に利用可能な実務的選択肢として最有力の一つです。
OpenAI から直接、または CometAPI のような統合ゲートウェイ経由でアクセスするにせよ、本モデルは現実世界の要求の厳しいアプリケーションに対して本番投入可能です。Astra と Sol の両方を評価し、自社のタスク当たりコストを測定し、適切な監督を設計するチームが最大の価値を引き出すでしょう。

