
Grok 4.7 リリースアップデート:予測から正式提供へ
確認日時: 2026年10月16日。
Grok 4.7 は 2026年9月21日に正式リリースされました。9月12日リリースという先行言及はプレリリース時点の推定であり、実際のリリース日として扱うべきではありません。
公式のローンチ告知では、コーディング、ナレッジワーク、長時間実行タスク、そしてモデル自身の結果検証における改善が説明されています。提供チャネルとして Grok API、Cursor、Grok Build が確認されています。正確な API モデル ID、対応機能、コンテキスト上限、最新の価格については、公式の Grok 4.7 ドキュメントを参照してください。
公式結果は Grok 4.6 に対する測定可能な進歩を示しています。たとえば、ローンチ比較では、Grok 4.7 は xhigh effort 設定で Terminal-Bench 4.0 スコア 37.6%、Grok 4.6 は high effort 設定で 20.3% と報告されています。これらは指定された評価条件下でのプロバイダ報告値であり、アプリケーションの実力はプロンプト、ツール、推論の努力レベル、タスク難易度に依存します。
開発者にとって重要なのは、Grok 4.7 が自分たちのワークロードをより確実かつ経済的に完了できるかどうかです。リポジトリの変更、ドキュメント作成、複数ステップのツールワークフローで試験し、成功完了率、レイテンシ、リトライ、総タスクコストを計測してください。
出典: Official Grok 4.7 launch announcement
Key Takeaways
- 9月12日の想定日は、Musk の10日間カウントダウンからの推定であり、xAI の別個に公開されたカレンダー告知ではありません。
- 2.1T 規模および SpaceX データ利用の言及はプレリリース段階の主張であり、稼働パラメータ、ルーティング、アーキテクチャ、学習手法は未公開のままです。
- Grok 4.6 はすでにナレッジワークやエージェント系で強い結果を示しており、FrontierCode v1.1(Extended)で 61.3% を記録していますが、難度の高いコーディング評価のいくつかでは最強の比較モデルに及びません。
- Grok 4.7 は、パラメータ数だけでなく、受理タスク率、長期ホライズンの信頼性、トークン効率、レイテンシ、成功あたりコストで評価すべきです。
- CometAPI は xAI がモデルを正式リリースし本番エンドポイントアクセスが可能になり次第 Grok 4.7 を統合します。移行前にライブのモデル ID、価格、応答挙動を必ず検証してください。
What Is Grok 4.7?
Grok 4.7 は Grok 4.6 の後継としてアナウンスされており、xAI のコーディング、エンジニアリング、長時間実行のエージェント、プロフェッショナルなナレッジワークへの注力を継続する見込みです。現在の公開情報は、創業者の発言とリリースカウントダウンが中心で、完全な技術的ローンチパッケージではありません。
最重要の区別は3つの対象物の間にあります。すなわち、アナウンスされた Grok 4.7 モデル、規模や学習に関するプレリリースの示唆、そして稼働中のGrokk 4.6 本番ベースラインです。xAI が最終ドキュメントを公開し、リリース済みエンドポイントへのリクエストが成功するまでは、Grok 4.7 を今後の評価候補として扱うべきです。
Grok 4.7 Release Date and Timeline
Grok 4.7 はいつリリースされる見込みですか?
Musk が9月2日に「10日後に到着」と述べたことから、目安は2026年9月12日となります。
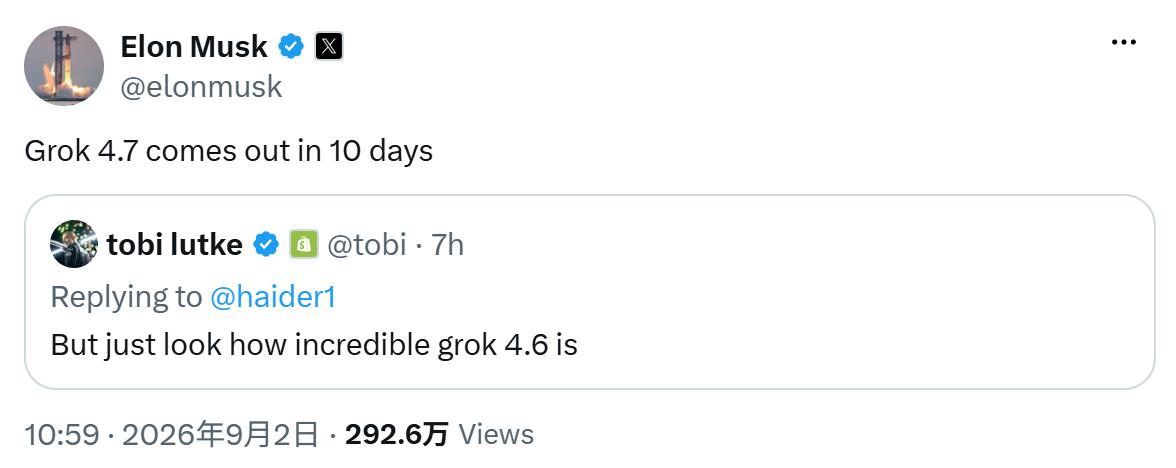
出典: Elon Musk on X, September 2, 2026
Grok 4.7 リリースタイムライン
| 日付 | 公開シグナル | 解釈 |
|---|---|---|
| 2026年7月下旬 | Musk が約 2.1T モデル、トークン効率の改善、やや遅いサービングを説明。 | 創業者によるモデル規模と効率に関する期待値の言及。 |
| 2026年8月12日 | 初期学習の完了が説明され、補足学習には SpaceX 企業データが相当量含まれると報告。 | 学習進捗の更新であり、リリース確定ではない。 |
| 2026年9月2日 | 「Grok 4.7 は10日後に出る。」 | これまでで最も明確な公開カウントダウン。 |
| 2026年9月12日 | カウントダウンから導かれるカレンダー日。 | 想定ターゲット。最終的な可用性は xAI のリリース告知と稼働エンドポイントの確認が必要。 |
Grok 4.7 仕様:確定情報と未確定情報
現時点の Grok 4.7 情報は、創業者の直接的な発言と、xAI が未公開の仕様を分けて読むのが有用です。新しい投稿はモデル名とリリースカウントダウンのみを確認しており、技術パラメータやベンチマーク結果は追加していません。
| 仕様 | 現在の Grok 4.7 の状況 | 証拠レベル |
|---|---|---|
| リリース時期 | 9月2日の10日カウントダウンから推定して9月12日前後 | 創業者が示した目標 |
| モデル規模 | 約 2.1T パラメータ | 創業者による言及 |
| 初期学習 | 8月12日までに完了と説明 | 創業者による言及 |
| 補足学習 | SpaceX 企業データを相当量含む | 創業者による言及 |
| 相対的な品質 | Grok 4.6 より大幅に優れるとの主張 | 未検証の主張 |
| トークン効率 | Grok 4.6 からの改善を主張 | 未検証の主張 |
| サービング速度 | やや遅くなる見込み | 創業者による言及 |
| コンテキストウィンドウ | xAI から未公表 | 不明 |
| 入出力モダリティ | xAI から未公表 | 不明 |
| 最終的な API モデル ID | xAI ドキュメントで未確認 | 不明 |
| 公式価格 | xAI から未公表 | 不明 |
| 公式ベンチマーク | Grok 4.7 について未公表 | 不明 |
約 2.1T パラメータの主張は、稼働パラメータ、スパース性、エキスパートルーティング、推論コスト、実効学習計算量を開示していません。パラメータ数だけでは本番品質を判断できません。
なぜ SpaceX の学習シグナルが 2.1T より重要かもしれないのか
より重要な開示は、SpaceX の企業データ補足かもしれません。高品質なエンジニアリングコーパスは、技術的推論、設計、デバッグ、最適化、長期ホライズンのエージェント作業を改善し得ます。これらの領域では、タスク分布や後処理の品質が、生の規模以上に効くことが多いからです。
この方向性は xAI のリリース済みモデル戦略とも整合します。Grok 4.6 の学習レポートは、高品質なエンジニアリングデータによる長めの補足学習、その後の教師あり微調整と強化学習(コーディング、STEM、ウェブ開発、カーネル最適化、CAD を横断)を説明しています。
したがって Grok 4.7 の主張は技術的にもっともらしいが、証明はされていません。真の優位性は、リリース後に再現可能なエンジニアリングテスト、タスク完了率、レイテンシ、成功あたりコストで可視化されるはずです。
Grok 4.7 vs Grok 4.6 パフォーマンス:ベースラインが示すもの
Grok 4.7 の公式スコアはまだ存在しません。責任ある比較点は、xAI が公開した Grok 4.6 の評価です。完全なモデル概要は CometAPI の Grok 4.6 詳説を参照してください。以下の表は意思決定に最も関係の深い行のみを残しています。
| 公式評価 | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
ベースライン結果: Grok 4.6 は示したすべての行で Grok 4.5 に対して実質的な優位を示しています。総合インテリジェンス指数では GPT-5.6 Sol に匹敵し、GDPVal-AA v2 ではこのグループをリードし、FrontierCode では GPT-5.6 Sol をわずかに上回ります。公表された主なギャップは DeepSWE と Terminal-Bench に残ります。
これらの結果は Grok 4.7 に具体的な基準を設定します。もしより大きなモデルとエンジニアリング志向の補足学習が本番に転移すれば、期待されるブレークスルーは、Grok 4.6 のナレッジワークの強みを失わずに、リポジトリレベルのコーディングとターミナルタスクの完了を強化することです。信頼に足るストレッチ目標は、公開済みの Claude Fable 5.1 とコーディングや長時間エージェントワークフローで競合できることです。これは検証すべき予測であり、現時点のベンチマーク主張ではありません。
Grok 4.7 vs Grok 4.6:想定ブレークスルーとアップグレード指針
リークおよび創業者発言から、Grok 4.7 の改善候補は5つの領域に示唆されます。xAI が最終評価データを公開していないため、各期待は測定可能な受け入れテストに変換すべきです。
リポジトリレベルのコーディング
Grok 4.6 は CursorBench と FrontierCode で既に強い一方、DeepSWE と Terminal-Bench には改善の余地が見えます。Grok 4.7 は、同一リポジトリでのパッチ受理率の向上、リグレッションの減少、コマンドラインでのリカバリ改善を実証してから 4.6 の置き換えとすべきです。
長期ホライズンのエージェント信頼性
SpaceX データのシグナルと xAI の既存のエージェント学習の方向性は、多段階のエンジニアリング作業への注力を示唆します。最終的な文章品質だけでなく、完了したワークフロー、失敗したツール呼び出し、リトライ、人手介入、エラー後の回復を測定してください。
ナレッジワークと技術的推論
Grok 4.6 は GDPVal-AA v2 で比較セットをリードします。Grok 4.7 はその優位を維持しつつ、設計レビュー、リサーチ統合、デバッグ、最適化などの複雑な技術タスクへの転移を強化すべきです。
トークン効率
モデルが大きくても、より少ないステップで正解に到達できるなら、成功タスクあたりのコストはむしろ安くなり得ます。同一の受理結果に到達するために必要な総入力、キャッシュ入力、出力トークン、リトライ、コストを比較してください。
サービングのトレードオフ
もし Grok 4.7 が遅いなら、品質向上はレイテンシを上回る必要があります。TTFT(最初のトークンまでの時間)、持続スループット、タスク完了までの実時間、エラー率、現実的な同時実行下のコストを記録してください。
Grok 4.7 ベンチマーク:Grok 4.6 を実質的に上回るかを検証する5つのテスト
- ソフトウェア工学の成功: 代表的なリポジトリで、解決課題、合格テスト、リグレッション率、パッチ受理を測定。
- 長期ホライズンのエージェント信頼性: 複数ステップ実行で、完了ワークフロー、ツール呼び出し失敗、リトライ、回復、人手介入を追跡。
- 実世界のエンジニアリング転移: 設計、デバッグ、最適化、科学的推論、CAD 関連を、公開採点基準で評価。
- 成功タスクあたりのトークン効率: 同一の受理結果に到達するための総トークンと費用を比較。
- 本番負荷下のレイテンシとコスト: 現実的な同時実行で、TTFT、スループット、実時間、エラー率、コストを評価。
9月12日までに開発者がすべきこと—そして CometAPI の位置づけ
ローンチ前の開発者チェックリスト
- 実際のコーディング、リサーチ、エンジニアリング、エージェントワークフローから固定評価セットを構築。
- Grok 4.6 に対して実行し、成功率、リトライ、ツール呼び出し、レイテンシ、トークン、総コストを記録。
- モデル選択を設定可能に保ち、暫定の Grok 4.7 識別子をハードコードしない。
- xAI のリリースノートと CometAPI のモデルページで可用性を確認。
- ローンチ後、コンテキスト、モダリティ、推論コントロール、価格、レート制限、ロールアウト範囲を検証。
- 本番トラフィックを切り替える前に同じ評価セットを再実行。
CometAPI は、1つのアカウントと統一インテグレーションで複数の AI モデルプロバイダへアクセスできる統合 API レイヤーを提供します。Grok 4.7 のトラッキングページはすでに公開済みです。CometAPI は xAI がモデルを正式リリースし本番アクセスが可能になり次第、Grok 4.7 を統合します。
それまでは、プレリリースの識別子、価格、機能欄は暫定とみなしてください。本番トラフィックを送る前に、ルートがライブであること、実リクエストが成功すること、返るモデルが意図したバージョンであること、最新価格がコンソールで確認できることを検証してください。
Grok 4.7 の価格見通し(Grok 4.6 対比)
公開されている Grok 4.6 の標準料金は、長コンテキスト閾値未満のプロンプトで入力 100万トークンあたり $2、出力 100万トークンあたり $6 です。xAI のリリースノートでは 200,000 プロンプトトークン超のリクエストに対してより高い料金が掲載されています。Grok 4.7 の価格はまだ公式発表されていません。
| 公開料金の基準 | 入力 / 100万 | 出力 / 100万 | ステータス |
|---|---|---|---|
| Grok 4.6、プロンプト < 200K | $2 | $6 | 公開済み |
| Grok 4.6、プロンプト > 200K | $4 | $12 | 公開済みの長コンテキスト階層 |
| Grok 4.7 | 未発表 | 未発表 | 公式ローンチ後に確認 |
価格の方向性としては3つが妥当です。採用加速のために Grok 4.6 と同等価格、提供コストが有意に高ければプレミアム階層、あるいはコンテキスト長や速度別の料金。これらは計画上のシナリオであり、xAI の予測ではありません。
ローンチ前の開発者チェックリスト
- 実際のコーディング、リサーチ、エンジニアリング、エージェントワークフローから固定評価セットを構築。
- Grok 4.6 に対して実行し、成功率、リトライ、ツール呼び出し、レイテンシ、トークン、総コストを記録。
- モデル選択を設定可能に保ち、暫定の Grok 4.7 識別子をハードコードしない。
- xAI のリリースノートと CometAPI のモデルページで可用性を確認。
- ローンチ後、コンテキスト、モダリティ、推論コントロール、価格、レート制限、ロールアウト範囲を検証。
- 本番トラフィックを切り替える前に同じ評価セットを再実行。
Grok 4.7: 今後の注目点
次の4つの出来事が、現在のカウントダウンを検証可能な製品ローンチへと転換します。公式の xAI リリース投稿、コンテキスト・モダリティ・推論コントロールをカバーするモデルドキュメント、最終的な API 価格とモデル識別子、そして再現可能なベンチマークまたは本番評価です。
最も有用なローンチ時の問いは、「2.1T が大きく聞こえるか否か」ではありません。Grok 4.7 が、公開済みベースラインよりも難しいエンジニアリングやエージェントタスクを、より確実に、そして成功あたりのより良いコストで完了できるかどうかです。
FAQ
Grok 4.7 はいつリリースされる見込みですか?
Musk の9月2日の10日間カウントダウンから、2026年9月12日前後が目安です。これは推定された目標であり、xAI による別途公表のカレンダー日ではありません。
Grok 4.7 はすでにローンチ済みですか?
Grok 4.7 は公にティーズ/アナウンスされていますが、完全な公式 API/モデル文書のリリースはまだ受けていません。
Grok 4.7 は 2.1 兆パラメータのモデルですか?
Musk は約 2.1T パラメータと述べています。xAI は稼働パラメータやルーティング詳細を確認するアーキテクチャ文書をまだ公開していません。
Grok 4.7 は Grok 4.6 より優れますか?
Musk は大幅な改善を主張していますが、公式の Grok 4.7 ベンチマーク表は存在しません。再現可能な結果が得られるまでは未検証の主張として扱ってください。
Grok 4.7 は CometAPI 経由で利用可能になりますか?
Grok 4.7 の CometAPI トラッキングページは既に存在しますが、最終的な可用性、識別子、価格、対応フォーマットは公式ローンチ後に確認してください。
結論
Grok 4.7 のストーリーは、9月上旬という大まかな見立てから具体的なカウントダウンへと移行しました。Musk の最新発言は 2026年9月12日前後を指し、以前の投稿では約 2.1T のモデルと、SpaceX 企業データを相当量用いた補足学習が説明されています。
これらはプレリリースとしては異例に具体的ですが、モデルカード、ベンチマークスイート、API 契約ではありません。開発者は Grok 4.6 を測定可能なベースラインとして維持し、今のうちに統制された評価を準備し、移行や予算の判断を行う前に、xAI と CometAPI が本番アクセスを確認するのを待つべきです。