
TL;DR
Grok 4.7 と Xiaomi MiMo‑V2.6 は一日違いで登場したものの、フロンティア AI へのアプローチは対照的だ。Grok 4.7 はコーディングとプロフェッショナルな知識労働に向けた、プロプライエタリで密に統合されたエージェントスタックを重視する。一方、MiMo‑V2.6‑Pro はオープンウェイト、より大きなコンテキストウィンドウ、ネイティブなマルチモーダル理解、そして攻めた API 価格を兼ね備えている。
SpaceXAI は Grok 4.7 を コーディング、エージェントタスク、知識労働 向けのフロンティアモデルとして位置づけ、500K トークンのコンテキストウィンドウと設定可能な推論負荷を提供する。
Xiaomi は MiMo‑V2.6‑Pro を、オープンウェイトかつテキスト・画像・音声・動画理解に対応する 1M コンテキストのマルチモーダル・フラッグシップ として位置づけている。
要するに、Grok 4.7 は垂直統合が進んだマネージド・エージェント製品であり、MiMo‑V2.6‑Pro はより大きな開発者のデプロイ制御と、はるかに低い生トークン価格を提供する。どちらが適するかは、一つのベンチマークスコアではなくワークロードに依存する。
Key Takeaways
- Grok 4.7 は長期的なコーディングとプロフェッショナルエージェント向けに構築されている。 SpaceXAI のベンダー公開評価では、CursorBench 4.0 で 46.3%、DeepSWE v1.1 で高負荷時 71.0%、AA Briefcase v1.1 で 1,657 を記録。
- MiMo‑V2.6‑Pro はオープンモデルとして異例の競争力がある。 Xiaomi はモデルウェイトを公開し、いくつかのコーディングおよびエージェント系ベンチマークでプロプライエタリなフロンティアシステムに近い結果を報告しているが、ベンダー間のスコアは直接互換ではない。
- MiMo はコンテキストとマルチモーダルで優位。 MiMo‑V2.6‑Pro は 1M トークンのコンテキストウィンドウと、テキスト・画像・音声・動画の理解に対応するのに対し、Grok 4.7 は 500K コンテキストでテキストと画像入力に対応。
- MiMo は生 API トークンの価格が大幅に安い。 MiMo‑V2.6‑Pro の公式標準価格は未キャッシュ入力/出力それぞれ 1M トークンあたり $0.435/$0.87 に対し、Grok 4.7 は それぞれ $2/$6。
- デプロイアーキテクチャが決定的なトレードオフ。 Grok は強力なファーストパーティのホスト型ツールスタックを提供する一方、MiMo のオープンウェイトはプライベートデプロイ、独自サービング、より深いインフラ制御を可能にする。
Grok 4.7 vs MiMo‑V2.6‑Pro at a Glance
| Dimension | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Release | September 21, 2026 | September 22, 2026 |
| Access and control | プロプライエタリ API とマネージドなエージェントエコシステム | オープンウェイト、セルフホスティングオプション、API アクセス |
| Performance evidence | ベンダー報告によるコーディングと長時間エージェントタスクでの強み;同一ハーネスで検証 | ベンダー報告による推論・コーディング・マルチモーダルタスクでの強み;同一ハーネスで検証 |
| Distinctive strengths | ファーストパーティのツール、マネージドなワークフロー、Web/X 接続エージェント | デプロイ制御、1M コンテキスト、テキスト/画像/音声/動画の理解 |
| Context window | 500K tokens | 1M tokens |
| Input modalities | テキストと画像 | テキスト、画像、音声、動画 |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low 〜 xHigh | Deep reasoning |
| Open weights | No | No |
| Best fit | マネージドなコーディングおよびエージェントワークフロー | プライベートデプロイ、マルチモーダル入力、低い生トークンコスト |
What Is Grok 4.7?
SpaceXAI は Grok 4.7 を 2026 年 9 月 21 日に公式リリース し、コーディングと知識労働向けの最も高機能なモデルとして位置づけた。このローンチは、事前報道で確認済み事実とリークされたアーキテクチャの主張が混在していたため重要だ。最終的なローンチ文書では総パラメータ数やアクティブパラメータ数は公開されておらず、事前のパラメータ推定は公式仕様として扱うべきではない。
公式発表によると、Grok 4.7 は Grok 4.6 より大きい新しいベースモデル を採用し、学習では数時間を要する問題に比重を置いたより長い強化学習を実施した。
両モデルはスタックの異なる層を最適化している。Grok 4.7 はモデルの周囲により豊かなマネージド環境を提供し、MiMo‑V2.6‑Pro はモデルおよびデプロイ層を開発者により多く公開する。
200K トークンを超えるプロンプトでは、SpaceXAI は高コンテキスト価格を適用する。公開されたティアは、入力 1M トークンあたり $4、キャッシュされた入力 1M トークンあたり $1、出力 1M トークンあたり $12。
Changes in Grok 4.7
最も意味のある変化は単なるベンチマークの上昇ではなく、学習目標だ。SpaceXAI は強化学習の配合を、数時間に及ぶ長いタスクにシフトさせたと述べており、モデルは自身の作業をより注意深く検証し、Grok Bot ハーネスをネイティブに理解するよう訓練された。この組み合わせは、実運用のエージェント実行を狙うものだ。すなわち、状態維持、ツール使用、中間結果のチェック、長いタスク軌道を通じた一貫性の確保である。
Grok 4.7 Performance
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* SpaceXAI は Grok 4.7 の DeepSWE を高負荷で報告。これらはベンダー公開評価であり、文書化されたハーネスと推論設定の下で解釈すべきである。
SpaceXAI は公式発表ページ上でローンチチャートをウェブネイティブコンテンツとして提示している。上の表は、開示されたベンチマーク値を再描画せずに再現したものだ。
What Is Xiaomi MiMo‑V2.6?
Xiaomi は MiMo‑V2.6 を 2026 年 9 月 22 日に公式リリースしオープンソース化 した。ファミリーには MiMo‑V2.6‑Pro と MiMo‑V2.6‑Flash が含まれ、遅延に敏感なワークロード向けに Pro‑UltraSpeed サービングオプションがある。Grok 4.7 との直接比較では、MiMo‑V2.6‑Pro が適切なフラッグシップ対抗馬だ。
Xiaomi の公式資料は、オープンウェイト、ネイティブなマルチモーダル入力、および API 価格 を別々に文書化している。この組み合わせにより、MiMo‑V2.6 はベンチマーク順位以上の意味を持つ。
MiMo‑V2.6 vs MiMo‑V2.5: 何が改善されたのか?
アーキテクチャ上の見出しは、単にチェックポイントが大きくなったという話ではない。Xiaomi の公開リリースは、後処理学習と Live RL に大きく焦点を当てている。公式リリースノート によれば、Pro と Flash はそれぞれ 30 の強化学習ステップを完了し、合計で約 750,000 のトラジェクトリを生成した。開示された RL 段階のコストは、Pro が約 $2.62M、Flash が約 $850k であった。
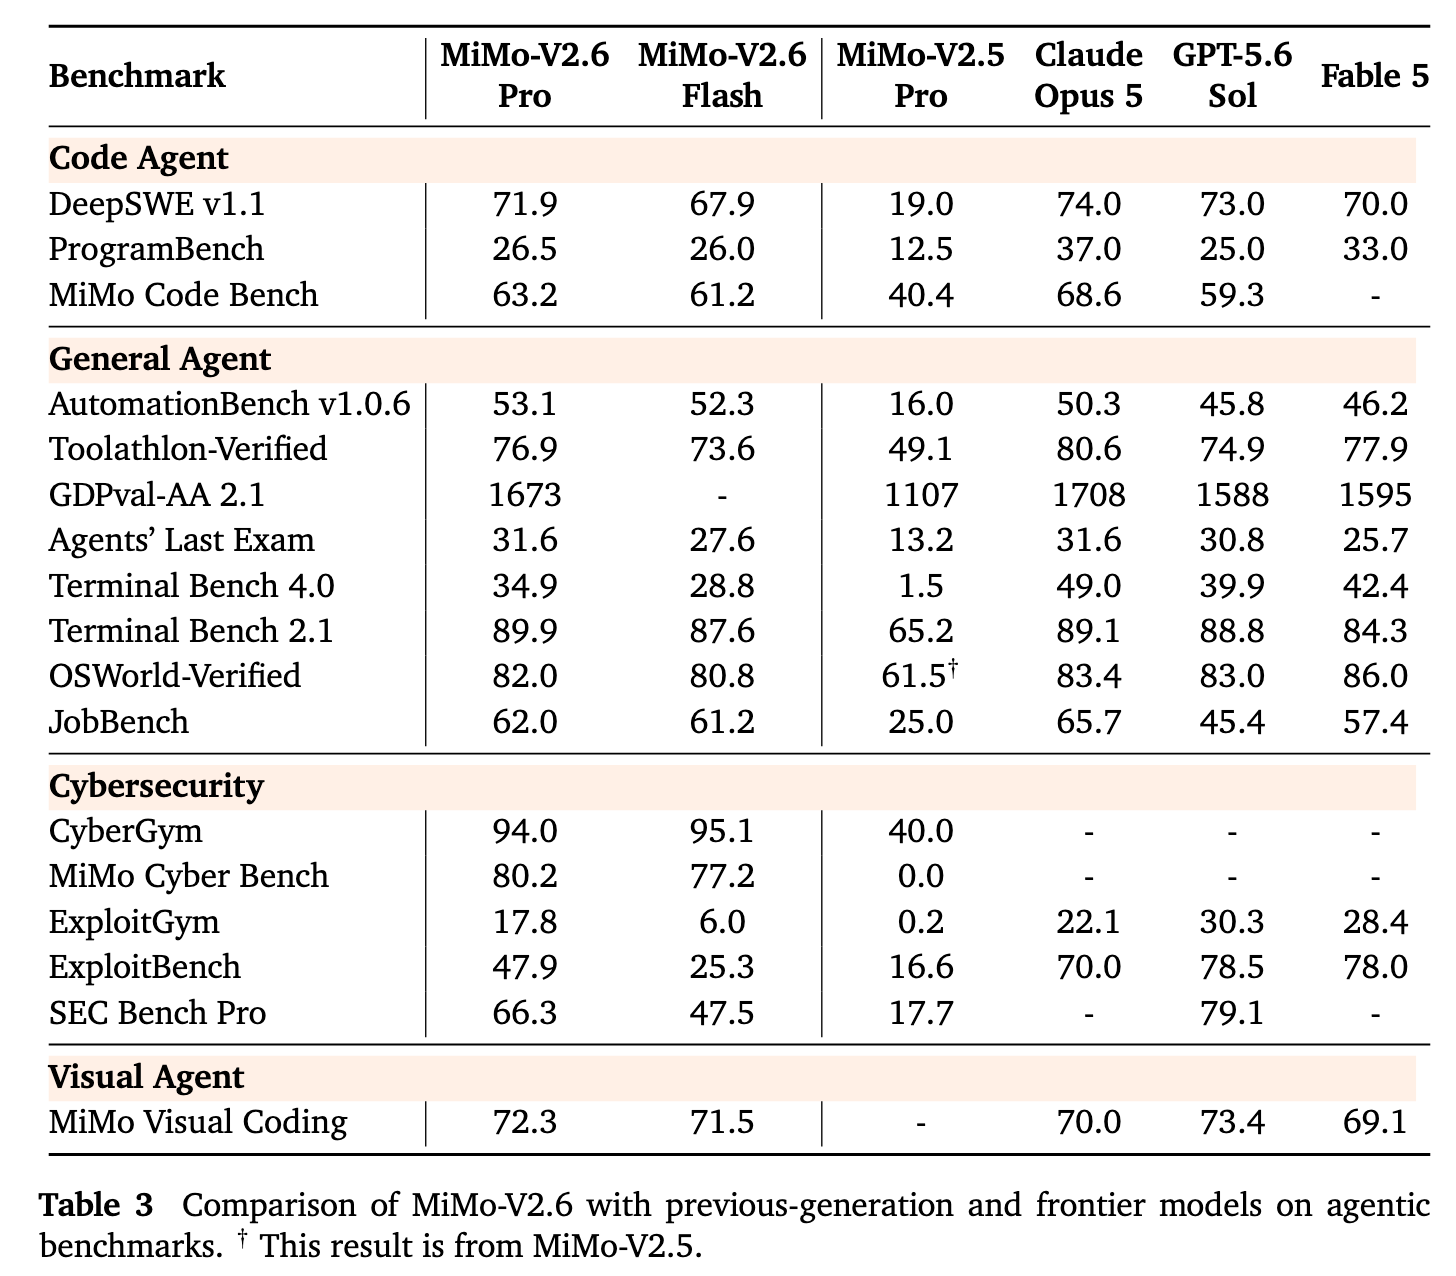
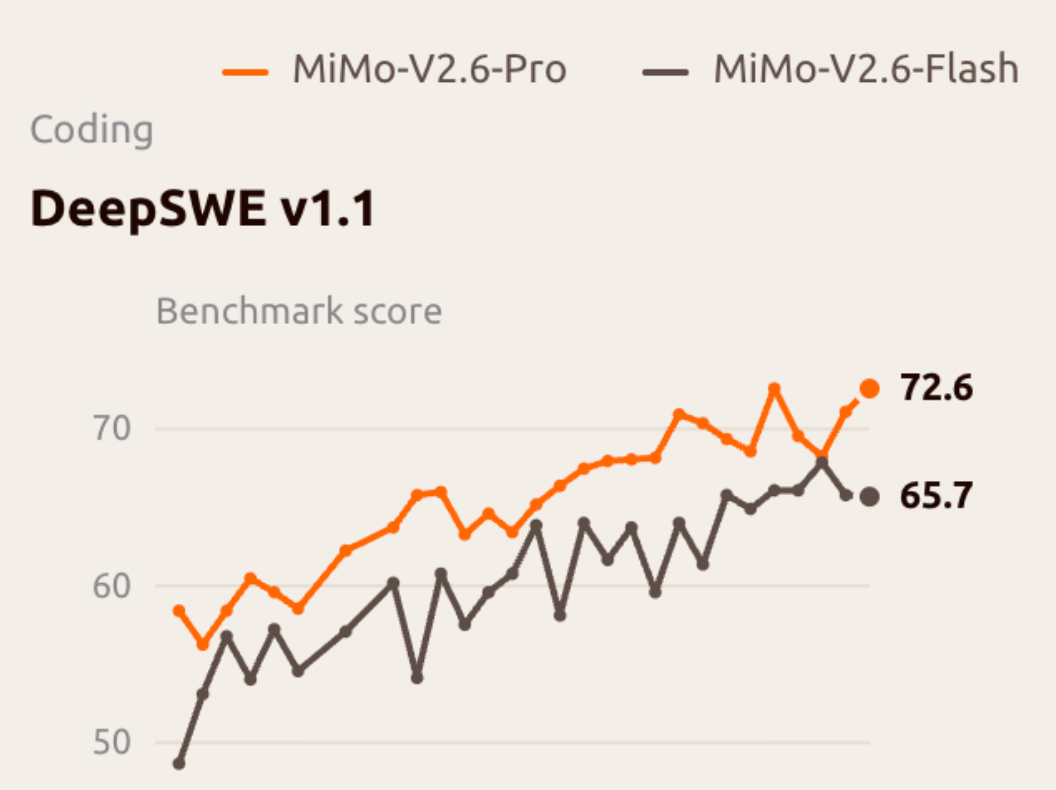
一つ注意すべきベンチマークの細部として、Xiaomi の Live RL カーブでは MiMo‑V2.6‑Pro が学習中に DeepSWE v1.1 で約 72.6 に到達している一方、最終比較表では 71.9 を報告している。これは異なる評価コンテキストを指しており、黙って統合すべきではない。
Grok 4.7 vs MiMo‑V2.6‑Pro: Benchmark Comparison
直接比較には注意が必要だ。ベンダーは必ずしも同一のハーネス、推論予算、チェックポイント、ツール構成を使用していない。ベンチマーク名が一致しても、小さなスコア差は見た目ほど意味を持たない場合がある。最も安全なのは、厳密に整合した測定を分けて、方向性の証拠と区別することだ。
Artificial Analysis Intelligence Index
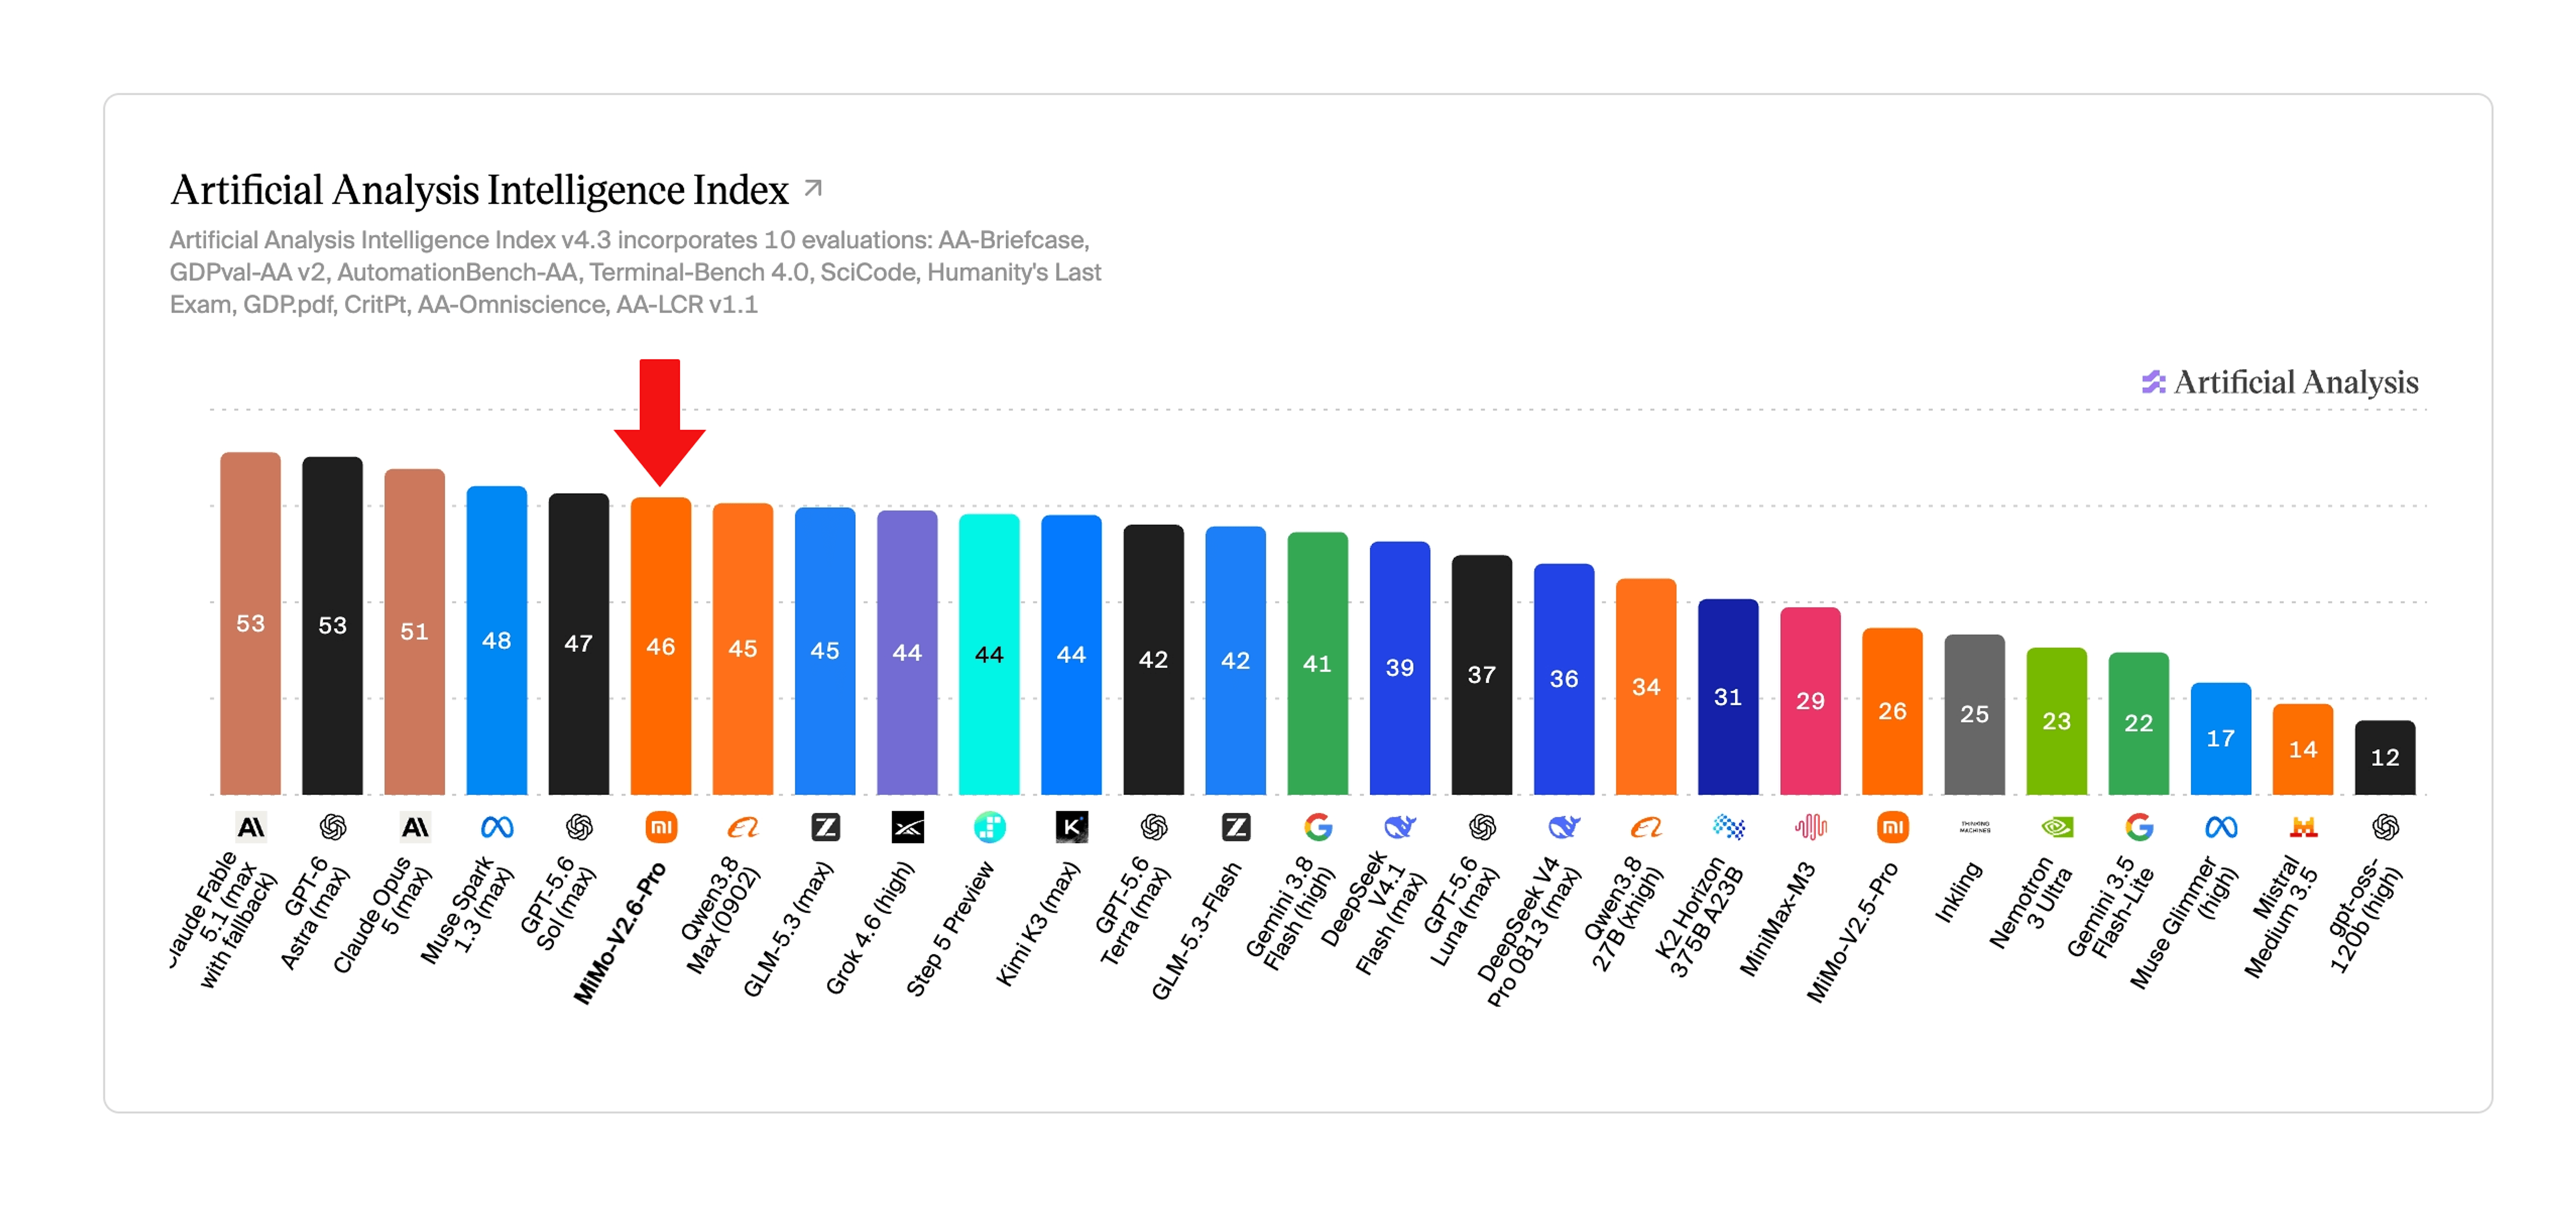
Xiaomi は MiMo‑V2.6‑Pro の Artificial Analysis 複合指数として 46.32 を報告している。Grok との比較は、使用した Artificial Analysis のスナップショットとモデル構成に厳密に結び付けるべきで、丸めた同等性主張を出すべきではない。
Coding and Agent Performance
| Benchmark | Grok 4.7 — SpaceXAI | MiMo‑V2.6‑Pro — Xiaomi | Interpretation |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | 数値は近いが、公開された実行と設定は異なる |
| GDPval-AA | SpaceXAI チャート参照 | 1,673 | ハーネスが一致しない限り方向性の参考 |
| AA Briefcase | 1,657 | Xiaomi チャート参照 | ベンダー報告値は出典コンテキストとセットで扱う |
| Terminal-Bench 4.0 | 38.0 | 34.9 | 傾向は類似;ハーネスの差が影響 |
| Context window | 500K | 1M | MiMo はより大きな作業コンテキストに対応 |
* SpaceXAI は Grok 4.7 の DeepSWE を高負荷で報告。 ** Xiaomi の最終比較表は 71.9 を報告し、Live RL 学習曲線は約 72.6 に到達。いずれも異なる評価コンテキストからの数値。
Coding Workflow Fit
コーディングにおいて、「コーディング」が生のリポジトリ問題解決を意味するのか、完全なマネージド・コーディングエージェント体験を意味するのかで区別される。DeepSWE v1.1 では、公開数値が十分近いため、1 ポイント未満の差で本番選定を決めるべきではない。
Grok 4.7 の優位はスタックの上位にある。 Grok Build に統合され、Cursor で利用でき、Grok Bot ハーネスを理解するよう設計され、ファーストパーティのコード実行・検索ツールと組み合わされている。
MiMo‑V2.6‑Pro の優位はスタックの下位にある。 オープンウェイトにより、プライベートなコーディングアシスタントの構築、サービングのカスタマイズ、データレジデンシ制御の強化、独自のエージェントハーネスでの実験が現実的になる。
両者の選択に際しては、代表的なリポジトリでの本番 A/B テストの方が、単一の公開コーディングベンチマークより有益だ。
Grok 4.7 vs MiMo‑V2.6‑Pro: Multimodal Capability Differences
ここは最も明確な差異の一つだ。Grok 4.7 はテキストと画像の入力を受け取り、テキストを生成する。より広い Grok プラットフォームは別個のメディア製品を提供しているが、それを grok-4.7 モデル自体のモダリティ表面と混同すべきではない。
MiMo‑V2.6‑Pro はテキスト、画像、音声、動画の理解に対応 している。1M トークンのコンテキストウィンドウと組み合わさることで、1 つのモデルコンテキストで処理できるワークフローの範囲が広がる。
- 同一タスクでのスクリーンショットとコードの併用解析
- 指示と併せた動画理解
- 長尺音声の処理
- 視覚フィードバックを伴うコンピュータ使用エージェント
- マルチモーダル研究アシスタント
- 大規模マルチモーダル抽出と QA
Grok 4.7 vs MiMo‑V2.6‑Pro: API Pricing Comparison
| Official API pricing | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | あり(200K プロンプトトークン超過時) | 同等の標準ティアは未公表 |
| Open-weight/self-host option | なし | あり |
名目価格では、MiMo‑V2.6‑Pro は通常の入力・生成出力の両方で数倍安価であり、とりわけキャッシュ済みコンテキストでの差が大きい。これは、リポジトリや長文書、永続コンテキストを繰り返し処理するエージェントの経済性に実質的な影響を与えうる。
Important pricing note: Grok 4.7 の 500K コンテキストウィンドウは、コンテキスト全体が標準レートで課金されることを意味しない。200K プロンプトトークンを超えるリクエストには長文コンテキストのティアが適用される。
2026 年 9 月 24 日時点で、CometAPI は Grok 4.7 を入力 $1.60、出力 $4.80/1M トークンとして掲載しており、公式の $2.00 と $6.00 に対して 20% 低い。MiMo‑V2.6‑Pro は入力 $0.348、出力 $0.696 と掲載され、公式の $0.435 と $0.87 に対して同じく 20% 低い。価格と適用条件は変動しうるため、予算化前にモデルのライブページで確認すること。
トークン単価は完了タスクあたりのコストと同一ではない。推論モデルは消費トークン量、ツールコール回数、再試行率が異なりうる。そのため本番評価では、完了タスクのコスト、レイテンシ、成功率を併せて追跡すべきだ。
Grok 4.7 vs MiMo‑V2.6‑Pro: Access and Availability
アクセスの違いは単純だ。Grok 4.7 は API とマネージドな Grok ワークフローを通じて利用可能であり、モデルウェイトはセルフホスティング向けには提供されない。MiMo‑V2.6‑Pro は API とオープンウェイトの両方で提供され、セルフホストの追加ルートがある。
可用性は、ライセンスやデプロイの柔軟性とは別問題だ。2026 年 9 月 24 日時点で、両モデルとも CometAPI のカタログページが存在する。本番投入前に、エンドポイント、リージョン、レート制限、アカウント資格を確認すること。カタログ掲載は、全アカウントで同一の可用性やサービスレベルを保証するものではない。
| Availability question | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Official API | xAI を通じて利用可能 | Xiaomi MiMo を通じて利用可能 |
| CometAPI catalog | 掲載あり | 掲載あり |
| Self-hosted weights | 提供なし | オープンウェイトあり |
| Operational check | アカウントアクセス、地域、レート制限、ツール可用性を確認 | アカウントアクセス、エンドポイント準備、セルフホスト要件を確認 |
Open Weights and Proprietary Access
MiMo‑V2.6‑Pro のオープンウェイトは、1 ポイントのベンチマーク差以上の意味を持つ。プライベートデプロイ、推論エンジンのチューニング、カスタム後処理学習、データレジデンシ制御、より深いインフラ統合といった選択肢を生むからだ。
Grok 4.7 は逆のトレードオフを取る。モデル内部の制御は少なくなる代わりに、マネージドで継続運用されるサービスと、密に統合されたファーストパーティ・エコシステムを提供する。多くの組織では、ガバナンスやインフラ要件が、ベンチマーク性能より先に候補を絞り込むだろう。
How to Use Grok 4.7 and MiMo V2.6 APIs in CometAPI
開発者は CometAPI の統一 API ワークフローを通じて Grok 4.7 API にアクセスでき、ベンダー固有の個別統合を維持する必要を減らせる。
複数のフロンティアモデルをベンチマークするチームにとって、統一 API レイヤーは特に有用だ。なぜなら、同一の本番プロンプト、テストハーネス、トークン会計、アプリケーションコードを、統合変数を減らしつつ各モデルで再実行できるからである。
CometAPI は現在 MiMo‑V2.6‑Pro を掲載しており、API 可用性は 2026 年 9 月 22 日に確認された。本番利用前に、ライブカタログとアカウントアクセスを確認すること。
両モデルページが利用可能として掲載されているため、アプリケーションレベルの A/B テストを行い、プロンプト、ツール、推論設定、成功基準を可能な限り一致させ、タスク完了、レイテンシ、トークン使用量、失敗モードを比較できる。
Grok 4.7 vs MiMo‑V2.6‑Pro: Model Fit by Use Case
| Requirement | Model fit / evaluation guidance |
|---|---|
| ファーストパーティの Web および X 検索 | Grok 4.7 |
| マネージドな長時間エージェント | Grok 4.7 |
| Grok Build / Cursor のワークフロー | Grok 4.7 |
| 1M トークンのコンテキスト | MiMo‑V2.6‑Pro |
| ネイティブな音声/動画理解 | MiMo‑V2.6‑Pro |
| オープンウェイト、セルフホスト、モデル制御 | MiMo‑V2.6‑Pro |
| 最低の生 API トークンコスト | MiMo‑V2.6‑Pro |
| リポジトリコーディング | 代表的リポジトリで両者をベンチマーク |
| プロフェッショナル知識エージェント | 本番タスクで両者をベンチマーク |
したがって、意思決定はワークロードアーキテクチャに基づくべきだ。Grok 4.7 はマネージド・エージェントスタックをより有能にするよう設計され、MiMo‑V2.6‑Pro は高性能な知性をより安価に、よりマルチモーダルに、より制御可能にするよう設計されている。
Which one should you choose?
ファーストパーティの Web と X 検索、ネイティブなコード実行、運用すべきインフラを減らしたマネージド・エージェント体験を望むなら Grok 4.7 を選ぶべきだ。統合されたツールスタックと、長時間のプロフェッショナル/コーディングワークフローを重視するチームにとって、より実用的な選択である。
MiMo‑V2.6‑Pro は、オープンウェイト、プライベートデプロイ、1M トークンのコンテキストウィンドウ、ネイティブな音声・動画理解、または大幅に低い生 API 価格が必要な場合に選ぶべきだ。デプロイ制御、マルチモーダル対応、コスト効率が主要な制約であるときに強力な選択肢である。
それでも選択が明確でない場合は、同一の代表タスクで、同一のプロンプト、ツール、推論予算、タイムアウト、再試行ポリシーを使い、両モデルを実行すること。完了率、レイテンシ、成功タスクあたりの総コスト、人的レビュー工数の最適な組み合わせを示すモデルを選定する。
Conclusion
Grok 4.7 vs MiMo V2.6 の比較が示すのは、もはや生の知性だけが意味のある差異ではないということだ。両モデルは現在の公開評価で同様の高能力帯に位置する一方で、製品戦略は大きく分岐している。
Grok 4.7 は 500K のコンテキストウィンドウ、設定可能な推論、長期エージェント訓練の強化、成熟したファーストパーティ検索・実行スタックを組み合わせている。MiMo‑V2.6‑Pro は 1M コンテキスト、ネイティブなマルチモーダル入力、オープンウェイト、そして多くのプロプライエタリ・フロンティアシステムを大きく下回る API 価格を組み合わせている。
開発者にとって実務的な問いは「どちらのベンチマークが高いか?」ではなく「知性をどこに置くべきか?」だ。マネージドなエージェントエコシステムと、オープンでカスタマイズ可能なモデルスタックは、異なる運用上の課題を解く。適切な選択は、本番ワークロード、インフラ制約、コストモデルに最も適合する方である。
FAQs
Grok 4.7 は 2.1 兆パラメータモデルなのか?
リリース前に約 2.1T の数字が流布したが、最終的な SpaceXAI の Grok 4.7 ドキュメントは総パラメータ数やアクティブパラメータ数を公開していない。確かな記述は、Grok 4.7 が Grok 4.6 より大きいベースモデルを使用しているという点である。
MiMo‑V2.6 はオープンソースなのか?
Xiaomi は MiMo‑V2.6 を、ダウンロード可能なウェイトと関連研究リソースを備えたオープンモデルファミリとしてリリースした。本番計画では、意図する利用に対する正確なモデルライセンスと再配布条件を必ず確認すべきだ。
Grok 4.7 と MiMo‑V2.6‑Pro のエージェンタスク完了あたりのコストは?
タスクセット、プロンプト、ツール権限、再試行ポリシー、成功基準を正規化する。総入力、キャッシュ入力、推論・出力トークン、ツールコール、レイテンシ、再試行、人的レビュー時間を追跡する。生トークン価格は完了タスクコストの一要素に過ぎない。
Grok 4.7 と MiMo‑V2.6‑Pro のベンチマーク比較はどれほど信頼できる?
同一のリポジトリまたはタスクセット、エージェントハーネス、ツール、推論予算、タイムアウト、再試行ポリシー、採点ルーブリックを使用する。信頼区間や反復実行による変動を報告し、ベンダー公開数値と社内結果は分けて扱う。
Grok 4.7 は長文コンテキストのプロンプトで高い料金を請求するのか?
SpaceXAI は、プロンプトトークンが 200K を超えると高いレートが適用されると文書化している。高いティアはリクエスト全体に適用されるため、大きなリポジトリや永続エージェントコンテキストを使用するチームは、この閾値を明示的にモデル化すべきだ。