
TL;DR
DeepSeek-V4.1-Flash はオープンウェイトでセルフホスト可能だが、「ローカル」は「ゲーミング PC 上」を意味しない。DeepSeek はこれを Causal Encoder-Decoder アーキテクチャを用いる 552B パラメータの Mixture-of-Experts バックボーン と説明しており、プロンプト処理中は 8B、生成時は 16B のパラメータのみがアクティブになる。一方でフルモデルは依然としてフロンティア規模のデプロイ対象である。
現在の vLLM デプロイ手順では、チェックポイントはディスク上で約 511 GB、最小 VRAM は約 614 GB とされており、8×H200 クラスのサーバーや同等の大容量メモリシステムが、コンシューマ向けワークステーションよりはるかに現実的である。
ウェイトレベルでの制御が不要でアクセスのみが必要なチームには、CometAPI の DeepSeek V4.1 Flash API の方が、マルチ GPU 推論サーバーを維持するよりもはるかに簡単である。
Key Takeaways
- DeepSeek-V4.1-Flash は 552B の MoE バックボーンを持ち、プレフィル時に 8B、デコード時に 16B のアクティブパラメータを使用するが、アクティブパラメータ数は常駐メモリ要件を意味しない。
- 1,048,576 トークンのコンテキストと 1 トークンあたり 890 バイトのグローバル KV キャッシュによりキャッシュ圧力は低下するが、容量計画では依然としてモデルウェイトが支配的である。
- 公式チェックポイントはディスク上で約 511 GB。vLLM のレシピでは、モデルのロードとランタイムのオーバーヘッドに対して、集計で約 614 GB の使用可能 VRAM を最小予算として見積もっている。これはベースラインの推定であり、すべてのバッチサイズ、コンテキスト長、マルチモーダル構成での保証ではない。
- vLLM は最も明確な本番サービング経路であり、SGLang は高度な分散推論を対象としている。Ollama の現行ルートは完全なローカル推論ではなくクラウドホストである。
- セルフホスティングの最大の魅力は、プライバシー、エアギャップ運用、ウェイトレベルの研究、または継続的なクラスター活用にある。多くの開発者にとってはホスト型 API の方が簡単である。
What Is DeepSeek-V4.1-Flash? Architecture, Parameters, and Model Size
DeepSeek は 2026 年 9 月 10 日に V4.1-Flash を正式リリースした。これは新アーキテクチャファミリーの中で最小モデルであり、ネイティブな視覚理解を備える。「Flash」という名称にもかかわらず、小さな密モデルではない。
主なアーキテクチャ変更は Causal Encoder-Decoder (CED) 設計 である。モデルはプロンプト取り込みとトークン生成の計算を非対称に分割し、非常に大きなエキスパートプールを維持しながらアクティブ計算量を削減する。
| Specification | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | マルチモーダル MoE(Causal Encoder-Decoder) |
| Backbone parameters | 552B |
| Active parameters, input | 8B |
| Active parameters, output | 16B |
| Transformer layers | 40(エンコーダ 20 + デコーダ 20) |
| Context window | 1,048,576 トークン |
| Global KV cache | 890 バイト/トークン |
| Modalities | テキスト + 画像入力、テキスト出力 |
| Weight license | MIT |
| Recommended sampling | 温度 1.0;top_p 0.95 または 1.0 |
| Official weights | Hugging Face |
| Primary local serving options | vLLM、SGLang、DeepSeek リファレンス推論 |
アクティブパラメータと常駐パラメータの区別は重要である。MoE のルーティングはトークンごとの計算量を減らすが、サーバーは選択されうるエキスパートのウェイトに引き続きアクセスする必要がある。そのため、「8B アクティブ」のモデルでも、数百 GB のストレージとアクセラレータメモリを必要としうる。
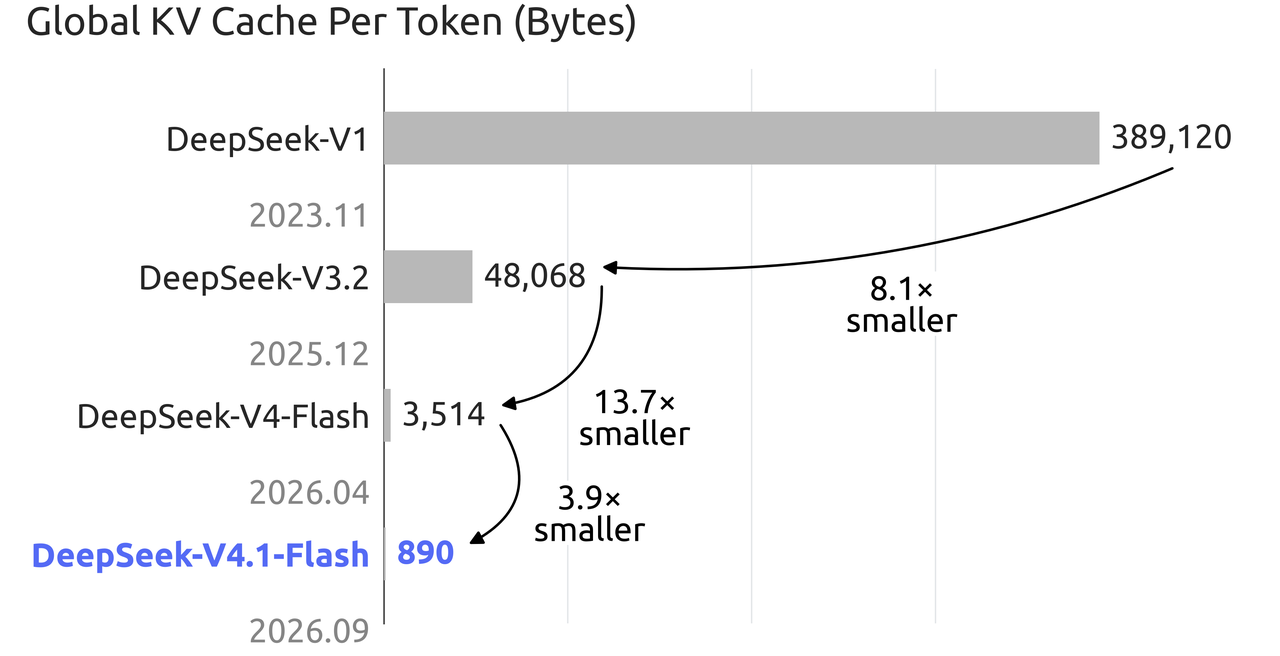
DeepSeek の公式 KV キャッシュチャートでは、グローバルキャッシュが V4 Flash の 1 トークンあたり 3,514 バイトから V4.1 Flash の 890 バイトへと約 3.9 倍削減されている。これは 100 万トークン推論に有意だが、モデルウェイトが生むはるかに大きなメモリ要件を解消するものではない。
How Good Is DeepSeek-V4.1-Flash Before You Deploy It?
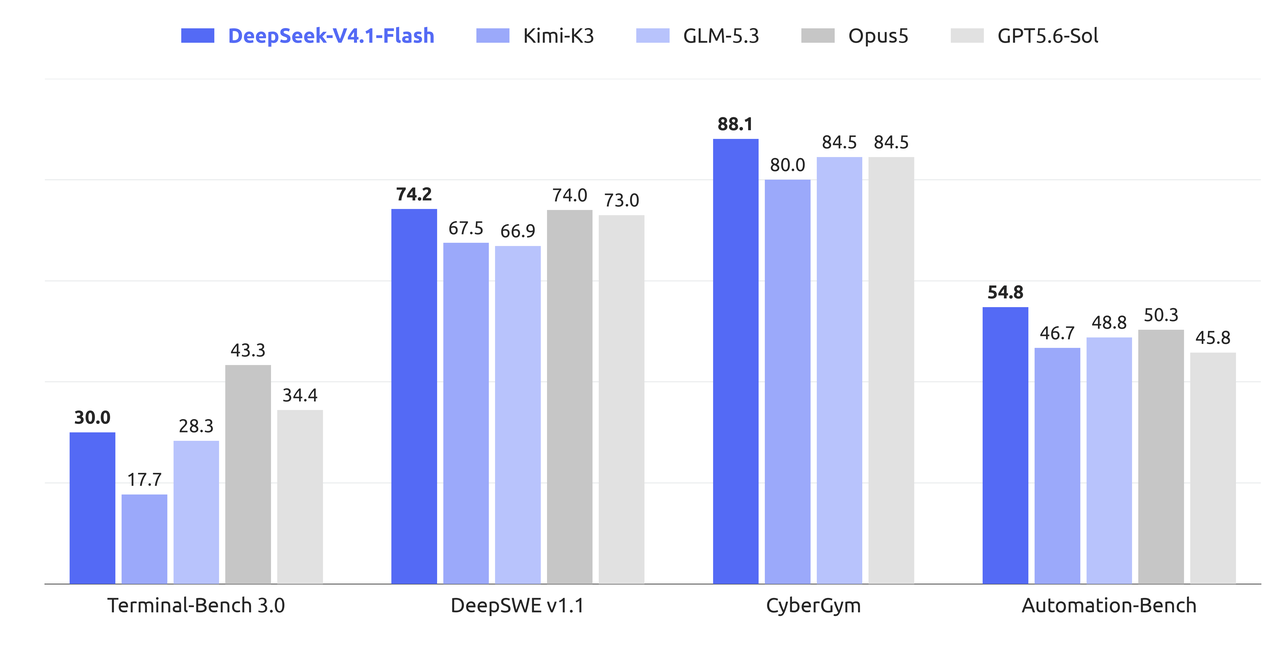
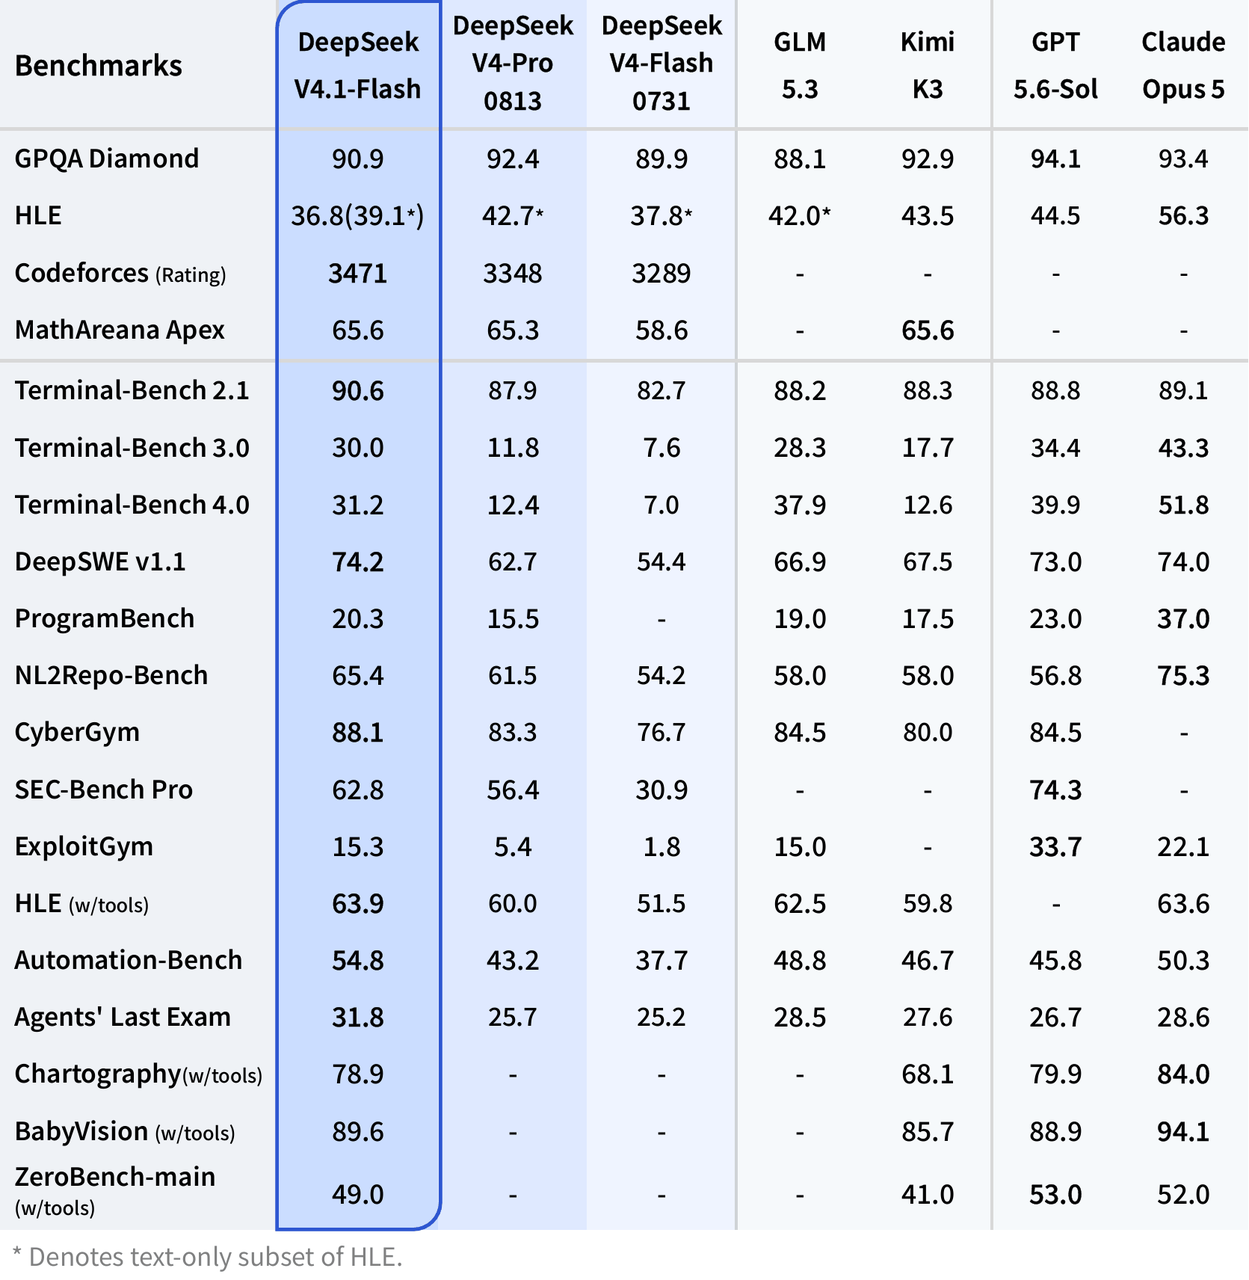
DeepSeek 公開のベンチマーク表では、V4.1-Flash は主にエージェント型コーディング、ターミナル操作、オートメーション、ソフトウェア工学ワークロードでの大幅な強化として位置づけられている。これらは ベンダー報告のベンチマーク結果 であり、アプリケーション性能の保証ではなく参考値として扱うべきである。
再現性のため、公式モデルカードでは温度 1.0、top_p 0.95 を推奨し、reasoning effort とトークン予算は評価によって異なる。以下の数値はベンダーによる参考結果であり、ハードウェアに依存しない性能保証ではない。再現の際は、ベンチマーク固有のハーネス詳細を確認すること。
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
重要なのは個々のスコアではなくパターンである。V4.1-Flash はすべてのベンチマークで首位ではないが、V4 Flash 0731 からのジャンプは Terminal-Bench、DeepSWE、オートメーション、サイバーセキュリティのワークロードで特に大きい。これは、プライベートなコーディングエージェント、リポジトリ規模の分析、内部オートメーション、エアギャップなエージェント基盤においてローカルデプロイの意義を高める。
Can You Really Run DeepSeek-V4.1-Flash Locally?
可能だが、「ローカル」という言葉には注釈が必要である。最新の vLLM DeepSeek-V4.1-Flash レシピでは、チェックポイントは約半テラバイトであり、ランタイムのオーバーヘッドを含めると、はるかに大きな VRAM 予算が推奨されている。
| Component | Approximate stored size |
|---|---|
| Routed + DSpark experts | 259.5 GiB |
| Engram tables | 183.1 GiB |
| Attention, dense projections and routers | 6.9 GiB |
| Embeddings, LM head and norms | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| Full checkpoint | ~476 GiB / ~511 GB |
| vLLM recommended minimum VRAM budget | ~614 GB |
重要な驚きは、V4.1-Flash が内部的にすでに強く圧縮されている点である。ルーティッドエキスパートのウェイトは低精度フォーマットを使用しており、公式チェックポイントは「大きな BF16 モデルを容易に 4bit 変換するだけ」の対象ではない。
DeepSeek-V4.1-Flash Hardware Requirements
| Hardware configuration | Practical status | Comments |
|---|---|---|
| 1× RTX 4090 / 5090 | No | モデルのメモリフットプリントに対して大幅に不足 |
| 2–4 consumer GPUs | No for the official full checkpoint | 集計 VRAM が引き続き不足 |
| 128 GB workstation | No | アクティブパラメータは常駐ウェイトメモリを決定しない |
| 256 GB workstation | No for official serving path | 公式チェックポイントのフットプリントに対して依然として不足 |
| 512 GB system RAM + GPU offload | Experimental | コミュニティ/オフロード領域であり、検証済みの本番サービングと同等ではない |
| 4× high-memory datacenter GPUs | Hardware-dependent | 十分に大きな最新アクセラレータであれば可能。ランタイムレシピを確認 |
| 8× H200 | Yes, documented class | 集計で約 1,128 GB の HBM |
| GB200 NVL4-class system | Yes | vLLM は 768 GB トレイがモデルに適合すると言及 |
重要: 8B のアクティブパラメータは 8 GB の VRAM を意味しない。「アクティブ」は、1 トークンの計算に参加する MoE ネットワークの規模を表す。完全なエキスパート集合は推論エンジンからアクセス可能な場所に格納しておく必要がある。
Which Runtime Should You Use for DeepSeek-V4.1-Flash?
| Runtime | Current V4.1-Flash status | Best use |
|---|---|---|
| vLLM | 現行デプロイレシピあり。最新のイメージが必要 | OpenAI 互換の本番サービング |
| SGLang | 現行 DeepSeek-V4.1 デプロイビルドで対応 | 高性能な分散推論 |
| DeepSeek reference inference | 公式 TP8 リファレンス実装 | アーキテクチャ研究と検証 |
| Transformers | Hugging Face 上でモデル統合が公開 | 開発と実験(ただしハードウェアは依然として必要) |
| Ollama | 公式ライブラリエントリは現在 :cloud を使用 | 手軽なクラウド呼び出し。セルフホスティングと同等ではない |
本番環境でのセルフホスティングには、現時点では vLLM が最も明確な出発点である。SGLang のデプロイガイダンス は、高度な分散推論に対応する別のサポートルートを提供する。
How to Run DeepSeek-V4.1-Flash Locally with vLLM
これはマルチ GPU の Linux サーバー向けの実用的なルートである。
以下のコマンド例は、言語別コードブロックとして再整形され、簡潔な英語の説明を伴う。
Step 1: Check Your Environment
- Linux。
- Docker。
- NVIDIA Container Toolkit。
- 数百 GB の空き SSD 領域。
- サポートされたマルチ GPU 構成。
- 現行の公式ウェイトサービングプロファイルに対して、集計で約 614 GB の使用可能アクセラレータメモリ。
- モデルがローカルにキャッシュされていない場合は高速ネットワーク。
Step 2: Download the DeepSeek-V4.1-Flash Weights
公式ウェイトは MIT ライセンスで DeepSeek-V4.1-Flash の Hugging Face リポジトリにホストされている。
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
~/.cache/huggingface を保持するファイルシステムに、511 GB を大きく超える空きがあることを確認する。一時ファイルや追加のエンジンアーティファクトにより、ピーク時のディスク使用量が増える場合がある。
Step 3: Start DeepSeek-V4.1-Flash with vLLM
現行の vLLM レシピでは、DeepSeek-V4.1 のサポートに十分新しい vLLM イメージが必要である。テキストのみ・8 GPU の開始構成例は以下のとおり。
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
ここには 2 つの意図的な選択がある。第一に、--language-model-only はテキスト専用ワークロードのためにビジョンエンコーダを無効化する。第二に、いきなり 100 万トークンのコンテキストを有効にするのではなく、131,072 トークンから開始する方が安全である。サーバーが安定したら、以下のように増やせる。
--max-model-len 1048576
適切な tensor-parallel 設定はアクセラレータのトポロジに依存するため、--tensor-parallel-size 8 をすべてのサーバーにそのまま適用しないこと。
Step 4: Test the Local DeepSeek-V4.1-Flash Endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Step 5: Call Your Local DeepSeek-V4.1-Flash Server with Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
How Do You Enable DeepSeek-V4.1-Flash Thinking Mode Locally?
V4.1-Flash はチャットテンプレートを通じて明示的な推論制御をサポートする。例:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
小さな max_tokens で最終コンテンツがほとんど返らない、または全く返らない場合、thinking モードが生成予算を消費している可能性がある。デプロイが壊れていると決めつける前に、max_tokens を増やす、reasoning effort を下げる、または単純なリクエストでは thinking を無効化すること。
How Do You Run DeepSeek-V4.1-Flash with Reference Code?
DeepSeek はモデルリポジトリ内に 最小の TP8 推論実装 も含めている。これは高スループットの本番サーバーというより、可読性の高いリファレンスコードを意図している。
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
このルートは、CED、MoE ルーティング、Engram メモリ、スペキュレイティブデコーディング、および関連する実装詳細を検査するのに有用である。通常の本番サービングには vLLM または SGLang の方が運用しやすい。
Can You Run DeepSeek-V4.1-Flash Locally with Ollama?
通常の 7B や 32B の Ollama モデルを実行するのと同じ意味ではない。Ollama は現在 V4.1-Flash を以下のように公開している:
ollama run deepseek-v4.1-flash:cloud
重要なのは :cloud である。現行の Ollama ライブラリエントリ はクラウドルートを使用しており、このコマンドは完全なモデルをダウンロードして、完全に自分のマシン上で推論を行うことと同等ではない。
DeepSeek-V4.1-Flash Local Deployment vs API: Which Makes More Sense?
| Dimension | Local DeepSeek-V4.1-Flash | Hosted API |
|---|---|---|
| Up-front hardware | 非常に高い | なし |
| Accelerator memory | 実用上の公式ターゲットは約 614 GB | プロバイダが管理 |
| Model control | フル | 限定的 |
| Data stays on premises | はい | いいえ |
| Weight modification | はい | いいえ |
| Maintenance | 自分の責任 | プロバイダ管理 |
| Setup complexity | 高い | 低い |
| Scaling | インフラが必要 | API ベース |
| Best for | エアギャップ、プライバシー、研究、高稼働率クラスター | ほとんどの開発者と本番アプリ |
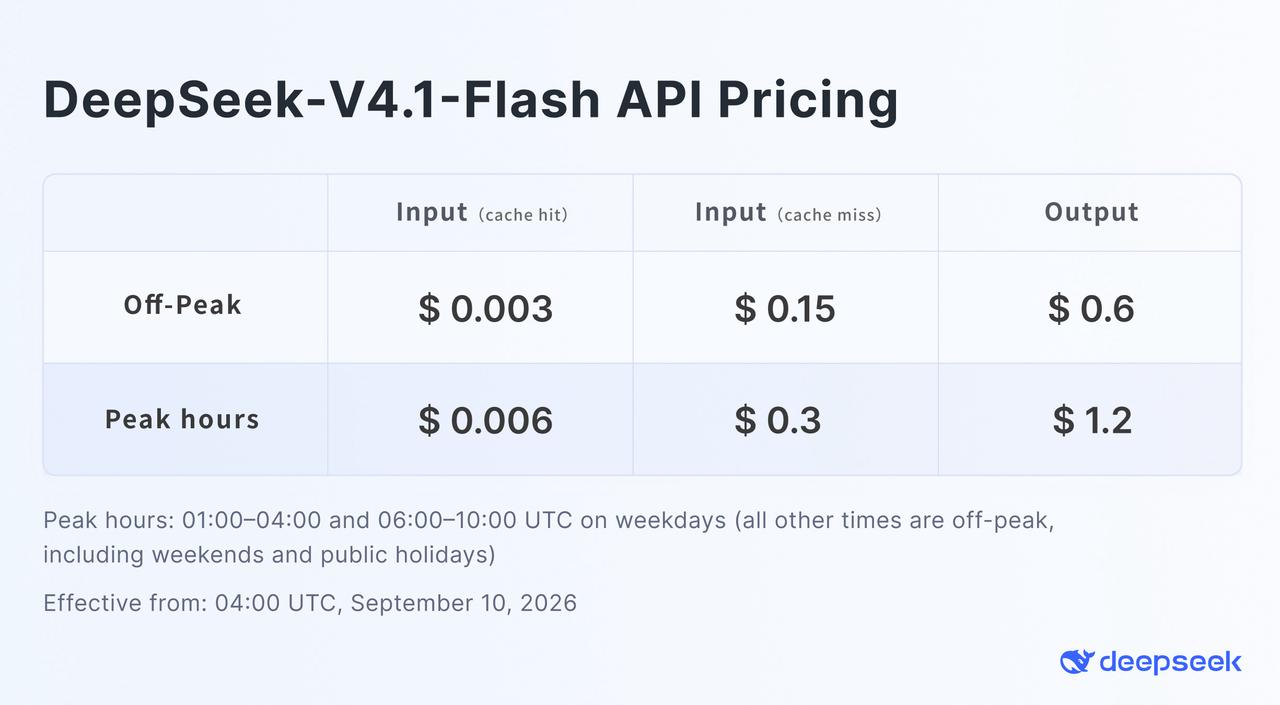
DeepSeek のオフピーク価格は V4.1-Flash の価格グラフィックに示されている。ウェイトの物理的保有が不要な開発者にとっては、CometAPI の DeepSeek V4.1 Flash API が、他の AI モデルと同様に OpenAI 互換の代替手段を提供する。
以下の例は CometAPI のモデル識別子を使用する。これは DeepSeek 公式 API の識別子ではない。
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
実務的な判断は明快である。プライバシー、エアギャップ運用、ウェイトレベルの実験、予測可能な高負荷利用、または規制要件がインフラコストを上回る場合にローカルデプロイは魅力的になる。通常のアプリケーション開発では、ホスト型エンドポイントによって、数百 GB のモデル管理やマルチ GPU オーケストレーションを回避できる。
What Problems Can You Encounter When Running DeepSeek-V4.1-Flash Locally?
生成が始まる前にサーバーがメモリ不足になる
メモリ要件の大部分は 8B/16B のアクティブパラメータ数ではなくフルチェックポイントで決まる。tensor parallelism、GPU メモリ利用率、ビジョンの読み込み、利用可能な HBM を確認すること。
DeepSeek-V4.1-Flash の起動に時間がかかる
半テラバイト規模のチェックポイントは、ダウンロード、マッピング、初期化、シャーディングに時間を要する。このクラスのモデルでは、エンジン準備のタイムアウトが長いのは正常である。
応答が空か、finish_reason=length で終了する
thinking モードが生成予算を消費している可能性がある。max_tokens を増やす、reasoning effort を下げる、または単純なリクエストでは thinking を無効にする。
ツール呼び出しが正しくパースされない
サーバーが DeepSeek V4.1 の tokenizer、tool-call parser、reasoning parser、および auto-tool-choice フラグを使用していることを確認する。
ビジョン入力が機能しない
--language-model-only で起動した場合、ビジョンエンコーダを意図的に無効にしている。画像をテストする前に、マルチモーダル対応を有効にして再起動すること。
Should You Run DeepSeek-V4.1-Flash Locally?
DeepSeek-V4.1-Flash は、セルフホスティングの観点から非常に興味深い。というのも、アーキテクチャがトークンあたりの計算量と KV キャッシュコストを大幅に削減する一方で、フロンティア規模のオープンウェイトモデルをデスクトップモデルへと変えるわけではないからである。
研究ラボ、エンタープライズ AI プラットフォーム、プライベートなコーディングエージェント群、またはエアギャップ環境では、vLLM と SGLang によりセルフホスティングが技術的に現実的になる。一方、1~2 枚の GPU を持つ開発者にとっては、完全なモデルのデプロイ対象としては現実的ではない。その場合は、CometAPI を通じた DeepSeek V4.1 Flash を利用することで、巨大なサービングインフラを抱え込むことなくモデルへアクセスできる。
FAQ
Is DeepSeek-V4.1-Flash open source?
モデルウェイトとリポジトリは MIT ライセンスでリリースされており、ライセンス条件の下で広範な使用、改変、再配布が可能である。
Can I run DeepSeek-V4.1-Flash on an RTX 4090 or RTX 5090?
公式のフルモデルは不可。単一のコンシューマ GPU はフルチェックポイントに必要なメモリのごく一部しか持たない。
Does 8B active parameters mean DeepSeek-V4.1-Flash only needs 8 GB of VRAM?
いいえ。8B はプロンプト処理中に参加するパラメータ数を示す。完全なエキスパートネットワークと補助状態は依然として格納・アクセス可能である必要がある。
How much VRAM does DeepSeek-V4.1-Flash need?
現行の vLLM レシピでは、公式チェックポイントとランタイムオーバーヘッドに対する計画値として約 614 GB を用いている。実際の必要量は、ハードウェア、バッチサイズ、コンテキスト、ビジョンサポート、サービング構成によって変動する。
How large is DeepSeek-V4.1-Flash on disk?
現行の vLLM ブレークダウンでは、チェックポイントはおよそ 476 GiB、約 511 GB とされている。
Can DeepSeek-V4.1-Flash run a 1M-token context locally?
アーキテクチャは最大 1,048,576 トークンをサポートするが、実用上のメモリ使用はバッチサイズ、ランタイムバッファ、ビジョン状態、その他のオーバーヘッドにも依存する。
Can I run DeepSeek-V4.1-Flash locally with Ollama?
現行の Ollama エントリは :cloud ルートを使用しており、完全なウェイトを完全に自機上で実行することと同じではない。
Is vLLM or SGLang better for DeepSeek-V4.1-Flash?
いずれも高性能サービングを目指す。vLLM には特に詳細な V4.1 向けレシピがあり、SGLang も高度な分散デプロイに適している。
What is the easiest way to use DeepSeek-V4.1-Flash without local hardware?
ホスト型 API を使用する。DeepSeek 自身の API があり、CometAPI でも他の AI モデルと並んで OpenAI 互換の DeepSeek-V4.1-Flash エンドポイントが提供されている。