Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
new / CometAPIリサーチ
Mistral Small 4 をローカルで実行する方法 Mistral Small 4 は、Mistral AI によって新たにリリースされたオープンウェイトのマルチモーダルAIモデル(2026年3月)で、推論・コーディング・ビジョンの機能を単一アーキテクチャに統合しています。Ollama、vLLM、または llama.cpp(量子化版)などのフレームワークを用いてローカルにデプロイでき、GPU(VRAM 24GB以上を推奨)または量子化を用いたハイエンドCPUを必要とします。主要な利点は、推論コストとレイテンシを大幅に抑えつつ高い性能を発揮できることで、オンデバイスAIアプリケーションに最適です。
Mistral Small 4 は、Mistral AI によって新たにリリースされたオープンウェイトのマルチモーダルAIモデル(2026年3月)で、推論・コーディング・ビジョンの機能を単一アーキテクチャに統合しています。Ollama、vLLM、または llama.cpp(量子化版)などのフレームワークを用いてローカルにデプロイでき、GPU(VRAM 24GB以上を推奨)または量子化を用いたハイエンドCPUを必要とします。主要な利点は、推論コストとレイテンシを大幅に抑えつつ高い性能を発揮できることで、オンデバイスAIアプリケーションに最適です。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)Mistral Small 4 は、Mistral AI が 2026年3月に新たにリリースしたマルチモーダルAIモデルで、推論、思考、コーディング、マルチモーダル機能 を単一アーキテクチャに統合しています。256Kのコンテキストウィンドウ、Mixture-of-Experts(MoE)設計( ~119B 総パラメータ、トークンあたり ~6.5B がアクティブ)**を備え、ベンチマークでは GPT-OSS 120B のような同等のオープンモデルを上回りつつ、**より高速な推論(最大 40% のレイテンシ削減)**を実現します。
ローカルで実行するには、大容量メモリGPU(推奨:48GB以上のVRAM)または 量子化デプロイ に加え、Transformers、vLLM、Ollama などのフレームワークが必要です。
Mistral Small 4 とは?
複数の仕事をこなす単一モデル
Mistral Small 4 は「万能型」と考えるのが最もわかりやすいでしょう。Mistral の従来の instruction、reasoning、coding 系列の強みを 1 つのモデルに統合しています。同社のリリース表現を使えば、Small 4 は
明確性、出典の帰属、最新のAPI用語について確認済みです。
推論向けの Magistral
マルチモーダル向けの Pixtral
エージェント的コーディング向けの Devstral
テキストと画像の入力
このリリースが重要な理由 実務上の大きな意味は、Mistral Small 4 がモデル切り替えのオーバーヘッドを減らすことです。高速な instruct モデルに 1 つ目のプロンプトを送り、reasoning モデルに 2 つ目のプロンプトを送り、vision モデルに 3 つ目のプロンプトを送る代わりに、単一のエンドポイントを使い、必要に応じて reasoning_effortreasoning_effort="none"reasoning_effort="high"
Mistral Small 4 の性能ベンチマーク
主な性能ハイライト Architecture MoE Context Window 256K Latency ↓ 最大 40% Coding Benchmarks GPT-OSS 120B を上回る Output Efficiency トークン数 20% 削減
👉 これにより、本番運用レベルのAIシステム に最適です。
アーキテクチャ(主要な技術的ポイント)
モデルタイプ: Mixture-of-Experts(MoE)総パラメータ数: ~119Bトークンあたりのアクティブパラメータ数: ~6.5Bエキスパート数: ~128(各フォワードパスで 4 つがアクティブ) 👉 このアーキテクチャにより、小規模モデルのコストで大規模モデル級の知能 が実現でき、高密度モデルと比べてローカルデプロイに適しています。
Mistral Small 4 を導入する際に計画すべき要件
公式の最小構成と推奨インフラ Mistral はここをかなり明確に示しています。最小構成は NVIDIA HGX H100 x4、NVIDIA HGX H200 x2、または NVIDIA DGX B200 x1 です。最適性能のための推奨構成は HGX H100 x4、HGX H200 x4、または DGX B200 x2 です。これは、完全に公式な運用パスが、単一のコンシューマGPUではなくデータセンター級マシンを想定していることを強く示しています。
実際にはどういう意味か Mistral Small 4 は open-weight で、その規模のわりに効率的ですが、それでも 256k コンテキストウィンドウを持つ 119B の MoE システムです。実運用では、この組み合わせによりコンテキスト長が伸びるほどメモリ負荷が急速に高まり、持続的な性能は通常マルチGPUのテンソル並列化と効率的なサービングソフトウェアに依存します。だからこそ、主要なセルフデプロイエンジンとして vLLM を推奨し、単一マシンで「そのまま動く」前提よりも、OpenAI互換のサービングパターンを提供しているのです。
推奨セットアップ(プロ向け) GPU 48GB–80GB VRAM(A100 / H100) CPU 16–32 コア RAM 128GB Storage NVMe SSD
ハードウェアが重要な理由
119B パラメータモデル(MoE であっても)
大きなコンテキスト(256K トークン)
マルチモーダル処理
👉 最適化なしでは、コンシューマGPUには重すぎます
Mistral Small 4 をローカルで実行する方法(ステップごと)
ステップ 1)重みを取得し、アクセス条件に同意する vLLM はデフォルトで Hugging Face から重みを取得するため、READ 権限付きの Hugging Face アクセストークン が必要であり、モデルカード上の条件に同意しなければなりません。実用的なローカルセットアップとして、NVIDIA ドライバ、CUDA 対応ランタイム、Python、および選択したチェックポイントに十分なGPUメモリを備えた Linux マシンを準備してください。すでに自分のストレージ上にアーティファクトを持っている場合は、Hugging Face の設定をスキップして、代わりに vLLM にローカルパスを指定できます。
ステップ 2)公式推奨のサーバースタックを使う セルフデプロイには vLLM を推奨しており、これは OpenAI互換API を公開できる高度に最適化されたサービングフレームワークと説明されています。セルフデプロイ用ドキュメントでは TensorRT-LLM や TGI も代替として言及されていますが、このモデルファミリーにおける推奨パスは vLLM です。
ステップ 3)Mistral 推奨の Docker イメージを取得するか、vLLM を手動でインストールする Mistral Small 4 では、必要なツールコールおよび reasoning 解析の修正を含むカスタム Docker イメージ、またはパッチ適用済みの vLLM ビルドを手動でインストールすることが推奨されています。モデルカードではカスタムイメージが提供されており、Mistral が vLLM チームと協力して変更を upstream に取り込んでいることも記載されています。
docker pull mistralllm/vllm-ms4:latestdocker run -it mistralllm/vllm-ms4:latest
ステップ 4)モデルをサーブする Mistral 推奨のサーバーコマンドは以下です:
vllm serve mistralai/Mistral-Small-4-119B-2603-NVFP4 \ --max-model-len 262144 \ --tensor-parallel-size 2 \ --attention-backend TRITON_MLA \ --tool-call-parser mistral \ --enable-auto-tool-choice \ --reasoning-parser mistral \ --max_num_batched_tokens 16384 \ --max_num_seqs 128 \ --gpu_memory_utilization 0.8
このコマンドは、ローカル運用の文脈で最も重要な実践的ヒントです。つまり、このモデルが本格的なGPUバックエンド、長いコンテキストウィンドウ、そして Mistral 専用のツールおよび reasoning パーサを有効にして動かすことを前提としていることを示しています。
ステップ 5)アプリケーションをローカルエンドポイントに接続する vLLM は OpenAI互換の REST API を公開するため、通常は既存の OpenAI SDK コードの接続先を http://localhost:8000/v1 に向けるだけで、アプリケーションロジックの大部分を変更せずに済みます。Mistral の例では base_url="http://localhost:8000/v1" と空の API キーを使っており、これはローカル開発でよくあるパターンです。
from openai import OpenAIclient = OpenAI(api_key="EMPTY", base_url="http://localhost:8000/v1")resp = client.chat.completions.create( model="mistralai/Mistral-Small-4-119B-2603-NVFP4", messages=[{"role": "user", "content": "Summarize the document in five bullets."}], temperature=0.7, reasoning_effort="none",)print(resp.choices[0].message.content)
ステップ 6)速度または品質向けに調整する モデルをローカルでテストする場合、複雑なプロンプトには reasoning_effort="high"、そのモードでは temperature=0.7 が推奨されています。一方で、reasoning を無効にしている場合はより低い temperature が適しています。また同じモデルカードでは、最高精度向けの FP8 チェックポイントと、スループットおよび低メモリ使用量向けの NVFP4 チェックポイントを分けているため、最適な構成は品質、速度、ハードウェア使用量のどれを重視するかによって変わります。
ステップ 7: 任意 – Ollama 経由で実行する(簡易版) ollama run mistral-small-4
Mistral Small 4 vs GPT-OSS vs Qwen 3.5(完全比較)
Mistral Small 4: 極めて効率的な MoE
119B 総パラメータ トークンあたり ~6.5B がアクティブ128 エキスパート(4 つがアクティブ) マルチモーダル(テキスト + 画像)
👉 重要なポイント: 非常に大きな容量だが、トークンあたりの計算量は少ない
GPT-OSS: デプロイ向けの実用的な MoE
120B 版: ~117B 総計 / 5.1B アクティブ 20B 版: ~21B 総計 / 3.6B アクティブ テキスト専用
👉 重要なポイント: 最小限のハードウェアで強力なモデルを動かせること
単一の H100 GPU で動作可能強力なツール利用 / 構造化出力サポート
Qwen 3.5: 高能力スケーリング
最大 122B パラメータ より高い アクティブパラメータ数(~20B+)
マルチモーダル + 強力な多言語対応
👉 重要なポイント: 計算コストが上がっても能力を最大化すること
性能ベンチマーク比較 Input / Output テキスト + 画像入力 → テキスト出力Context: 256K tokens テキスト入力 → テキスト出力Context: ~128K tokens テキスト + 画像 + 動画入力 → テキスト出力Context: 最大 1M tokens Price (API) $0.15 /M input$0.60 /M output 公式API価格なし(セルフホスト)→ インフラ依存コスト $0.40–0.50 /M input$2.40–3.00 /M output Architecture MoE (Mixture-of-Experts)119B total / 6.5B active128 experts (4 active) MoE Transformer120B: 117B / 5.1B active20B: 21B / 3.6B active Hybrid MoE + advanced layersUp to 397B total (A17B active) Multimodal ✅ 画像サポート ❌ テキスト専用 ✅ 画像 + 動画 Reasoning Control ✅ (reasoning_effort) ✅ (low/med/high modes) ✅ Adaptive reasoning Context Efficiency ⭐⭐⭐⭐⭐(短い出力) ⭐⭐⭐⭐ ⭐⭐⭐(長い出力) Tool / Agent Support ✅ ネイティブツール、エージェント、構造化出力 ✅ 強力なツール利用、構造化出力 ✅ 高度なエージェントエコシステム Coding Ability ⭐⭐⭐⭐⭐(Devstral レベル) ⭐⭐⭐⭐ ⭐⭐⭐⭐⭐ Deployment 重い(マルチGPU推奨) 柔軟(単一GPUでも可) 重い(クラウド規模推奨)
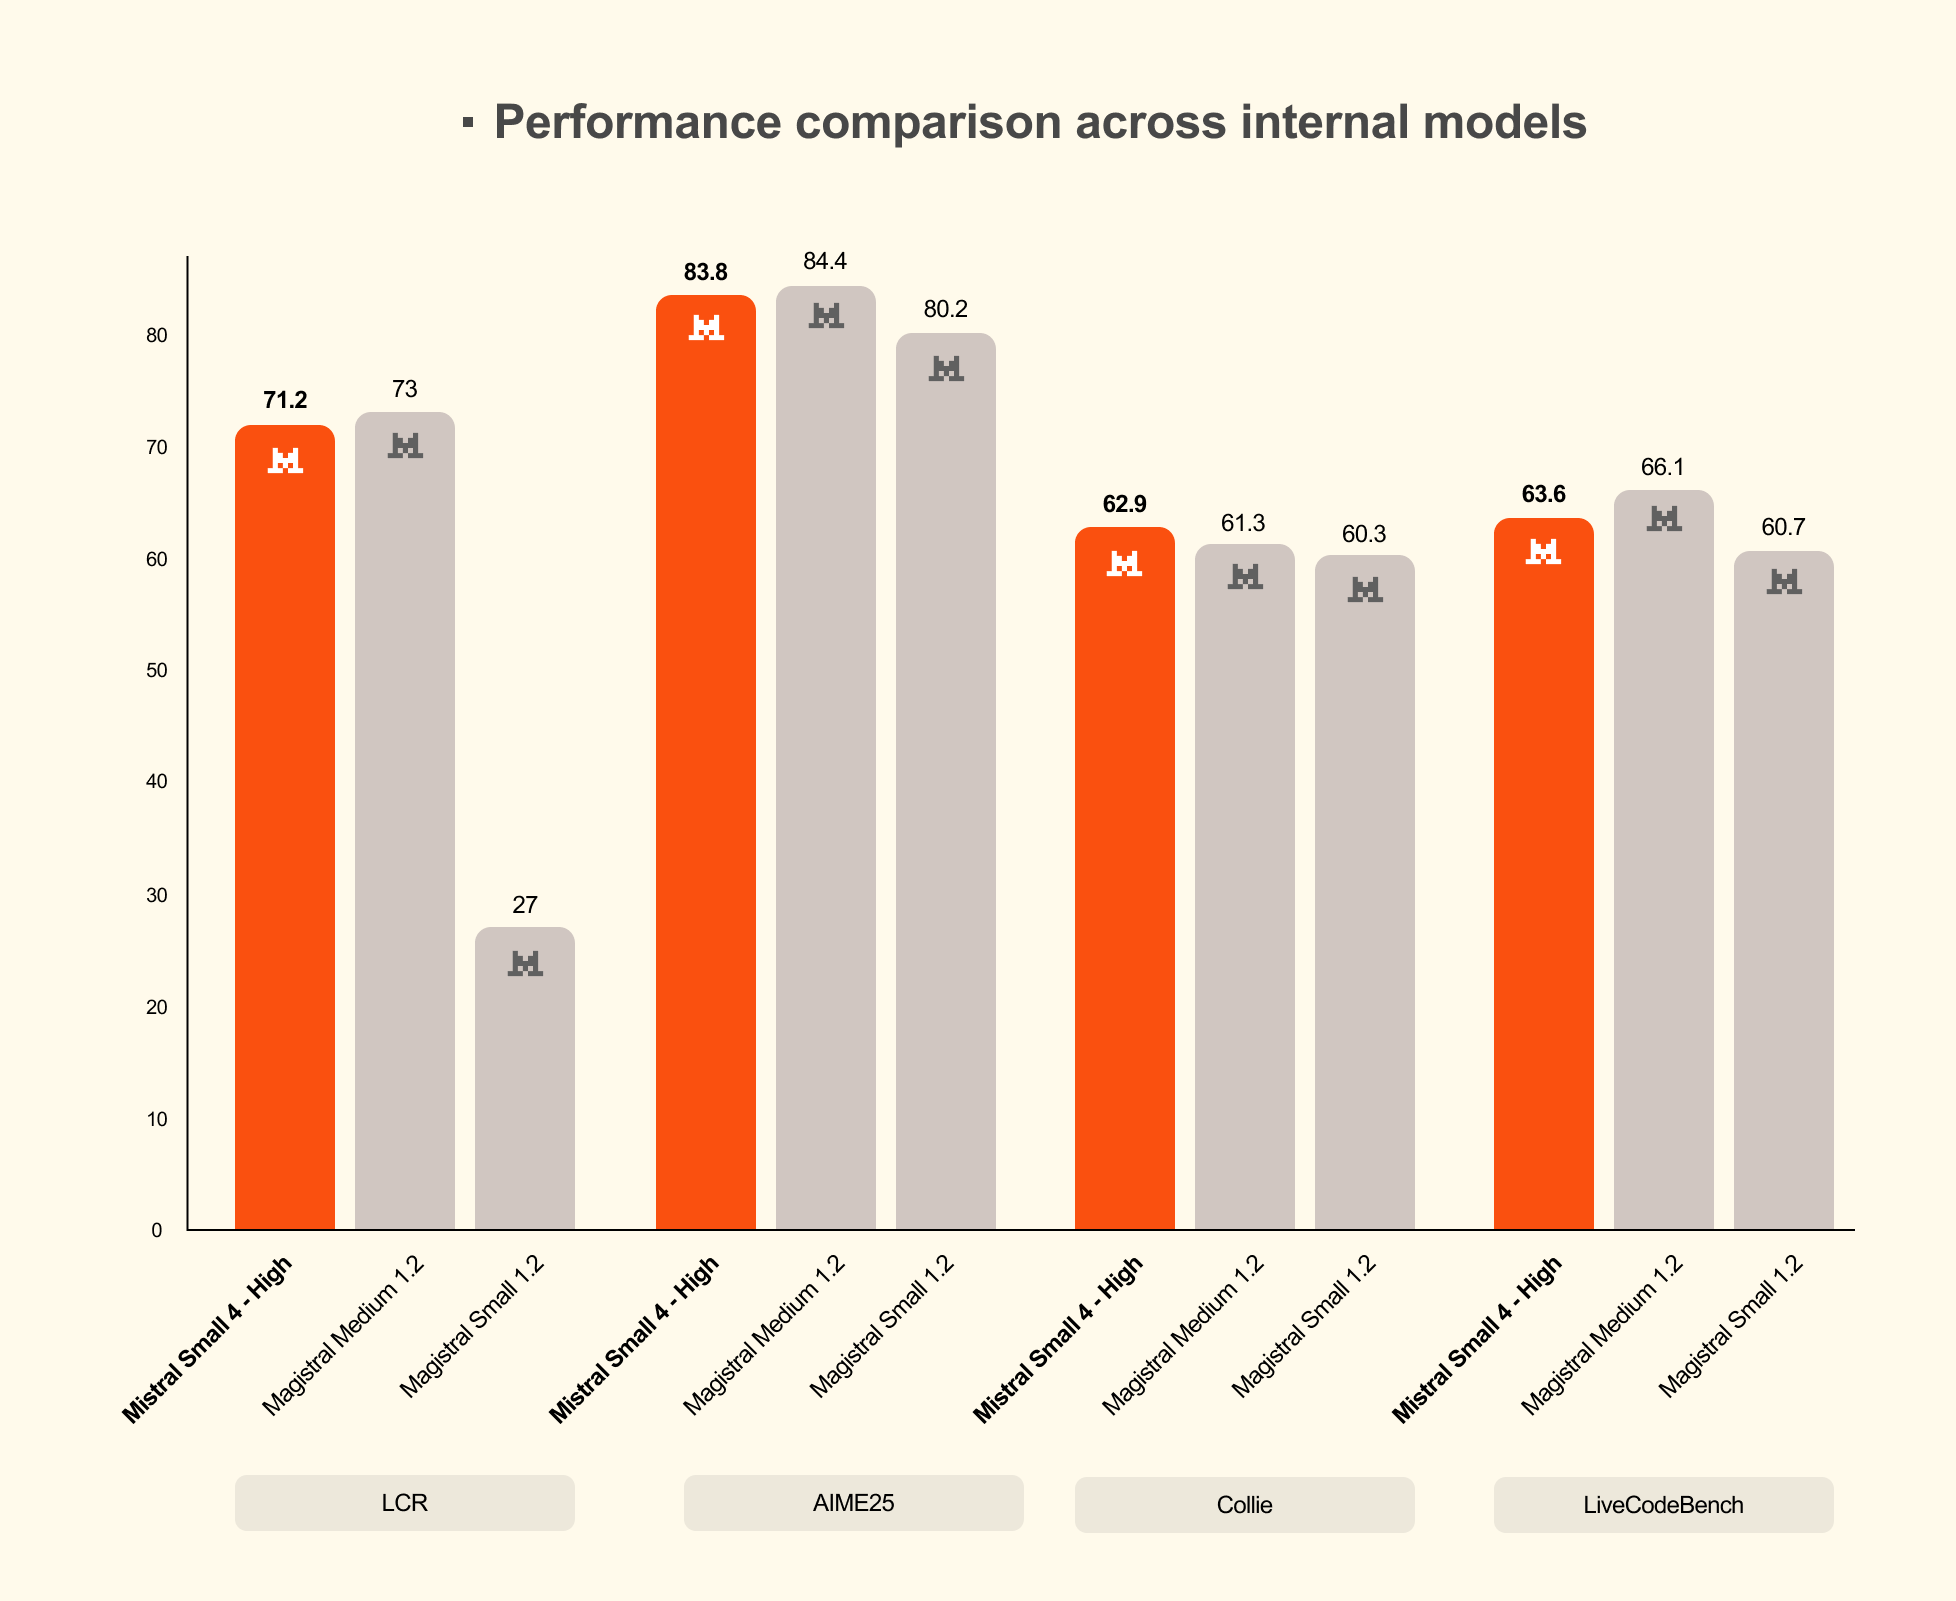
reasoning を有効にすると、Small 4 は LCR、LiveCodeBench、AIME 2025 において GPT-OSS 120B に匹敵または上回りつつ、より短い出力を生成します。Mistral は一例として、Small 4 が AA LCR で 1.6K 文字のみで 0.72 を記録した一方、同等の Qwen の結果では 5.8K~6.1K 文字が必要だったと述べています。また、Small 4 は LiveCodeBench で GPT-OSS 120B を上回りながら、出力を 20% 少なく抑えるともしています。
ローカル用途で最良の選択はどれか? 私見では、Mistral Small 4 は、強力な汎用チャット、コーディング、エージェント作業、マルチモーダル対応を備えた、バランスの取れたローカルまたはプライベートデプロイを求めるなら、最良の「単一モデル」候補です。GPT-OSS は、明確なローカルサービングガイダンスがあるオープンな OpenAI モデルを求めるなら最もわかりやすい選択肢で、とくに小さい 20B 版が有力です。Qwen3.5 は最も幅広いファミリーであり、多言語対応、複数サイズ帯、柔軟なローカルサービングオプションを重視するなら注目すべきです。
言い換えれば、Small 4 はホスト型モデルとして利用することも、重みを取得して自前のインフラでセルフホストすることもできます。
結論 Small 4 は、open-weight 、マルチモーダル 、推論対応 のモデルを必要とし、さらにそれをセルフホスト 、ファインチューニングし、既存の OpenAI スタイルのアプリケーションスタックへ統合したい場合に非常に適しています。特に、デプロイ制御、データレジデンシー、限界トークンコストの低減を重視しつつ、なおかつ最新の汎用モデルを求めるチームにとって魅力的です。
Mistral Small 4 にアクセスする準備はできましたか? それなら CometAPI へどうぞ!