Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Hy4 と GPT-6.1 Terra:ベンチマーク、API 料金、どちらのモデルを選ぶべきか ai-comparisons / CometAPIリサーチ
Hy4 と GPT-6.1 Terra:ベンチマーク、API 料金、どちらのモデルを選ぶべきか Hy4 と GPT-6.1 Terra を、コーディング、リサーチ、公式API仕様、CometAPIの料金で比較しましょう。あなたのワークロードに最適なモデルを見つけましょう。
Deon Goodwin AIモデルとAPIの調査チーム Hy4 と GPT-6.1 Terra を、コーディング、リサーチ、公式API仕様、CometAPIの料金で比較しましょう。あなたのワークロードに最適なモデルを見つけましょう。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)要約
Hy4 は金融リサーチや大量のテキスト生成に強力な出発点であり、GPT-6.1 Terra はターミナルでのコーディングとデバッグに強力な出発点です。両者ともテキストと画像を受け付け、ツール利用をサポートします。最も明確な違いはタスク性能、出力容量、価格です。以下のターミナルコーディングでは Terra が優位で、Hy4 は金融とリサーチで優位、かつ CometAPI の表示料金ではコストが低くなります。
重要なポイント
ワークロードで選ぶ: リサーチや大量出力なら Hy4、ターミナルでのコーディングとデバッグなら Terra。
両者ともおよそ100万トークン級のコンテキストウィンドウ。Terra はより大きな最大出力予算を提供。
Terminal-Bench 4.0 では Terra が10.10ポイントのリード。Vals AI の結果では Finance Agent v2.1 で Tencent のモデルが8.74ポイントのリード。
CometAPI の例(入力1,000万トークン・出力200万トークン)は、表示ベース料金で $10.672 対 $16.00。
プロバイダ切り替え前に、エンドポイント、ツール挙動、推論設定をアプリに合わせて調整。
明確性、出典の帰属、最新のAPI用語について確認済みです。
仕様、ベンチマークのスナップショット、価格は 2026年11月6日に確認。
Hy4 と GPT-6.1 Terra の比較: 仕様と機能 Hy4 はテキストと画像の理解に加え、推論やツール利用を組み合わせ、コマンドラインやグラフィカルインターフェースをまたぐワークフローを含みます。GPT-6.1 Terra は視覚的推論、コンピュータ操作、ライティングをサポートし、推論努力の制御とより大きな出力予算を備えています。以下の表は Tencent と OpenAI の仕様を比較したものです。
公式 API 仕様 両モデルとも大規模なドキュメント群やコードベースで動作可能です。長いプロンプトでは応答のための余裕も確保してください。Tencent は Hy4 の最大入力を 960K と記載しています。宣伝上のコンテキスト容量の小さな差よりも、与えた材料をどれだけ正確に活用できるかの方が選定には有用です。
Terra は最大 128,000 トークンの出力に対応し、Hy4 公称の 64K より長文応答に余裕があります。レポートやコード成果物を1回の応答に収める必要がある場合に有利です。推論トークンも Terra の出力予算を消費します。
推論コントロール Terra には推論努力の設定が6段階(none, low, medium, high, xhigh, max)あり、デフォルトは medium です。タスクに応じて推論の工数を明示的に調整できます。分類リクエストと難易度の高いデバッグで同じ予算を使う必要はありません。
Tencent の発表では視覚認識とツール利用を組み合わせた推論が説明されていますが、同等の6段階制御は明示されていません。推論パラメータはエンドポイントごとに異なるものとして扱い、あるプロバイダの努力設定を別のリクエストにそのまま流用して同じ意味になると想定しないでください。
Hy4 と GPT-6.1 Terra の比較: 性能 Vals AI はコーディング、金融、法務リサーチ、税務タスクにわたる両モデルの直接的な結果を提供しています。これらのスコアは、各モデルがワークロードに適している領域を示します。
独立ベンチマーク結果と試験条件 以下の Vals Index v2.2 の結果は 2026年11月10日に確認しました。スコアが高いほど良好です。
Vals AI は Hy4 に temperature 0.9、top_p 1.0、出力上限 65,536 トークンを、Terra に最大推論努力と出力上限 128,000 トークンを設定しています。設定が異なるため、同一予算の比較ではなく、テスト時の構成同士の比較として結果を解釈してください。
Terra のリードは、コード生成よりもターミナルタスクで大きく、Terminal-Bench 4.0 で 10.10 ポイント、Vibe Code Bench では 2.99 ポイントです。したがってデバッグやコマンドライン開発が Terra 評価の出発点として最も明確です。
Hy4 は Finance Agent、Legal Research Bench、Tax Agent Bench でそれぞれ 8.74、15.39、17.32 ポイントのリードです。証拠収集とドメイン規則の適用を伴うリサーチワークフローは、Hy4 の有望な出発点となります。
全体の差は 1.19 ポイントであり、公開された不確実性区間は重なっています。
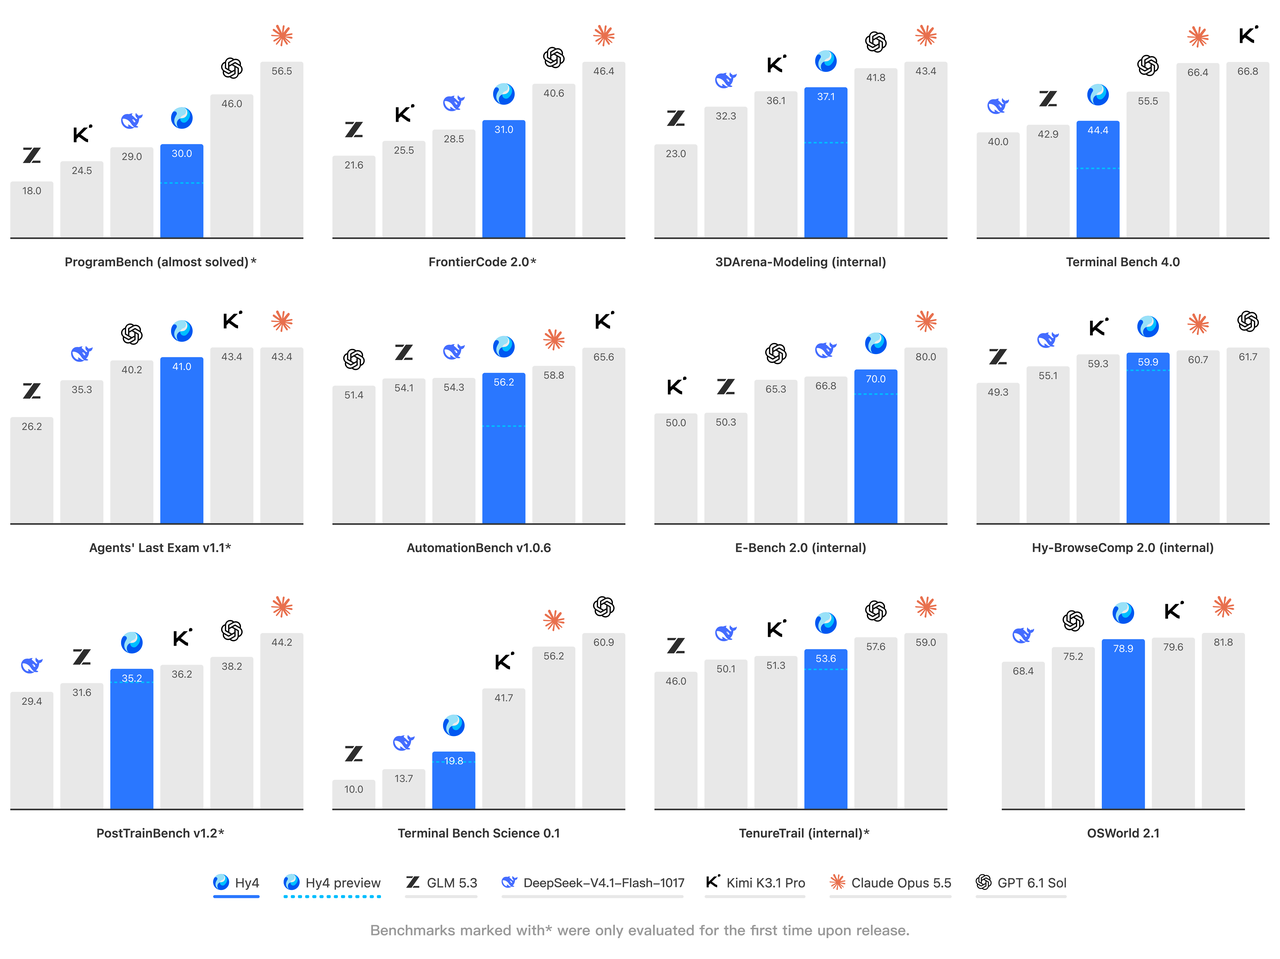
Tencent による Hy4 のローンチベンチマーク Tencent のローンチチャート には、コーディングとコンピュータ操作の結果が追加されています。ここでは Hy4 が GPT-6.1 Sol と比較されています。GPT-6.1 Terra との直接比較は上記の Vals AI の表を参照してください。
Tencent が報告した Hy4 のベンチマーク結果(2026年11月)。表示されている OpenAI のモデルは GPT-6.1 Sol。
Tencent のローンチチャートでは、Hy4 は Terminal Bench 4.0 で 44.4、OSWorld 2.1 で 78.9 を記録しています。これらの数値は Tencent の評価設定に基づくもので、上記の Vals AI のスコアとは別物です。
ビジョンおよびコンピュータ操作ワークフロー Tencent は公式リリースで画像理解 を導入し、コマンドラインツール、グラフィカルインターフェース、Blender、CAD にまたがるワークフローの訓練について説明しています。これにより、チャート解析や視覚的なソフトウェアタスクが中心的なポジショニングとなっています。
OpenAI はモデルを画面ベースのワークフロー 、簡潔なライティング、限定範囲のコード修正向けに位置づけています。カタログアプリでは商品写真のマッチング、技術用途では小さなラベルや寸法のある図面、デスクトップ自動化では保存ファイルとアプリケーション状態の検証をテストしてください。
優れた視覚テストセットは、読み取りと行動を分けて評価すべきです。まずモデルが正しい値を抽出するか、適切なインターフェース要素を特定できるかを測定します。その後、誤ったクリックやファイル欠落、不要な人手介入なしに、完全なワークフローが所定の結果に到達するかを測定します。
スピードとエンドツーエンドのレイテンシ チャットでは、回答がいつ開始されるかと、完了までの時間が重要です。エージェントでは、ツール実行や修復を含めたタスク全体を測定します。
想定する同時実行数で、典型的・高負荷タスクの両方を両モデルで比較してください。成功率とともに、中央値およびテールのレイテンシを追跡しましょう。速い応答でも、成果が得られてこそ有用です。
Hy4 と GPT-6.1 Terra の比較: コスト まずトークン単価を比較し、その後、使える結果を得るために必要な工数を考慮してください。以下の価格は CometAPI の基本料金で、100万トークンあたりの米ドルです。Vals AI が報告するテスト当たりのコストとは別です。
入力(100万トークンあたり) $0.6672 $0.80 出力(100万トークンあたり) $2.00 $4.00
以下の表は、100万トークンあたりの CometAPI 掲載の基本料金(米ドル)を用いています。入力と出力を別々に比較し、典型的なリクエストのコストを計算してください。
1万リクエストのコスト例 各リクエストで未キャッシュの入力トークン 1,000、課金対象の出力トークン 200 を使用する 1万件のリクエストを考えます。合計で入力 1,000万トークン、出力 200万トークンです。上記の CometAPI の基本価格を適用すると:
Hy4: (10 × $0.6672) + (2 × $2.00) = $10.672
GPT-6.1 Terra: (10 × $0.80) + (2 × $4.00) = $16.00
この例では Hy4 の方が約 33.3% 低コストです。この試算は未キャッシュの入力と課金対象の出力を対象としています。実際のワークフローの予算には、キャッシュ、ツール、リトライの費用を加算してください。
直接プロバイダ課金と長コンテキストのリクエスト OpenAI の直接 API では、入力 272K トークン超のプロンプトで、リクエスト全体に対して入力・キャッシュが 2 倍、出力が 1.5 倍のレートが適用されます。利用サービスの課金ルールを適用してください。上記の CometAPI 例は CometAPI の基本料金に基づきます。OpenAI の価格詳細 。
受理タスクあたりのコスト 受理タスクとは、アプリケーションの品質・完了チェックを満たしたタスクです。成功に至るまでの全試行、ツール利用、レビュー作業を含め、失敗に終わった試行の費用も計上します。
受理タスクあたりのコスト = モデル・リトライ・ツール・人手レビューの総コスト ÷ 受け入れ基準を満たしたタスク数。
より高価な呼び出しでも、複数の修復試行を不要にできるなら経済的になり得ます。逆に、低コストのモデルで品質閾値を満たせるなら、すべてのタスクで高い料金を払っても価値は限られるかもしれません。
どちらを選ぶべきか: Hy4 か GPT-6.1 Terra か 主要なワークロードの強みに合うモデルから始めてください。以下の選択肢で候補を絞り込み、その後、完了タスクの品質とコストを比較しましょう。
Hy4 を選ぶべきとき 金融リサーチ、法務・税務ドキュメント分析、大量テキスト生成のアプリケーションでは、まず Hy4 を検討してください。3つのドメインベンチマークでのリードは、証拠重視のリサーチに有用な候補であることを示します。CometAPI 掲載の料金では、出力単価が Terra の半分であり、大量の下書きやレポート作成で大きな差になります。
リサーチ業務では、出典の正確性、計算、質問カバレッジで完成した回答を評価してください。Hy4 がレビューとリトライを含めた総コストを抑えつつ要件を満たすなら、より適した選択です。
GPT-6.1 Terra を選ぶべきとき ターミナルでのコーディング、デバッグ、コード修正にはまず GPT-6.1 Terra を検討してください。Terminal-Bench での 10.10 ポイントのリードは、本比較で最も強いコーディングのシグナルです。より大きな出力予算は、長文レポートや大きなコード応答の評価対象としても有用です。
Terra は、パッチがテストを通過し、成果物が完全であるかで評価してください。視覚・デスクトップ作業では、実際の画面、チャート、ファイルで両モデルを比較し、最終的に保存された結果を確認しましょう。
リサーチとコーディングを別モデルにルーティングする 混在ワークロードでは、両モデルの併用が有益な場合があります。金融分析アシスタントでは、リサーチとレポート作成に Hy4 を用い、分析スクリプトのデバッグが必要になったら Terra を呼び出す、といった構成です。
証拠収集とレポート作成は Hy4 に送る。
レポートを受け入れる前に、引用、元データ、計算を確認する。
失敗した分析スクリプトは、コード、エラー出力、期待動作と合わせて Terra に回す。
修正後のスクリプトを実行し、同じ証拠チェックを適用してから最終結果を返す。
追加コストと統合作業を上回る最終成果の改善が得られる場合に、第2のモデルを使用してください。
Hy4 と GPT-6.1 Terra の入手先
公式プロバイダでの利用
CometAPI では、両モデルが hy4 と gpt-6.1-terra の ID で提供されています。各ルートのリクエスト例と価格はモデルページに記載されています: Hy4 と GPT-6.1 Terra 。
ツール対応アプリケーションでは、選択したルートが関数呼び出しと構造化出力をサポートするかを確認してください。OpenAI の直接 API では、Terra のツール呼び出しに Responses API が必要です。
選定のテストとロールアウト方法 本番トラフィックを切り替える前に、代表的なタスクで同じ入力、ツール、合格基準を使ってモデルを比較してください。成功完了、総コスト、経過時間を記録し、より強いルートを段階的にロールアウトしましょう。
日常的なリクエストと、ユーザーにとって重要な難ケースを含める。
ツール引数、構造化出力、エラー、完了ステータスを確認する。
本番トラフィック送出前に、リトライ上限とロールバックトリガーを設定する。
結論 リサーチ品質とテキスト生成コストの低さを優先するなら Hy4 を選びましょう。ターミナルでのコーディング、デバッグ、より大きな出力予算を重視するなら GPT-6.1 Terra を選びましょう。
混在アプリケーションでは、主要ワークロードごとに1モデルから始め、成果が向上する箇所に第2ルートを追加してください。最適な選択は、持続可能なコストで正確にタスクを完了できるモデルです。
開発元 Tencent OpenAI API モデル ID hy4 gpt-6.1-terra 入力 / 出力 テキストと画像 / テキスト テキストと画像 / テキスト コンテキストウィンドウ 1024K トークン(Tencent 表記) 1,050,000 トークン 最大出力 64K トークン(Tencent 表記) 128,000 トークン ツール呼び出し 対応(Function Calling) 対応(Responses API が必要) 構造化出力 対応 対応 主な用途 ソフトウェア工学、金融分析、長時間稼働のエージェントタスク 視覚的推論、コンピュータ操作、ライティング、限定範囲のコードタスク
Vals Index 59.35% ± 1.08 60.54% ± 0.99 Terra が +1.19 ポイント Terminal-Bench 4.0 39.39% 49.49% Terra が +10.10 ポイント Vibe Code Bench v1.1 81.01% 84.00% Terra が +2.99 ポイント Finance Agent v2.1 64.70% 55.96% Tencent モデルが +8.74 ポイント Legal Research Bench 41.35% 25.96% Tencent モデルが +15.39 ポイント Tax Agent Bench 34.40% 17.08% Tencent モデルが +17.32 ポイント
Hy4 と GPT-6.1 Terra:ベンチマーク、API 料金、どちらのモデルを選ぶべきか - CometAPI