

TL;DR
Muse Wonder、Claude Opus 5.5、GPT-6 Sol は、コーディングとエージェントのワークフローに位置付けられた高機能モデルです。Meta の新しい Muse Wonder は永続メモリと持続実行を強調し、Opus 5.5 は引用された総合インテリジェンス指数で首位、GPT-6 Sol は今回の比較で標準の短コンテキストにおける入出力単価が最も低く、長コンテキスト階層は別料金です。単一のリーダーボードではなく、代表的なタスク品質・信頼性・総コストで選定してください。
Key Takeaways
- 全体的な知性: Claude Opus 5.5 は報告された Intelligence Index v4.3 で 58、Muse Wonder は 52。
- 長期的コーディング: Muse Wonder は DeepSWE 1.1 で 78.8、SWE-Marathon で 53.1。Opus 5.5 は Meta の表で 74.2 と 46.3。
- 低コスト推論: GPT-6 Sol は OpenAI の短コンテキスト標準 API で 100万トークンあたり 入力 $2 / 出力 $10 から。
- メモリ特化エージェント: Muse Wonder は Active Memory と Active Focus を導入。
- 利用可能性が重要: Muse Wonder Full は開発者が利用できる標準の Muse Wonder とは別の、より制限のある製品。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol at a Glance
永続エージェントと長時間のエンジニアリングには Muse Wonder、幅広いコーディングとターミナル中心の作業には Claude Opus 5.5、標準の短コンテキストにおける低トークン単価を求めるなら GPT-6 Sol を選びましょう。
| Decision factor | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Start testing with | 永続エージェントと長時間のエンジニアリング | ターミナル中心のコーディングとプロフェッショナルなワークフロー | 予算重視のコーディングと自動化 |
| Context window | 1,048,576 トークン | 1M トークン | 1,050,000 トークン |
| Published strength | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | 標準 入力/出力 $2/$10(100万トークンあたり) |
| Standard input / output per 1M tokens | $4 / $20 | $4 / $20 | $2 / $10(短コンテキスト階層) |
| Provider access | Meta Model API。Full は別サブスクリプション製品 | Anthropic API | OpenAI API |
| Selection metric | 受理タスク品質と総コスト | 受理タスク品質と総コスト | 受理タスク品質と総コスト |
| Developer | Meta | Anthropic | OpenAI |
| Release | 2026年10月12日 | 2026年9月22日 | 2026年9月16日 |
| Input modalities | テキスト、画像、音声、動画。PDF 入力が文書化 | テキスト、画像 | テキスト、画像 |
| Output | テキスト | テキスト | テキスト |
| Distinctive capability | Active Memory と Active Focus | ツールとサブエージェントのワークフロー | 設定可能な推論努力と API ツール |
この概要は、以下で検討した日付付きの仕様と公開結果をまとめたものです。ベンチマーク行は評価方法が異なり、低いトークン単価が受理タスクあたりのコスト低下を保証するわけではありません。標準の Muse Wonder と Muse Wonder Full は別のアクセス選択肢です。
仕様は 2026年10月13日に確認しました。対応モダリティや機能は選択したエンドポイントと提供経路に依存し、音声の可用性も含まれます。モデルレベルの機能が、あらゆるゲートウェイルートでのサポートを保証するわけではありません。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Overview and Specifications
Muse Wonder: Persistent Agent Workflows
Meta は 2026年10月12日に Muse Wonder と Muse Wonder Full を発表しました。標準の Muse Wonder は、長時間のプロフェッショナルタスク、永続的なエージェントメモリ、障害からの復旧を重視します。Active Memory は有用な過去コンテキストの取得を意図し、Active Focus は多段階作業における進捗の維持を設計意図としています。Meta は、コーディング、リサーチ、財務分析、パーソナルアシスタンスを主要なシナリオとして挙げています。
Claude Opus 5.5: Professional Coding and Tool Use
Claude Opus 5.5 は、コーディング、推論、複数ツールを用いるプロフェッショナルなワークフローを対象としています。Anthropic は 2026年9月22日にリリースしました。コンテキストウィンドウは 100万トークンで、以下の報告されたコーディング結果はベンチマークにより強みが異なることを示します。
GPT-6 Sol: Cost-Conscious Reasoning
GPT-6 Sol は、強力な推論とツール使用を比較的手頃な推論コストと組み合わせることを目指します。OpenAI の API エコシステムを通じてプログラム的なワークフローをサポートします。標準の短コンテキスト料金は、記載の Claude Opus 5.5 より低い一方で、エンドツーエンドの経済性はリトライや推論トークン使用量にも依存します。
OpenAI は GPT-6 Sol を、複雑なコーディングとエージェント的ワークフロー向けのモデルとして説明しており、以下に用いた評価結果をリリース告知で提供しています。本記事は、各ベンダーの最新全モデルではなく特定のモデルバージョンを比較しています。
Architecture and Reasoning Controls
引用元は、3モデルすべてに対して比較可能なパラメータ数やアーキテクチャの内訳を提供していません。したがって、密型と Mixture-of-Experts の優劣を序列化することは正当化できません。Active Memory と Active Focus は Meta のエージェント機能を表すものであり、開示済みのニューラルアーキテクチャの代替ではありません。GPT-6 Sol は推論努力を設定可能であり、報告された Meta と Claude のスコアも努力設定や評価セットアップに依存します。これらの設定は、比較対象の構成の一部として扱うべきであり、計算量の交換可能な尺度とは見なさないでください。
Comparison result: 3モデルはいずれも大きなコンテキストウィンドウと開発者向け API を提供します。Muse Wonder はモデルレベルでより広い入力モダリティを文書化し、Opus 5.5 と GPT-6 Sol はテキストと画像のワークフローを強調しています。コンテキスト容量と機能の可用性は、選択したエンドポイントで個別に確認が必要です。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Performance
Published Benchmarks and Source Boundaries
Meta の公式モデルカードは、Muse Wonder と Claude Opus 5.5 の直接比較を提示します。OpenAI は GPT-6 Sol の結果を別途公開しているため、3モデルを完全に統一されたリーダーボードに置くには、評価ハーネス、バージョン、設定の調整が必要です。
| Benchmark | Muse Wonder | Claude Opus 5.5 | Higher score |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
公式モデルカードの方法論は、社内テスト、第三者評価、プロバイダー報告の競合スコアを区別しています。上表は報告値を再現したものであり、全行にわたる統一的で独立に管理された試験を確立するものではありません。
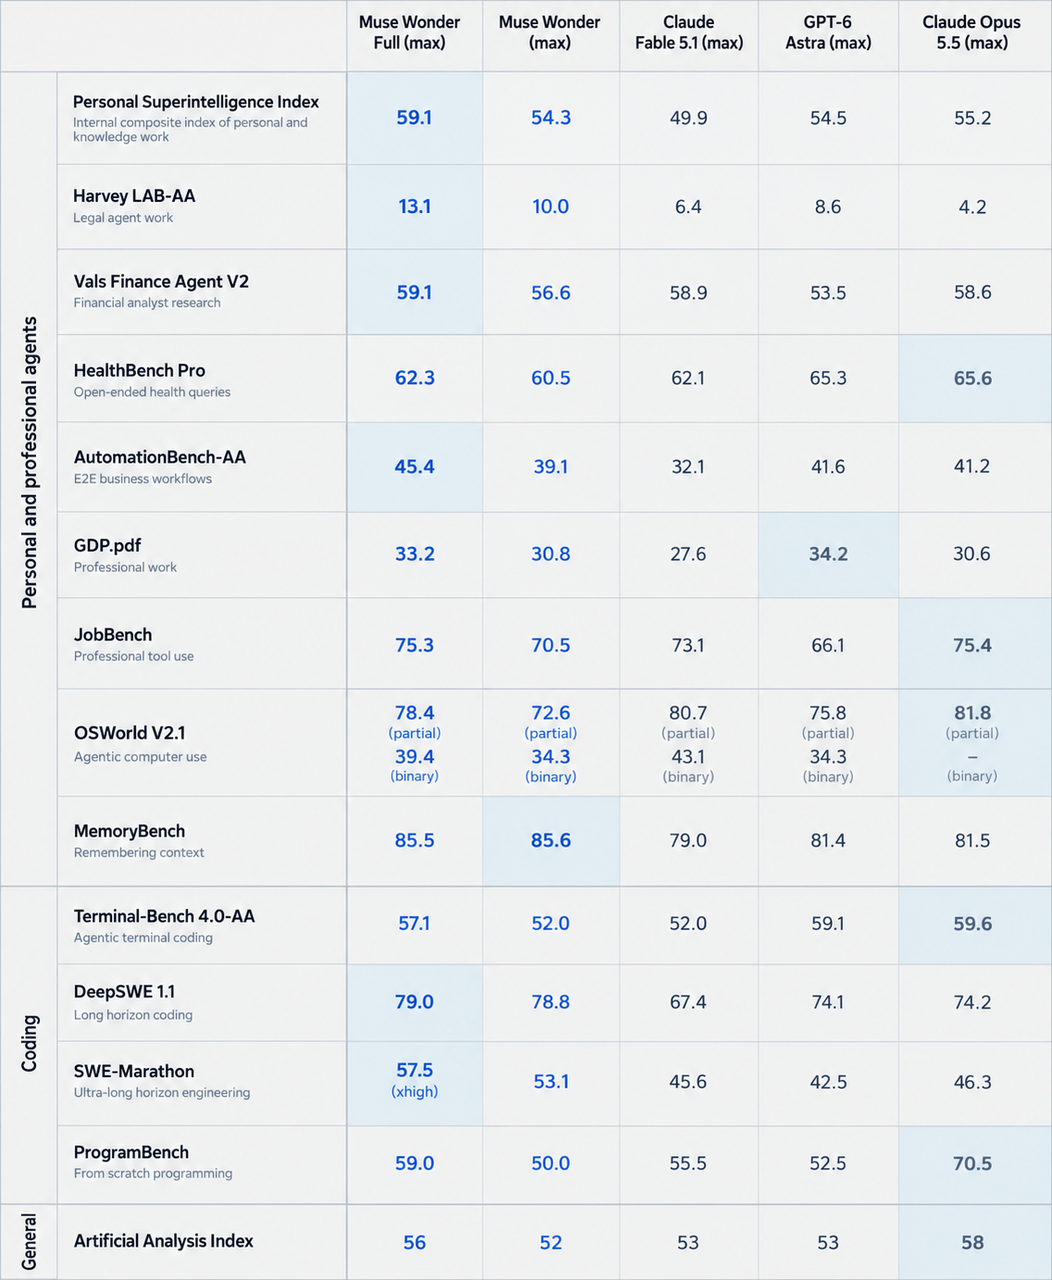
Meta の Muse Wonder モデルカードからのオリジナルのベンチマークスコアカード(再作図なし)。この公式画像に示される追加の OpenAI モデルは GPT-6 Astra であり、GPT-6 Sol ではありません。周囲の表は本記事に関連するモデルを示しています。
Evaluation Conditions
DeepSWE v1.1 は 91 リポジトリ・5 言語にわたる 113 タスクをカバーし、pass@1 による機能テストと回帰テストで採点します。Meta のスコアカードは、Muse Wonder と Opus 5.5 に Datacurve の結果を用いています。SWE-Marathon はプロジェクトテストを使用し、Abundant AI による pass@1 を報告します。エージェントハーネスは異なり、Wonder Full のスコアは xhigh と記されています。ProgramBench は mini-swe-agent を使用し、セットアップ後はインターネットを無効にして、隠しテストの少なくとも 95% に合格したロールアウトを測定します。MemoryBench は Meta の社内 64K~100K トークンの会話テストで、LLM ジャッジにより採点されます。これらの環境と指標を単一の一般的な正確性スコアに統合すべきではありません。
Coding and Software Engineering
Muse Wonder は報告された DeepSWE 1.1 と SWE-Marathon で優位です。Claude Opus 5.5 は Terminal-Bench 4.0-AA と ProgramBench で優位です。この分化は、長期エンジニアリング、コマンドラインツールの使用、プログラム再構成が異なるスキルを要求することを示唆します。
GPT-6 Sol Results and Cross-Source Comparability
| Published OpenAI evaluation | GPT-6 Sol | Reported setting |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
OpenAI の公開評価結果は上記のスコアを報告しています。OSWorld の結果は、v2026.08.08 のオフラインセットでの部分報酬であり、厳密なタスク完了率ではありません。評価は研究環境または API を用いたと OpenAI は注記しており、本番構成は異なる場合があります。
報告された DeepSWE のスコアは、Muse Wonder と GPT-6 Sol の間に 10.0 ポイント、Opus 5.5 と GPT-6 Sol の間に 5.4 ポイントの差を示唆します。これは、それぞれの出版物間の算術的な差であり、モデルのみの優位性を統制下で推定したものではありません。エージェントのセットアップ、プロンプト、努力レベル、ツールの予算が結果に影響し得ます。
Memory and Long-Running Agents
Muse Wonder は、過去の意思決定を記憶し、コンテキストを復元し、中断した作業を継続する必要があるエージェントをターゲットとしています。Active Memory は、リサーチアシスタントがプロジェクト固有の事実を記憶するのに役立ち、Active Focus は、初期の計画がうまくいかなかった場合の反復的なアクションを支えます。これらの製品機能は、状態検証、権限、監査証跡、機密アクションに対する必須の人手確認の代替にはなりません。
Muse Wonder Full Performance
Muse Wonder Full は別製品の選択肢です。Meta は標準の Muse Wonder を API で提供する一方、Full は Muse Code の Power Usage と Maximum Usage サブスクリプションで利用が制限されています。スコアが高いからといって、Full が標準モデルの API 代替になるわけではありません。
Meta が報告する Wonder Full の結果は、Intelligence Index で 56、Personal Superintelligence で 59.1、Harvey LAB-AA で 13.1、AutomationBench-AA で 45.4 です。DeepSWE 1.1 で 79.0、SWE-Marathon で 57.5、MemoryBench で 85.5、JobBench で 75.3 も報告されています。これらは別途アクセスされる Full 製品の公開結果であり、共通ハーネスによる新たな比較測定ではありません。
標準の Muse Wonder と比べると、Full はこれら 8 指標のうち 7 つで改善しています。MemoryBench は 85.6 に対して 85.5 とわずかに低い一方、Opus 5.5 は Intelligence Index で依然として 58 と先行しています。
Latency and Reliability
引用した証拠は、3 モデルのレイテンシを揃えた比較を提供していません。有用な最初の出力までの時間、エンドツーエンドのタスク時間の中央値と 95 パーセンタイル、タイムアウト頻度、介入なしでの完了を測定してください。タスク入力、ツール権限、同時実行、受け入れ基準を固定し、努力設定とリトライ予算を記録します。トークン生成の速さだけでは、多段階タスクの完了が速いとは言えません。
Comparison result: Muse Wonder は引用された持続エンジニアリング系テストで優位、Opus 5.5 はターミナルとプログラム再構成のテストで優位です。GPT-6 Sol はより低いトークン単価の候補ですが、公開情報からは 3 モデル間の品質や速度の同環境における序列は証明されていません。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Cost
Official API Token Prices
| Price per 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standard input | $4 | $4 | $2 |
| Standard output | $20 | $20 | $10 |
| Cached input | $0.20 | $0.20 | $0.20 |
| Long-context input | $4 | $4 | $4 |
| Long-context output | $20 | $20 | $15 |
| Long-context cached input | $0.20 | $0.20 | $0.40 |
Meta は 100万トークンあたり 入力 $4、出力 $20、キャッシュ済み入力 $0.20 を公開しています。Anthropic は Opus 5.5 を 入力 $4、出力 $20、キャッシュヒット $0.20(100万トークンあたり)としています。OpenAI の料金表は GPT-6 Sol を短コンテキストで 入力 $2 / 出力 $10、長コンテキストで 入力 $4 / 出力 $15 とし、キャッシュ済み入力の料金も階層により異なります。見積もりの際は、該当するリクエストのコンテキスト階層、処理モード、エンドポイント条件を適用してください。
GPT-6 Sol では、入力トークンが 272,000 を超えるリクエストは高い料金が適用されます:
- 入力トークン: 標準レートの 2 倍($2 → $4/100万トークン)
- キャッシュ済み入力トークン: 標準レートの 2 倍($0.20 → $0.40/100万トークン)
- 出力トークン: 標準レートの 1.5 倍($10 → $15/100万トークン)
これらの高レートは、超過分だけでなくリクエスト全体に適用されます。したがって、入力トークンが 272,001 のリクエストは、入力・キャッシュ済み入力・出力トークンすべてが長コンテキストの料金階層に入ります。
対照的に、Muse Wonder と Claude Opus 5.5 は、標準 API 料金において同等の長コンテキスト料金上乗せを課していません。
この違いは、大規模文書の解析、リポジトリ全体のコーディング、長時間稼働の AI エージェントにおいて特に重要であり、リクエストが大きくなるほど GPT-6 Sol の短コンテキストにおける単価優位が縮小する可能性があります。
CometAPI Pricing and Billing Conditions
レビュー時点で、CometAPI は Opus 5.5 を 入力 $3.20 / 出力 $16、GPT-6 Sol を 入力 $1.60 / 出力 $8(いずれも 100万トークンあたり)としていました。これらは CometAPI の独自料金であり、上記の公式プロバイダー価格と混同してはいけません。見積もりの前に、適用されるルート、コンテキスト階層、アカウントの課金条件を確認してください。価格や条件は変更される場合があります。
Cost per Accepted Task
受理タスクあたりのコストは、課金対象となったモデルとツールの合計支出(有料のリトライやフォールバックを含む)を、事前に定義した受理基準を満たした出力数で割って算出してください。人手レビューの時間は別途記録するか、明示した人件費率で換算します。失敗したリクエストと実際の課金を個別に追跡してください。失敗そのものは課金の有無を証明しません。
Comparison result: GPT-6 Sol は標準の短コンテキスト入力・出力単価が最も低く、Muse Wonder と Opus 5.5 は同じ基準単価です。実際の受理タスクあたりコストは、選択した課金ルート、キャッシュ利用、コンテキスト階層、ツール費用、リトライ、レビュー工数に依存します。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Comparison and Selection
Capability and Workload-Based Selection
- 幅広いコーディングとターミナルワークフローには、引用の Intelligence Index、Terminal-Bench、ProgramBench で優位な Claude Opus 5.5 から開始してください。リファクタリング、ツール実行、プログラムレベルの一貫性で検証しましょう。
- 長期のエンジニアリングプロジェクトには、Opus 5.5 より強いと報告された DeepSWE と SWE-Marathon の結果を踏まえ、Muse Wonder から開始してください。タスク完了、障害からの回復、総タスクコストを測定しましょう。
- 永続的なパーソナルエージェントには、Active Memory と Active Focus を備え、Opus 5.5 より高い MemoryBench スコアが報告されている Muse Wonder から開始してください。想起、修正の取り込み、継続性、プロジェクト分離でテストしましょう。
- 多段階のツールワークフローには 3 モデルすべてを評価してください。Muse は Active Focus を提供し、Opus はツールオーケストレーションを強調し、GPT-6 Sol は Responses API のツールをサポートします。ツール権限、リトライ、状態管理を含むエージェントスタック全体を比較しましょう。
- プロフェッショナルな文書作成と分析には、Muse Wonder または Claude Opus 5.5 を評価してください。Muse には専門的な強みがあり、Opus は引用された総合指数で強みがあります。代表的な文書とタスク固有の受理基準を使用してください。
- 大量・コスト敏感な自動化には、標準の短コンテキストで最も低い入出力単価を持つ GPT-6 Sol から開始してください。受理タスクコスト、コンテキスト階層、レイテンシ、リトライを確認しましょう。
- Meta の最上位オプションとしては、アクセス可能であれば Muse Wonder Full を評価してください。いくつかの専門タスクでより高いスコアが報告されていますが、標準 API モデルとは別です。サブスクリプションのアクセスと適合性を確認してからテストしてください。
Professional Coding
Claude Opus 5.5 は、ツール実行、リファクタリング、プログラムレベルの一貫性が重要なチームにとって、幅広いエンジニアリングアシスタントのデフォルトとして適しています。報告された Terminal-Bench と ProgramBench の優位性はこの主張を強化しますが、モデル単体ではなくエージェントスタック全体を検証すべきです。
High-Volume Automation
GPT-6 Sol は、リクエスト数が多くコスト感度が高い場合に魅力的です。ドキュメントの下書き、構造化フィールドの抽出、コードの説明といった、低リスクで容易に検証できるタスクでは、質の小さな差は許容可能な場合があります。長時間の自律実行では、品質、トークン、レイテンシ、リトライを併せて追跡してください。
Production Evaluation Checklist
本番評価では 6 つの指標を追跡してください。正確性(受理回答やテスト合格で測定)、信頼性(人手救済なしで完了したタスクで測定)、レイテンシ(エンドツーエンドのタスク時間で測定)、トークン使用量(課金対象の入力・出力総量)、エージェント効率(ツール呼び出しと是正リトライ)、有効コスト(受理タスクで割った総支出)です。
Comparison result: 永続エージェントと長期エンジニアリングには Muse Wonder、ターミナル要求の強い幅広いコーディングワークフローには Opus 5.5、トークンコストが主要制約のときは GPT-6 Sol を候補に入れてください。候補の昇格は、タスク固有の品質と信頼性の閾値を満たした後に行ってください。
Where Can You Access Muse Wonder, Claude Opus 5.5, and GPT-6 Sol?
Official Provider Access
標準の Muse Wonder には Meta Model API、Opus 5.5 には Anthropic API、GPT-6 Sol には OpenAI API を使用してください。Muse Wonder Full は標準の API モデルの代替ではなく、指定の Muse Code サブスクリプションプランで提供されます。選択したルートのアカウントアクセス、使用制限、対応するリクエスト機能を確認してください。
CometAPI Access
統一ゲートウェイは認証、課金、ルーティングを簡素化できます。アーキテクチャレビューのような複雑な作業には高性能モデルを、反復的で低リスクの下書きには安価なモデルを使い分けましょう。モデル識別子と対応リクエスト形式は、対象 API エンドポイントに対して必ず確認してください。
開発者は、代表的なワークロードの評価のために Claude Opus 5.5 API in CometAPI と GPT-6 Sol API in CometAPI にアクセスできます。共通のゲートウェイであっても、すべてのリクエスト形式が相互運用できると仮定せず、各モデルの対応 API 面を確認してください。
本記事に引用した CometAPI のルートは Opus 5.5 と GPT-6 Sol をカバーします。本記事は Muse Wonder または Wonder Full の CometAPI ルートを確立するものではありません。これらの製品を評価する際は、確認済みの提供元ルートを使用してください。
Conclusion
すべてのワークロードで勝つ単一のモデルはありません。Muse Wonder は永続エージェントの挙動と長時間のエンジニアリングタスクをテストする最有力候補です。Claude Opus 5.5 は幅広いコーディング、ターミナル中心のワークフロー、ナレッジワークに強く、Meta が報告する Artificial Analysis Intelligence Index の値で先行しています。GPT-6 Sol は標準の短コンテキストにおける最も低いトークン単価を提供し、コスト重視の自動化に魅力的です。本番チームは、代表的なワークロードにおける受理タスクの品質、信頼性、レイテンシ、リトライ、ツール使用、総コストに基づいて最終選択を行うべきです。
FAQ
チームは Muse Wonder、Opus 5.5、GPT-6 Sol をどのように公正にテストできますか?
固定の受理基準、同一の入力アセット、文書化されたツール権限を備えた実タスクのホールドアウトセットを使用してください。各モデルバージョン、努力設定、エージェントハーネス、タイムアウト、トークン予算を記録します。出力が変動する場合は反復試行を行い、成功だけでなく失敗も報告し、共通ハーネスでの比較と最適構成システムでの比較を分けて実施してください。これにより、他チームのベンチマーク設定ではなく、自分たちのワークフローに適用可能な証拠が得られます。
API ゲートウェイは、モデルを切り替えてもエージェントの状態を保持できますか?
共通のゲートウェイアドレスだけでは、会話状態、ツール呼び出し ID、保存レスポンス参照の可搬性は保証されません。メッセージ、ツール出力、検証済みタスク状態の正本をアプリケーション側で保持してください。進行中ジョブを別モデルにルーティングする前に、各ルートの状態とツールのセマンティクスをテストしてください。そうしないと、安価なフォールバックが完了に必要な情報を失う可能性があります。
リトライや人手レビューの予算はどう立てるべきですか?
テスト前に受理結果を定義し、受理結果で割った課金対象のモデル・ツール合計支出として算出してください。レビュー工数は別途報告するか、明示した時給で組み入れます。失敗試行、是正呼び出し、フォールバックモデルを計上し、典型タスクと高コストタスクの両方を比較してください。これにより、低いトークン単価を有用な作業コストの自動的な低下と見なす誤りを避けられます。
メモリに敏感なエージェント評価には何を含めるべきですか?
エージェントが関連事実を想起し、修正を取り込み、古い指示を無視し、プロジェクトごとに分離を保てるかをテストしてください。単一の長いプロンプトだけでなく、遅延したフォローアップや矛盾する更新も含めます。永続性、検索、削除は導入システムに依存するため、モデルレベルだけでなくアプリケーションレベルでもメモリの動作を確認してください。