
TL;DR
Metaは2026年10月12日にMuse WonderとMuse Wonder Fullを発表しました。WonderはMeta Model APIとMuse Codeから利用可能で、FullはMuse CodeのPower UsageおよびMaximum Usageサブスクリプションで提供されます。Fullは公開ベンチマークのいくつかで先行していますが、実務上の選択はAPIアクセス、タスク品質、コストに依存します。本比較は公開情報に基づくもので、独自のハンズオン検証は含みません。
Key Takeaways
- WonderはAPI統合をサポート。FullはMuse CodeのPower UsageおよびMaximum Usageサブスクリプションで利用可能。
- MetaのローンチチャートではArtificial Analysis Intelligence IndexのスコアはWonderが52、Fullが56。4ポイント差はタスク性能の一律の百分率向上を意味しません。
- Wonderは1,048,576トークンのコンテキストウィンドウと、テキスト、画像、音声、動画、PDF入力(出力はテキスト)をサポート。
- Meta標準APIレートは100万トークンあたり入力$4、キャッシュ入力$0.20、出力$20。FullにはModel APIの公開トークン単価はありません。
- 最大の推論努力設定にしてもFullは選択されません。アプリケーションにはまずWonderを、Muse Codeで高度な対話型作業が必要な場合にFullを検討。
Muse Wonder vs Muse Wonder Full: Overview and Specifications
製品や自動化ワークフローで呼び出せるモデルが必要な場合は、まずWonderから始めましょう。Muse Codeを使い、かつベンチマーク上の強みが自分のタスクに関係するならFullを評価します。アクセスはPower UsageまたはMaximum Usageサブスクリプションが必要で、プラン制限の対象です。実務上の違いは、まずアクセス、次にベンチマーク性能という順序です。
| Decision factor | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Start testing with | 本番API、カスタムエージェント、バッチ処理 | 難易度の高い対話型コーディングとMuse Codeでのプロフェッショナル作業 |
| Provider access | Meta Model API と Muse Code | Muse Code の Power Usage または Maximum Usage |
| Public Meta API model ID | muse-wonder-1.0 | 公開されたModel API識別子はなし |
| Context window | 1,048,576 tokens | モデルカードで推論時に1M tokens |
| Input and output | テキスト、画像、音声、動画、PDF入力;出力はテキスト | モデルカードレベルではテキスト、画像、音声、動画入力とテキスト出力;Muse Codeの対応を確認 |
| Meta API input / cached input / output per 1M tokens | $4 / $0.20 / $20 | Model API の公開トークン単価はなし |
| CometAPI access status | 利用可能;アカウントのルートと課金を要確認 | 2026年10月16日時点でComing soon |
| Primary selection criterion | 受理タスクの品質、信頼性、総タスクコスト | 対応プロダクトとサブスクリプション範囲内での受理タスク品質 |
この表は、以下で論じる仕様、公開結果、商用条件を要約したものです。モデルレベルのモダリティは、すべてのエンドポイントで同一のサポートを保証するものではありません。Fullのモデルカードに記載されたコンテキスト上限は公開APIの契約ではありません。
両バリアントは複雑なコーディングおよび個人・業務のエージェントワークを対象としています。主な相違は、公開された性能とアクセス手段です。WonderはMeta Model APIとMuse Codeから、Fullは対象のMuse Codeサブスクリプションから利用可能です。
Muse Wonder for Programmable Workflows
MetaはMuse Wonder model familyを、個人および業務のエージェントワーク向けのフロンティアAIとして紹介し、持続的な推論、ツール活用、ソフトウェアエンジニアリング、難易度の高い知的作業を重視しています。
Muse WonderはMetaのModel APIとMuse Codeからアクセスできる標準モデルです。コーディングアシスタント、ドキュメント分析、マルチモーダルシステム、長時間稼働のエージェントを設計する開発者に適しています。APIインターフェースにより、ワークロードの直接測定、利用課金、プロダクションソフトウェアへの統合が可能です。
Muse Wonder Full for Demanding Interactive Work
Muse Wonder Fullは、特に要求の高いワークフロー向けに最適化された、より高性能なバリアントです。Metaの発表資料は、プロフェッショナルな分析や長期的なコーディングとの関連付けを示しています。ローンチ時点では、アクセスは独立した公開API価格ではなく、対象のMuse Codeサブスクリプションプランに紐づきます。
API仕様は、Wonderのマルチモーダル入力、正確なコンテキスト上限、推論コントロールを文書化しています。Fullにはファミリーレベルのモデルカード説明はありますが、同等の公開API契約はありません。ファミリー共有の機能から、エンドポイントのパラメータやプロダクトのアップロード制限が同一と推定することはできません。
Active Memory, Active Focus, and Reasoning Settings
MetaはActive MemoryとActive Focusを、難易度の高いタスクで有用なコンテキストを保持し、目標指向の進捗を維持するための2つのメカニズムとして説明しています。これはアプリケーションレベルの検証、権限、人的監督の必要性を排除するものではありません。
Wonderを最大の推論努力に設定しても、それがWonder Fullに変わるわけではありません。この区別はリクエスト内のトグルではなく、モデルアクセスの違いです。
Muse Wonder vs Muse Wonder Full: Performance
Published Benchmarks and Source Boundaries
Fullは報告された総合指数で先行していますが、ベンチマークスコアは選定された評価上の性能を測るものであり、普遍的な割合改善を示すものではありません。同一のベンチマーク版、推論設定、評価日を比較し、導入上の結論を出してください。
| Evaluation | Muse Wonder | Muse Wonder Full | Metric / reported setting |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52 | 56 | Composite index; Artificial Analysis; max effort |
| AutomationBench-AA | 39.1 | 45.4 | Strict pass@1; simulated business workflows; Artificial Analysis |
| SWE-Marathon | 53.1 | 57.5 | Pass@1; project tests; Abundant AI; Full at xhigh |
| Terminal-Bench 4.0-AA | 52.0 | 57.1 | Accuracy; isolated terminal tasks with executable verification; Artificial Analysis |
| DeepSWE 1.1 | 78.8 | 79.0 | Pass@1; functional and regression tests; Datacurve results |
| MemoryBench | 85.6 | 85.5 | Internal conversation-memory benchmark; LLM-judged recall |
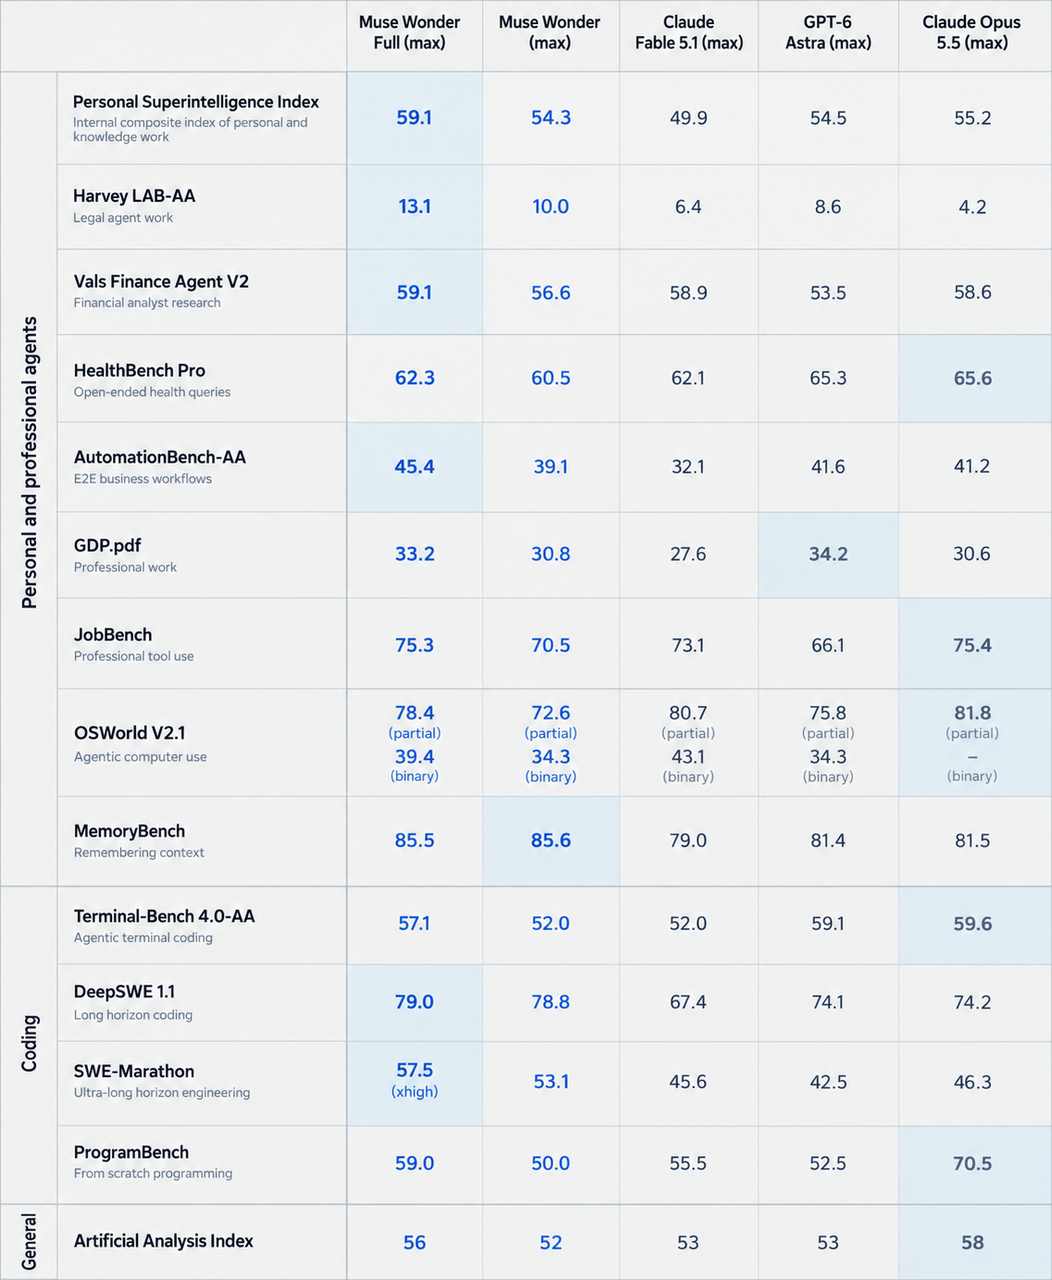
Metaの公式モデルカードのスコアカード(再描画せず再掲)。accompanying methodologyは結果の出典と設定を明示しています。
Evaluation Conditions
Metaの評価手法は、特に断りがない限りmax reasoningを用います。SWE-Marathonは、全モデル共通の制御ハーネスではなく、ベンダー報告の環境を使用しています。これらはMetaが要約した第三者の結果であり、4つの一様に統制された社内テストではありません。リリース時点のスナップショットは2026年10月12日であり、ライブのリーダーボードではありません。
DeepSWEは機能テストと回帰テストにより長期的なリポジトリ作業を測定します。MemoryBenchは64K〜100Kトークンの会話におけるリコールをLLMジャッジで測定します。スコアは異なる振る舞いを評価し、採点体系も異なります。報告されたMemoryBenchの0.1ポイント差は、評価のばらつき情報がない限り、実務上の順位付けを支えるには小さすぎます。
Coding and Software Engineering
Fullは引用されたコーディング結果で優位ですが、差の大きさは一定ではありません。DeepSWEでは0.2ポイント、SWE-Marathonでは4.4、Terminal-Benchでは5.1の差です。このパターンは、難しい長時間作業でFullをテストする根拠にはなりますが、すべてのコードレビューや短い実装でFullが必要であることを示すものではありません。APIの可用性は別の導入制約です。
Memory and Long-Running Agents
Fullはすべての指標で先行しているわけではありません。公式スコアカードのMemoryBenchはFullが85.5、Wonderが85.6です。この僅差は、実際のメモリ動作(修正された事実、古い指示、プロジェクトの隔離)をテストする理由と捉えましょう。Active Focusは、より高い総合スコアが持続性の向上を保証するという前提ではなく、失敗ステップからの回復とエンドツーエンドの完了で評価してください。
Latency and Reliability
引用資料は、WonderのAPIとMuse CodeにおけるFullのレイテンシを同条件で比較できる順位を示していません。有用な出力までの時間、中央値と95パーセンタイルのタスク所要時間、タイムアウト頻度、リトライ、人的介入なしの完了率を測定しましょう。プロダクトレベルの比較をモデルだけの実験として提示しないよう、各サーフェスのツール、推論設定、実行時間、タスク制限を記録してください。
Muse Wonder vs Muse Wonder Full: Cost
Official API Prices and Subscription Units
MetaはWonderの標準APIレートとして、100万トークンあたり入力$4、キャッシュ入力$0.20、出力$20を公開しています。Fullはサブスクリプションによるアクセスモデルのため、同じトークン価格計算は適用できません。
MetaのPower UsageおよびMaximum Usageプランは、Muse CodeにおいてWonderとFullの両方を含みます。特典や提供状況は地域により異なる場合があるため、予算化前に最新の提供内容とアカウントの許容量を確認してください。これらのサブスクリプションは対話型の利用枠を提供するもので、無制限の本番API呼び出しを含むものではありません。
トークンコスト例:100,000の非キャッシュ入力トークンは$0.40、20,000の出力トークンは$0.40、合計$0.80です。マルチステップのエージェント実行では、リクエスト間で追加のトークン使用が発生し、ツール料金も加算される場合があります。
Metaはウェブ検索のgroundingを、トークン料金に加えて1,000検索クエリあたり$2.50と掲載しています。
CometAPI Billing Conditions
Muse WonderはCometAPIから利用可能で、アカウント固有のルートレベルの価格設定があります。本番トラフィックを送る前に、入力・出力・キャッシュ入力・その他の課金条件をMetaの掲示価格とは別に確認してください。2026年10月16日時点でWonder FullはComing soonと表示されており、これは利用可能なAPIルートでも、価格の見積もりやリリースの確約でもありません。
Cost per Accepted Task
受理される成果物を定義したうえでコストを測定してください。課金されたモデルとツールの総支出(課金対象のリトライやフォールバックを含む)を受理成果物数で割ります。レビュー工数は別に記録するか、明示的な時給を適用します。Fullについては、サブスクリプション枠内で完了した有用な作業も追跡してください。月額料金とトークン単価は異なる単位であり、見出し価格だけを比べてもより安価なワークフローは判定できません。
Muse Wonder vs Muse Wonder Full: Comparison and Selection
Capability and Workload-Based Selection
本番API統合、ドキュメントのバッチ処理、カスタムエージェント、再現性のあるA/BテストにはMuse Wonderを選びましょう。呼び出し可能なAPIと使用量課金により、ワークフローの自動化、ツール動作の検査、回帰テストの実行、受理タスクあたりのコスト測定が可能です。デプロイ制御と再現性が重要な要件であれば、まずここから始めましょう。
Muse Codeでの複雑な対話型リファクタリングやプロフェッショナル分析には、対象サブスクリプションを有している場合にMuse Wonder Fullを選びましょう。公開ベンチマークでの強みから、難易度の高い長時間の課題で候補になります。自分の業務で修正やレビュー時間を削減できるかをテストし、サブスクリプションの許容量がワークロードに適合するか確認してください。
Application and Automation Workflows
Muse WonderはリポジトリのQ&A、スクリプト化されたコードレビュー、ドキュメント抽出、検索ベースのアシスタント、カスタムエージェントに適した選択です。APIアクセスにより、チームはレイテンシのモニタリング、ツール動作のトレース、自動回帰、コスト上限の設定が可能です。
サービスやバッチパイプラインでは、まず対応するWonderのAPIルートを評価してください。アプリケーション側でリクエスト、ツール実行、リトライ、メータリングを明示的に制御できます。タスクがMuse Codeでのみ利用可能な機能に依存する場合は、運用制約が異なる独自の対話型ワークフローとして評価してください。
Interactive Coding and Professional Analysis
Fullは、Muse Codeでの長時間のコーディングセッション、複数ファイルのリファクタリング、複雑なプロフェッショナル分析の評価に値します。いくつかの公開ベンチマークで高スコアですが、アクセス制約により、その利点を本番APIアプリケーションに自動的に移せるわけではありません。
代表的なリファクタリング、調査、完成物を用いて、Fullが修正反復やレビュー工数を削減するかを検証しましょう。反復的な業務の依存先にする前に、実際のサブスクリプション許容量を確認してください。自分のタスクで改善が小さい場合は、標準バリアントで受理基準を満たしている可能性があります。
Production Evaluation Criteria
実務的な評価には少なくとも3種類の証拠を収集してください:エンドツーエンドのタスク完了、完成物の品質、リトライや人的レビューを含む総消費工数。総合指数での4ポイント差は、複雑なエージェントには重要でも、単純な分類タスクでは目に見える差を生まないことがあります。
Where Can You Access Muse Wonder and Muse Wonder Full?
Official Provider Access
標準のWonderはMeta Model API、またはMuse Codeから利用します。Fullは対象のMuse Codeサブスクリプションが必要です。標準モデルを最大努力に設定しても、選ばれるバリアントは変わりません。テスト前に、アカウントの具体的な資格、サポートされるリクエスト機能、使用制限を確認してください。
CometAPIとの統合は、Muse Code経由のWonder Fullへのアクセスとは別物です。Muse Codeのサブスクリプションが、再利用可能な本番API認証情報や無制限スループットを提供するとは限りません。
CometAPI Access
開発者はCometAPIのMuse Wonder APIにアクセスできます。CometAPIのMuse Wonder Full APIは2026年10月16日時点でComing soonと表示されています。この表示は、ローンチ日や呼び出し可能なエンドポイントを確定するものではありません。デプロイ前に、アカウントの価格およびサポートされるフィールドを確認してください。
CometAPIのリクエストでは、選択したルートに記載のモデル識別子を使用してください。マルチステップジョブを開始する前に、サポートされるメッセージ形式、ツールのセマンティクス、状態管理を確認しましょう。検証済みのタスク状態はアプリケーション側で保持し、ルーティング変更によって完了に必要な情報が暗黙に失われないようにしてください。
Conclusion
Muse WonderとMuse Wonder Fullは密接に関連していますが、商用および運用面では異なります。Wonderはアプリケーション構築のための文書化されたマルチモーダル・長コンテキストAPIを提供し、Fullはより高い報告性能を持ちますがアクセスは限定的な対話型に絞られます。総合スコアは有用な証拠として扱い、普遍的な判断基準と見なさないでください。実際にデプロイ可能なバージョンを、自身のタスク、制約、レイテンシ、コストに対してテストしましょう。
FAQ
How should teams compare Muse Wonder API with Full in Muse Code?
同一のリポジトリスナップショット、タスク指示、受理テスト、レビュールーブリックを使用してください。各サーフェスのツールアクセス、推論設定、経過時間、リトライ、人的介入を記録します。結果はワークフロー比較として扱ってください。APIエージェントとMuse Codeでは、提供ツールや実行ループが異なる場合があり、品質差をモデルの重みだけに自動的に帰することはできません。
What happens when a Muse Wonder Full subscription reaches its limit?
Metaのサブスクリプション規約は、上限到達後はアップグレードするかリフレッシュを待つことを求めています。Maximum Usage加入者はリセットまで待機する必要があります。追加のAPIキーは従量課金で別途課金され、Fullは公開Model APIでは提供されていません。サブスクリプションが無制限のスループットを提供すると仮定せず、アカウントの実際の許容量に合わせて対話型作業を計画してください。
Can Muse Wonder API persist business records across independent requests?
ファミリーレベルのメモリ機能を、アプリケーションのデータストアの代替として使用しないでください。タスクに永続的な記録が必要な場合は、明示的に保存し、関連資料を取得して、サポートされるリクエストインターフェースを通じて渡してください。実際のプロバイダールートで隔離、保持、検索の動作をテストしましょう。モデルのコンテキスト容量だけでは、リクエスト間の永続性は確立されません。
How should teams estimate the cost of a Muse Wonder agent task?
ツールループ全体にわたり、失敗やリトライを含む入力、キャッシュ入力、出力の使用量を測定します。ツール料金と人的レビュー時間を加え、受理成果物あたりのコストを比較してください。Fullについては、サブスクリプション枠内の完了作業と費やした時間を追跡します。トークン価格と月額サブスクリプション料金は異なる購買単位であり、どちらか一方だけでは安価なワークフローを特定できません。