
要約
OpenAI Decisions API と TypeSafe Jev は、通常の生成テキストではなく、境界付きで確率に裏付けられた意思決定結果を返します。OpenAI は専用エンドポイント経由で GPT-6 Luna を使用し、TypeSafe Jev は特化型の System One モデルです。公開されている入力トークン単価では Jev が安価(100万トークンあたり $0.042 対 $0.10)である一方、OpenAI は画像をネイティブにサポートします。ここで参照するベンダー数値は、精度や速度の直接比較における勝者を示すものではありません。
主要ポイント
- 価格: 公開ベースレートの入力トークン単価で、Jev は 58% 安価。
- アーキテクチャ: OpenAI Decisions API は GPT-6 Luna を使用、Jev は意思決定処理に特化。
- モダリティ: OpenAI はテキストと画像をサポート、Jev はテキストと構造化入力に注力。
- ベンチマーク: ベンダーの速度主張は基準が異なるため、同一ラベル付きデータセットで比較。
- 選定: アプリ次第で、マルチモーダル対応と OpenAI 連携を優先するか、テキスト特化のスループットとコストを優先。
一目でわかる比較: OpenAI Decisions API vs Jev
以下の概要は、2026年10月12日時点で確認した意思決定エンドポイントと公開ベースレートの比較です。モデルのアクセス、制限、サービス条件は、導入アカウントで検証してください。
| 機能 | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| 提供元 | OpenAI | TypeSafe AI |
| エンジン | GPT-6 Luna | Jev System One |
| エンドポイント | POST /v1/decisions | POST /v1/systemone |
| モデル識別子 | gpt-6-luna | jev-1.13.0 / jev-latest |
| 入力 | Text + images | Text / structured text |
| 質問タイプ | predicate(条件の確率)、choice(カテゴリ)、score(評価基準) | noul(条件の確率)、choice(カテゴリ)、score(レベル) |
| リクエスト内の質問 | name 付き配列 | ID をキーにしたオブジェクト |
| コンテキスト上限 | リンク先の Decisions ガイドには未記載 | 合計 64K;state + 最長の question ≤32K |
| 基本入力コスト / 100万 | USD 0.10 | USD 0.042 |
| 出力トークン費用 | 無料 | 無料 |
| ベンダーの速度表明 | Responses API の約 10× 高速 | エンドツーエンドで 70~500 ms |
| 提供状況 | パブリックベータ | ローンチ告知ではアーリーアクセス;現行のアカウントアクセスを要確認 |
| 明確な優位点 | 画像を用いた意思決定 | 公開されている入力コストが低い |
| 生成的推論/コーディング | 本エンドポイントの出力契約ではない | 本エンドポイントの出力契約ではない |
多くの AI ワークフローは段落ではなく、カテゴリ、確率、スコアを必要とします。サポートチケットの振り分け、エージェントの許可済みアクション選択、審査キューでの不確実入力の特定などが該当します。両プロダクトは、そのような意思決定を API の第一級の出力として扱います。
OpenAI は 2026年10月6日に Decisions API をベータ公開しました(https://developers.openai.com/api/docs/changelog)。GPT-6 Luna のエンドポイントはテキストと画像を受け付けます。Jev は TypeSafe AI の非生成評価に特化した System One モデルで、学習手法は Reinforcement Learning for Calibrated Decisions(RLCD)として説明されています(https://docs.typesafe.ai/introduction/machine-learning-primer)。
表の質問タイプは、共有される 3 つのタスクをカバーします。OpenAI の predicate と Jev の noul は、返金意図や適格性など、ある条件が真である確率を推定します。choice は、ルーティングのために Billing、Technical、Shipping など定義済みカテゴリから選択します。score は、緊急度や優先度のように、入力を評価基準やレベルに照らして評価します。これらは両製品の概要を統合した説明であり、リクエストスキーマや確率の意味づけはプロバイダ固有の取り扱いが必要です。
OpenAI Decisions API と Jev とは?
OpenAI Decisions API と TypeSafe Jev は、オープンエンドなテキスト生成ではなく、構造化された境界付きの出力を返す意思決定特化の AI サービスです。従来の大規模言語モデルが説明や対話応答を生成するのに対し、これらの API はあらかじめ定義した質問を評価し、意思決定、確率、スコアを返します。顧客要望のルーティング、コンテンツ分類、リスク評価、AI エージェントのツール選択など、予測可能な出力と効率的な処理が重要な自動化ワークフローに特に有用です。
OpenAI Decisions API(https://developers.openai.com/api/docs/guides/decisions)は GPT-6 Luna を基盤とし、/v1/decisions エンドポイントで動作します。テキストと画像に対応し、predicate、choice、score の 3 種類の意思決定を提供します。汎用 AI モデルの文脈理解と専用の意思決定インターフェースを組み合わせている点が強みで、マルチモーダルな分類や OpenAI エコシステムとの統合済みアプリに適しています。
TypeSafe Jev(https://docs.typesafe.ai/api)は対照的に、/v1/systemone エンドポイントから利用する特化型の意思決定モデルです。テキストベースの評価に注力し、noul、choice、score の 3 種類の質問タイプを提供します。効率的な推論、構造化された予測、確率のキャリブレーションを重視しており、大規模な分類や自動意思決定のパイプラインに魅力的な選択肢です。両サービスは類似の課題に取り組むものの、アーキテクチャ、入力能力、価格、API 設計の違いは、どちらが特定アプリに適するかに大きく影響します。
モデルのアプローチ、入力上限、適用範囲
比較は、公開ドキュメントの API 挙動と製品ポジショニングに関するものです。OpenAI は GPT-6 Luna を意思決定エンドポイントで公開し、TypeSafe は Jev を特化型の System One モデルとして位置づけています。これらの説明だけでは、精度面の優位や実装の全容は確定しません。
Jev はリクエスト全体で 64K トークンを許容し、state と最長の question の合計に別途 32K の上限があります(https://docs.typesafe.ai/models)。共有入力に加え、質問の手順や評価基準もカウントしてください。OpenAI の Decisions ガイドには、このエンドポイント固有の数値的コンテキスト上限は明記されていません。汎用モデルのコンテキストウィンドウをそのまま適用できると仮定せず、該当する上限を確認してください。
生成的推論やコーディングのベンチマークは、これらの境界付き意思決定エンドポイントの適用範囲外です。説明生成やコード生成が必要な場合は、適切な生成エンドポイントを別途評価してください。基盤となる汎用モデルの結果は、Decisions エンドポイントの性能を保証しません。
精度とレイテンシ
引用したベンダー資料には、精度やレイテンシの直接対決(同一条件)を示すテストはありません。OpenAI の「約 10× 高速」という表現は、Decisions が Responses API と比較した相対値です。TypeSafe はエンドツーエンド 70~500 ms(https://typesafe.ai/blog/introducing-system-one-models-and-jev)を報告し、評価は主に米国西部のノート PC から実施したとしています。
| 指標 | OpenAI Decisions API | Jev | 評価 |
|---|---|---|---|
| 直接対決の精度 | 引用資料に一致条件のテストなし | 引用資料に一致条件のテストなし | 勝者なし |
| 速度 | 相対的なベンダー主張 | 絶対値のベンダー範囲 | 直接比較不可 |
| キャリブレーション | 確率;choice/score に別の confidence | 確率;choice/score の confidence は分布から導出 | 観測キャリブレーション要確認 |
| テキスト分類 | 対応 | 対応 | いずれも有力 |
| 画像分類 | ネイティブ画像対応 | 画像のネイティブ対応なし | OpenAI に分 |
確率のキャリブレーションとレビュー閾値
モデルは高精度でもキャリブレーションが不十分な場合があります。選択クラスに 0.90 の確率を割り当てた予測群では、評価分布上で約 90% が正解であるべきです。定義を確認せずに、confidence と名付けられた API フィールドをこの確率の代替として使わないでください。Jev は Choice の confidence を確率分布から導出します(https://docs.typesafe.ai/confidence):confidence = (p_max − 1/n) / (1 − 1/n)(n は選択肢数)。noul の結果には別個の confidence フィールドはありません。適切な確率から ECE と Brier score を測定し、precision、recall、macro F1 と併せて評価してください。レビュー閾値はラベル付きデータから設定します。
価格と受理された意思決定あたりのコスト
OpenAI は /v1/decisions の入力トークン 100万あたり $0.10(https://developers.openai.com/api/docs/guides/decisions)、Jev は $0.042(https://docs.typesafe.ai/models)としています。いずれも本意思決定サービスでは出力トークンの課金はありません。このベースレートでは、Jev は入力トークン単価で 58% 安価です。OpenAI の地域別プレミアムや長文コンテキストの倍率が適用される場合があり、リトライ、前処理、レビューもワークフローコストに加算されます。
両サービスで各リクエストが 500 の課金対象入力トークンを使うと仮定します。以下は参考計算であり、ベンダーの請求書ではありません。
| 月間決定回数 | 入力トークン | OpenAI コスト | Jev コスト | 差額 |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
受理された正解あたりのコスト =(API 支出 + リトライ支出 + 人手レビュー支出)/ 受理された正解数。トークン単価が低くても、ミスルートやエスカレーションが多ければ相殺され得ます。
従来型の GPT-6 Luna ワークフローでは、CometAPI のモデル料金表(https://www.cometapi.com/models/openai/gpt-6-luna/#pricing)が、2026年10月12日時点で以下の USD レート(100万トークンあたり)を掲示しています。これはモデル・エンドポイントのレートであり、リンクページは Responses API の例を示しているだけで、/v1/decisions のネイティブ対応やその料金を保証するものではありません。
| 公開ティア | 入力 / 100万トークン | 出力 / 100万トークン |
|---|---|---|
| ショートコンテキスト(ページ条件:≤272,000 tokens) | $0.08 | $0.40 |
| ロングコンテキスト(ページ記載通り) | $0.16 | $0.60 |
CometAPI の通常の GPT-6 Luna では出力トークンに課金があります。これは上記 2 つの意思決定サービス(出力トークン無料)とは分けて考えてください。たとえば、ショートコンテキストで入力 500 トークン + 出力 20 トークンの場合、1 リクエストあたり $0.000048、すなわち 100万リクエストで $48 となります。予算化の前に、ライブのモデルカタログ(https://www.cometapi.com/models/openai/gpt-6-luna/)で該当ティアとアカウントレートを確認してください。
エージェントワークフローとモダリティのトレードオフ
両者とも、ツール呼び出しのルーティング、ガード条件の充足可否評価、アクションのスコアリングが可能です。いずれも認可、入力バリデーション、明示的なツール権限の代替にはなりません。ビジュアル自動化では、OpenAI のネイティブ画像対応がパイプラインを簡素化します。テキスト中心のルーティングでは、Jev の低いベースコストが魅力的です。
応答境界での出力の扱いは異なります。OpenAI は answers array を返し、name で質問を識別します。Jev は answers object を質問 ID をキーにして返します。共有の業務ルールを適用する前に、これらの構造を正規化してください。Jev は confidence を確率分布から導出します(https://docs.typesafe.ai/confidence)。同名のフィールドであっても、プロバイダ間で同じ意味とは限りません。アプリケーションデータでラベルを検証し、レビュー閾値をキャリブレーションしてください。
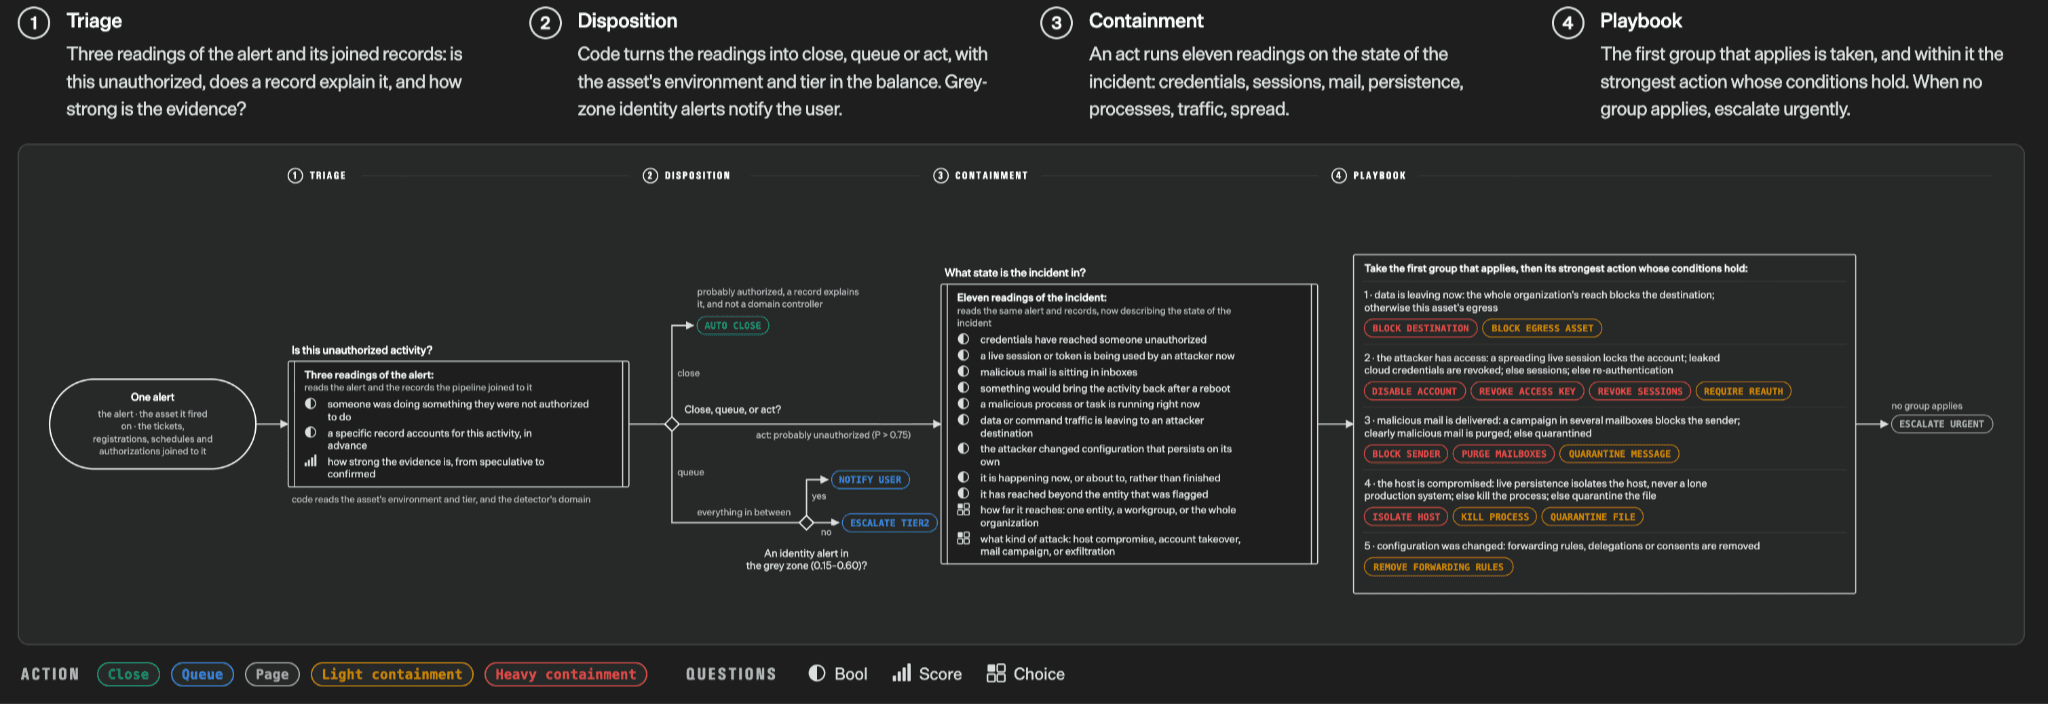
出典: Introducing System One Models & Jev(https://typesafe.ai/blog/introducing-system-one-models-and-jev);original image(https://framerusercontent.com/images/ih1bFwZGYJxlnijbTuXx3f9NeM.png)。これはワークフロー構成の概念図であり、OpenAI Decisions API とのベンチマークではありません。

API 利用の違い: OpenAI Decisions API vs Jev
各プロバイダでアクセストークン等の設定が別々に必要です。以下の例はそれぞれ固有のホストと API キーを使用します。OpenAI は Decisions をパブリックベータのエンドポイントとして文書化しています(https://developers.openai.com/api/docs/guides/decisions)。Jev の場合、導入前に TypeSafe と現在のアクセス権・資格情報を確認してください。いずれのサービスも、アカウント権限、地域提供、クオータ、利用規約を検証してください。生成モデルへのサードパーティ経由のアクセスがあっても、ネイティブの意思決定エンドポイント対応を自動的に保証するものではありません。
OpenAI Decisions API の使い方
概念は重なるものの、リクエストスキーマは異なります。OpenAI は input と name 付きの questions 配列を送信し、Jev は state と question ID をキーにした questions オブジェクトを使用します(https://docs.typesafe.ai/api)。共有の意思決定ポリシーを適用する前に、プロバイダ固有のアダプタを実装してください。
OpenAI Decisions API でサポートチケットをルーティングします。
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Jev API の使い方
次の cURL リクエストは、Jev の System One エンドポイント(https://docs.typesafe.ai/api)を使ってサポートチケットを分類します。環境変数に TYPESAFE_API_KEY を設定し、state にチケット本文を置き、questions オブジェクト内に department を定義します。criteria マップに許可されたルーティングラベルとその説明を列挙します。リクエスト成功後、answers の department 項目を読み取り、選択されたラベルを検証してからチケットをルーティングしてください。モデル識別子がアカウントで利用可能か確認してください。
TypeSafe Jev でサポートチケットをルーティングします。
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| 連携要素 | OpenAI | Jev |
|---|---|---|
| 入力 | input | state |
| 質問 | Array | Keyed object |
| 質問 ID | name | Object key |
| 二値質問 | predicate | noul |
| 選択肢 | choices | criteria |
| 回答の形 | answers array | answers object |
選択クラス確率に対する共通レビュー方針
選択クラス確率に、明示的にキャリブレーションした閾値を適用します。
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
この Python 3.10+ の例はアプリケーションのポリシーレイヤであり、API 応答のパーサではありません。各プロバイダのアダプタは、応答を検証し、選択クラス確率を抽出する必要があります。Jev の生の confidence フィールドを selected_probability として渡さないでください。プロバイダ・質問・評価データセットごとにキャリブレーションした閾値を与え、拒否や通信エラーはポリシー呼び出し前に処理してください。
OpenAI Decisions API vs Jev: 選び方
2 段階で選定します。まず、画像入力、アカウントアクセス、入力上限、統合工数などの導入要件でふるいにかけます。次に、適格なサービスを同一のラベル付きワークロードでベンチマークします。テキストのみのルーティングでは、Jev の低い公開入力単価が総コスト削減につながるか検証し、画像依存の意思決定では OpenAI のネイティブ画像経路を評価してください。ミスルート、キャリブレーション、テールレイテンシ、リトライ、人手レビューを、合意した品質目標のもとで比較します。以下の表は初期候補のショートリストであり、総合性能の優劣を示す証拠ではありません。
| ユースケース | OpenAI Decisions API | Jev | 実務的推奨 |
|---|---|---|---|
| サポート振り分け | 対応 | 対応 | コスト重視なら Jev から検証 |
| テキスト分類 | 対応 | 対応 | キャリブレーション比較 |
| スクリーンショット検査 | ネイティブ対応 | 画像前処理が必要 | OpenAI |
| エージェントのツール選択 | 対応 | 対応 | エンドツーエンドの成果で比較 |
| マルチモーダルモデレーション | テキスト+画像 | テキストのみ | OpenAI |
| 既存の OpenAI スタック | ネイティブ | 新規統合 | OpenAI |
サポート振り分けやテキスト分類などの大規模業務自動化では、入力コストとスループットを重視する場合に Jev の優先検討価値が高いです。スクリーンショット検査、ビジュアルモデレーション、画像ベースの意思決定などマルチモーダル用途では、OpenAI Decisions API のネイティブ画像対応が実務的です。AI エージェントやエンタープライズワークフローでは、既存インフラ、統合の複雑さ、誤判断の影響次第です。既に OpenAI エコシステムを使っているチームには OpenAI がスムーズな選択肢となり、テキスト中心で大規模なワークロードには Jev の検討余地があります。いずれのシナリオでも、見出しの価格だけでなく、同一アプリデータでのラベル品質、確率キャリブレーション、レイテンシ、総運用コストに基づいて最終判断してください。
OpenAI Decisions API と Jev をどうベンチマークすべきか?
同一の実データに基づくラベル付き入力で両サービスを走らせ、質問定義とクライアント地域を一致させます。精度、macro F1、ECE、Brier score、p50/p95/p99 レイテンシ、タイムアウト、拒否率、レビュー率、受理された正解あたりのドルコストを追跡します。
| 次元 | 推奨指標 | 重要な理由 |
|---|---|---|
| 分類 | Accuracy、Precision、Recall、Macro F1 | ラベル品質 |
| キャリブレーション | ECE、Brier score | 確率の信頼性 |
| レイテンシ | p50 / p95 / p99 | 運用上の応答性 |
| 信頼性 | 429 / タイムアウト / 拒否率 | 本番での挙動 |
| 経済性 | 受理された正解あたりのコスト | 実際の運用費用 |
推奨手順: 代表的なラベル付きデータセットを構築し、曖昧なケースや分布外ケースも含める。同義のタスクを送信し、分散を測るのに十分な回数を繰り返す。各システムの閾値を独立にキャリブレーションする。エスカレーションやリトライを含むエンドツーエンドのコストで比較する。
結論
意思決定が画像証拠に依存する場合、または既存の OpenAI 連携で導入作業が軽減される場合は OpenAI Decisions API を選びましょう。テキストのみの意思決定ワークロードでは、公開されている入力トークン単価の低さから Jev の評価価値が高いです。選択は、同一アプリデータでのラベル品質、確率キャリブレーション、テールレイテンシ、レビュー負荷、総運用コストに基づいて行ってください。
Jev は公開ベースの入力トークン単価が低く、OpenAI Decisions API は画像入力をネイティブにサポートします。引用したベンダー数値は、精度や速度の総合的な勝者を示すものではありません。最適な選択は、ワークフロー全体で「受理された意思決定のコストと品質」に依存します。
開発者は、より広範なマルチモデルワークフローの中で軽量な分類を試作する目的で、CometAPI の GPT-6 Luna API(https://www.cometapi.com/models/openai/gpt-6-luna/)を利用できます。リンク先のモデルページは Responses API の例を示しています。これは /v1/decisions の専用エンドポイントへの対応を保証するものではありません。これは従来型のテキスト生成プロトタイプであり、Decisions のネイティブな answers スキーマやキャリブレーション済みのクラス確率分布は返しません。返されたラベルが許可カテゴリに一致するか検証し、API エラーを処理してから下流アクションへ接続してください。/v1/decisions のネイティブ対応が必要な場合は別途確認してください。