TL;DR: Alibaba は 2026年11月16日に、Qwen4 世代のフラッグシップモデルとして Qwen4-Max を公開しました。公式評価では、業務タスクでの性能が向上し、Qwen3.8-Max より実行コストが低いことが報告されており、トークン効率の改善と API 価格の引き下げが反映されています。
主なポイント
- モデル規模: Qwen4-Max はバックボーンパラメータ 2.4兆、トークンあたり 710億 のアクティブ化パラメータ。
- コンテキストウィンドウ: Qwen4-Max は 100万トークンのコンテキストウィンドウに対応。
- マルチモーダル対応: Qwen4-Max はテキスト・画像・動画を入力として受け取り、テキストを生成。
- 開発者向け機能: Qwen4-Max は Function calling、構造化出力、コンテキストキャッシュ、ウェブ検索に対応。
- アクセス方法: ユーザーは対応する Qwen アプリケーション、従量課金の QwenCloud API、Token Plan サブスクリプションを通じて Qwen4-Max にアクセス可能。
Qwen4-Max とは?
Alibaba の公式発表では、Qwen は Qwen4-Max を、仕事・創作・探索のための AI の同僚として位置付けています。目標の理解、ツールの操作、実行時フィードバックへの応答、複数段階を通じた成果の提供に重点を置いた能力を備えています。
これらのワークフローにおいて、モデルは推論と調整を提供し、接続されたアプリケーションやツール、実行環境が具体的な操作を実施します。
Qwen4-Max の仕様
公式の QwenCloud モデルページでは、以下の仕様が示されています:
| 仕様項目 | Qwen4-Max |
|---|---|
| Model ID | qwen4-max |
| Backbone parameters | 2.4 trillion |
| Activated parameters per token | 71 billion |
| Context window | 1 million tokens |
| Input / output | テキスト・画像・動画 / テキスト |
| Standard mode limits | 最大入力: 991K; 最大出力: 131Kトークン |
| Thinking mode limits | 最大入力: 983K; 最大出力: 262Kトークン |
| Maximum reasoning length | 262K tokens |
| Developer capabilities | Function calling、構造化出力、コンテキストキャッシュ、ウェブ検索 |
| API compatibility | OpenAI と Anthropic の API プロトコル |
コンテキストサイズ、入力制限、出力制限はそれぞれ異なる制約を表します。アプリケーションはこれらを併せて満たし、生成される回答と推論のために十分な容量を確保する必要があります。
Qwen4-Max の主な機能は?
Qwen4-Max の能力は、複数の文書・ツール・実行ステップに跨るタスクで特に有用です。長いコンテキストは作業の背景を保持し、視覚理解は利用可能な証拠を拡張し、エージェント機能はタスクを成果に向けて推進します。
100万トークンのコンテキストとネイティブな視覚理解
大きなコンテキストウィンドウにより、関連資料を共有の作業コンテキスト内で処理できます。実用的な用途には、契約書の比較、複数コードファイルに跨る依存関係の分析、レポートと支援資料を併読しながらのレビューなどがあります。
ネイティブな視覚理解により、スクリーンショット、図表、スキャンページ、動画へと拡張されます。ユーザーは、設計図やインターフェースのスクリーンショットを、文書化された要件と並行して解釈するようモデルに求められます。
文書中心のタスクでは、ファイル名・日付・セクションラベルを保持することが証拠の整理に役立ち、結果の分析検証を容易にします。
コーディングとプロフェッショナルツールの活用
Qwen4-Max は function calling に対応しており、データベース、検索サービス、ファイル操作、業務システムと接続できます。構造化出力は、モデル結果をその後のソフトウェアプロセスに渡すのに役立ちます。
公式デモでは、より広範なソフトウェアワークフローが示されています。ゲーム開発では、モデルが Unity、Unreal Engine、Godot などのエンジンを用いて、シーン構築、ゲームプレイの実装、テストを通じた結果の洗練を行います。Blender では、ジオメトリ、マテリアル、ライティング、レンダリングを調整します。
これらのワークフローを再現するには、関連ソフトウェア、アセット、実行権限が必要です。デモは、その環境内でモデルが達成できることを示しています。
長期タスク向けエージェントと Live Delivery
長いタスクは、完成まで進捗を確認できないと管理が難しくなります。Qwen4-Max の Live Delivery アプローチは、初期の実用的な成果を提示し、その後に連続的なアップデートを行います。
調査課題では、エージェントがまず予備的な所見とソース一覧を提示し、その後分析を拡張してチャートを追加します。ユーザーは各バージョンをレビューして、その後の作業の方向性を修正できます。
Qwen は Qwen-Live-Delivery-Plugin も公開しました。数時間以上に及ぶワークフローでは、段階的な納品が品質レビューと方向修正のための実用的なチェックポイントを生み出します。
アーキテクチャとトークン効率
Qwen4-Max はスパースなエキスパート混合アーキテクチャにいくつかの変更を導入しています:
- Gated DeltaNet と Qwen Sparse Attention: 履歴情報の圧縮と、関連コンテキストへの選択的アテンションを組み合わせ、長いシーケンスの計算を削減します。
- Gated Residual: 4つの並列残差ブランチと動的ゲートを用いて、情報伝達と学習の安定性を改善します。
- N-gram Embedding: ローカルトークンパターンをルックアップ操作で表現するために、埋め込みパラメータ 3,280億 を追加し、比較的低い追加計算で容量を拡張します。
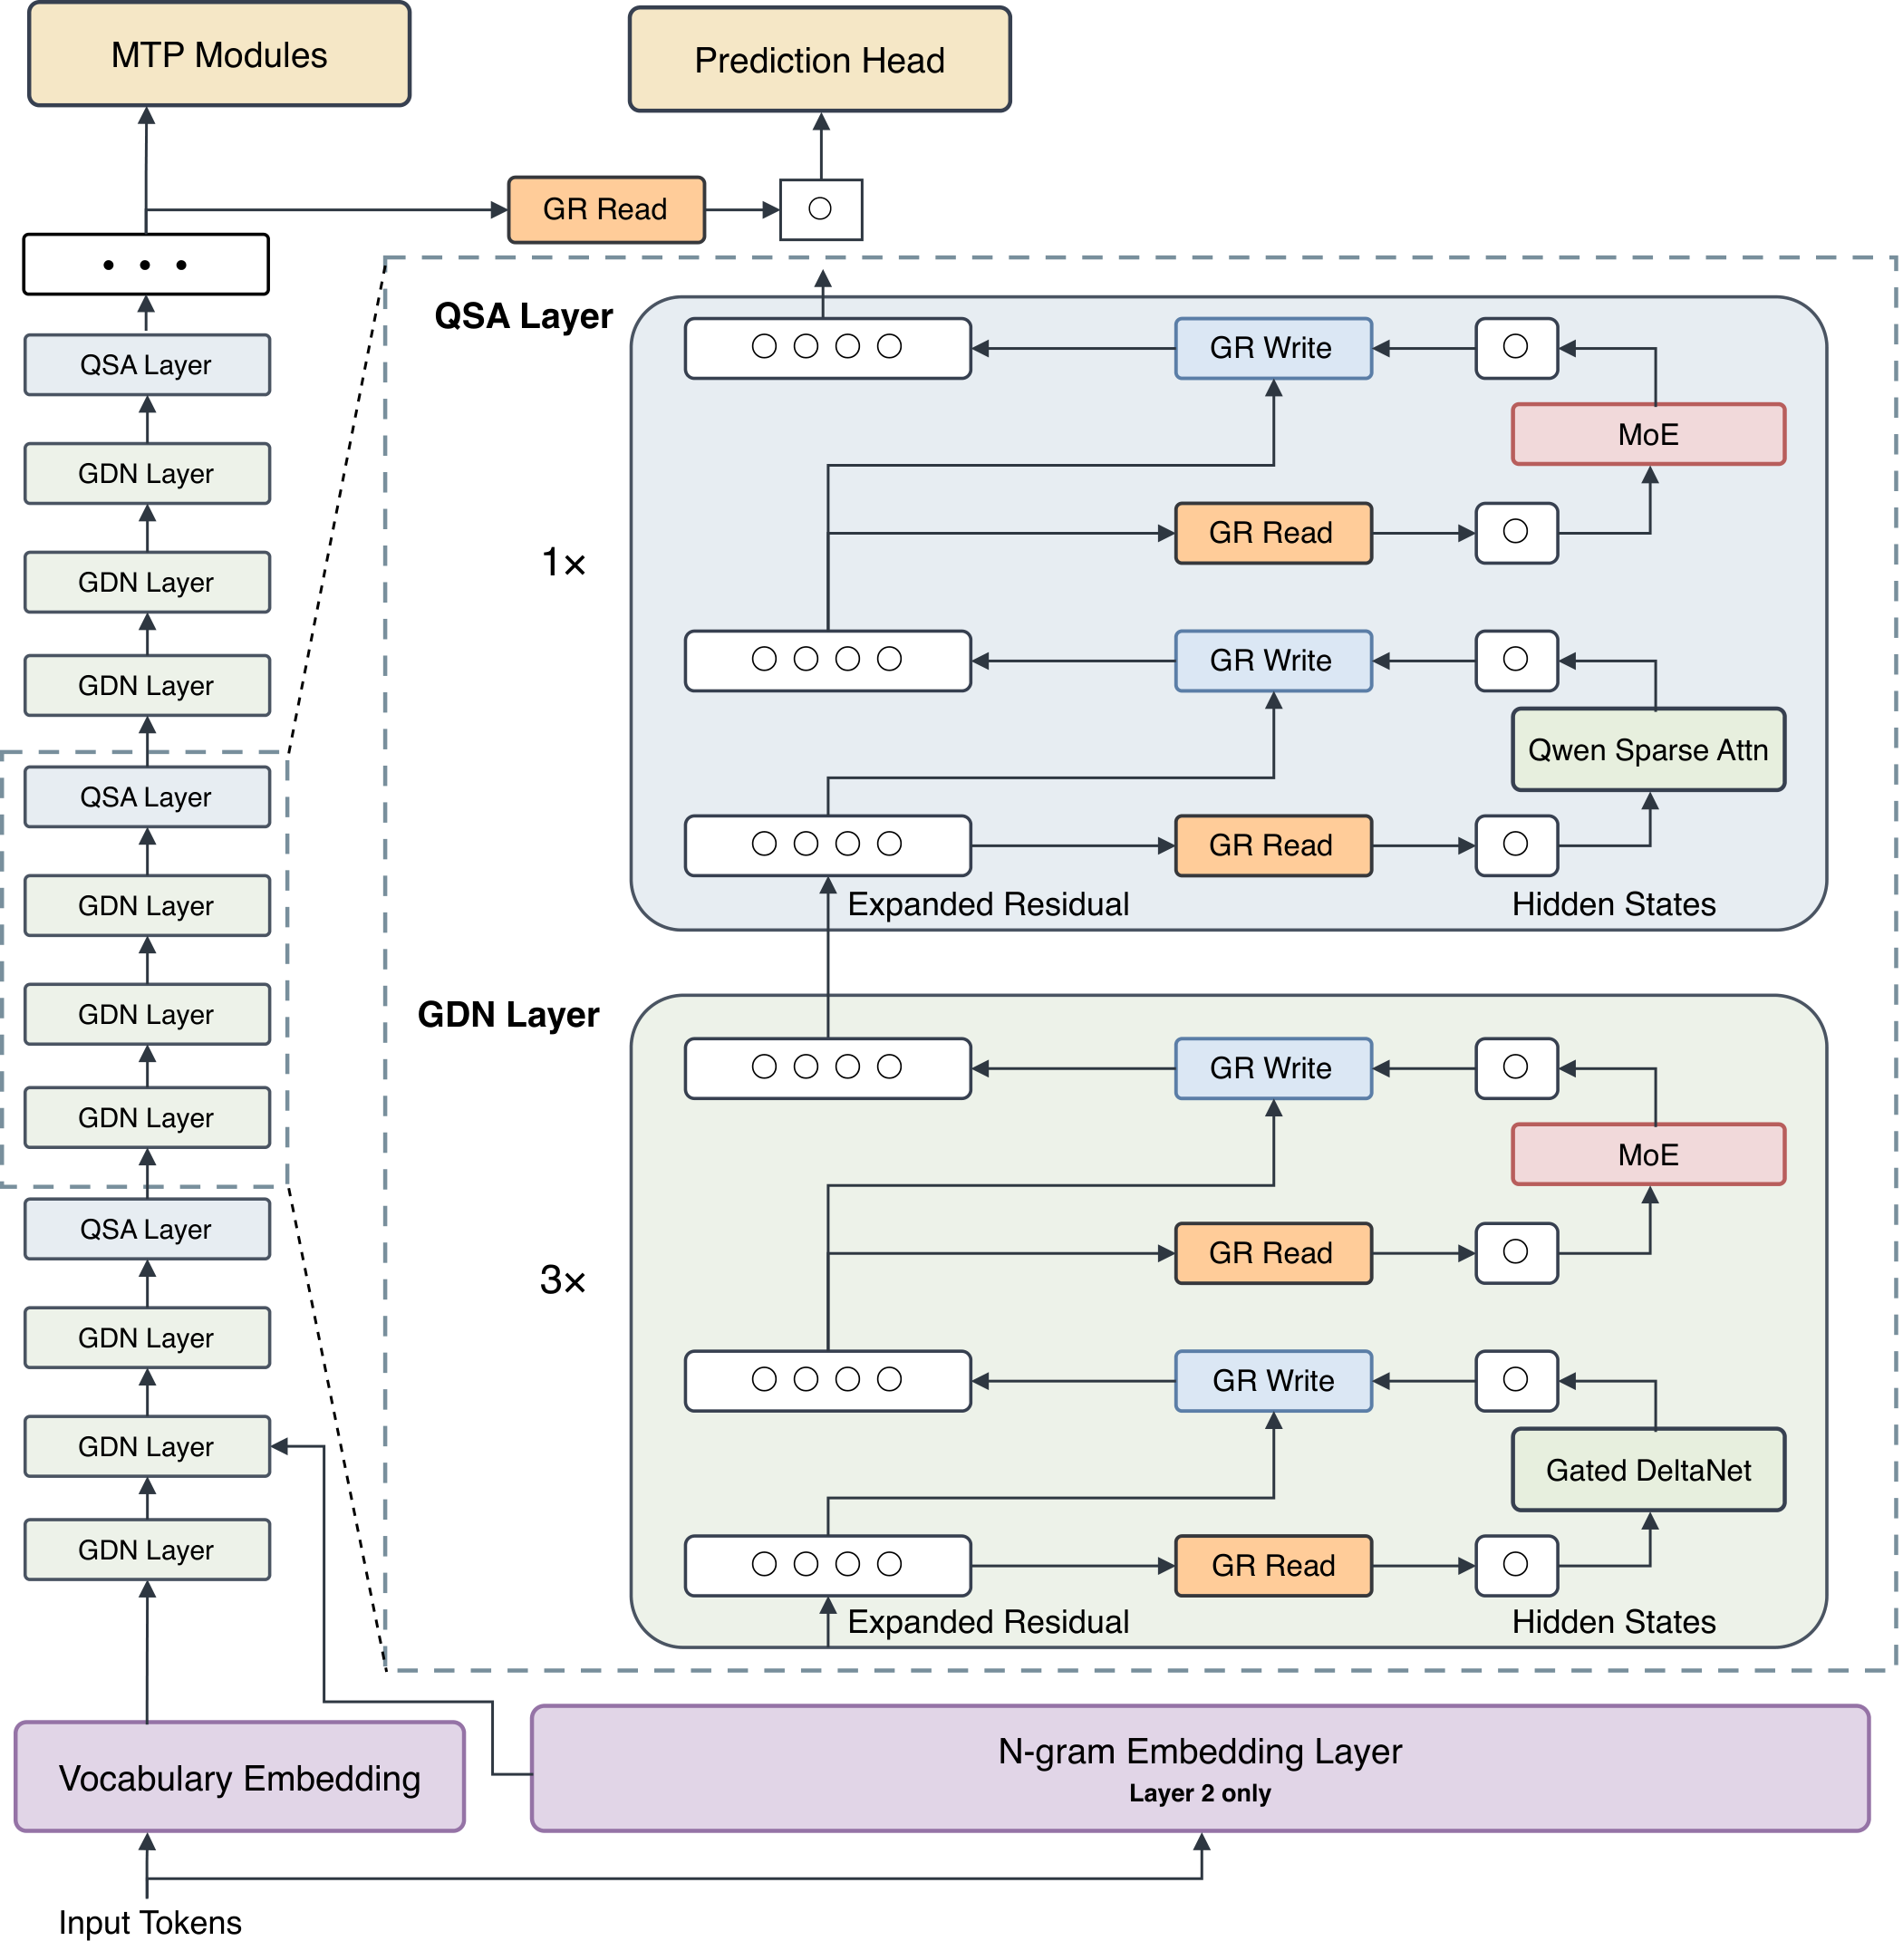
ユーザーにとっての実用的な検証は、これらの変更が、許容できる結果を得るために必要なリソースを削減するかどうかです。Qwen の公開されたトークン消費測定は、評価タスクにおける改善の証拠を提供します。
Qwen4-Max の性能は?公式ベンチマークと事例
Qwen の公開ベンチマークは、タスク性能、トークン消費、実行コストを測定し、デモは実用的なワークフローを示します。
Qwen4-Max のベンチマーク結果
以下の結果は、Qwen4-Max と Qwen3.8-Max を比較したものです:
| 指標 | Qwen4-Max と Qwen3.8-Max の比較 |
|---|---|
| Work360 スコア | 47.74 から 52.69 に上昇 |
| Work360 のトークン消費 | Xhigh で約 24% 減、High で約 35% 減 |
| Terminal-Bench 4.0 のトークン消費 | Xhigh で約 48% 減、High で約 49% 減 |
| 平均 Work360 タスクコスト | RMB 26.58 から RMB 11.16 に低下、約 58% 安価 |
コスト削減は、トークン消費の低下と API 価格の改定の両方を反映しています。
ツール呼び出しを繰り返すアプリケーションでは、トークン単価だけでなく、成功裡に完了したタスク 1 件あたりのコストがより有用な比較指標です。価格が低いリクエストでも、ワークフローが多くの再試行や手作業の修正を要する場合、節約効果は限定的です。
金融リサーチと製造の事例
複数の公式事例は、具体的な成果物と測定可能な結果を提示します。
金融リサーチでは、モデルが市場データツールと検索を組み合わせて、Excel の作業用ワークペーパーと編集可能な PowerPoint レポートを作成します。ソースリンクと整合したチャートにより、レビュー担当者はレポートの所見を支援データに遡って追跡できます。
製造の事例では、モデルがパラメトリックモデリング、ツールパス生成、シミュレーションフィードバックを組み合わせます。あるワークピースに対する人手のプログラミング工数は、約 475分 から 24分 に低減したと報告されています。この結果は、デモでのワークピースとツール環境を記述したものであり、類似プロセスを評価するための有用な出発点を提供します。
結果の解釈方法
Qwen4-Max の Work360 スコアは 47.74 から 52.69 に上昇し、4.95 ポイントの増加です。これは、評価された業務タスク全般での性能向上を示しますが、個々のタスク結果は変動し得ます。トークン消費の削減は、別の効率指標を提供しており、推論設定 High と Xhigh で異なる節約が示されています。
報告された平均 Work360 タスクコストの 58% 低減は、トークン消費の低下と API 価格改定を組み合わせたものです。開発者にとって重要なのは、その節約が、再試行や手作業の修正を経た成功裡のタスク完了にまで反映されるかどうかです。
アプリケーションのデモは、特定のワークフローと成果物に関する追加の証拠を提供します。これらを用いてテストに値するタスクを特定し、同一のツール条件下で、完了品質、レビュー工数、総コストを比較してください。
Qwen4-Max の料金: API コストと Token Plan の選択肢
Qwen4-Max は、従量課金の API 請求と Token Plan サブスクリプションで利用可能です。適切な選択肢は、アプリケーションを構築しているか、対話型の AI ツールを使用しているかによって異なります。
公式の従量課金 API 料金
QwenCloud はシンガポール地域で以下の価格を掲載しています:
| 課金項目 | 100万トークンあたりの価格 |
|---|---|
| Standard input | $1.50 |
| Output | $4.50 |
| Implicit cache input | $0.075 |
| Explicit cache read | $0.075 |
Explicit cache の作成は、5分キャッシュで 100万トークンあたり $1.875、1時間キャッシュで $3.00 のコストがかかります。
キャッシュなしの入力トークン 100,000 と課金対象の出力トークン 10,000 を使用するタスクは、モデルのトークン料金として $0.195 となり、追加の課金対象ツールやサービスは除外されています。
キャッシュされた入力は、標準入力より 95% 低い価格で提供されます。同じ指示、ツール定義、文書のプレフィックスを繰り返し送信するアプリケーションは、キャッシュの活用を改善することで入力コストを削減できます。
Token Plan の仕組み
Token Plan はサブスクリプション課金と Credits の差し引き方式を採用しており、現在は対応モデルに qwen4-max を含みます。
2026年11月17日現在、シンガポール地域のページには以下の個別月額プランが表示されています:
| プラン | 月額料金 | 月間 Credits |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
ページには新規ユーザー向けプロモーション($3 から開始)も掲載されています。適用可否と最終金額はチェックアウト時に表示されます。
Credits はサブスクリプションの課金単位であり、直接のトークン割当ではありません。消費は、適用されるモデルおよびツールのルールに依存します。
Token Plan のドキュメントによれば、このサービスは互換性のある AI ツールでの対話利用を意図しており、現在はシンガポール地域で提供されています。
Qwen4-Max のアクセス方法
実用的な方法は 3 つあります。Qwen 製品を利用する、QwenCloud を通じて直接接続する、互換性のある AI ツールを構成する、のいずれかです。特に資格情報やエンドポイント周りで、セットアップ要件はそれぞれ異なります。
Qwen アプリケーションを利用する
公式発表には、Qwen Studio、Qwen アプリ、QwenWork、Qoder がアクセスチャネルとして記載されています。
これらの製品は、文書分析、コーディング支援、オフィスワークフローのテストを始めるのに便利です。リクエスト、ツール、結果処理を制御する必要がある開発者は、直接の API 統合へ移行できます。
QwenCloud API にアクセスする
Qwen4-Max にアクセスするには、QwenCloud にサインインし、選択した地域の API キーを取得し、モデル ID qwen4-max を用いて対応するエンドポイントを構成します。QwenCloud は OpenAI 互換のアクセスを提供します。プレビューから移行するユーザーは、リクエストパラメータと請求の設定も見直してください。
コーディングおよびエージェントツールの構成
Token Plan のドキュメントは、Qwen Code、Cline、Cursor、OpenCode などのツールに対する統合ガイダンスを提供します。
構成には一般に、専用の API キー、適切な Base URL、モデル名が必要です。Token Plan は別ドメインのエンドポイント token-plan.maas.qwencloudapi.com を使用し、そのキーは従量課金 API のキーと相互に利用できません。
選択したツールのガイドに従い、読み込み資料、操作の実行、結果の確認を含むタスクでセットアップを検証してください。
誰が Qwen4-Max を使うべきか?
Qwen4-Max は、広範なコンテキスト、複数ツール、検証可能な成果物を必要とする定期的なワークフローで評価に値します。
- 開発者 は、複数ファイルに跨るコード変更、フロントエンド開発、外部ツールを用いるエージェントでの評価が可能です。
- オフィス/リサーチチーム は、文書の分析、データの整理、ソースの追跡が可能なレポート作成に活用できます。
- デザイン/コンテンツチーム は、3D モデリング、ゲーム試作、プロ用ソフトウェアに接続した動画ワークフローでのテストが可能です。
- エンタープライズチーム は、定義されたデータアクセス、ツールインターフェース、受け入れ基準を備えた定期プロセスを評価できます。
金融・法務・医療のワークフローでは、証拠処理と分析支援に用い、重要な結論は有資格の専門家がレビューしてください。
FAQ
Qwen4-Max の出力上限は 100万トークンですか?
いいえ。コンテキストウィンドウと最大出力長は別の制限です。QwenCloud では、スタンダードモードの最大出力が 131K トークン、思考モードの最大出力が 262K トークンと記載されています。リクエストは、適用される入力およびコンテキストの制限も満たす必要があります。
Qwen4-Max の API と Token Plan のどちらを選ぶべきですか?
アプリケーションやバックエンドサービスに Qwen4-Max を統合する場合は、従量課金の API を選択してください。Token Plan は互換性のある AI ツールでの対話利用を目的としており、サブスクリプションの Credits を用います。両オプションは、資格情報とエンドポイントが別々です。
Qwen4-Max を無料で使えますか?
公式の API アクセスと Token Plan は有料サービスです。Qwen アプリケーションで提供される無料アクセス(提供がある場合)は、各製品のアカウントと利用規約に従います。これは無料の API 枠を保証するものではありません。
Qwen4-Max をローカルデプロイのためにダウンロードできますか?
2026年11月17日現在、Qwen は Qwen4-Max のオープンウェイトを提供していないため、公式リリースではローカルデプロイ用のダウンロード可能なモデルは提供されていません。Qwen は、Qwen4 シリーズの小型モデルを段階的にオープンソース化する計画を発表しています。
結論
Qwen4-Max は、長文書の分析、複雑なコーディング、複数ツールを伴うワークフローに適した有力候補です。公式評価では、報告されたワークロードにおいて Qwen3.8-Max より高いスコアと低いタスクコストが示されています。
受け入れ基準が明確な代表的なタスクから開始してください。出力品質、手動修正時間、実行時間、総コストを比較します。これらの指標での改善は、類似ワークフローへ Qwen4-Max を拡大するための実用的な根拠になります。