
TL;DR
Claude Haiku 5.5 は、Anthropic の標準速度における最速の小型モデルで、高ボリュームかつ低レイテンシーのタスク向けに設計されています。100万トークンのコンテキストウィンドウ、標準出力上限 128K、適応的推論、そしてベース価格は入力 100万トークンあたり $0.10、出力 100万トークンあたり $0.50 から。プロンプトが 100,000 トークンを超えると料金帯が上がります。複雑なコーディングや長期的なエージェント作業には、Sonnet 5.5 や Opus 5.5 が引き続き有力です。CometAPI の Standard 価格は公式レートより 20% 低く、入力 100万トークンあたり $0.08、出力 100万トークンあたり $0.40 から。CometAPI のモデルページは公開済みで、本番 API アクセスを報告しています。
Key Takeaways
- 公式リリース: 2026年10月7日。Claude API のモデル ID: claude-haiku-5-5。
- 開始 API レート: プロンプトが 100K トークン以下の場合、入力 $0.10、出力 $0.50(いずれも 100万トークンあたり)。CometAPI は公式 Standard 価格の 80%(入力 $0.08、出力 $0.40)。
- コンテキストと出力: コンテキスト 1M トークン、標準出力 128K トークン。
- フォーカス領域: 分類、ドキュメント抽出、ルーティング、サポート、委譲型エージェントタスク。
- 新しいトークナイザは同一テキストで約 30% 多くトークンを数える場合あり。トークン単価だけでなく、受理タスクあたりのコストで評価を。
What Is Claude Haiku 5.5?
Claude Haiku 5.5 は、応答性と運用コストを重視した大規模リクエスト向けに設計された、Anthropic の現行 Claude ファミリーの軽量モデルです。主な用途は、ドキュメント処理、会話型サポート、情報抽出、コンパクトなサブエージェント業務など。Anthropic のモデル概要は、ローンチ日、機能、プラットフォーム識別子を確認しています。
Claude Haiku 5.5 は、Haiku シリーズで初めて努力レベル(effort)の設定をサポートし、同一モデル内で推論深度・レイテンシー・トークン使用量のトレードオフを開発者が調整できます。
What Are the Key Features of Claude Haiku 5.5?
適応的思考と調整可能な effort
Haiku 5.5 は、いつ・どの程度推論するかを自律的に判断できます。加えて、effort パラメータにより、応答品質・レイテンシー・トークン使用量のバランスを開発者が制御可能です。デフォルトの effort は medium。単純な分類には low が適し、曖昧な抽出やツール計画のステップにはより高い設定が妥当な場合があります。
大規模コンテキスト処理
100万トークンのコンテキストウィンドウにより、長い文書や大きな会話履歴を単一リクエストに収められます。ただし、適切な場面では依然として検索(RAG)、切り詰め、キャッシュを活用すべきです。長大なコンテキストは、特に 100K の価格しきい値を超える領域では、不要なコストや精度トレードオフを生む可能性があります。
低コスト・高スループット処理
新しい $0.10/$0.50 の開始レートは、短いリクエストの反復を先代 Haiku よりトークン単価ベースで大幅に安価にします。一方で、Anthropic はトークナイザの変更を文書化しており、同一テキストが Haiku 4.5 比で約 30% 多いトークンになる可能性があります。したがって、実務のタスク単位での実際の節約幅は、見出しのレート低下ほど大きくない場合があります。
コンピュータ操作と委譲型エージェントタスク
公開評価では、コンピュータインタラクションやツール併用タスクで前世代の Haiku を上回る性能が示されています。これにより、Haiku 5.5 は限定範囲のエージェントステップに有用ですが、成功する自動化は、強固なツール権限、エラー復旧、人間によるリスキーな操作の承認に引き続き依存します。
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic は、プロフェッショナル知識タスク、コンピュータ操作、コーディング、推論において顕著な向上を報告しています。以下の結果は報告された評価設定に基づくものであり、異なるベンチマークのスコアを単一の「知能スコア」に統合すべきではありません。
| ベンチマーク | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1(オフラインサブセット、部分点) | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam(ツールなし) | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam(ツールあり) | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography(ツールなし) | 6.4% | 46.4% | 61.6% |
システムカードにおける標準の Haiku 5.5 評価設定は、最大 effort の適応的思考、デフォルトサンプリング、特記なき場合は 5 試行です。製品デフォルトは medium であり、見出しのスコアはデフォルト設定の保証ではありません。OSWorld は 82 のオフラインタスク、インターネットなし、1080p、500 アクション上限を用います。72.4% は部分点スコアで、厳密合格率は 37.1% です。GDPval-AA と AA-Briefcase は、Anthropic が独立実施の Artificial Analysis 評価から報告しています。
Terminal-Bench 4.0 は、セーフガード有効の Claude Code を --bare モードで使用。Haiku 5.5 は最大 effort、フォールバックモデルなし、インターネット egress なし、各タスク 10 試行。Sonnet 5.5 は 5 試行で、一部のフラグ付きリクエストでフォールバックを使用。Haiku 4.5 は固定 63,999 トークンの思考予算を使用。これらの設定差は、39.2% と 70.6% の解釈に影響します。
Anthropic の公開ベンチマーク結果は上記スコアを提供します。OSWorld はオフラインサブセットを使用し、Humanity's Last Exam はツール有無を分け、Chartography はツールなしです。これらはベンダー報告の結果であり、普遍的な共通設定による独立測定ではありません。Anthropic はHaiku 5.5 システムカードで評価詳細を提供しています。比較の前に、該当する effort、ツール、スキャフォールド、予算設定を再現してください。ローンチ概要は、各行に対して完全に共通のテスト環境を特定してはいません。
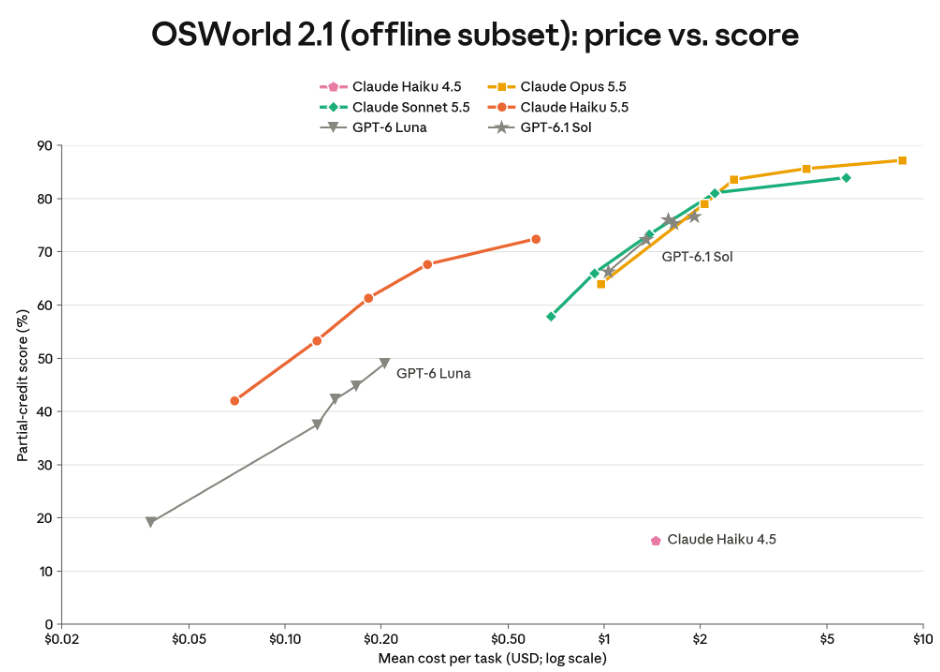
上の Anthropic 公式の評価グラフィックはシステムカードから再掲したものです。評価設定に関する補足証拠を提供するものであり、本記事のために新たに作成したベンチマークではありません。
ベンチマークの解釈
OSWorld の改善は、Haiku 5.5 が構造化されたグラフィカルタスクで有意に有用になったことを示唆します。一方、Terminal-Bench における Sonnet 5.5 の 70.6% と Haiku 5.5 の 39.2% の差は、より大きなモデルによるエージェント型コーディングの優位が続いていることを示します。実際のワークフローの失敗コストと難易度に応じてモデルを選定してください。
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| 項目 | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| コンテキスト | 200K | 1M | 1M |
| 標準出力の最大値 | 64K | 128K | 128K |
| 標準入力 / MTok | $1 | 〜100K は $0.10;超過は $0.50 | $2 |
| 標準出力 / MTok | $5 | 〜100K は $0.50;超過は $2.50 | $10 |
| 推論 | 固定トークン予算の拡張思考 | 適応型;デフォルトは medium | 適応型;デフォルトは high |
| 相対レイテンシー | 高速 | 標準速度で最速 | 高速 |
| コーディングの深さ | 限定的なタスク | より強力なサブエージェント | より複雑なコーディング |
| 主な用途 | レガシー小型モデルのデプロイ | 高ボリュームのワークフロー | 複雑な本番ワークフロー |
共通仕様: 3 モデルともテキストと画像の入力を受け付け、テキスト出力を生成します。Claude API およびサポートされるパートナープラットフォームからのアクセスが可能で、モデル識別子やアカウントアクセスはプロバイダに依存します。引用した製品ドキュメントは、パラメータ数や詳細アーキテクチャを確定するものではありません。
Haiku 5.5 は、検証可能で反復的なタスクの第一候補として妥当です。繰り返しの失敗呼び出し、ツールのリトライ、人手による修正を減らせる場面では、Sonnet 5.5 が全体経済性で有利になることがあります。特に要求の厳しい多段ステップの課題には Opus 5.5 も選択肢です。
相対レイテンシーの比較は標準速度モードに基づきます。Anthropic の速度に関する但し書きは、最速モデルの主張から Opus Fast Mode を除外しています。パラメータ数などのアーキテクチャ詳細は、これらの製品ティアからは確定しません。テキスト+画像入力とテキスト出力は、画像生成とは別物です。
能力比較は、Anthropic のモデル仕様に従います。プラットフォームアクセスは選択したプロバイダとアカウントに依存し、モデルティアは公開パラメータ数を意味しません。
ワークロード選定
| ワークロード | 実用上のデフォルト | 理由 |
|---|---|---|
| メール分類 | Haiku 5.5 | 短く反復的で検証可能な判断 |
| ドキュメントのフィールド抽出 | Haiku 5.5 | 構造化処理を低コストで |
| サポートのトリアージ | Haiku 5.5 | 迅速な応答とエスカレーション |
| コーディング用サブエージェント | Haiku 5.5 | 低コストなファイル検索と限定的な編集 |
| 複雑なデバッグ | Sonnet 5.5 | コーディング系ベンチマークでの高性能 |
| 高リスクな多段推論 | Opus 5.5 | 上位モデルのより高い能力 |
| 混在ワークロード | Haiku + Sonnet | 複雑度と信頼度に応じたルーティング |
How Much Does Claude Haiku 5.5 Cost?
なぜトークン価格は 90% 低下しているのに、「約 75% 安価」と宣伝されているのですか?
90% は、100,000 トークンまでのプロンプトに対する Standard 入出力レートの低下を指します。より長いプロンプトは 50% の低下になります。Anthropic は、リクエスト長の構成やタスクあたりのトークン使用変化を考慮した平均運用コストで、Haiku 5.5 が約 75% 安価になると報告しています。トークナイゼーションも一因で、同一の入力テキストが約 30% 多いトークンとして数えられることがあります。したがって、コスト見積りは新モデルで計測したカウントを使用してください。
Anthropic の公式価格表には 2 つのプロンプト長帯があります。以下の表は、100万トークンあたりの公式 USD 価格です。下の CometAPI の比較では、公式 Standard 入出力レートに 0.8 を掛けています。
| レート区分 | 100K トークン以下 | 100K トークン超 |
|---|---|---|
| 入力 | $0.10 | $0.50 |
| 出力 | $0.50 | $2.50 |
| 5 分キャッシュ書き込み | $0.125 | $0.625 |
| 1 時間キャッシュ書き込み | $0.20 | $1.00 |
| キャッシュ読み出し | $0.01 | $0.05 |
| バッチ入力(50% 引き) | $0.05 | $0.25 |
| バッチ出力(50% 引き) | $0.25 | $1.25 |
上記は 2026年10月8日時点で確認した公式の Standard、キャッシュ、バッチのレートです。料金帯はプロンプト長によって決まり、100K を超えるとリクエスト全体に高い帯が適用されます(超過分だけが高率になるのではありません)。下の CometAPI Standard レートは、対応する公式 Standard レートに 0.8 を掛けたものです。この比較は、ゲートウェイ割引がバッチやキャッシュ割引と重複適用されることを前提としていません。
| プロンプト長 | トークン区分 | 公式 Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| 〜100K トークン | 入力 | $0.10 | $0.08 |
| 〜100K トークン | 出力 | $0.50 | $0.40 |
| 100K トークン超 | 入力 | $0.50 | $0.40 |
| 100K トークン超 | 出力 | $2.50 | $2.00 |
例: 月間 100,000 件の短いリクエスト
各リクエストが 2,000 入力トークンと 500 出力トークンを使用し、各リクエストは 100K のしきい値未満に収まると仮定します。プロンプトキャッシュ、ツール、リトライは無視し、モデル間でのトークン数は同一と仮定します。
| モデル/プロバイダ | 入力/月 | 出力/月 | 合計/月 |
|---|---|---|---|
| Haiku 4.5 — 公式 Standard | $200 | $250 | $450 |
| Haiku 5.5 — 公式 Standard | $20 | $25 | $45 |
| Sonnet 5.5 — 公式 Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
この例では、100,000 リクエストで 2 億入力トークンと 5,000 万出力トークンを使用します。CometAPI の入力コストは 200 × $0.08 = $16、出力コストは 50 × $0.40 = $20、合計 $36/月で、公式の $45 に対して $9 の節約(20%)です。本シナリオはキャッシュ、ツール、リトライを除外し、固定トークン数を用いています。新トークナイザによりトークン数が変わるため、代表入力に基づく受理タスクあたりのコストを測定してください。
$450 から $45 への比較は、固定トークンの例に基づく 90% レート低下の説明であり、同等の実ワークロードで 90% の節約を約束するものではありません。ローンチ発表では、リクエスト長やトークン使用変化を考慮した平均運用コストで約 75% 低下と報告されています。代表的な入力で再カウントし、完了タスクのコストを測定してから自社の節約を見積もってください。
Where Can You Access Claude Haiku 5.5?
公式アクセスとクラウドプラットフォーム
Anthropic の提供開始のお知らせによれば、Haiku 5.5 は Claude API と、Amazon Web Services、Google Cloud、Microsoft Azure 上のサポートプラットフォームから利用可能です。直接の Claude API モデル ID は claude-haiku-5-5、Amazon Bedrock では anthropic.claude-haiku-5-5。選択したプロバイダが発行する資格情報を使用し、最新のアカウント要件を確認してください。
CometAPI からのサードパーティーアクセス
CometAPI のモデルページには claude-haiku-5-5 が利用可能と記載され、Standard レートは 100K トークン以下のプロンプトで入力 100万トークンあたり $0.08、出力 100万トークンあたり $0.40 からと、対応する公式レートより 20% 低価です。CometAPI のエンドポイントとリクエスト形式を用い、CometAPI 発行のキーを使用してください。これは Anthropic への直接 API アクセスとは別経路です。提供状況、料金帯、連携詳細はライブページを確認してください。
プロバイダ切替や Haiku 4.5 からのアップグレード時は、モデル ID の確認、トークン再カウント、応答上限や会話ハンドリングのテストを実施してください。実装詳細や互換性の変化については、Anthropic の移行ガイドを参照してください。
移行検証
- モデル ID を更新し、エンドポイント固有のリクエストフィールドを検証する。
- 安定プレフィックスやツール定義を含め、新トークナイザでトークンを再カウントする。
- 適応的思考の設定、レイテンシー分布、応答ブロックのパースをテストする。
- ツール呼び出し、失敗時の復旧、保存済み思考ブロックのアカウント制限を確認する。
- p50/p95 レイテンシー、受理タスク率、課金対象トークン総数を比較する。
- 重要ワークフローは段階的ロールアウトとロールバック経路を用意する。
- Assistant prefill は禁止
Haiku 5.5 移行ガイドは、トークナイザの挙動、ID、リクエスト互換性を説明しています。temperature、top_p、top_k は指定しないでください。明示的に指定する場合、temperature は 1、top_p は 0.99 でなければなりません。任意の top_k の指定、または temperature と top_p を同時に指定すると 400 error になります。
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 は大型モデルの普遍的な代替ではありません。複雑なコーディングや長期的推論は、Sonnet や Opus の有意な差別化要因のままです。長いプロンプトはコストも高くなるため、100万トークンのウィンドウは選択的に使うべきです。適応的推論は生成トークン数とレイテンシーのばらつきを導入します。ベンチマークは、個別の業務ワークフローの保証にはなりません。
リスク感度の高い自動化では、構造化出力の検証、外部ツール権限の限定、監査ログの保持、重要なアクションの事前レビューが必要です。不確実なタスクは、Haiku の低いベーストークン単価だけに頼るのではなく、より強力なモデルにルーティングしてください。
Conclusion
受理基準が明確な高ボリューム処理において、Claude Haiku 5.5 は魅力的なアップグレードです。低い導入価格、拡大したコンテキスト、適応的推論、より強い公開評価が揃っています。一方、複雑なプログラミングや曖昧な意思決定では、Sonnet 5.5 や Opus 5.5 がリトライや修正を減らして総合的な経済性で上回る場合があります。勝ち筋は、ワークフロー全体をベンチマークし、難易度に応じてリクエストをルーティングすることです。
FAQ
100K の価格しきい値はキャッシュを使うワークフローにどう影響しますか?
料金帯はプロンプト長で決まります。新規テキストだけの量で課金を見積もったり、超過分だけが高率になると仮定したりしないでください。選択モデルでのリクエスト(履歴やツール定義を含む)をカウントし、入力・キャッシュ書き込み・キャッシュ読み出し・出力の使用量を該当帯で整合させます。本番予算設定の前に、代表的なキャッシュ付きリクエストの請求を比較してください。
Haiku 5.5 の thinking ブロックはアカウント間で再生できますか?
thinking ブロックは、それを生成したアカウント、またはそれにリンクされたアカウントでのみ機能します。無関係なアカウントが保存済み thinking ブロックを送信すると、モデルが参照する前に API がそれを破棄します。リクエスト自体はそのまま成功し得ます。公式移行ガイドを参照してください。会話ブロックは保存し、ツールワークフローを継続する際は発行元またはリンク済みアカウントを使用します。ゲートウェイやアカウントの変更は明示的にテストしてください。モデル名が一致しても、保存済み thinking ブロックが引き続き利用可能である保証にはなりません。
Haiku 4.5 で完了していた応答が、Haiku 5.5 で切り詰められるのはなぜですか?
新しいトークナイザは同一テキストでより多くのトークンを数えることがあり、max_tokens を不変にすると実質的な出力許容量が減る可能性があります。適応的思考が出力予算を消費することもあります。stop_reason と usage を確認し、新モデルでプロンプトを再カウントし、実タスクに基づいて出力許容量を再調整してください。
Haiku 5.5 のルーティングしきい値はどう選べばよいですか?
実ワークロードからラベル付きサンプルを用い、受理タスク率、修正コスト、レイテンシーを測定します。明示的な検証に失敗する、またはテストしたタスク範囲を超えるリクエストは、より強力なモデルにルーティングしてください。リトライやエスカレーションを含むワークフロー総コストに対してしきい値を調整し、プロンプト・ツール・effort の変更後は監視を継続します。