
TL;DR
Muse Ember は、ルーティング、抽出、ツール呼び出し、フォーカスしたコーディングなど、高頻度のエージェントタスク向けに構築された Meta 最小のマルチモーダル推論モデルです。Meta は 2026年11月9日に Muse Ember を発表しました。
1,048,576 トークンのコンテキストウィンドウ は大規模なソース素材を収容できます。Meta は Model API と Muse Code 経由のアクセスを提供しており、CometAPI は muse-ember を掲載しています(アクティベーション状況は後述)。検証可能な出力を持つ反復タスクから開始し、推論、ツール、リトライを含む成功結果あたりのコストを比較してください。
Key Takeaways
- Role: Muse Ember は、分類、抽出、ツール呼び出し、限定されたコーディングなど、反復的なエージェント実行のために構築されています。
- Inputs and capacity: Muse Ember はテキスト、画像、音声、動画を受け付け、1M トークンのコンテキストウィンドウと最大 512K の出力トークンを備えています。
- Performance: Meta の結果では複数のエージェント系ベンチマークで Muse Ember が優位でしたが、独立系の分析テストでは低トークン価格が必ずしも最小のタスクコストに繋がらないことが示されています。
- Pricing: 入力トークンが 200K を超えるリクエストは高価格帯に移行します。総タスクコストは推論とツール使用にも依存します。
- Access: Meta Model API と Muse Code が利用可能です。CometAPI の掲載ではモデルは現在 Coming soon と表示されています。
What Is Muse Ember Best Used For?
Muse Ember は、大型モデルが計画を担い、エージェント・ワークフローの実行ステップを担当します。明確な入力、限定されたスコープ、アプリケーション側で検証可能な結果を持つ高頻度タスクに適合します。主な役割は次のとおりです。
- 分類とルーティング: リクエストにラベルを付与し、適切なキューやサービスへ送る。
- 抽出: 文書やメディアを、ソース証拠付きの構造化フィールドへ変換する。
- ツール呼び出し: 関数を選択し、アプリケーションが実行するための引数を提供する。
- バッチ処理: ファイルやレコードにまたがる反復可能な操作を適用する。
Support-Ticket Routing
実用的なサポートのワークフローでは、Ember に注文参照の抽出、カテゴリの割り当て、情報不足のフラグ付けを依頼できます。アプリケーションはルーティング前に自社の記録と参照を照合できます。払い戻しやアカウント変更など重要な操作は、アプリケーション側の認可チェックの背後に維持してください。
Document Extraction with Evidence
請求書や契約の処理では、抽出した値に加えて、それを裏付けるページや該当箇所も要求します。欠落や判読不能なフィールドは、モデルに推測させるのではなく明示的な結果として扱ってください。これにより、レビュアーがすべての文書を読み返さなくても検証できる記録が得られます。
Focused Coding Work
コーディングワーカーには小さな所有範囲を割り当てます: 変更可能なファイル、保持すべき挙動、および完了を定義するテストです。Meta の並列コード移行の例は、この役割分担を示しています。周辺のエージェントがコマンドを実行し結果を検証します。モデルの応答だけでは、変更がテストを通過した証拠にはなりません。
Meta のMuse Ember のローンチビジュアルは、実行モデルと大規模な計画モデルを組み合わせるためのガイドに付随しています。
Meta は、Muse Ember が Muse Wonder Full を用いて学習された最初のモデルであり、より大きなモデルを使って特化モデルを開発する戦略を拡張したものだと述べています。
Muse Ember Specifications
コア仕様は以下のとおりです。
| 仕様 | Muse Ember |
|---|---|
| Developer | Meta Superintelligence Labs |
| Announcement date | November 9, 2026 |
| Model category | Multimodal reasoning and agent execution |
| Context window | 1,048,576 tokens |
| Maximum output | 524,288 tokens |
| Input modalities | Text, images, audio, video |
| File inputs | Supported through the Responses API |
| Output modality | Text |
| Reasoning effort | Minimal, Low, Medium, High, XHigh, Max |
| Default reasoning effort | Max |
| Tool calling | Supported |
| Structured output | Supported |
| Search grounding | Supported through the Model API |
Meta は Muse Ember の重みやパラメータ数を公開していません。リクエストおよびトークン制限はチーム単位で適用され、同一チームのすべての API キーがモデルのアローワンスを共有します。
Context and Multimodal Inputs
PDF ワークフローでは、Meta は最初の 100 ページからテキストを、最初の 50 ページから画像を抽出します。そのため、処理前に長いファイルは分割してください。タスクに必要な素材のみを送信します。推論トークンは最終回答と同じ 524,288 トークンの出力枠を共有します。
レイアウトが重要な場合はスクリーンショット、文書抽出にはスキャン、会議分析には音声、時間経過で事象が展開するケースには動画を使用してください。テキストのみの要約にはトランスクリプトで十分です。ファイルは Responses API を通じてサポートされ、結果はテキストで返されます。
Configurable Reasoning Effort
Muse Ember は 6 段階の推論レベルを提供します: Minimal, Low, Medium, High, XHigh, Max。Meta のデフォルトは Max です。none は未サポートで、HTTP 400 を返します。日常的なルーティングや分類は低いレベルから始め、受け入れ率の改善が余分なレイテンシと出力トークンコストを正当化する場合にのみ引き上げてください。
Tool Calling and Structured Output
Muse Ember はツール呼び出しと構造化出力をサポートします。ツール呼び出しはモデルの意思決定をアプリケーションの関数に接続し、構造化出力は抽出フィールドの検証と次工程への受け渡しを容易にします。
このサポートチケットの例示的な結果は、ルーティングアプリケーションにカテゴリ、優先度、レビュー要否フラグを提供します:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API は検索によるグラウンディングやコンピュータ操作のワークフローもサポートします。接続されたアプリケーションがツールを提供し、アクションを実行し、権限を制御します。
How Does Muse Ember Perform on Benchmarks?
Meta のローンチ結果は最大推論レベルを使用しています。Agents’ Last Exam は Meta 内部評価の Linux サブセットをカバーし、Terminal-Bench は各モデルの公開されている最適ハーネスを用います。外部で報告された Artificial Analysis の結果を Meta 内部評価と組み合わせています。Personal Superintelligence Index は Meta の内部合成であり、独立した別個のリーダーボードではありません。
Muse Ember Benchmark Results
| ベンチマーク | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 は Muse Ember に mini-swe-agent、Haiku 5.5 に Claude Code、GPT-6 Luna に Codex を使用します。これは同一の実行環境ではありません。OSWorld 2.1 は部分点と二値スコアの両方を報告し、PerceptionBench はツールを含みます。Artificial Analysis Intelligence Index の結果は 2026年11月9日に公開されたバージョン 5 に基づきます。
Muse Ember Benchmark Analysis
エージェント実行は Muse Ember の最も強い領域です。
AutomationBench-AA では Muse Ember が 37.8 を記録し、Haiku 5.5 の 13.9、GPT-6 Luna の 20.2 と比較して高いスコアです。これは、Muse Ember をエンドツーエンドの業務ワークフローや反復的なエージェント運用のためのモデルとして位置づける Meta の主張を裏付けます。
コーディング性能は競争力があるが、常に優位とは限りません。
Muse Ember は Terminal-Bench 4.0 で 40.9、Coding Agent Index-AA で 46 を記録します。一方で、FrontierCode 2.0-AA では 27.2 と、Haiku 5.5 の 34.9 を下回ります。これは、Muse Ember が限定されたコーディングサブタスクの有力候補である一方で、より難易度の高いエンジニアリング作業については、より強力な代替案と比較検証すべきことを示唆します。
マルチモーダルおよびコンピュータ操作の結果は有望です。
Muse Ember はツールありの PerceptionBench で 80.6、OSWorld 2.1 の部分点で 69.5 を記録しました。これは、視覚理解やコンピュータ操作を含むワークフローにおける位置づけを支える結果です。
一般知能は Haiku 5.5 と同等です。
Muse Ember と Haiku 5.5 はともに Artificial Analysis Intelligence Index で 36 に丸められ、GPT-6 Luna の 28 を上回ります。選定の際は、その広範な比較に加えて上記のタスク特化の結果も併用してください。
Muse Ember Intelligence vs. Cost Per Task
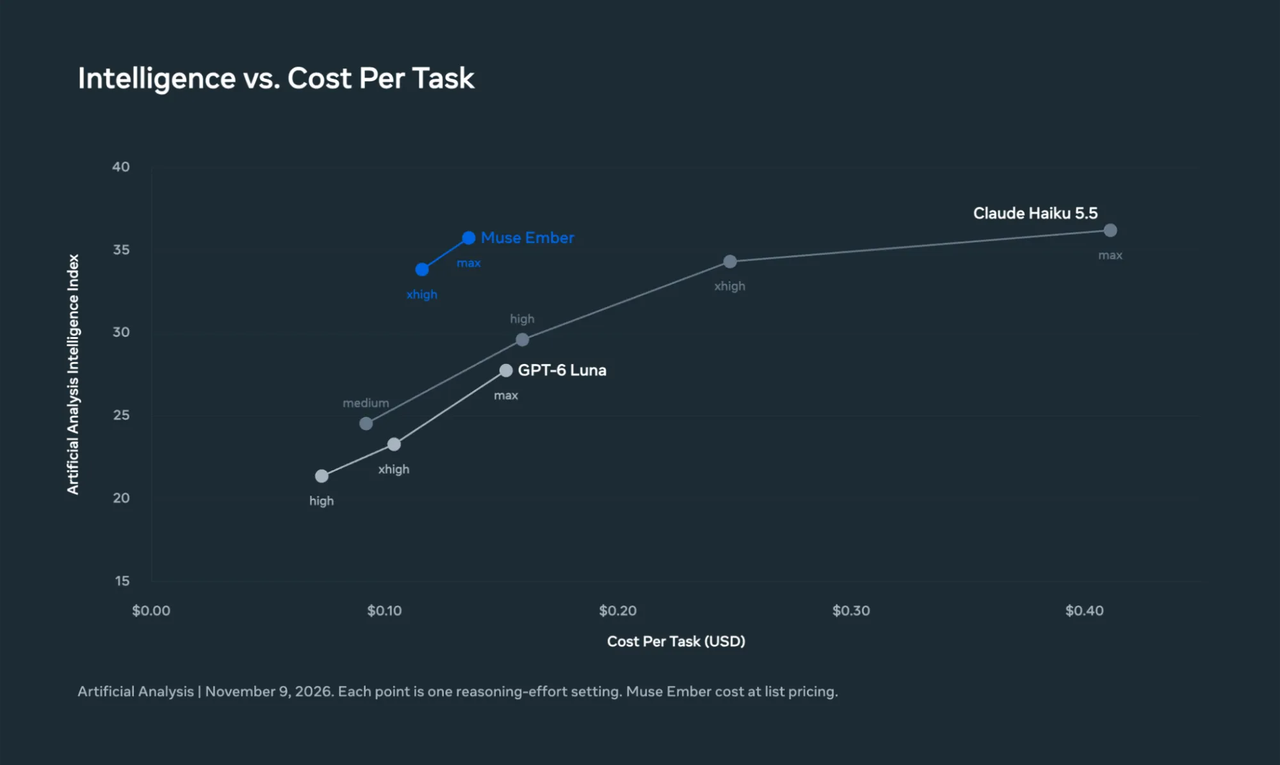
Meta のチャートは、Artificial Analysis Intelligence Index のスコアと、異なる推論レベル設定における推定タスク単価を比較しています。
最大推論レベルでは、Muse Ember は Artificial Analysis Intelligence Index で 35.8 を記録し、推定 $0.136/タスクです。Haiku 5.5 は 36.2 で $0.411、GPT-6 Luna は 27.8 で $0.152 です。このベンチマークでは、Ember は Haiku に近いスコアを約 3 分の 1 のタスクコストで達成し、Luna のスコアをわずかに低いコストで上回ります。
これらの見積もりは、ベンチマークのトークン消費とリスト価格に基づきます。次の評価は、特定のワークフローを選ぶ際になぜツール活動が重要かを示します。
Independent Data-Analysis Results
Plotly の 2026年11月10日のデータ分析評価では、合成風力エネルギーデータセットに対する Plotly Studio Embedded の 43 問をテストしました。Muse Ember は OpenRouter 経由で動作し、報告されたコストは各モデルが実行された時点の価格を使用しています。これは Meta ネイティブ API の課金テストではなく、ワークロード固有の結果です。
| 評価指標 | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Questions passed | 38/43 | 38/43 | 37/43 |
| Full test cost | $1.04 | $0.13 | $0.38 |
| Median time per question | 28 seconds | 18 seconds | 14 seconds |
このデータ分析ワークロードでは、GPT-6 Luna は総コストが 1/8 で、同じ 38/43 の合格数を達成し、中央値の応答時間も短い結果でした。Haiku は 1 問あたり 14 秒で最速、合格数は 37/43 でした。類似のコスト重視の分析ワークフローでは、Luna が有力な出発点であり、Ember の低トークン単価だけでは最安の選択になるとは限らないことが示されました。
Plotly は、隠れたパターンを含む問題で、Muse Ember が平均 78 回のクエリを発行したのに対し、テストしたモデル全体の中央値は 25 回だったと報告しました。追加のツール活動がトークン消費と総コストを増加させました。
また、強みも示されました: Muse Ember は明確に定義された 20 の分析問題、5 つの曖昧な質問、5 つの不可能な要求、3 つのデータ品質チェックのすべてに正答しました。一方で、データ中の隠れたパターンには最も苦戦しました。
Plotly は各モデルを 1 回ずつ実行し、他モデルでは最大 3 問の変動を観測しました。38 対 37 の差は僅差と捉え、ここでの明確な違いはツール使用と総コストであると考えてください。
Muse Ember vs Muse Wonder vs Muse Spark
Muse モデルは、計画、メインのエージェントループ、または反復実行のうち、どの責務を担うかで選択します。
| 次元 | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Primary role | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| Main strength | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| Typical workload | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| API model ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Context window | 1M tokens | 1M tokens | 1M tokens |
| Default reasoning | Max | High | Max |
| Standard input price / 1M | $4.00 | $1.25 | $0.10 |
| Standard output price / 1M | $20.00 | $4.25 | $0.50 |
この表はMeta の Standard モードのトークン価格を用いています。ここでの Ember の価格は 200K 入力トークンまでのリクエストに適用されます。Wonder と Spark には Ember の長文脈プレミアムはありません。
Muse Model Selection
困難な計画、リポジトリ規模のエンジニアリング、長いステップ列にわたる復旧にはWonderを選びましょう。メインのコーディングやエージェントループの実行にはSparkを選びます。ルーティング、抽出、特定ファイルのターゲット変更など、独立に検証可能な出力を持つ反復サブタスクにはEmberを選びます。
例えば、リポジトリ移行では、依存関係の分析を大型モデルに割り当て、狭く定義されたファイル変更を Ember に任せることができます。引き継ぎでは、ファイル名、期待される挙動、受け入れチェックを明示してください。小さなタスクの調整とレビューのコストが、メインモデルで全作業を完了するよりも低い場合にのみ、この分割が有益です。
候補間の選定には、同じ代表タスクを同じ受け入れチェックで実行します。まず、必要な成功率やレイテンシ目標を満たせない構成を除外します。そのうえで、リトライやツール呼び出しを含む総支出を受け入れ結果数で割り、比較します。Ember はそのコストを下げられるタスクタイプに割り当て、未解決のケースは Spark または Wonder にルーティングします。
How Much Does Muse Ember Cost?
この表は、Meta の公式レートと CometAPI による 20% 割引見積もりを組み合わせ、百万トークンあたりの USD を示します。各セルはMeta / 割引見積を表示します。CometAPI の掲載はまだライブ料金を公開していません。予算計画には割引後の数値を利用してください。
| 1M トークンあたりの利用 (Meta / 20%オフ見積) | 200K 入力トークンまで | 200K 入力トークン超 |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Cached input | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
リクエストの総入力トークン(キャッシュされた入力を含む)がティアを決定します。200K 入力トークンを超えるリクエストは、出力を含めリクエスト全体に対して高価格帯が適用されます。Meta の previous_response_id を使用する場合、保存された会話履歴も入力合計に算入されます。
Typical Muse Ember Request Costs
キャッシュなし入力および推論を含む 20K の課金対象出力トークンで、200K 入力のリクエストは Meta のレートで $0.0300、20% 割引シナリオで $0.0240です。入力を 220K に増やすとリクエスト全体が高価格帯に移行し、同じ 20K 出力でも合計はMeta のレートで $0.0960、割引見積で $0.0768になります。これらの例は別途のツール料金を除外しています。関連コンテキストを低価格帯に収めることは、20% の割引以上の節約につながる場合があります。
| シナリオ | 入力トークン | 課金対象出力トークン | Meta コスト | CometAPI コスト |
|---|---|---|---|---|
| Standard request | 200K | 20K | $0.0300 | $0.0240 |
| Long-context request | 220K | 20K | $0.0960 | $0.0768 |
推論トークンは課金対象出力としてカウントされます。Meta ネイティブ API では、ウェブ検索のグラウンディングは 1,000 クエリあたり $2.50 の追加費用が発生し、Ember には Contributor モードのバリアントはありません。上記のトークン価格比較は、別途のツール料金に 20% 割引を適用していません。
How to Access Muse Ember
CometAPI listing: モデルページはモデルを muse-ember と識別していますが、2026年11月16日現在、カタログ上のステータスは Coming soon です。アクティベーションと価格についてはそのページをフォローしてください。現時点でのアクセスには Meta Model API または Muse Code を使用します。
Through Meta Model API: muse-ember-1.0 を https://api.meta.ai/v1. で使用します。ネイティブ API は Responses、Chat Completions、Messages 形式をサポートします。ファイル入力は Responses を使用します。クライアントを設定する際は、各プロバイダのエンドポイントとモデル識別子をセットで管理してください。
Native API limits and other access: Meta はチームあたり毎分 3,000 リクエスト、毎分 4,000,000 トークンを掲示しており、チームの API キーで共有されます。Muse Ember は Muse Code でも利用可能です。バッチの規模を見積もる際には、選択したルートの制限を確認し、ネイティブ API のセットアップにはMeta の統合ガイドを使用してください。
What Are the Limitations of Muse Ember?
次の 3 つの要因が、Ember が次のワークフローに適しているかを決定します。
- 複雑なエンジニアリングは依然としてワークロード依存です。 Ember は Terminal-Bench の結果が強い一方で、FrontierCode 2.0-AA では Haiku 5.5 に劣後します。狭い範囲のコーディングでの勝利は、すべてのリポジトリ規模の変更に対する適合性を保証するものではありません。
- 長いコンテキストと低トークン価格は、低タスクコストを保証しません。 大きなリクエストは高価格帯に移行し、繰り返しのツール使用が、低いトークン単価を上回るトークン消費と総コストを招く場合があります。
- ツールサポートには依然としてアプリケーションが必要です。 周辺システムが呼び出しを実行し、権限を制御し、結果を検証します。モデルがアクションを要求できること自体は、信頼できるワークフローを提供するものではありません。
Conclusion
受け入れ基準が測定可能な領域で Ember を採用してください。最初の有用な導入先は、すでに既知の結果を持つ高頻度ステップ(ラベル付きチケットのルーティングや、レビュー済み文書からのフィールド抽出など)です。現行モデルと比較し、成功タスクあたりのコスト、エラー率、レイテンシを評価してから、その役割を拡大してください。そのエビデンスが、Ember が求められる品質を維持しつつ、ワークフローのコストを削減するかどうかを教えてくれます。
FAQ
Muse Ember の抽出結果はどのように検証すべきですか?
人手で確認した解答を含む参照用文書セットを構築し、欠落フィールド、判読不能なスキャン、矛盾する値も含めます。各 JSON 応答を成功と見なすのではなく、フィールド単位で精度を測定してください。各抽出値が引用されたソース箇所により裏付けられているかを確認し、不一致はレビューに回します。これにより、フォーマットの信頼性と事実の信頼性を分離できます。
Muse Ember のサブタスクはいつメインのエージェントに戻すべきですか?
実行前にエスカレーション条件を定義します。必要なファイルが割り当て範囲外、ソース間で不一致、受け入れチェックの反復的な失敗、またはワーカーに権限がない判断が必要になる場合です。証拠、試行したステップ、未解決の問いをメインエージェントに返します。ワーカーが任務範囲を無制限に広げるよりも、明確な引き継ぎの方が有用です。
本番で Muse Ember をテストする際に何をログに残すべきですか?
正確なプロバイダとモデル識別子、推論設定、入力および課金対象出力トークン、キャッシュトークン、ツール呼び出し回数、リトライ、レイテンシ、最終的な受け入れ結果を記録します。検証結果を使用記録と紐づけ、受け入れタスクあたりのコストを計算できるようにします。類似のタスクタイプごとに比較してください。ルーティング、コーディング、長文書処理の平均を取ると、モデルが助けている箇所とコストを増やしている箇所が見えにくくなります。
Muse Ember のワークフローで重複アクションを防ぐにはどうすべきですか?
アプリケーション側にアクションの同一性と完了状態の責任を持たせます。チケット作成のような操作では安定した操作キーを割り当て、すでに完了していないかを確認し、可能であれば宛先 API の冪等性サポートを使用します。タイムアウト後には再試行前にアクションのステータスを確認します。この設計により、不確かな応答を根拠に、元のアクションが発生していないと誤認することを避けられます。