Specyfikacja techniczna GPT-5.4 Mini
| Element | GPT-5.4 Mini (szacunek na podstawie informacji oficjalnych + weryfikacji krzyżowej) |
|---|---|
| Rodzina modeli | seria GPT-5.4 (kosztowo efektywny wariant „mini”) |
| Dostawca | OpenAI |
| Typy wejścia | Tekst, Obraz |
| Typy wyjścia | Tekst |
| Okno kontekstu | 400,000 tokens |
| Max output tokens | 128,000 tokens |
| Granica wiedzy | ~31 maja 2024 (dziedziczy linię mini) |
| Obsługa rozumowania | Tak (lżejsza vs pełny GPT-5.4) |
| Obsługa narzędzi | Wywoływanie funkcji, wyszukiwanie w sieci, wyszukiwanie plików, agenty (wnioskowane z rodziny GPT-5) |
| Pozycjonowanie | Szybki, opłacalny model near-frontier |
Czym jest GPT-5.4 Mini?
GPT-5.4 Mini to kosztowo efektywny, szybki wariant GPT-5.4 zaprojektowany dla obciążeń wrażliwych na opóźnienia i o dużej skali. Przenosi znaczną część możliwości wnioskowania, programowania i multimodalnych GPT-5.4 do mniejszego, szybszego modelu zoptymalizowanego pod systemy produkcyjne.
W porównaniu z wcześniejszymi modelami „mini”, GPT-5.4 Mini jest pozycjonowany jako mały model near-frontier, co oznacza, że zbliża się do poziomu flagowego, jednocześnie drastycznie obniżając koszt i czas odpowiedzi.
Kluczowe funkcje GPT-5.4 Mini
- Szybkie wnioskowanie: zoptymalizowany pod aplikacje o niskich opóźnieniach, takie jak chatboty, copiloty i systemy czasu rzeczywistego
- Duże okno kontekstu (400K): obsługuje długie dokumenty, wieloetapowe przepływy i pamięć agentów
- Silne wsparcie dla kodowania i agentów: zaprojektowany do korzystania z narzędzi, wieloetapowego rozumowania i delegowanych zadań subagentów
- Wejście multimodalne: akceptuje zarówno dane tekstowe, jak i obrazowe dla bogatszych przepływów pracy
- Ekonomiczne skalowanie: znacznie tańszy niż GPT-5.4 przy zachowaniu silnych zdolności wnioskowania
- Optymalizacja potoku agentów: idealny do architektur wielomodelowych, w których duże modele planują, a mini modele wykonują
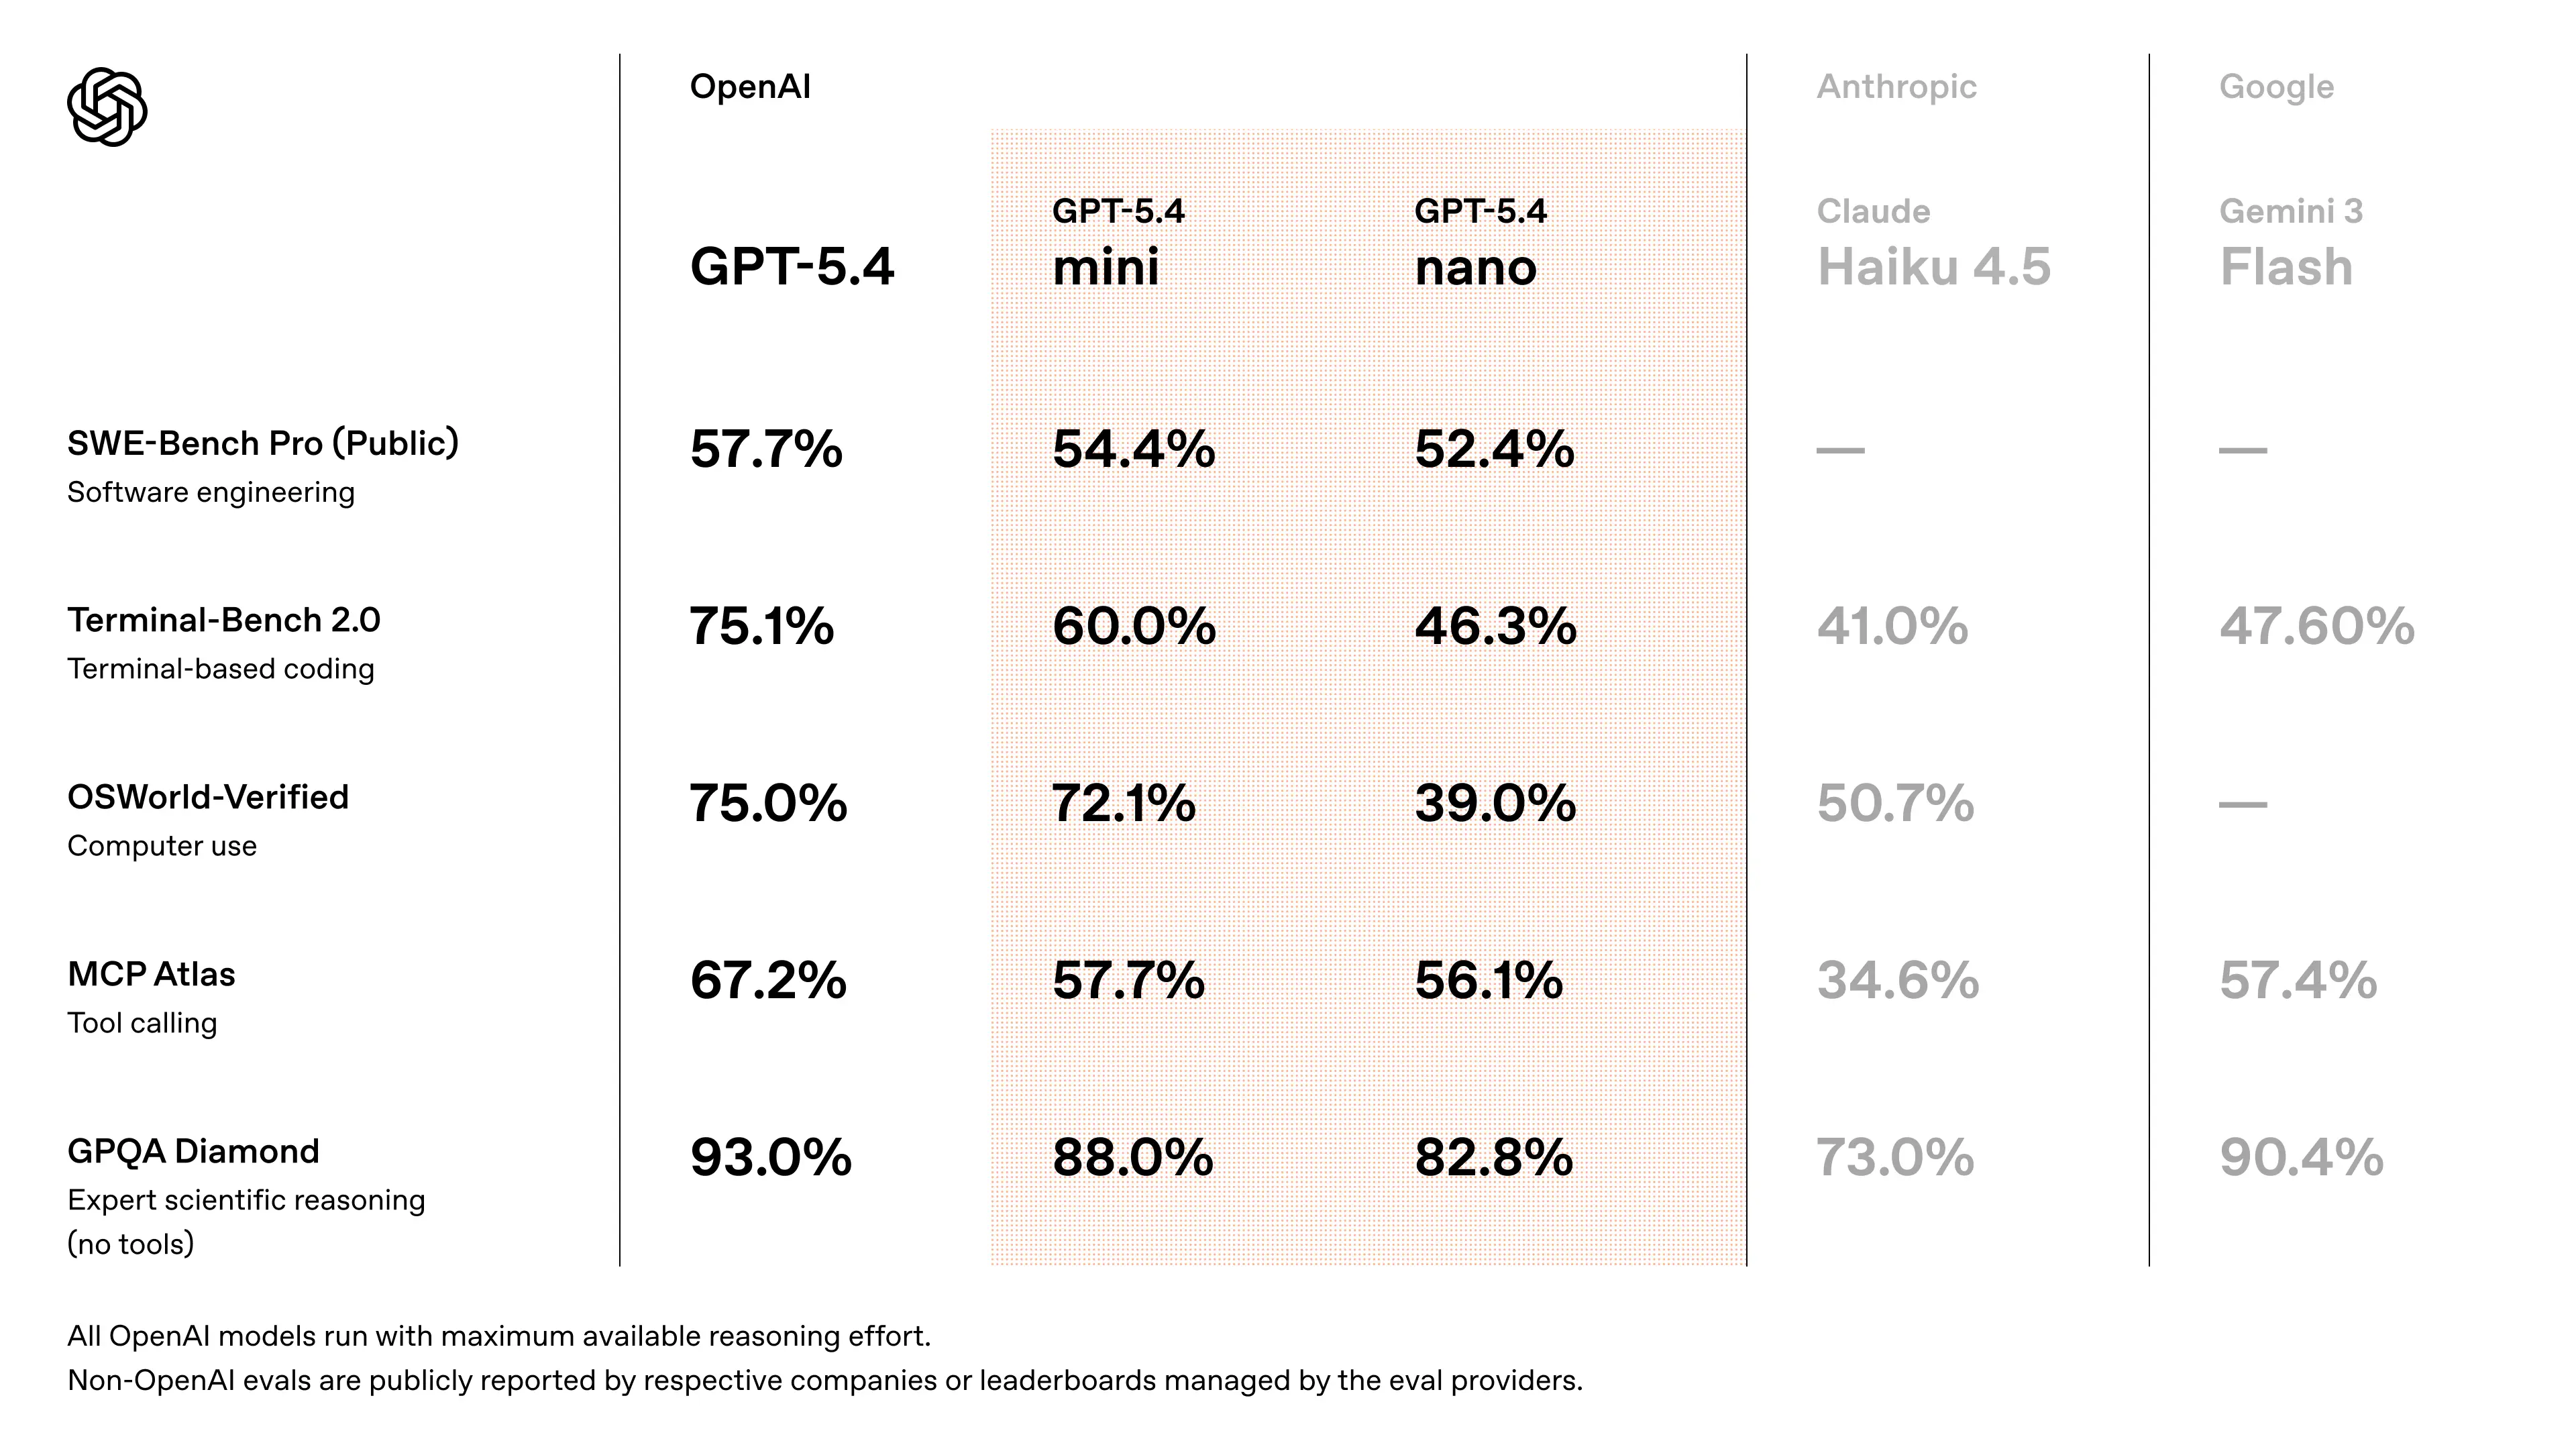
Wyniki benchmarków GPT-5.4 Mini
- Zbliża się do wydajności GPT-5.4 w zadaniach kodowania w stylu SWE-Bench (~94–95% wydajności modelu flagowego) (szacunek zweryfikowany krzyżowo na podstawie dyskusji wydania)
- Znaczące ulepszenia względem GPT-5 Mini w zakresie:
- dokładności rozumowania
- niezawodności korzystania z narzędzi
- zrozumienia multimodalnego
- Zaprojektowany, aby przewyższać poprzednie generacje „mini” w przepływach pracy agentów i benchmarkach kodowania
- pomiary szybkości: wczesni testerzy API raportują ~180–190 tokens/sec na GPT-5.4 Mini (vs ~55–120 t/s dla starszych wariantów GPT-5 mini w zależności od trybów priorytetu).
👉 Kluczowy wniosek: GPT-5.4 Mini zapewnia wydajność near-frontier za ułamek kosztu i opóźnienia, co czyni go idealnym dla systemów skalowalnych.
Przykładowe zastosowania
- Asystenci kodowania i edytory (wtyczki IDE, Copilot): szybkie parsowanie kontekstu, eksploracja bazy kodu i szybkie uzupełnienia sprawiają, że GPT-5.4 Mini jest idealny do podpowiedzi w edytorze, gdzie liczy się czas do pierwszego tokena. GitHub Copilot to wczesna integracja.
- Subagenci / delegowani pracownicy: tam, gdzie agent nadrzędny deleguje krótkie, szybkie zadania (formatowanie, małe kroki rozumowania, wyszukiwania w stylu grep) do taniego, szybkiego wykonawcy. OpenAI pozycjonuje mini/nano do tych ról.
- Automatyzacja API o dużej przepustowości: masowe generowanie kodu, automatyczna triage zgłoszeń, streszczanie logów na dużą skalę, gdzie koszt na wywołanie i opóźnienie są kluczowymi ograniczeniami. Dane społeczności dotyczące przepustowości wskazują na istotne korzyści operacyjne dla mini.
- Opakowywanie narzędzi i łańcuchy narzędziowe: szybkie wywołania narzędzi, w których model orkiestruje wywołania zewnętrznych narzędzi (search, grep, run tests) i zwraca zwięzłe, użyteczne wyniki. Rodzina GPT-5.4 obejmuje ulepszone możliwości „computer use”.
Jak uzyskać dostęp do API GPT-5.4 Mini
Krok 1: Zarejestruj się po klucz API
Zaloguj się do cometapi.com. Jeśli nie jesteś jeszcze naszym użytkownikiem, zarejestruj się najpierw. Zaloguj się do swojej konsoli CometAPI. Uzyskaj klucz API uprawniający dostęp do interfejsu. Kliknij „Add Token” przy tokenie API w centrum osobistym, pobierz klucz tokena: sk-xxxxx i wyślij.

Krok 2: Wysyłaj żądania do API GPT-5.4 Mini
Wybierz punkt końcowy „gpt-5.4-mini”, aby wysłać żądanie API i ustaw ciało żądania. Metodę i ciało żądania znajdziesz w naszej dokumentacji API na stronie. Nasza strona udostępnia również test w Apifox dla Twojej wygody. Zastąp <YOUR_API_KEY> swoim rzeczywistym kluczem CometAPI z konta. podstawowy adres URL to Uzupełnienia czatu oraz Odpowiedzi.
Wstaw swoje pytanie lub prośbę w polu content — na to odpowie model. Przetwarzaj odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Pobierz i zweryfikuj wyniki
Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Po przetworzeniu API odpowiada statusem zadania i danymi wyjściowymi.