
TL;DR: Qual alternativa à API do GPT-6 Astra você deve escolher?
Escolha o modelo de acordo com a carga de trabalho: Claude Opus 5 como substituto premium mais próximo, Claude Fable 5.1 para o raciocínio sustentado mais difícil, GPT-5.6 Sol para a migração de menor atrito a partir do OpenAI, Claude Sonnet 5 para produção em alto volume, Gemini 3.8 Flash para trabalho multimodal de baixo custo e DeepSeek V4.1 Flash quando o custo por token for a principal restrição.
Mantenha o GPT-6 Astra para cargas de trabalho em que seu uso de computador mais forte, execução autônoma, raciocínio científico ou desempenho em cibersegurança reduzem materialmente as tentativas e a intervenção humana.
Principais conclusões: O que importa ao substituir o GPT-6 Astra?
- O GPT-6 Astra é difícil de substituir em suas tarefas agentivas mais fortes. A tabela oficial de benchmark do GPT-6 Astra registra 57.9% no Terminal-Bench 4.0, 97.6% no FrontierMath Tier 4 e 96.0% no GPQA Diamond.
- Claude Opus 5 é a alternativa direta mais equilibrada para testar primeiro. A Anthropic precifica o Opus 5 a $5/$25 por milhão de tokens de entrada/saída, metade das taxas-base de tokens do Astra.
- Claude Fable 5.1 não é uma alternativa econômica. Sua precificação de $10/$50 em entrada/saída corresponde à tarifa principal do Astra, enquanto avaliações selecionadas de conhecimento e raciocínio de longo horizonte favorecem o Fable 5.1.
- GPT-5.6 Sol é o downgrade mais fácil, em vez de uma troca de plataforma real. A janela de contexto de 1,05M, a saída máxima de 128K e os preços de $4/$20 reduzem o atrito de migração para aplicações OpenAI.
- Gemini 3.8 Flash oferece um forte caso de preço/desempenho hospedado. Sua tarifa introdutória de 2026 é $0.75/$3.75 por milhão de tokens de entrada/saída.
- DeepSeek V4 Flash está em uma classe de custo diferente. Suas tarifas oficiais de pico e fora de pico ficam muito abaixo dos preços de modelos premium, mas um custo menor por token não estabelece taxas equivalentes de sucesso agentivo.
- A melhor métrica de produção geralmente é o custo por tarefa concluída e aceita. Inclua tentativas adicionais, falhas de ferramentas, latência, uso de tokens de saída e retrabalho humano.
O que é a API do GPT-6 Astra?
A OpenAI posiciona o GPT-6 Astra como seu modelo carro-chefe para trabalhos complexos ponta a ponta. A especificação da API inclui uma janela de contexto de 1.050.000 tokens e saída máxima de 128.000 tokens, entrada de texto e imagem, suporte a tokens de raciocínio e cinco configurações de esforço de raciocínio: low, medium, high, xhigh e max.
O Astra difere de um chatbot convencional porque é projetado para execução de longa duração. A visão geral oficial de capacidades enfatiza uso de computador e trabalho profissional, juntamente com engenharia de software, navegação, ciência, cibersegurança e raciocínio complexo.
| Especificação do GPT-6 Astra | Valor |
|---|---|
| ID do modelo da API | gpt-6-astra |
| Provedor | OpenAI |
| Janela de contexto | 1.050.000 tokens |
| Saída máxima | 128.000 tokens |
| Entrada | Texto, imagens |
| Saída | Texto |
| Data de corte do conhecimento | 30 de abril de 2026 |
| Esforço de raciocínio | Low, medium, high, xhigh, max |
| Preço padrão de entrada | $10 / 1M tokens |
| Entrada em cache | $1 / 1M tokens |
| Preço padrão de saída | $50 / 1M tokens |
| Limite de contexto longo | Mais de 272K tokens de entrada |
Nota de precificação para contexto longo:
solicitações acima de 272K tokens de entrada
são reprecificadas para todo o pedido a $20/M na entrada e $75/M na saída. Faça o orçamento dessas solicitações separadamente.
Por que as equipes olham além do GPT-6 Astra
O Astra é mais convincente quando sua capacidade adicional elimina tentativas fracassadas, erros de ferramentas, intervenção manual ou chamadas repetidas a modelos mais fracos. Seu preço premium é mais difícil de justificar para sumarização, extração, classificação, RAG rotineiro, conversa comum e geração padrão de código.
Portanto, as equipes avaliam alternativas para reduzir custos, permanecer em um ecossistema de provedor existente, melhorar a economia de cache, adicionar suporte multimodal ou usar um modelo mais rápido para tráfego rotineiro, reservando o Astra para escalonamento.
Comparação de benchmarks e limitações
Nota de evidência: a tabela usa a estrutura de comparação publicada pela OpenAI para colocar várias alternativas sob uma configuração comum. Essas pontuações relatadas pelos fornecedores podem mudar com snapshots de modelos, prompts, ferramentas e metodologia de avaliação; use-as para fazer uma lista curta de candidatos e, em seguida, valide os finalistas em tarefas de produção representativas.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
Os resultados mostram por que chamar qualquer modelo de “substituto universal do Astra” é enganoso. O Astra tem liderança clara em várias avaliações agentivas e científicas, enquanto o Fable 5.1 tem melhor desempenho no Humanity’s Last Exam e várias alternativas permanecem muito próximas no DeepSWE.
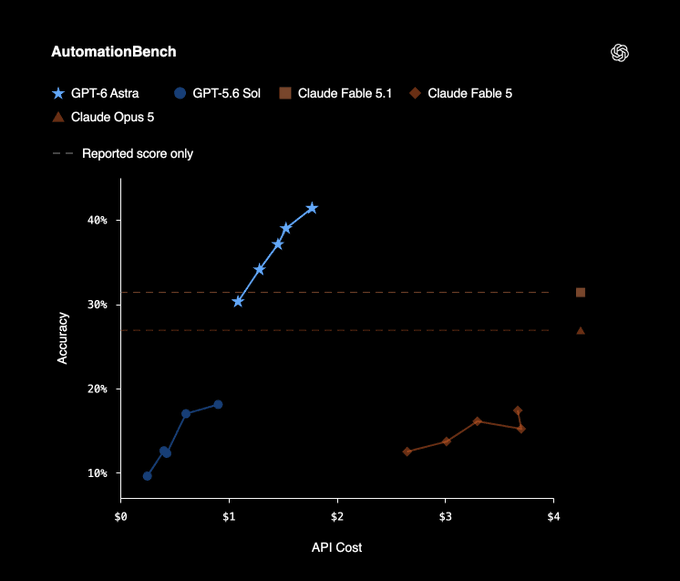
Gráfico oficial do benchmark AutomationBench da OpenAI.
Índices públicos de benchmark também podem mudar à medida que a metodologia e os snapshots dos modelos são revisados. Use-os para fazer uma lista curta de candidatos, não como substituto de uma avaliação específica da carga de trabalho.
Alternativas ao GPT-6 Astra
Nenhum modelo substitui o Astra em todas as cargas de trabalho. A escolha mais prática depende da capacidade de que você precisa, do ecossistema do provedor que você já usa e do custo de execuções fracassadas ou repetidas.
| Alternativa | Preço oficial de entrada / saída por 1M tokens | Contexto | Melhor motivo para escolhê-la |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Substituto premium geral mais próximo |
| Claude Fable 5.1 | $10 / $50 | 1M | Raciocínio mais difícil e agentes longos |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Migração de menor atrito no OpenAI |
| Claude Sonnet 5 | $2 / $10 | 1M | Trabalho de produção em alto volume |
| Gemini 3.8 Flash | $0.75 / $3.75 promocional | 1M | Multimodal e lotes de baixo custo |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Menor custo por token e alto volume |
Claude Opus 5
Por que considerar
O Claude Opus 5 é a primeira alternativa a testar quando um produto precisa de raciocínio premium, codificação ou desempenho em trabalho profissional a um preço de lista mais baixo do que o Astra.
Preço, contexto e cache
A Anthropic lista o Claude Opus 5 a $5/M na entrada e $25/M na saída com janela de contexto de 1M tokens. Confirme os termos atuais de cache antes do orçamento de produção.
Onde ele tem bom desempenho
É competitivo em codificação, análise, redação profissional e fluxos de trabalho de agentes; a tabela de benchmark citada o coloca próximo ao Astra em DeepSWE e FrontierCode.
Limitações
Não supera o Astra de forma consistente. O Astra permanece mais forte quando operação de computador, execução autônoma avançada, cibersegurança ou ferramentas nativas da OpenAI são centrais ao produto.
Melhor para / Evite quando
Melhor para: agentes de codificação premium, análise complexa e redação profissional. Evite quando: o fluxo depende fortemente de ferramentas específicas do Astra ou de sua capacidade de uso de computador.
Claude Fable 5.1
Por que considerar
O Claude Fable 5.1 é um concorrente carro-chefe para o raciocínio mais difícil, pesquisa, codificação e tarefas de agentes de longa duração, em vez de um substituto de baixo custo.
Preço, contexto e cache
Suas tarifas de $10/M na entrada e $50/M na saída correspondem à precificação principal do Astra. A janela de contexto de 1M tokens e o preço de leitura de cache de $0.25/M podem melhorar a economia quando prompts grandes são reutilizados com frequência.
Onde ele tem bom desempenho
É particularmente atraente para raciocínio sustentado e agentes com uso intenso de cache; na comparação citada, lidera o Astra no Humanity’s Last Exam com ferramentas.
Limitações
Não reduz a tarifa principal por token, e o Astra mantém vantagens em vários benchmarks agentivos e científicos, bem como no conjunto de ferramentas nativas da OpenAI.
Melhor para / Evite quando
Melhor para: máxima qualidade de raciocínio e fluxos repetidos com contexto longo. Evite quando: o objetivo principal é uma grande redução no preço padrão por token.
GPT-5.6 Sol
Por que considerar
O GPT-5.6 Sol oferece a migração de menor atrito para aplicações já construídas em torno do comportamento e das ferramentas compatíveis com OpenAI.
Preço, contexto e cache
A especificação citada lista $4/M na entrada e $20/M na saída, janela de contexto de 1,05M tokens e saída máxima de 128K. Verifique os termos atuais de entrada em cache antes do orçamento final.
Onde ele tem bom desempenho
Permanece próximo ao Astra em DeepSWE e GPQA Diamond enquanto custa substancialmente menos no nível padrão de contexto curto.
Limitações
A diferença aumenta em tarefas representadas por Terminal-Bench e FrontierMath, então as economias podem desaparecer se a conclusão de tarefa mais fraca gerar tentativas adicionais ou reparo manual.
Melhor para / Evite quando
Melhor para: aplicações existentes no OpenAI e cargas gerais que não precisam das capacidades agentivas mais fortes do Astra. Evite quando: a carga de trabalho se beneficia repetidamente dos grandes ganhos do Astra em benchmarks.
Claude Sonnet 5
Por que considerar
O Claude Sonnet 5 é um padrão de produção prático para trabalho de conhecimento competente e repetível que não exige um carro-chefe de fronteira em cada requisição.
Preço, contexto e cache
Sua tarifa permanente citada é $2/M na entrada e $10/M na saída com janela de contexto de 1M tokens. Confirme os termos atuais de cache para implantações com forte reutilização de prompt.
Onde ele tem bom desempenho
Serve para classificação de tickets, extração de documentos, RAG padrão, transformação de conteúdo, explicação de código, chamadas de função rotineiras e geração estruturada.
Limitações
Não consegue substituir de forma confiável o Astra em todos os problemas de raciocínio de longo horizonte ou de fronteira.
Melhor para / Evite quando
Melhor para: tráfego de produção em alto volume e automação de negócios rotineira. Evite quando: a falha em uma tarefa agentiva difícil é mais cara do que o prêmio de um modelo carro-chefe.
Gemini 3.8 Flash
Por que considerar
O Gemini 3.8 Flash combina entrada multimodal, grande contexto e baixo custo de API hospedada para documentos, mídia, codificação e pipelines em lote.
Preço, contexto e cache
A tarifa introdutória citada é $0.75/M na entrada e $3.75/M na saída até 31 de dezembro de 2026, com janela de contexto de 1M tokens e cache com desconto durante o período promocional.
Onde ele tem bom desempenho
É adequado para extração multimodal, PDFs, áudio, vídeo, imagens, grandes coleções de documentos, análise em lote e cargas de trabalho de codificação sensíveis a custo.
Limitações
A precificação promocional é por tempo limitado, e as tarefas agentivas mais difíceis ou de uso de computador ainda exigem validação específica da carga de trabalho em relação ao Astra.
Melhor para / Evite quando
Melhor para: processamento multimodal de baixo custo e lotes de alto volume. Evite quando: o aplicativo requer a execução autônoma mais forte independentemente do custo por token.
DeepSeek V4.1 Flash
Por que considerar
O DeepSeek V4.1 Flash é a opção focada em custo para raciocínio, codificação, sumarização, extração, classificação e processamento offline de alta vazão.
Preço, contexto e cache
A tabela de pico e fora de pico citada lista entrada com acerto de cache a $0.007–$0.014/M, entrada com erro de cache a $0.22–$0.44/M e saída a $0.66–$1.32/M, com janela de contexto de 1M tokens. Verifique novamente a página atual de preços do V4.1 antes da publicação.
Onde ele tem bom desempenho
É atraente quando o custo por token domina e o aplicativo pode usar roteamento, validação ou verificações de qualidade offline para gerenciar a variabilidade.
Limitações
Um preço por token muito menor não estabelece sucesso equivalente em tarefas autônomas. Confiabilidade, comportamento de ferramentas, latência e taxa de aceitação precisam ser medidos na carga de trabalho alvo.
Melhor para / Evite quando
Melhor para: processamento em larga escala e sensível a custo com validação. Evite quando: uma execução autônoma de alto valor fracassada superaria as economias de tokens.
GPT-6 Astra vs alternativas: Qual modelo vence em cada categoria?
Considerando preço, arquitetura, contexto e evidências de benchmark, obtemos uma tabela de decisão mais útil do que simplesmente classificar modelos do primeiro ao sexto.
| Categoria | Melhor escolha | Por quê |
|---|---|---|
| Alternativa geral ao Astra | Claude Opus 5 | Desempenho próximo ao de fronteira por metade do preço |
| Raciocínio máximo | Claude Fable 5.1 | Raciocínio carro-chefe e forte desempenho de longo horizonte |
| Permanecer no OpenAI | GPT-5.6 Sol | Ecossistema de API similar com preços 60% menores |
| Produção em alto volume | Claude Sonnet 5 | Forte qualidade por $2/$10 |
| Preço/desempenho multimodal | Gemini 3.8 Flash | Contexto de 1M e preços introdutórios muito baixos em 2026 |
| Menor custo de API | DeepSeek V4.1 Flash | $0.22–$0.44 na entrada e $0.66–$1.32 na saída |
| Agentes com uso intenso de computador | GPT-6 Astra | Um dos diferenciadores mais claros do Astra |
| Fluxos científicos e matemáticos difíceis | GPT-6 Astra | Resultados muito fortes em FrontierMath e agentes científicos |
| Agentes longos com uso intenso de cache | Claude Fable 5.1 | Leituras de cache a $0.25/M |
O resultado mais importante é que o GPT-6 Astra ainda vence em algumas categorias. Um artigo sobre alternativas não deve insinuar que um modelo mais barato o substitui universalmente. O Astra fica caro quando implantado em todos os lugares; ele ainda pode ser econômico quando sua maior taxa de conclusão de tarefas substitui várias tentativas com modelos mais fracos.
Quanto você realmente pode economizar substituindo a API do GPT-6 Astra?
Considere uma carga de trabalho que consome 1 milhão de tokens de entrada sem cache e 200.000 tokens de saída. Ignorando descontos de cache, tarifas de ferramentas, tentativas adicionais, preços em lote e sobretaxas de contexto longo:
| Modelo | Custo aproximado de API |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Tarifa promocional do Gemini 3.8 Flash | $1.50 |
| DeepSeek V4.1 Flash fora de pico | $0.35 |
O cálculo básico é:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Este exemplo simples também demonstra por que o preço por token não pode ser a única métrica. Se uma requisição de $20 no Astra tiver sucesso de primeira enquanto um modelo de $4 exigir seis tentativas, vários retries de ferramenta e reparo humano, o Astra foi, na verdade, mais barato.
Uma métrica de produção melhor é:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Acompanhe esse número junto com latência, sucesso de tarefa, taxa de tentativas, erros de chamadas de ferramentas e taxa de escalonamento para humanos.
Como testar alternativas ao GPT-6 Astra via CometAPI?
Um benefício prático de uma camada de API multi-modelo é que a avaliação não precisa se tornar um projeto de integração de provedor. A CometAPI fornece API do GPT-6 Astra, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash e DeepSeek V4.1 Flash por meio de um catálogo único de modelos.
Com um cliente compatível com OpenAI, o modelo pode ser configurável em vez de codificado:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Você pode executar novamente o mesmo conjunto de avaliação usando IDs de modelo como:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Isso geralmente é mais informativo do que escolher uma alternativa apenas por um ranking de benchmark. Pegue de 100 a 500 prompts representativos de produção e registre sucesso da tarefa, aceitação humana, tentativas, erros de ferramentas, tokens totais, latência e custo total de API.
Substituir o GPT-6 Astra por um único modelo ou usar roteamento de modelos?
Para muitas aplicações, substituir o Astra por um modelo universal é a otimização errada. Uma arquitetura mais eficiente se parece com isto:
- Tráfego rotineiro → Claude Sonnet 5, Gemini 3.8 Flash ou DeepSeek V4.1 Flash
- Raciocínio difícil → Claude Opus 5 ou GPT-5.6 Sol
- Tarefas muito difíceis de longo horizonte → Claude Fable 5.1 ou GPT-6 Astra
- Uso de computador ou fluxos de agentes específicos do Astra → GPT-6 Astra
Isso transforma o Astra em um modelo de escalonamento, e não no padrão. Se apenas 10% das requisições realmente exigem desempenho de agente de fronteira, rotear 100% do tráfego pelo Astra significa pagar seu prêmio pelos outros 90% também.
Qual alternativa à API do GPT-6 Astra você deve escolher?
Escolha o Claude Opus 5 se você quer o equilíbrio mais próximo entre qualidade e preço.
Escolha o Claude Fable 5.1 se o raciocínio máximo importa mais do que reduzir as tarifas principais por token.
Escolha o GPT-5.6 Sol se você já usa OpenAI e quer a menor mudança de integração.
Escolha o Claude Sonnet 5 se a maior parte do seu tráfego de produção é trabalho de conhecimento competente porém comum.
Escolha o Gemini 3.8 Flash se multimodalidade, escala e baixo custo de API hospedada importam.
Escolha o DeepSeek V4.1 Flash se o custo por token é a restrição dominante e sua carga de trabalho pode tolerar mais avaliação e validação.
E escolha o próprio GPT-6 Astra quando seu aplicativo realmente se beneficia de uso de computador mais forte, trabalho autônomo complexo em software, raciocínio científico ou outras capacidades agentivas.
O principal erro não é escolher o “modelo de fronteira errado”. É pagar preços de modelo de fronteira por requisições que nunca precisaram de um modelo de fronteira em primeiro lugar.
FAQ
Qual é a melhor alternativa geral à API do GPT-6 Astra?
Claude Opus 5 é um dos substitutos de uso geral mais fortes. Ele oferece janela de contexto de 1M, fortes capacidades de codificação e agentes, e preços de lista de $5/$25 — metade das tarifas padrão de tokens do Astra.
Qual é a alternativa mais barata ao GPT-6 Astra?
Entre os modelos abordados aqui, o DeepSeek V4.1 Flash tem a menor precificação direta por token. Sua tarifa atual fora de pico é $0.22/M de entrada sem cache e $0.66/M de saída. No entanto, não se deve presumir que iguala o sucesso de tarefas autônomas do Astra simplesmente por ser mais barato.
Claude Fable 5.1 é melhor que o GPT-6 Astra?
Nenhum dos modelos vence todas as cargas de trabalho. A comparação da OpenAI dá ao Astra vantagens significativas no FrontierMath Tier 4 e no Terminal-Bench 4.0, enquanto o Fable 5.1 pontua mais alto no Humanity’s Last Exam com ferramentas.
Vale a pena usar o GPT-5.6 Sol depois do GPT-6 Astra?
Sim. Sua precificação padrão de API de $4/$20 está substancialmente abaixo dos $10/$50 do Astra, enquanto mantém uma janela de contexto de 1,05M. Portanto, pode ser um melhor padrão para cargas em que os ganhos do Astra não melhoram materialmente a conclusão da tarefa.
O Gemini 3.8 Flash é bom o suficiente para substituir o GPT-6 Astra?
Para algumas cargas de trabalho de codificação, multimodal, documentos e processamento em lote, sim. Ele é dramaticamente mais barato e tem janela de contexto de 1M. Para as tarefas de agente autônomo e uso de computador mais difíceis, o Astra continua sendo a escolha mais forte.
O GPT-6 Astra tem desvantagem de preço para prompts muito longos?
Sim. A OpenAI aplica um nível de preço mais alto quando a entrada excede 272K tokens, portanto solicitações de contexto longo devem ter orçamento separado.
Devo comparar modelos usando preço por token ou pontuações de benchmark?
Use ambos apenas como métricas de triagem. A métrica de produção que mais importa geralmente é o custo por tarefa concluída e aceita, incluindo tokens de raciocínio, tentativas adicionais, chamadas de ferramentas, latência e retrabalho humano.
Posso usar várias alternativas ao GPT-6 Astra no mesmo aplicativo?
Sim. Em muitas aplicações, o roteamento de modelos é preferível a comprometer cada requisição com um único modelo. Um modelo de baixo custo pode lidar com requisições rotineiras enquanto modelos mais fortes tratam escalonamentos cada vez mais difíceis.