
TL;DR
Claude Haiku 5.5 e GPT-6 Luna são modelos de raciocínio de baixo custo para cargas de trabalho de API em grande volume. Ambos começam em $0,10 por milhão de tokens de entrada e $0,50 por milhão de tokens de saída. O Haiku obtém pontuações mais altas nas seis comparações publicadas nos materiais de lançamento da Anthropic. A Luna mantém suas tarifas base de tokens para prompts de até 272K tokens de entrada, em comparação com o limite de 100K do Haiku. Para desenvolvedores, as métricas-chave são taxa de aceitação, latência de ponta a ponta, compatibilidade de API e custo por resultado aceito — o custo total de todas as tentativas dividido pelo número de saídas que passam em verificações predefinidas.
Principais pontos
- O Haiku 5.5 lidera a comparação de uso de computador OSWorld 2.1 citada, 72,4% contra 48,9% da Luna.
- No Terminal-Bench 4.0, os resultados citados são 39,2% para o Haiku e 16,4% para a Luna.
- Ambos começam com preços idênticos para contexto curto, mas o nível de preço mais alto do Haiku começa acima de 100K tokens de prompt, contra o limite de 272K da Luna.
- As páginas de “max-effort” do Artificial Analysis, verificadas em 9 de outubro de 2026, mostram velocidades de saída de 240,6 tokens/s para o Haiku e 123,0 tokens/s para a Luna; a vazão exclui o tempo de espera até o primeiro token.
- Comece com o Haiku para as tarefas de uso de computador e terminal refletidas nos benchmarks compartilhados; considere a Luna para prompts grandes. Mantenha seu modelo atual até que um piloto representativo demonstre uma melhoria útil.
O que são Claude Haiku 5.5 e GPT-6 Luna?
Claude Haiku 5.5: Visão geral
Claude Haiku 5.5 foi lançado em 7 de outubro de 2026. Ele combina inferência de baixo custo com raciocínio ajustável, uso de ferramentas, contexto longo e entradas de texto e imagem. Aplicações típicas incluem extração de documentos, consultas a banco de dados, suporte ao cliente e subagentes leves.
GPT-6 Luna: Visão geral
GPT-6 Luna foi lançado em 22 de setembro de 2026. É direcionado a tarefas focadas em escala, incluindo classificação, extração de informações, saída estruturada, assistência em programação e processamento de documentos longos. Suas configurações flexíveis de raciocínio incluem uma configuração sem raciocínio para trabalhos mais simples.
Especificações
| Especificação | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Desenvolvedor | Anthropic | OpenAI |
| Lançamento | 7 de outubro de 2026 | 22 de setembro de 2026 |
| ID do modelo | claude-haiku-5-5 | gpt-6-luna |
| Janela de contexto | 1.000.000 tokens | 1.050.000 tokens |
| Saída máxima (API padrão) | 128.000 tokens | 128.000 tokens |
| Entrada | Texto e imagem | Texto e imagem |
| Saída | Texto | Texto |
| Raciocínio | Ajustável, de Baixo a Máximo | De Nenhum a Máximo |
| Esforço padrão | Médio | Médio |
| Corte de conhecimento | Junho de 2026 | 18 de maio de 2026 |
| Uso de ferramentas | Sim | Sim |
| Saída estruturada | Sim | Sim |
| Pesos abertos | Não | Não |
| Arquitetura e número de parâmetros | Não especificado nos materiais oficiais citados | Não especificado nos materiais oficiais citados |
As especificações usam a documentação padrão de modelos de API dos fornecedores, verificada em 9 de outubro de 2026: Especificações da API padrão do Haiku e Especificações da API padrão da Luna. Arquitetura e contagem de parâmetros não são especificadas porque essas fontes não as estabelecem.
Claude Haiku 5.5 vs GPT-6 Luna: Resultados de benchmark
| Benchmark | Haiku 5.5 | GPT-6 Luna | Líder |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1.620 | 1.437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1.578 | 1.336 | Haiku +242 |
| OSWorld 2.1, pontuação parcial offline | 72,4% | 48,9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39,2% | 16,4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46,4% | 42,4% | Haiku +4.0 pp |
| Chartography, sem ferramentas | 46,4% | 29,1% | Haiku +17.3 pp |
As seis linhas acima reproduzem os resultados de comparação de lançamento publicados pela Anthropic, verificados em 9 de outubro de 2026. São comparações publicadas pela Anthropic, incluindo resultados independentes ali reproduzidos, e não novos testes executados para este artigo. GDPval-AA e AA-Briefcase são pontuações Elo; diferenças percentuais são pontos percentuais. Essas famílias de benchmarks medem tarefas diferentes e não devem ser agregadas para definir um vencedor universal.
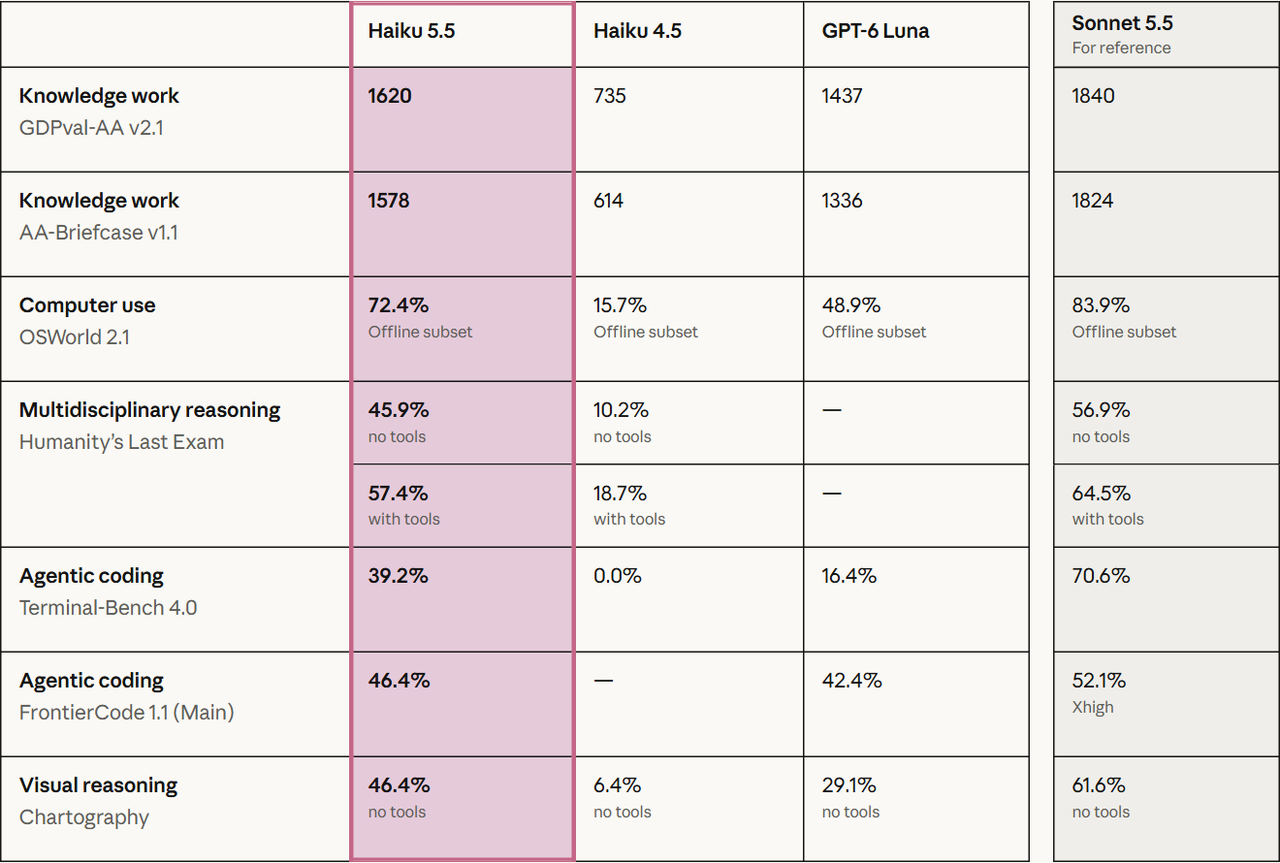
Os resultados relativos mais fortes do Haiku nesta tabela de lançamento aparecem em interação visual com computador e tarefas baseadas em terminal. Sua liderança menor no FrontierCode alerta contra extrapolar uma diferença de 20 pontos para toda e qualquer situação de codificação. Use esses resultados para selecionar candidatos a piloto e, depois, valide seus prompts e pilha de ferramentas.
Esforço de raciocínio e limites de avaliação
O esforço de raciocínio altera o equilíbrio entre precisão e custo. Compare as configurações disponíveis usando a mesma carga de trabalho e o mesmo harness; nomes de configuração iguais entre fornecedores não garantem orçamentos de tokens de raciocínio iguais. A tabela de lançamento reporta o subconjunto offline do OSWorld e o Chartography sem ferramentas. Harness, seleção de tarefas, tentativas e acesso a ferramentas podem mudar os resultados. O system card da Anthropic documenta as condições específicas do benchmark. Leia os métodos de benchmark no system card da Anthropic.
- O OSWorld usa o subconjunto offline de 82 tarefas, uma máquina virtual Ubuntu, capturas de tela 1080p, limite de 500 ações, esforço máximo e cinco tentativas por tarefa. A comparação 72,4%/48,9% é de pontuação de crédito parcial, não a porcentagem de tarefas concluídas perfeitamente; a taxa de aprovação estrita do Haiku é 37,1%. A Anthropic executou a Luna no mesmo subconjunto de tarefas pela API da OpenAI.
- O Terminal-Bench usa 66 tarefas conteinerizadas; o Haiku rodou em esforço máximo no modo bare do Claude Code, sem egresso à internet ou modelo de fallback, com média de dez tentativas por tarefa.
- O FrontierCode Main contém 100 tarefas com cinco execuções por tarefa; modelos Claude usaram Claude Code e modelos GPT usaram Codex.
- GDPval-AA e AA-Briefcase foram avaliados independentemente pelo Artificial Analysis e reproduzidos nos materiais de lançamento. São pipelines de avaliação separados, não um único harness de produção compartilhado.
Claude Haiku 5.5 vs GPT-6 Luna: Comparação de recursos
Uso de computador e codificação orientada a agentes
A maior vantagem do Haiku está nas tarefas compartilhadas de lançamento que exigem interação com um computador gráfico ou trabalho em um terminal. A diferença de pontuação parcial do OSWorld é de 23,5 pontos percentuais, enquanto o Terminal-Bench difere por 22,8 pontos. A diferença menor de 4,0 pontos no FrontierCode mostra por que a categoria mais ampla de codificação não deve ser tratada como uma única carga de trabalho.
Para automação de navegador, teste navegação de páginas, preenchimento de formulários, recuperação de falhas de ferramentas e conclusão fim a fim. Para codificação, teste se um patch passa nas verificações funcionais do seu repositório e permanece dentro do escopo. Essas verificações de aceitação são mais úteis do que escolher um modelo com base na maior manchete.
Contexto longo e processamento de documentos
A diferença de 5% na capacidade nominal de contexto é menos significativa do que a confiabilidade e o preço de processar prompts volumosos. Nenhum modelo é inerentemente superior em recuperar informações apenas porque sua janela de contexto é maior.
A principal diferença é quando se aplicam tarifas mais altas: um prompt de 150K tokens cruza o limite do Haiku enquanto permanece no nível base da Luna. Portanto, a Luna é o ponto de partida de menor custo para essa carga de tokens. Se ela é a melhor analista de documentos ainda depende da precisão de extração, citações e das tentativas necessárias para obter uma resposta aceitável.
Controles de raciocínio
Ambos os modelos expõem esforço de raciocínio ajustável, com médio como padrão na documentação citada. A Luna também expõe a configuração none. Use esses controles conforme a tarefa: extração e roteamento podem exigir menos raciocínio do que um fluxo de ferramentas multietapas incerto. O mesmo rótulo de esforço não implica a mesma alocação de computação entre fornecedores.
Entrada multimodal e fluxos de trabalho estruturados
Ambos aceitam texto e imagens e produzem texto. Isso os torna candidatos para capturas de tela, extração de imagens de documentos e fluxos de trabalho estruturados a jusante. O suporte a entrada, por si só, não estabelece precisão igual em texto pequeno, gráficos ou interfaces visuais; meça esses casos separadamente.
Velocidade e economia da tarefa
| Métrica independente (esforço máximo) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Velocidade de saída | 240,6 tokens/s | 123,0 tokens/s |
| Custo ponderado por tarefa do Intelligence Index | $0,21 | $0,07 |
Artificial Analysis é o publicador de testes independentes. A tabela é um instantâneo de suas páginas de modelos em esforço máximo, verificadas em 9 de outubro de 2026, e não desempenho oficial do fornecedor. A velocidade de saída mede os tokens recebidos após o início da geração; é separada do tempo até o primeiro token e da latência completa da tarefa. O custo por tarefa é uma métrica ponderada do Intelligence Index, não um orçamento para sua tarefa de produção ou custo por resultado bem-sucedido.
A vazão de saída instantânea do Haiku é aproximadamente 1,96 vezes a da Luna, enquanto o custo ponderado por tarefa de avaliação da Luna é menor. Isso não estabelece uma vantagem de 1,96 vez no tempo de conclusão da tarefa completa. Em produção, registre separadamente o tempo até o primeiro token, o tempo de conclusão, o comprimento da saída, o consumo de raciocínio e o tempo de execução de ferramentas.
Claude Haiku 5.5 vs GPT-6 Luna: Preços e acesso à API
Tarifas padrão oficiais
| USD por 1M de tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Entrada | $0,10 | $0,50 | $0,10 | $0,20 |
| Leitura em cache | $0,01 | $0,05 | $0,01 | $0,02 |
| Gravação em cache (Haiku: TTL de 5 minutos) | $0,125 | $0,625 | $0,125 | $0,25 |
| Saída | $0,50 | $2,50 | $0,50 | $0,75 |
USD por milhão de tokens nas taxas padrão de processamento, verificado em 9 de outubro de 2026. A tabela usa as taxas padrão e de gravação em cache de 5 minutos do Haiku e as taxas de contexto curto e longo da Luna. Tarifas de ferramentas, impostos, acréscimos regionais e ajustes opcionais de nível de processamento estão excluídos. Acima do limite de entrada, as tarifas mais altas aplicáveis cobrem a solicitação, e não apenas os tokens excedentes.
O ponto central é o limite de cobrança. O Haiku passa para tarifas mais altas acima de 100K tokens de prompt, enquanto a Luna mantém seu nível baixo até 272K. Mesmo acima desse limite, os preços citados de entrada e saída de contexto longo da Luna são mais baixos.
O Haiku também oferece gravações em cache de 1 hora a $0,20/$1,00 por milhão de tokens para prompts curtos/longos. Persistência de cache e mecanismos de precificação diferem entre fornecedores, então compare padrões de reutilização em vez de tratar ambas as linhas de gravação em cache como produtos idênticos. O limite de saída de 128K do Haiku é o limite da API padrão; sua Message Batches API pode suportar 300K de saída com um cabeçalho beta.
Custos ilustrativos com orçamentos de tokens fixos
| Carga de trabalho | Entrada / Saída | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Classificação de tickets | 2K / 200 | $0,0003 | $0,0003 |
| Relatório curto | 40K / 4K | $0,006 | $0,006 |
| Análise de repositório | 150K / 5K | $0,0875 | $0,0175 |
| Revisão de documento grande | 300K / 10K | $0,175 | $0,0675 |
| Análise de contexto massivo | 800K / 20K | $0,45 | $0,175 |
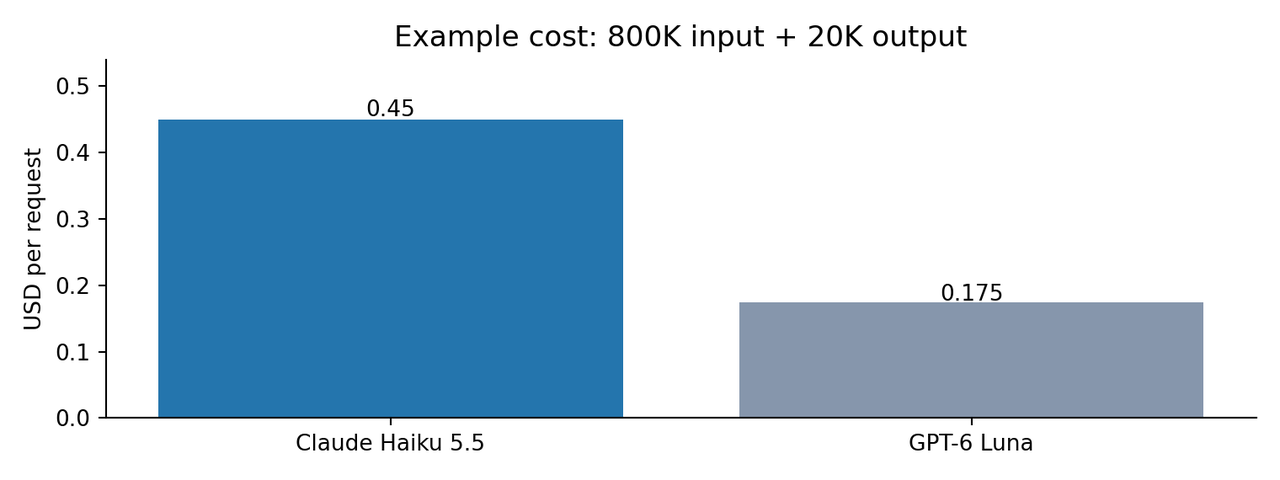
Estimativa de tarifa padrão sem cache calculada pelo autor: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Saída” significa a saída total cobrada para esta estimativa, incluindo tokens de raciocínio quando cobrados como saída; não é necessariamente o comprimento visível da resposta. As mesmas contagens de tokens reportadas são usadas para ambos os modelos, embora os tokenizers possam diferir.
Um token barato não é necessariamente um resultado bem-sucedido barato. As equipes devem considerar tentativas repetidas, chamadas de ferramentas com falha, consumo de tokens de raciocínio e diferentes comportamentos de tokenizer.
Acesso via CometAPI e restrições de integração
A CometAPI oferece opções de acesso para ambos os modelos. Antes de compará-los ou implantá-los por meio do gateway, verifique IDs de modelo, endpoints suportados, parâmetros de requisição, comportamento de ferramentas e regras de cobrança para cada rota. Esses links de provedores documentam opções de acesso; eles não substituem as fontes técnicas ou de preços padrão dos fornecedores.
Para integrações diretas com a OpenAI, a Luna suporta ferramentas integradas por meio da Responses API; a chamada de função do Chat Completions requer esforço de raciocínio none. O Haiku usa a Messages API da Anthropic e pensamento adaptativo. Um gateway não torna os esquemas subjacentes intercambiáveis: valide definições de ferramentas, comportamento de saída estruturada, eventos de streaming e contabilização com a rota exata que você pretende usar.
Como os desenvolvedores podem comparar Claude Haiku 5.5 e GPT-6 Luna com o mesmo prompt?
Exemplo de extração de documento longo
Uma comparação prática pode usar um pacote de contratos de fornecedores contendo datas de vigência, termos de renovação, períodos de aviso e exceções. Mantenha o pacote de documentos, as instruções de extração, os campos esperados e as regras de validação idênticos. A seguir está um desenho de avaliação, não um novo resultado de modelo medido.
Exemplo de prompt: Extraia o nome do fornecedor, a data de vigência, a data de renovação, o período de aviso de rescisão e as exceções de preços de cada contrato. Para cada valor extraído, cite o título do documento e a passagem exata de suporte. Retorne null quando um campo estiver ausente; não infira datas faltantes. Sinalize cláusulas conflitantes e mantenha a resposta final dentro de 1.000 palavras.
| Verificação | Critério de aceitação | O que registrar |
|---|---|---|
| Precisão de extração | Campos obrigatórios correspondem a um gabarito verificado independentemente | Valores corretos, incorretos e ausentes |
| Fundamentação | Todo campo não nulo tem uma passagem de suporte válida | Alegações sem suporte e citações de documento incorretas |
| Seguimento de instruções | Nenhuma data inventada; campos ausentes retornam null | Falhas de esquema e violações de restrições |
| Economia | Calcular gasto por extração aceita | Entrada cobrada, saída, raciocínio, novas tentativas e custo de fallback |
| Latência | Comparar conclusão do job sob a mesma política de ferramentas | Tempo até o primeiro token e tempo fim a fim |
Execute mais de um pacote representativo e repita os casos em que os resultados variem. Comece com o mesmo nível de esforço disponível e, em seguida, teste uma configuração de menor custo para cada modelo. Informe tamanho da amostra, configurações, rota, data e contagens de falhas antes de apresentar um vencedor.
Haiku 5.5 ou GPT-6 Luna: qual escolher?
| Dimensão | Ponto de partida mais indicado | Limite de decisão |
|---|---|---|
| Interação com GUI | Claude Haiku 5.5 | As pontuações parciais compartilhadas do OSWorld favorecem o Haiku; verifique a conclusão completa da tarefa |
| Codificação em terminal | Claude Haiku 5.5 | As pontuações compartilhadas do Terminal-Bench favorecem o Haiku; valide alterações no repositório |
| Prompts curtos e preços base | Teste ambos | Tarifas base idênticas; compare uso cobrado e novas tentativas |
| Prompts acima de 100K tokens | GPT-6 Luna em tarifas padrão | A Luna mantém o nível base por mais tempo; a precisão pode alterar o custo total |
| Vazão de tokens em streaming | Claude Haiku 5.5 no instantâneo datado | Vazão difere do tempo total de conclusão |
| Extração simples e repetida | Teste a Luna com raciocínio baixo ou nenhum | Selecione por saída válida aceita, e não apenas por preço |
Escolha o Claude Haiku 5.5 para tarefas interativas relevantes aos benchmarks
Comece com o Haiku quando sua aplicação se assemelhar às tarefas publicadas de computador gráfico, codificação em terminal ou trabalho profissional, e quando uma taxa de conclusão mais alta compensar o gasto extra de raciocínio ou contexto longo. Confirme essa vantagem na sua própria pilha de ferramentas antes de rotear tráfego de produção.
Escolha o GPT-6 Luna para controle de custo em prompts grandes
Comece com a Luna quando os prompts frequentemente excedem 100K tokens e os custos padrão de tokens afetam materialmente seu orçamento. Ela também é candidata para extração repetida ou roteamento que pode ter sucesso com pouco ou nenhum raciocínio. Mantenha a recomendação condicional às taxas de resultados aceitos e ao uso efetivamente cobrado.
Use ambos quando as cargas de trabalho tiverem necessidades diferentes
Um piloto pode rotear extração de documentos longos para a Luna e tarefas de GUI ou terminal para o Haiku, depois validar cada escolha contra verificações de aceitação. Acione um fallback quando uma saída falhar na validação de esquema, carecer de evidência exigida ou falhar em uma verificação específica da tarefa, e inclua custos e latência do fallback na comparação.
Valide antes de trocar
Inclua seu modelo atual como linha de base. Só mude quando o candidato atender a uma meta de correção predefinida e melhorar o custo por resultado aceito ou a latência fim a fim o suficiente para cobrir migração e manutenção. Adie o rollout se erros críticos de ferramentas aumentarem. A recomendação muda se seu piloto mostrar que a tarifa mais baixa da Luna é compensada por novas tentativas, ou que as pontuações mais altas do Haiku em benchmarks não melhoram o sucesso da sua tarefa.
- Use uma amostra representativa da carga de trabalho e classifique resultados corretos, incorretos e incompletos.
- Meça latência do primeiro token, tempo de tarefa de ponta a ponta e confiabilidade das ferramentas.
- Acompanhe separadamente contagens de tokens de entrada, em cache, de saída e de raciocínio.
- Calcule o custo por resultado bem-sucedido, incluindo novas tentativas e fallbacks.
- Compare esforço de raciocínio médio e alto antes de ativar configurações máximas por padrão.
Conclusão
O Claude Haiku 5.5 tem evidência de lançamento mais forte frente a frente nos benchmarks de trabalho profissional, uso de computador e codificação orientada a agentes aqui comparados. Ele também tem maior vazão de saída no instantâneo independente. O GPT-6 Luna tem uma vantagem clara de tarifas padrão para prompts acima do limite de 100K do Haiku e um custo ponderado por tarefa de avaliação mais baixo. Nenhuma dessas observações, por si só, determina confiabilidade em produção ou custo por resultado bem-sucedido.
O vencedor prático é o modelo que entrega um resultado aceitável ao menor custo operacional plenamente medido. Execute ambos com seus próprios prompts, ferramentas e regras de nova tentativa, em vez de tratar um único benchmark como resposta.
Perguntas frequentes
Por que os custos das tarefas podem diferir quando ambos os modelos têm os mesmos preços base por token?
O mesmo preço base não significa a mesma fatura total. Os modelos podem usar quantidades diferentes de tokens de entrada, saída e raciocínio, e podem exigir números distintos de novas tentativas ou chamadas de ferramentas para produzir um resultado aceitável. Tarifas de contexto longo e uso de cache também afetam o total. Compare o custo total de todas as tentativas dividido pelo número de resultados aceitos, e não apenas os preços por token.
Tarifas mais altas de contexto longo se aplicam apenas aos tokens acima do limite?
Não. Sob a precificação padrão descrita neste artigo, cruzar o limite de entrada aplica as tarifas mais altas à solicitação, não apenas aos tokens excedentes. Por exemplo, uma solicitação com 150K tokens de entrada cruza o limite de 100K do Haiku, mas permanece dentro do nível base da Luna a 272K. Use as tarifas de entrada e saída aplicáveis para toda a solicitação ao estimar custo.
Claude Haiku 5.5 e GPT-6 Luna podem compartilhar um cache de prompt?
Não presuma que entradas de cache sejam transferíveis entre modelos ou provedores. Projete estratégias de reutilização separadas e meça taxas de acerto e uso cobrado em cada rota. Suporte do gateway, regras de retenção e estrutura de requisição podem afetar se a entrada repetida é elegível para cache; verifique isso antes de prever economias.
O que um teste de migração do Haiku para a Luna deve cobrir?
Teste entradas representativas de texto e imagem, campos estruturados exigidos, argumentos de ferramentas, respostas em streaming e recuperação de erros. Estabeleça a taxa de aceitação do seu sistema atual antes da migração e compare ambos os candidatos sob as mesmas políticas de nova tentativa e ferramentas. Preços de token semelhantes ou categorias de modelo não estabelecem compatibilidade.
Pontuações de benchmarks devem acionar fallback para Haiku ou Luna?
Use as pontuações para escolher candidatos e, depois, acione fallbacks com base em falhas observadas, como argumentos de ferramentas inválidos, campos obrigatórios ausentes ou verificações de tarefa não atendidas. Acompanhe a frequência de fallback e o custo total cobrado. Um segundo modelo pode adicionar latência e despesas, então verifique se ele melhora resultados aceitos em vez de apenas produzir uma segunda resposta.
Dados sensíveis podem ser roteados por ambas as APIs?
Revise exatamente os fornecedores e o gateway envolvidos, suas configurações atuais de retenção, locais de processamento, termos contratuais e a política de dados da sua organização antes de rotear entradas sensíveis. Capacidade do modelo e tabelas de preços não estabelecem a elegibilidade de uma rota para dados regulados ou confidenciais. Use a rota aprovada quando esses requisitos forem decisivos.