

TL;DR
Claude Opus 5.5 é um forte candidato inicial porque oferece preços de tokens substancialmente mais baixos enquanto iguala ou supera o Fable 5.1 em várias avaliações publicadas, cobrando $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída, comparado ao Fable 5.1 a $10 e $50.
Fable 5.1 ainda tem um papel quando uma tarefa é incomumente difícil, de longa duração, cara de refazer ou destinada a operar sem supervisão próxima. A regra prática é simples: comece com o Opus 5.5, depois escale apenas quando testes representativos de produção mostrarem que o Fable 5.1 reduz falhas, correções ou custos de repetição o suficiente para justificar seu prêmio.
Claude Opus 5.5 vs Claude Fable 5.1 em resumo
| Dimensão | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Data de lançamento | 22 set. 2026 | 1 set. 2026 |
| ID do modelo na API | claude-opus-5-5 | claude-fable-5-1 |
| Contexto / saída máx. | 1M / 128K | 1M / 128K |
| Entrada / saída por MTok | $4 / $20 | $10 / $50 |
| Leitura de cache por MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66,4% | 55,8% |
| FrontierCode v1.1 | 54,4% | 50,3% |
| CursorBench 4.0 | 57,8% | 51,8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Migração HAProxy C->Rust | 9,5 horas; custo de tarefa 51% menor | 12 horas; custo de tarefa de referência |
| Opção de velocidade | Modo Fast, até 2,5× a velocidade normal | Sem modo equivalente no lançamento |
| Ponto de esforço inicial | Orientado a médio | Alto |
| Melhor uso padrão | Codificação de fronteira diária, agentes, produção supervisionada e alto volume | Trabalho de maior valor, difícil, de longa duração ou autônomo |
| Acesso à API | Anthropic API e provedores compatíveis, incluindo CometAPI | Anthropic API e provedores compatíveis, incluindo CometAPI |
Nota de leitura: As figuras de benchmark são relatadas pela Anthropic e dependem de nível de esforço, harness, salvaguardas, versão da tarefa, contagem de tentativas e erro padrão. Devem ser comparadas apenas sob condições de avaliação equivalentes.
Principais conclusões
- As tarifas padrão de entrada e saída do Opus 5.5 são 60% menores que as do Fable 5.1.
- Ambos os modelos suportam janela de contexto de 1M tokens e até 128K de saída, portanto custo, configurações de esforço e ajuste ao workload importam mais do que o tamanho nominal do contexto.
- Os resultados publicados pela Anthropic favorecem o Opus 5.5 em muitas avaliações de codificação e agentes, mas as configurações de benchmark afetam materialmente o resultado.
- Avaliação independente sustenta a posição de fronteira do Opus 5.5 ao relatar pontuações absolutas diferentes, reforçando a necessidade de testes compatíveis.
- Para a maioria dos trabalhos de produção supervisionados, o Opus 5.5 é o ponto de partida mais forte. O Fable 5.1 é um nível de escalada, não o padrão automático.
O que é o Claude Opus 5.5?
Claude Opus 5.5 é o primeiro modelo Claude 5.5 da Anthropic. É posicionado para codificação agentic, agentes de longa duração, trabalho profissional de conhecimento, fluxos de trabalho empresariais, análise financeira, visão e uso de computador.
Seu ID de modelo na API é claude-opus-5-5. O pensamento adaptativo está sempre ativado, enquanto os desenvolvedores controlam a intensidade do raciocínio por meio dos níveis de esforço low, medium, high, xhigh e max. A Anthropic também oferece o Fast mode, que pode operar até 2,5 vezes mais rápido que o normal por $8/M de entrada e $40/M de saída.
O que é o Claude Fable 5.1?
Claude Fable 5.1 é posicionado para projetos exigentes e de longa duração, como codificação de múltiplas horas, pesquisa complexa, interação com navegador, agentes autônomos e fluxos de trabalho que abrangem vários aplicativos.
Seu ID de modelo na API é claude-fable-5-1. Ele usa pensamento adaptativo, parte de uma configuração de esforço de API mais alta e deve ser tratado como a opção premium quando o custo esperado de falha ou repetidas tentativas supera o custo adicional de inferência.
Uma leitura simplificada seria que o Opus 5.5 oferece quase o mesmo envelope por 40% do preço padrão de tokens do Fable. Mas é precisamente aqui que uma tabela simples de especificações se torna enganosa.
Comparação de código e benchmarks
A Anthropic relata o Opus 5.5 à frente do Fable 5.1 no Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam com ferramentas, Terminal-Bench-Science, OSWorld 2.0 e Chartography.
Como ler os resultados de benchmark
A Anthropic relata o Opus 5.5 à frente do Fable 5.1 no Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam com ferramentas, Terminal-Bench-Science, OSWorld 2.0 e Chartography. Essas cifras são resultados de avaliação, não constantes do modelo independentes de configuração.
A maioria das pontuações de destaque do Opus 5.5 usou esforço max, enquanto o Terminal-Bench 4.0 usou esforço xhigh. Design do harness, configuração de ferramentas, salvaguardas, contagem de tentativas, erro padrão, comportamento de fallback e tetos de custo podem todos mudar o resultado. A própria Anthropic adverte que margens de benchmark podem superestimar a diferença prática entre modelos de fronteira.
Desempenho em codificação
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretação |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | Vantagem relatada de 10,6 pontos para tarefas agenticas em terminal |
| FrontierCode v1.1 | 54,4% max; 54,6% medium | 50,3% | Opus 5.5 em esforço médio permanece competitivo para economia de produção |
| CursorBench 4.0 | 57,8% max; 52,5% medium | 51,8% | Esforço médio supera ligeiramente o resultado relatado do Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Vantagem relatada em trabalho agentic profissional |
Essas cifras são resultados de benchmark relatados pela Anthropic. A tabela deve ser lida em conjunto com as ressalvas de configuração de avaliação nas seções seguintes e com a página oficial do modelo Claude Opus.
Os três primeiros resultados se destacam porque cobrem o workload em que o Claude está cada vez mais importante comercialmente: agentes de engenharia de software. O Terminal-Bench 4.0 mostra uma diferença absoluta de 10,6 pontos percentuais; o FrontierCode mostra 4,1 pontos; o CursorBench 4.0 mostra 6 pontos.
O GDPval-AA, que mede trabalho agentic profissional, também relata 1846 Elo para o Opus 5.5 versus 1735 para o Fable 5.1. Se essas cifras fossem toda a história, a hierarquia do produto pareceria invertida. Não é tão simples.
Avaliação independente
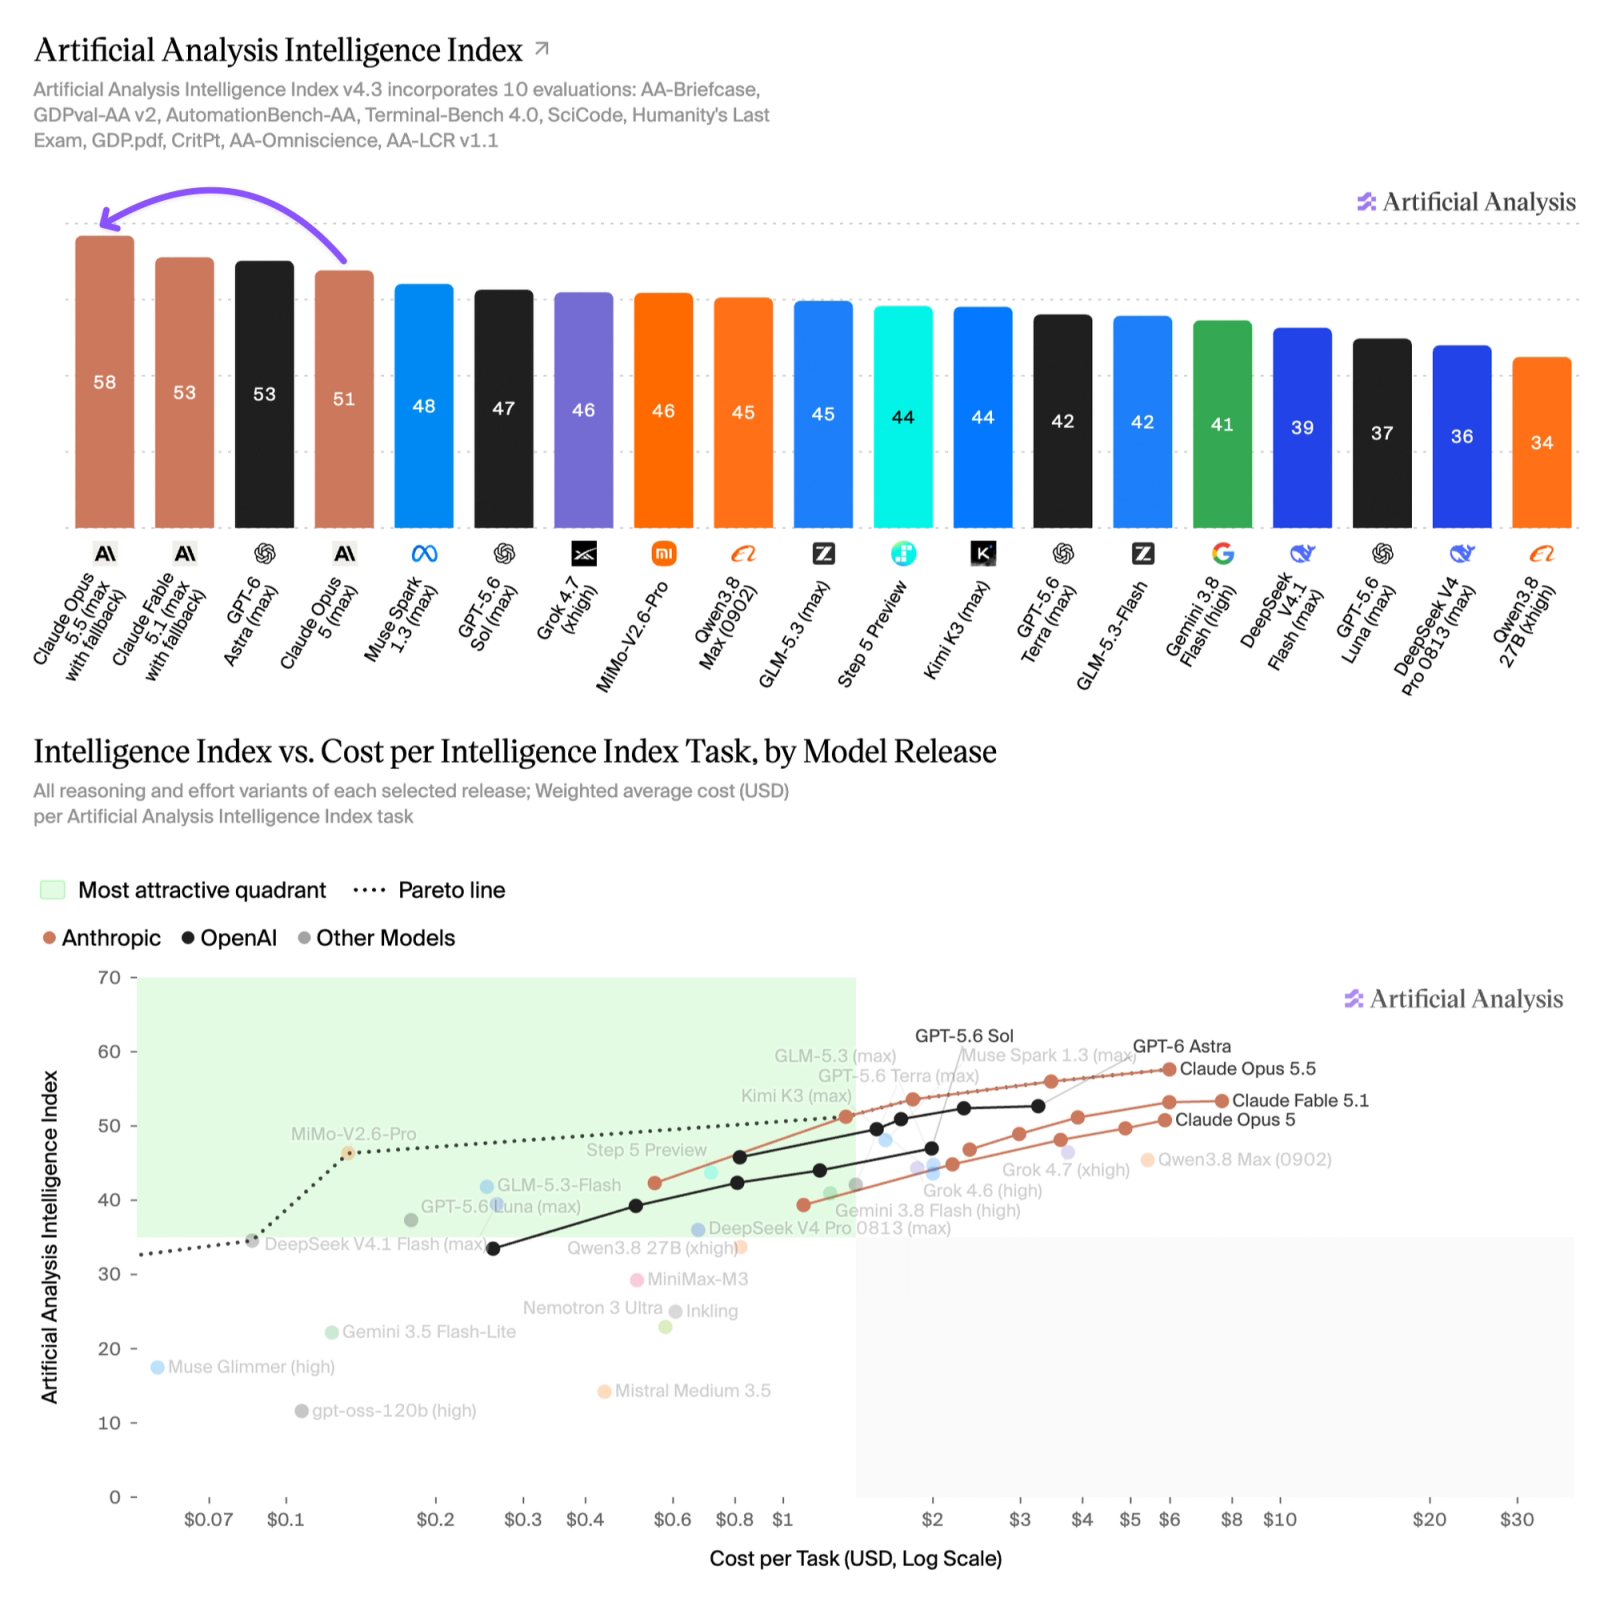
Artificial Analysis colocou o Opus 5.5 Max em 58 no seu Intelligence Index e relatou resultados fortes em AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode e Humanity's Last Exam. Seu resultado no Terminal-Bench 4.0 foi 59,6%, abaixo dos 66,4% da Anthropic, demonstrando por que as equipes devem documentar a versão do modelo, nível de esforço, harness, ferramentas, contagem de tentativas e limite de custo sempre que as pontuações divergirem.
Comparação de preço e custo por tarefa concluída
A CometAPI oferece preços de tokens inferiores às tarifas oficiais, permitindo que os desenvolvedores alcancem o mesmo desempenho da API oficial usando o formato padrão de requisição de mensagens.
Preços de tokens
| Preço | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Entrada | $4 | $10 |
| Saída | $20 | $50 |
| Cache write 5 min | $5 | $12.50 |
| Cache write 1 hora | $8 | $20 |
| Leitura de cache | $0.20 | $0.25 |
| Lote entrada/saída | Desconto de 50% | Desconto de 50% |
Suponha que um workload consuma 10 milhões de tokens de entrada novos e 2 milhões de tokens de saída. Sem efeitos de cache:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Nessas condições, o Opus 5.5 custa 60% menos. No entanto, esse número não deve ser confundido com a declaração da Anthropic de que o Opus 5.5 custa cerca de 40% menos para operar do que o Opus 5.
São duas comparações completamente diferentes. A cifra de 40% inclui os preços mais baixos do nível Opus 5.5 e a redução do consumo de tokens por tarefa em relação ao Opus 5. A cifra de 60% vem diretamente da comparação dos preços de lista padrão do Opus 5.5 e do Fable 5.1.
Custo por tarefa concluída
Uma API de modelo não vende realmente tokens. Desenvolvedores compram trabalho concluído.
Uma equipe de desenvolvimento não se importa que um modelo consumiu 6,2 milhões de tokens. Importa se o modelo corrigiu o bug, completou a migração, passou a suíte de testes ou finalizou a pesquisa.
A Anthropic destaca isso diretamente em sua análise What a task costs on Opus 5.5: dois modelos com preços semelhantes podem ter custos de tarefa muito diferentes se um precisar de mais turnos, reler mais contexto, repetir mais vezes ou gerar mais tokens de “thinking”.
Custo da tarefa = Custo de entrada nova
                + Custo de leitura de cache
                + Custo de escrita de cache
                + Custo de saída / thinking
                + Custo de repetição
Esse último item é frequentemente negligenciado. Um modelo mais barato que falha duas vezes pode se tornar mais caro do que um modelo mais caro que conclui a tarefa em uma execução. Da mesma forma, um nível de esforço alto que evita dez turnos de repetição pode, na verdade, reduzir o custo total.
Economia de cache de prompt
Agentes com uso pesado de cache reutilizam repetidamente definições de ferramentas, contexto de repositório, instruções de sistema, histórico de conversas e saída de testes. Como o preço de leitura de cache é $0,20/M para o Opus 5.5 e $0,25/M para o Fable 5.1, a diferença é muito menor do que a diferença de $6/M no preço de entrada nova. Portanto, as equipes devem acompanhar separadamente entrada nova, leituras de cache, escritas de cache, saída, turnos de ferramenta e repetições.
Economia por nível de esforço
Potencialmente, sim. O Artificial Analysis testou cinco níveis de esforço do Opus 5.5 e encontrou uma curva clara de capacidade-custo.
| Esforço no Opus 5.5 | Índice de Inteligência do Artificial Analysis | Custo por tarefa do Índice |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
O esforço Medium é um ponto de partida sensato para mudanças de código rotineiras, refatorações conhecidas e depuração supervisionada. High ou xhigh podem ser justificados para falhas de sistema ambíguas, migrações noturnas ou tarefas em que um plano errado gera retrabalho substancial.
Comparação de segurança e confiabilidade
Nenhum modelo deve ser rotulado como mais seguro apenas com base em benchmarks de capacidade. Uma comparação defensável requer prompts, ferramentas, permissões, níveis de esforço, limites de repetição e critérios de aceitação compatíveis. Maior capacidade pode reduzir erros acidentais, mas maior autonomia e execução mais longa também aumentam o impacto de um plano ruim, prompt injection, chamada de ferramenta insegura ou desvio não percebido.
| Dimensão de segurança | Comparação prática | Controle em produção |
|---|---|---|
| Raciocínio e esforço | O Opus 5.5 expõe múltiplos níveis de esforço, enquanto o Fable 5.1 parte de uma postura de esforço mais alta. Mais raciocínio não substitui a aplicação de políticas. | Fixe a política de esforço por workload e reteste o comportamento de segurança sempre que ela mudar. |
| Autonomia de longa duração | O Fable 5.1 é posicionado para trabalho difícil e sem supervisão; o Opus 5.5 também suporta fluxos agenticos. O risco cresce com duração, permissões e ações irreversíveis. | Use checkpoints, etapas de aprovação, tetos de tempo e custo e condições automáticas de rollback ou desligamento. |
| Uso de ferramentas e PC | Ambos os modelos podem operar ferramentas, portanto a escolha do modelo por si só não controla exposição de dados ou ações destrutivas. | Aplique privilégio mínimo, allowlists, sandboxing, isolamento de segredos e confirmação antes de ações externas ou irreversíveis. |
| Avaliação e auditabilidade | Pontuações públicas de benchmark não estabelecem qualidade de recusas, resistência a prompt injection ou taxas de incidentes em produção. | Registre chamadas de ferramentas e decisões de política; meça taxa de conformidade insegura, recusas falsas, sucesso de injeção, vazamento de segredos e recuperação. |
Regra prática de segurança: comece com a configuração de Opus 5.5 com o menor privilégio que atenda à tarefa e escale para o Fable 5.1 somente após a mesma suíte de segurança ser aprovada. Para fluxos de trabalho de alto impacto, exija aprovação humana independentemente de qual modelo pontue mais alto em testes de capacidade.
- Execute testes adversariais de prompt injection e exfiltração de dados com o conjunto real de ferramentas de produção.
- Separe permissões de leitura, escrita, publicação, exclusão e financeiras em vez de conceder um único papel amplo de ferramenta.
- Defina gatilhos de rollback para violações de política, falhas repetidas de ferramenta, expansão inesperada de escopo e estouros de custo.
- Revalide após alterações de modelo, prompt do sistema, esforço, ferramentas, permissões ou roteamento.
Como escolher entre Opus 5.5 e Fable 5.1
| Workload | Ponto de partida recomendado | Condição para escalada |
|---|---|---|
| Codificação diária e code review | Opus 5.5, esforço médio | Escale apenas para casos incomumente difíceis ou de alto risco |
| Trabalho de feature multi-arquivo | Opus 5.5, médio ou alto | Use Fable quando falhas repetidas de planejamento dominarem o custo |
| Migração no repositório todo | Teste Opus 5.5 high ou xhigh primeiro | Escale para os projetos autônomos mais difíceis |
| Execuções autônomas noturnas | Opus 5.5 com checkpoints rígidos | Prefira Fable quando o custo de uma direção incorreta for extremo |
| Tráfego de API de alto volume | Opus 5.5 | Escale apenas a minoria de tarefas propensas a falhas |
| Implantação Fable validada | Mantenha a atual durante os testes | Troque apenas depois que o Opus cumprir os mesmos thresholds |
Um teste prático de produção
Execute as mesmas tarefas representativas, prompts, ferramentas, política de esforço, critérios de aceitação e limites de repetição em ambos os modelos. Registre taxa de tarefas aceitas, latência, entrada nova e em cache, tokens de saída e thinking, chamadas de ferramentas, repetições, correções humanas e custo total por resultado aceito. Inclua tarefas rotineiras e casos difíceis com falha.
Orientações de migração para usuários existentes do Claude Opus 5
Usuários existentes do Opus 5 devem testar o Opus 5.5 como sucessor, em vez de assumir que trocar o ID do modelo é isento de risco. Compare profundidade de planejamento, padrões de chamadas de ferramenta, comprimento de resposta, conformidade de formato, latência, comportamento de cache de prompt, recuperação de chamadas de ferramenta com falha, roteamento de segurança e custo por tarefa concluída. Mantenha critérios de rollback e o modelo existente disponível até que o Opus 5.5 passe em testes com aceitação semelhante à produção.
Usuários existentes do Fable 5.1 não precisam de uma seção genérica de migração. Devem tratar o Opus 5.5 como uma otimização candidata e avaliá-lo sob os mesmos critérios de aceitação de produção antes de mudar uma implantação validada.
Acesso via CometAPI
Desenvolvedores que avaliam qualquer modelo podem revisar os guias relacionados da CometAPI para Claude Opus 5.5 e Claude Fable 5.1. Ao integrar por qualquer provedor de API compatível, confirme o ID exato do modelo, parâmetros de esforço suportados, comportamento de cache, limites de taxa, disponibilidade regional e preço atual antes da implantação em produção.
Use claude-opus-5-5 para o Opus 5.5 e claude-fable-5-1 para o Fable 5.1 onde esses identificadores forem suportados. Evite rotear silenciosamente ambas as classes de workload por um único nível de esforço fixo; seleção de modelo e política de esforço devem ser configuradas independentemente.
Python — Anthropic Messages API via CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analise esta base de código e proponha um plano de migração seguro."),}],)print(message.content[0].text)
Conclusão
O Claude Opus 5.5 altera a fronteira prática entre o modelo diário de fronteira da Anthropic e seu nível premium de escalada. Ele é substancialmente mais barato nas tarifas padrão de tokens, lidera muitos benchmarks de codificação e agentes publicados e oferece flexibilidade de esforço suficiente para cobrir uma ampla faixa de produção.
O Claude Fable 5.1 permanece relevante quando a tarefa é difícil, de alto valor, longa ou autônoma e o custo de falha supera a conta de inferência mais alta. Para a maioria das equipes, a melhor política é começar com o Opus 5.5, medir os resultados por tarefa concluída e escalar seletivamente.
Perguntas frequentes
Como as equipes devem desenhar um teste A/B de produção para Opus 5.5 e Fable 5.1?
Use as mesmas tarefas representativas, prompts, ferramentas, política de esforço, critérios de aceitação e limites de repetição para ambos os modelos. Registre taxa de tarefas aceitas, latência, entrada nova e em cache, tokens de saída e thinking, chamadas de ferramentas, repetições, correções humanas e custo total por resultado aceito. Execute tarefas suficientes para capturar trabalho rotineiro e casos difíceis com falha.
Quando preços de tokens mais baixos podem não reduzir o custo total por tarefa?
Um modelo com preço mais baixo ainda pode custar mais se precisar de mais turnos, reler contexto adicional, produzir mais tokens de thinking ou necessitar de repetidas repetições. O comportamento de cache também importa: a diferença de preço de entrada se estreita em sessões longas dominadas por leituras de cache. Compare custo por tarefa concluída em vez de apenas o preço de lista.
O que deve ser documentado quando resultados de benchmark discordam?
Registre a versão do modelo, nível de esforço, harness, configurações de fallback e segurança, número de tentativas, versão da tarefa, erro padrão e teto de custo. Rotule cada resultado como oficial ou independente e evite combinar pontuações de configurações incompatíveis em um único ranking.
Quais riscos de migração os usuários atuais do Fable 5.1 devem monitorar?
Observe mudanças na profundidade de planejamento, padrões de chamadas de ferramenta, comprimento de resposta, conformidade de formato, latência, comportamento de cache de prompt, recuperação de falhas e roteamento de segurança. Mantenha a implantação existente disponível durante a avaliação, estabeleça critérios de rollback e migre apenas depois que o Opus 5.5 atingir os mesmos thresholds de aceitação em tarefas semelhantes às de produção.
Metadados de SEO
Meta title: Claude Opus 5.5 vs Fable 5.1: Código, Custo e Benchmarks
Meta description: Compare Claude Opus 5.5 e Claude Fable 5.1 em benchmarks de codificação, preços de API, velocidade, caching, níveis de esforço, custo por tarefa concluída e ajuste de workload.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, benchmarks de codificação do Claude, preços da Claude API, CometAPI, modelos de IA para codificação
URL slug: claude-opus-5-5-vs-claude-fable-5-1