
TL;DR
Claude Opus 5.5 e Claude Sonnet 5.5 oferecem contexto de 1M e saída padrão máxima de 128K, com entrada de texto e imagem e corte de conhecimento em junho de 2026. Opus é voltado para trabalhos complexos e abertos; Sonnet visa execução mais rápida em tarefas do dia a dia com escopo definido.
Nas tarifas padrão da API da Anthropic, Sonnet 5.5 custa $2/M de entrada e $10/M de saída, exatamente metade dos $4/M de entrada e $20/M de saída do Opus 5.5. Várias pontuações publicadas são próximas, mas a classificação varia por benchmark. Opus pontua mais alto no CursorBench, enquanto Sonnet pontua mais alto no Terminal-Bench. Esses resultados usam configurações de esforço diferentes e não devem ser tratados como um teste controlado frente a frente.
Escolha o modelo que atenda aos seus requisitos de qualidade e latência com o menor custo total por tarefa. As equipes devem comparar custo por tarefa aceita, latência, comportamento de chamadas de ferramentas, novas tentativas e a quantidade de julgamento necessária antes de decidir onde o Opus justifica seu prêmio.
Principais pontos
- Preço: o Sonnet 5.5 tem metade do preço padrão de entrada/saída do Opus 5.5.
- Especificações: ambos suportam janela de contexto de 1M tokens e até 128K de saída padrão.
- Codificação: Opus lidera FrontierCode e CursorBench, enquanto Sonnet apresenta o resultado Terminal-Bench 4.0 publicado mais alto.
- Trabalho de conhecimento: Opus mantém uma pequena vantagem no GDPval-AA e AA-Briefcase.
- Implantação: teste o Sonnet mais rápido para execução com escopo e o Opus para escalonamento de complexidade; valide ambos em relação a metas de qualidade, latência e custo.
Claude Opus 5.5 vs Sonnet 5.5 em resumo
| Fator de decisão | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Contexto / saída padrão máxima | 1M / 128K | 1M / 128K |
| Modalidades de entrada/saída | Texto + imagem -> texto | Texto + imagem -> texto |
| Raciocínio | Pensamento adaptativo, sempre ativo | Pensamento adaptativo |
| Esforço padrão na Claude Platform | Médio | Alto |
| Preço oficial de entrada/saída | $4 / $20 por 1M | $2 / $10 por 1M |
| Leitura de cache | $0.20 / 1M | $0.10 / 1M |
| Latência comparativa | Moderada | Rápida |
| Destaque em codificação | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| Destaque em trabalho de conhecimento | GDPval-AA 1846 | GDPval-AA 1844 |
| Ajuste principal | Trabalho complexo, ambíguo e de longa duração | Trabalho de produção rápido, com escopo definido e repetível |
Claude Opus 5.5
Claude Opus 5.5 foi lançado em 22 de setembro de 2026 como o primeiro modelo da família Claude 5.5. A Anthropic o posiciona para codificação avançada, agentes complexos, trabalho profissional de conhecimento e fluxos de trabalho de longa duração, onde preservar a intenção ao longo de muitas etapas importa mais do que a latência mínima.
Seu comportamento operacional mais distintivo é o pensamento adaptativo sempre ativo. Os desenvolvedores podem controlar o esforço de raciocínio, mas o pensamento adaptativo em si não pode ser desativado. Isso torna importantes os testes de migração para agentes mais antigos que anteriormente dependiam de um caminho com pensamento desativado ou de padrões de esforço diferentes.
A API do Claude Opus 5.5 na CometAPI fornece uma rota unificada para o mesmo ID de modelo, claude-opus-5-5, ao lado de outros modelos para roteamento de cargas de trabalho.
Claude Sonnet 5.5
Claude Sonnet 5.5 foi lançado em 28 de setembro de 2026 como o segundo modelo da família Claude 5.5. A Anthropic o descreve como um complemento mais rápido e de menor custo ao Opus 5.5 para trabalhos do dia a dia bem definidos, incluindo correção de bugs, criação de documentos, codificação, agentes e tarefas orientadas a design.
A Anthropic relata que o Sonnet 5.5 gera saída mais de 30% mais rápido que o Sonnet 5 e pode custar até 30% menos por tarefa do que seu antecessor. Essas são comparações relatadas pelo provedor com o Sonnet 5, não métricas de velocidade ou custo por tarefa medidas contra o Opus 5.5.
A API do Claude Sonnet 5.5 na CometAPI usa o ID de modelo claude-sonnet-5-5 e é adequada para testar o Sonnet como a camada de execução de menor custo em aplicativos de modelo misto.
Claude Opus 5.5 vs Sonnet 5.5: Desempenho
Os resultados publicados pela Anthropic mostram pequenas diferenças de pontuação em várias avaliações de trabalho de conhecimento e uso de computador. Opus relata pontuações mais altas no FrontierCode, CursorBench e Humanity’s Last Exam, enquanto Sonnet relata uma pontuação mais alta no Terminal-Bench. As comparações dependem das configurações de esforço e das condições de avaliação.
| Benchmark | Claude Opus 5.5 | Claude Sonnet 5.5 | O que mede |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | Tarefas de agente em linha de comando |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | Engenharia de software do mundo real |
| CursorBench 4.0 | 57.8% | 55.5% | Tarefas ambíguas de codificação multi-arquivo |
| GDPval-AA v2.1 | 1846 | 1844 | Trabalho profissional de conhecimento |
| AA-Briefcase v1.1 | 1822 | 1811 | Trabalho de longo horizonte |
| Humanity's Last Exam, tools | 67.7% | 64.5% | Raciocínio multidisciplinar |
| OSWorld 2.1 | 81.8% | 80.1% | Uso de computador |
| Chartography | 64.4% | 61.6% | Reconhecimento de gráficos visuais |
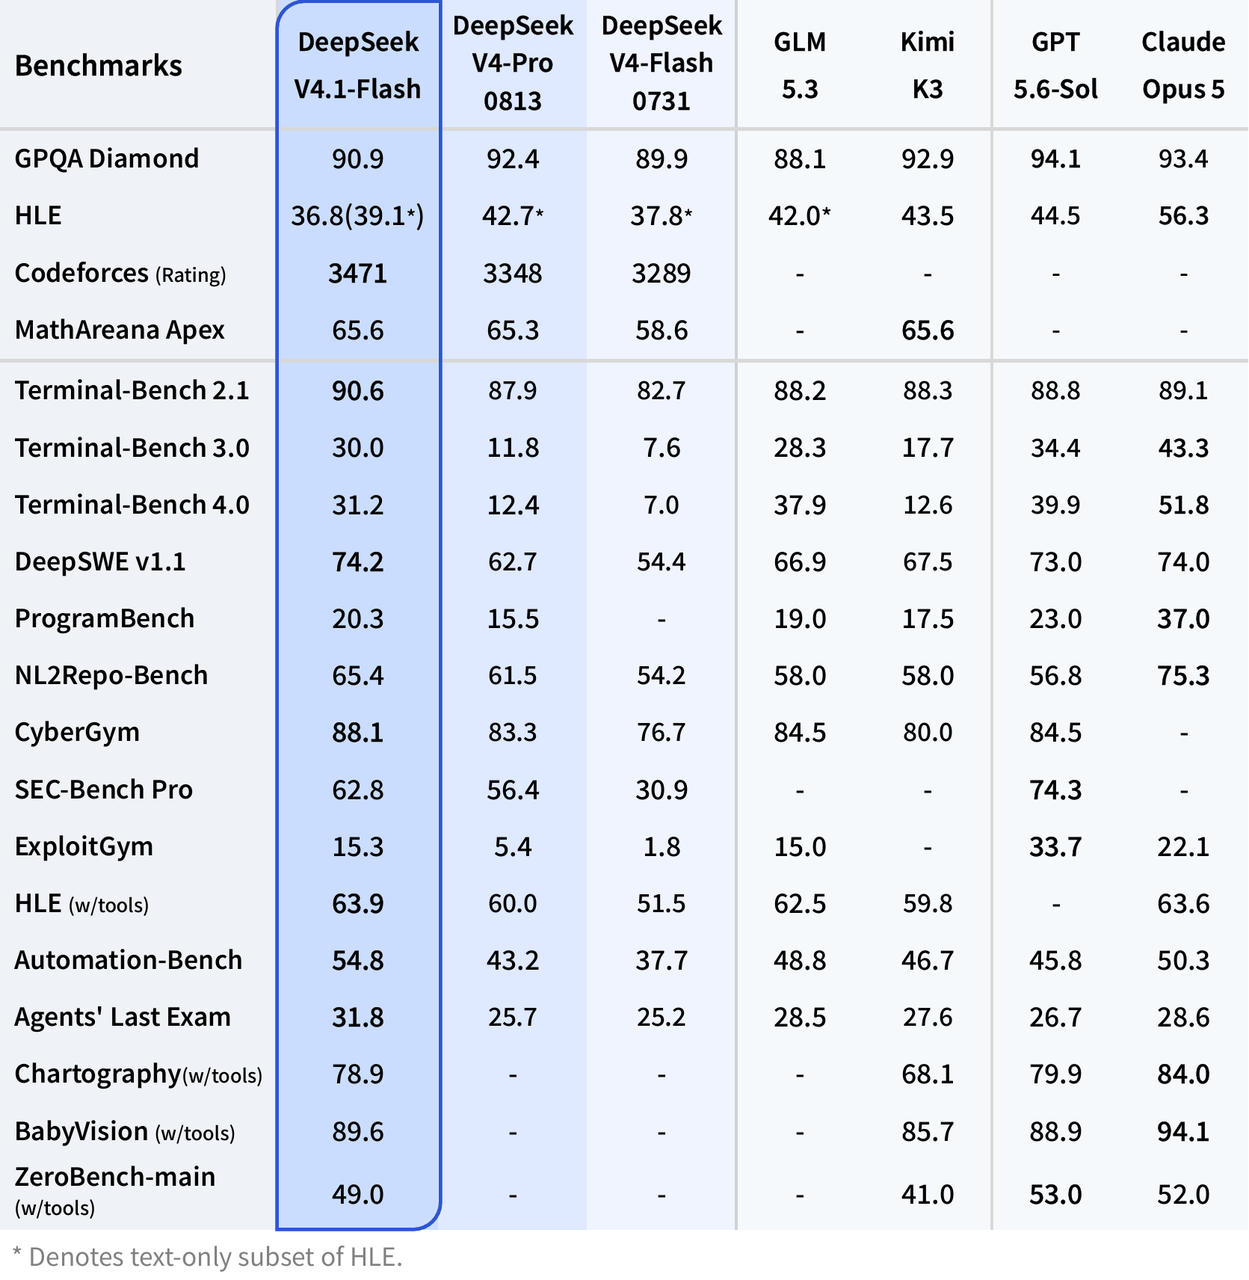
Estes são resultados publicados, não uma comparação controlada conduzida para este artigo.
- Effort: o resultado do Opus no Terminal-Bench usa Xhigh. A pontuação do Sonnet no FrontierCode é mais alta em Xhigh do que em Max.
- Scoring and tools: OSWorld usa pontuação com crédito parcial; os resultados do Chartography aqui não usam ferramentas.
- Deployment: os resultados do Sonnet no GDPval-AA e AA-Briefcase foram medidos em uma implantação pré-lançamento com um bug de saída estruturada que já foi corrigido.
Codificação com agentes
A pontuação de 70.6% do Sonnet 5.5 no Terminal-Bench 4.0 é maior do que a pontuação de 66.4% reportada do Opus 5.5, mas a nota oficial diz que o resultado do Opus é em esforço Xhigh. No FrontierCode 1.1 Main, o Opus lidera com 54.4% contra 46.2% do Sonnet em Max; no CursorBench 4.0, o Opus lidera 57.8% contra 55.5%.
Essa divisão importa porque benchmarks de agentes de codificação recompensam comportamentos diferentes. O Terminal-Bench enfatiza execução multi-etapas bem-sucedida em um ambiente de linha de comando, enquanto o CursorBench usa tarefas ambíguas de múltiplos arquivos de sessões reais de codificação. Para codificação delimitada e execução iterativa, o Sonnet pode ser altamente competitivo; para trabalho mais amplo em escala de repositório, o Opus mantém evidências mais fortes nas avaliações publicadas pela Anthropic.
Trabalho de conhecimento e raciocínio
No GDPval-AA v2.1, o Sonnet 5.5 marca 1844 em comparação com 1846 do Opus 5.5. No AA-Briefcase v1.1 a diferença é 1811 versus 1822. Esses resultados são notáveis porque a diferença de preço é muito maior do que a diferença de benchmark.
A Anthropic identifica o Opus 5.5 como mais forte em trabalho complexo e aberto que exige julgamento sustentado. Para pesquisa, arquitetura e auditorias, teste se esse comportamento reduz decisões incorretas ou correções humanas nas suas próprias tarefas, em vez de inferir uma vantagem econômica a partir de margens pequenas em benchmarks.
Uso de computador e tarefas visuais
No OSWorld 2.1, usando pontuação com crédito parcial, o Opus marca 81.8% e o Sonnet 80.1%. No Chartography sem ferramentas, as pontuações são 64.4% e 61.6%, respectivamente. Para agentes de navegador ou GUI, isso sugere que latência, eficiência de chamadas de ferramentas e custo por tarefa podem importar tanto quanto a diferença de benchmark em destaque.
Interpretação de benchmarks
A história dos benchmarks não é que o Sonnet substituiu o Opus. É que a Anthropic reduziu a distância de capacidade o suficiente para que o formato da carga de trabalho agora importe mais do que apenas o nível do modelo. Tarefas bem definidas e sensíveis à latência favorecem cada vez mais a economia do Sonnet, enquanto ambiguidade, horizontes longos e modos de falha caros permanecem os motivos mais fortes para testar o Opus.
Claude Opus 5.5 vs Sonnet 5.5: Preços
Preços oficiais da Claude API
A especificação de preços do Opus e a especificação de preços do Sonnet distinguem taxas padrão por token, janelas de retenção de cache e descontos do Batch. Os preços abaixo são em USD por milhão de tokens; confirme separadamente modificadores de serviço opcionais.
| Métrica de preços | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M tokens | $4.00 | $2.00 |
| Saída / 1M tokens | $20.00 | $10.00 |
| Leitura de cache / 1M tokens | $0.10 | $0.20 |
| Gravação em cache de 5 minutos / 1M tokens | $5.00 | $2.50 |
| Gravação em cache de 1 hora / 1M tokens | $8.00 | $4.00 |
| Entrada em lote / 1M tokens | $2.00 | $1.00 |
| Saída em lote / 1M tokens | $10.00 | $5.00 |
O Sonnet tem metade das taxas padrão de entrada, saída e gravação em cache.
Leituras de cache seguem a mesma proporção de preço 2:1: o Sonnet 5.5 custa $0.10/M de entrada em cache, enquanto o Opus 5.5 custa $0.20/M. Reutilizar prefixos em cache reduz custos de entrada para ambos os modelos, preservando a menor taxa por token do Sonnet. As economias totais por tarefa ainda dependem do comprimento da saída, gravações em cache, novas tentativas e taxa de aceitação.
Custo por tarefa aceita
Para uma ilustração simples, uma solicitação com 100K tokens de entrada não em cache e 10K tokens de saída custa cerca de $0.60 no Opus 5.5 e $0.30 no Sonnet 5.5 nas taxas padrão. Mas uma diferença de taxa por token de 2x não garante uma diferença de 2x no custo por sucesso. Novas tentativas, chamadas de ferramentas, comprimento da saída, acertos de cache, tentativas fracassadas e correção humana podem alterar o resultado.
Avaliações em produção devem, portanto, registrar o custo por tarefa aceita juntamente com taxa de conclusão, latência p50/p95, novas tentativas, chamadas de ferramentas e intervenção humana.
Preços da CometAPI
O catálogo de modelos da CometAPI anuncia um desconto de 20% em muitas rotas Anthropic suportadas. Para a API do Claude Opus 5.5 na CometAPI, o preço de catálogo referenciado é $3.20/M de entrada e $16/M de saída. Para a API do Claude Sonnet 5.5 na CometAPI, dados localizados do catálogo mostram $1.60/M de entrada e $8/M de saída. Como os preços do gateway podem mudar, confirme a rota de modelo ativa antes de orçar tráfego de produção.
| Tarifa da CometAPI | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M | $3.20 | $1.60 |
| Saída / 1M | $16.00 | $8.00 |
| Desconto relativo vs oficial | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Especificações técnicas
Ambos os modelos compartilham o contexto central e os limites de saída mostrados na tabela “em resumo”. O limite adicional de saída de 300K é um recurso beta da Batch API, em vez do limite de saída interativo padrão.
O comprimento do contexto não é o diferenciador entre esses dois modelos. Ambos suportam a mesma janela de 1M tokens e teto de saída padrão de 128K. As diferenças mais significativas são o comportamento de raciocínio, a velocidade e quanto julgamento difícil a tarefa requer.
A melhoria de velocidade de saída do Sonnet é relatada em relação ao Sonnet 5. O Opus também possui Fast mode com até 2.5x de throughput de tokens de saída, com preço de $8/M de entrada e $40/M de saída. É uma prévia de pesquisa na Claude API; isso não é garantia de tarefas ponta a ponta 2.5x mais rápidas ou tempo até o primeiro token.
Divulgação de arquitetura e comportamento de integração
Os materiais citados não divulgam contagens de parâmetros ou detalhes internos de arquitetura suficientes para uma comparação defensável de denso versus MoE. Compare interfaces e comportamentos documentados. Ambas as migrações exigem testar restrições de escolha de ferramentas e pensamento preservado; o pensamento adaptativo do Opus não pode ser desativado. Valide o estado da conversa ao rotear entre modelos, em vez de encaminhar blocos de pensamento opacos sem verificar compatibilidade.
Claude Opus 5.5 vs Sonnet 5.5: Casos de uso
Uma estratégia útil de implantação é tratar o Sonnet 5.5 como modelo de execução padrão e o Opus 5.5 como modelo de escalonamento. Isso pode reduzir gastos em tarefas bem especificadas e repetíveis, reservando o Opus para trabalhos que se beneficiam de julgamento sustentado. As economias dependem da taxa de aceitação do Sonnet e de com que frequência as tarefas precisam de escalonamento.
Seleção baseada na carga de trabalho
| Carga de trabalho | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Codificação rotineira | Capaz, custo mais alto | Ótimo encaixe |
| Correção de bugs | Útil para casos difíceis | Ótimo encaixe |
| Tráfego de API de alto volume | Maior custo unitário | Ótimo encaixe |
| Geração de documentos/apresentações | Forte | Mais econômico |
| Subagentes de codificação | Usar seletivamente | Ótimo encaixe |
| Migração em escala de repositório | Ótimo encaixe | Testar para trabalho delimitado |
| Arquitetura ambígua | Ótimo encaixe | Depende da complexidade |
| Agentes autônomos de longa duração | Ótimo encaixe | Boa camada de execução |
| Pesquisa/análise difícil | Ótimo encaixe | Bom para trabalho delimitado |
| UX sensível à latência | Moderado | Ótimo encaixe |
| Carga de trabalho de produção mista | Modelo de escalonamento | Modelo de execução padrão |
Um roteador prático pode começar com o Sonnet e escalar quando a tarefa ultrapassar um limiar de ambiguidade, comprimento do loop de ferramentas, falhas repetidas ou impacto no negócio. A regra de roteamento deve ser validada em tarefas semelhantes às de produção em vez de ser presumida a partir de pontuações de benchmark.
Como chamar o Opus 5.5 e o Sonnet 5.5 via CometAPI
Crie uma chave de API da CometAPI e configure um cliente compatível com a Anthropic para usar o endpoint da CometAPI. Escolha o ID do modelo para a tarefa, envie seu prompt pela Messages API e leia a resposta de texto. Ao comparar os modelos, mantenha consistentes o prompt, o limite de saída, as ferramentas e os critérios de aceitação, e registre o esforço efetivo de raciocínio.
Exemplo do Opus 5.5
Para uma revisão de plano de migração, selecione claude-opus-5-5 e peça ao modelo para identificar as etapas de maior risco, explicar seu impacto e sugerir salvaguardas. Envie a solicitação pela Messages API da CometAPI e revise o texto retornado.
Exemplo do Sonnet 5.5
Para a mesma revisão do plano de migração, selecione claude-sonnet-5-5 e envie o mesmo prompt e limite de saída pela CometAPI. Compare a resposta com os mesmos critérios de aceitação, depois registre latência, novas tentativas e custo real antes de decidir qual modelo se ajusta à carga de trabalho.
Para roteamento em produção, mantenha ambos os IDs de modelo por trás da mesma interface do aplicativo e registre qualidade de conclusão, latência, novas tentativas e custo efetivamente faturado. Evite escalar apenas porque um prompt é longo; ambiguidade e custo de falha geralmente são sinais melhores.
Conclusão
Claude Opus 5.5 e Sonnet 5.5 agora compartilham praticamente o mesmo envelope técnico, portanto a escolha do modelo está cada vez mais relacionada à economia e ao comportamento da carga de trabalho do que ao tamanho do contexto. O Sonnet combina execução mais rápida e tokens padrão a metade do preço com desempenho em benchmarks que muitas vezes é próximo ao do Opus.
O Opus se torna mais valioso à medida que a ambiguidade, a duração da tarefa e o custo de uma decisão errada aumentam. Seu valor está menos em ter uma janela de contexto maior e mais em sustentar o julgamento ao longo de fluxos de trabalho difíceis e abertos.
Para muitas equipes de produção, a arquitetura mais eficiente usará ambos: Sonnet para a maioria repetível do trabalho, e Opus para o subconjunto de tarefas em que um raciocínio mais forte reduz de forma mensurável falhas, novas tentativas ou intervenção humana.
FAQ
Como um roteador do Claude 5.5 deve evitar loops caros de escalonamento?
Defina um número máximo de tentativas e um orçamento antes da execução. Faça o escalonamento após uma falha reprodutível, evidência ausente ou um critério de qualidade específico da tarefa, em vez de após cada resposta incerta. Registre qual falha acionou o Opus e se ele melhorou o resultado aceito. Se nenhum modelo passar, retorne a questão não resolvida para revisão em vez de tentar indefinidamente.
Como comparar de forma justa o Opus e o Sonnet em uma mesma carga de trabalho?
Use o mesmo corpus de tarefas, ferramentas disponíveis, evidências de entrada, limite de saída e rubrica de pontuação. Registre o esforço efetivo e teste execuções com cache frio e quente separadamente. Revise os resultados sem revelar o modelo quando possível. Relate taxa de aceitação e custo total, incluindo tentativas malsucedidas; preços de token iguais ou um único benchmark não estabelecem valor igual.
O que deve ser mantido ao trocar de modelo Claude 5.5 no meio da tarefa?
Preserve as instruções do usuário, evidências relevantes, resultados de ferramentas e um resumo explícito do progresso. Trate o estado de pensamento opaco como específico do modelo e da conversa; não presuma que ele possa ser reproduzido em diferentes rotas. Teste o comportamento de transferência suportado pelo provedor antes da produção, especialmente se o fluxo de trabalho misturar contas, gateways ou SDKs.
Quando a escolha de modelo Claude 5.5 deve ser reavaliada?
Refaça os testes de aceitação afetados após uma correção de implantação, mudança de roteamento, mudança de preço, alteração de ferramenta ou atualização material do prompt. Mantenha a execução anterior como linha de base e registre data, ID do modelo, endpoint, configuração e versão do harness. Isso distingue uma mudança de modelo de mudanças no aplicativo ao redor.