
TLDR: DeepSeek-V4.1-Flash-1017 é uma atualização menor, porém de alto impacto, de 17 de outubro de 2026, do modelo V4.1-Flash da DeepSeek. Ela oferece resultados superiores em raciocínio, codificação, capacidades de agente e benchmarks visuais, ao mesmo tempo em que produz saídas mais curtas e conclui tarefas mais rapidamente — avançando a fronteira de Pareto entre desempenho e custo.
Principais destaques
- DeepSeek-V4.1-Flash-1017 Lançado em 17 de outubro de 2026 como upgrade gratuito do endpoint de API
deepseek-flashexistente — sem necessidade de mudanças de código para usuários atuais. - Ganhos reportados pelo fornecedor em todos os 11 benchmarks listados vs. o V4.1-Flas de setembroh, com os maiores saltos em tarefas de agente e de codificação.
- Arquitetura: Mixture-of-Experts com 552B parâmetros e design Causal Encoder-Decoder (≈8B de parâmetros ativos na entrada/pré-preenchimento, 16B na decodificação/saída); janela de contexto de 1M tokens; até 384K tokens de saída; suporte nativo a visão.
- Preços inalterados: fora do pico $0.15 / $0.60 por 1M de tokens de entrada (falha de cache) / saída (o pico duplica essas taxas); acertos de cache a partir de $0.003. A CometAPI tem preço 20% abaixo da tarifa oficial.
- Novas APIs Search & Fetch disponíveis para todos os desenvolvedores ($0.75 por 1.000 chamadas; gratuitas via certas ferramentas server-side até 31 de outubro de 2026).
- Fortes capacidades de “wish-driven programming” para geração de projetos de ponta a ponta (jogos, cenas 3D, repositórios completos). Competitivo contra modelos fechados maiores em benchmarks de agentes/codificação, permanecendo muito mais barato e rápido para muitas cargas de produção.
- Pesos open-source sob licença MIT no Hugging Face e ModelScope permitem auto-hospedagem e fine-tuning.
- Para uso em produção, plataformas como a CometAPI oferecem acesso conveniente, compatível com OpenAI, aos modelos da DeepSeek ao lado de mais de 500 outros, frequentemente com preços competitivos e troca simplificada.
A DeepSeek continua a expandir os limites de modelos de IA abertos eficientes e de alto desempenho. Em 17 de outubro de 2026, a empresa lançou o DeepSeek-V4.1-Flash-1017, uma atualização direcionada do modelo V4.1-Flash (originalmente lançado em 10 de setembro de 2026). Promovido como oferecendo melhorias substanciais em raciocínio, codificação, capacidades de agente e entendimento visual — enquanto reduz o tempo de execução de tarefas e o comprimento das respostas — este checkpoint se posiciona como o modelo eficiente mais poderoso da DeepSeek até hoje para cargas de trabalho reais de agentes e codificação.
O modelo está disponível no site da DeepSeek, no app móvel e na API (ainda chamado simplesmente de deepseek-flash). Os pesos são disponibilizados abertamente sob a licença MIT, tornando-o uma das opções de pesos abertos mais fortes para desenvolvedores que desejam desempenho de agente em nível de fronteira sem custos de nível de fronteira.
O que exatamente é o DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 é um checkpoint datado (“1017” referindo-se ao lançamento de 17 de outubro) da família V4.1-Flash. A DeepSeek o descreve como uma “atualização menor”, mas as melhorias são amplas e significativas: pontuações mais altas em todas as categorias de benchmark reportadas, conclusão de tarefas mais rápida e saídas mais curtas. A empresa enquadra isso como uma verdadeira melhoria de Pareto — melhor desempenho e melhor eficiência de custo simultaneamente.
Ele herda a arquitetura inovadora introduzida com o V4.1-Flash:
- Design Mixture-of-Experts (MoE) com aproximadamente 552B de parâmetros totais de backbone (além de parâmetros Engram em alguns relatos). Nova arquitetura Causal Encoder-Decoder que ativa apenas ~8B de parâmetros por token durante o pré-preenchimento/entrada e ~16B durante a decodificação/geração de saída.
- Cache de KV altamente comprimido (reduções declaradas de 1/4 em HBM e 1/8 em armazenamento SSD em relação às gerações anteriores), o que reduz drasticamente o custo de interações de longo contexto e de múltiplas etapas para agentes.
- Suporte multimodal nativo (entrada de texto + imagem → saída de texto). Janela de contexto de 1 milhão de tokens e comprimento máximo de saída de 384K tokens (amostragem recomendada frequentemente usa ≥256K tokens máximos).
- Suporte a modos com e sem raciocínio, chamadas de ferramentas, saída em JSON e esforço de raciocínio ajustável.
O modelo foi treinado com técnicas aprimoradas de aprendizado por reforço, incluindo ciclos de auto-feedback especificamente voltados a melhorar o desenvolvimento de projetos de ponta a ponta. Isso possibilita uma “wish-driven programming” mais confiável — transformar objetivos de linguagem natural de alto nível em projetos completos e funcionais, como jogos web, cenas 3D ou repositórios de código inteiros.
Para um desenvolvedor de aplicações, isso muda a pergunta de avaliação. Em vez de verificar se o modelo pode produzir uma função plausível, teste se ele consegue entender uma base de código existente, fazer edições coordenadas, executar verificações e corrigir erros. Uma demonstração convincente estabelece uma capacidade que vale a pena testar; não estabelece confiabilidade em repositórios arbitrários.
A atualização também torna a eficiência de saída algo que vale a pena medir separadamente da qualidade da resposta. Uma resposta mais curta pode reduzir o custo de geração, mas apenas se preservar a implementação, explicação ou evidências exigidas pela tarefa. Remover validação útil seria uma regressão, mesmo que a conta de tokens diminua.
Especificações da API do DeepSeek V4.1-Flash-1017
| Especificação | DeepSeek V4.1-Flash-1017 |
|---|---|
| Identificador nativo da API | deepseek-flash |
| Janela de contexto | 1M tokens |
| Saída máxima | 384K tokens |
| Suporte de entrada | Texto e imagens |
| Modos de raciocínio | Com raciocínio e sem raciocínio |
| Recursos para desenvolvedores | Chamadas de ferramentas, saída JSON, Responses API |
| Arquitetura | Causal Encoder–Decoder MoE |
| Contagem de parâmetros da família anunciada | 552B |
| Parâmetros ativos | 8B na entrada; 16B na saída |
Como o DeepSeek V4.1-Flash-1017 se sai em benchmarks?
Testes independentes iniciais (por exemplo, lado a lado com o DeepSeek V4 Pro) mostraram que o 1017 iguala a qualidade em tarefas práticas enquanto é significativamente mais rápido e barato, além de adicionar suporte a visão que o Pro não tinha em algumas configurações.
Os resultados selecionados, reportados pelo fornecedor, comparam a versão de setembro com a atualização de 17 de outubro.
| Resultados oficiais de benchmark | Versão de setembro | Atualização de 17 de outubro | Variação absoluta da pontuação (pontos) |
|---|---|---|---|
| HLE sem ferramentas | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
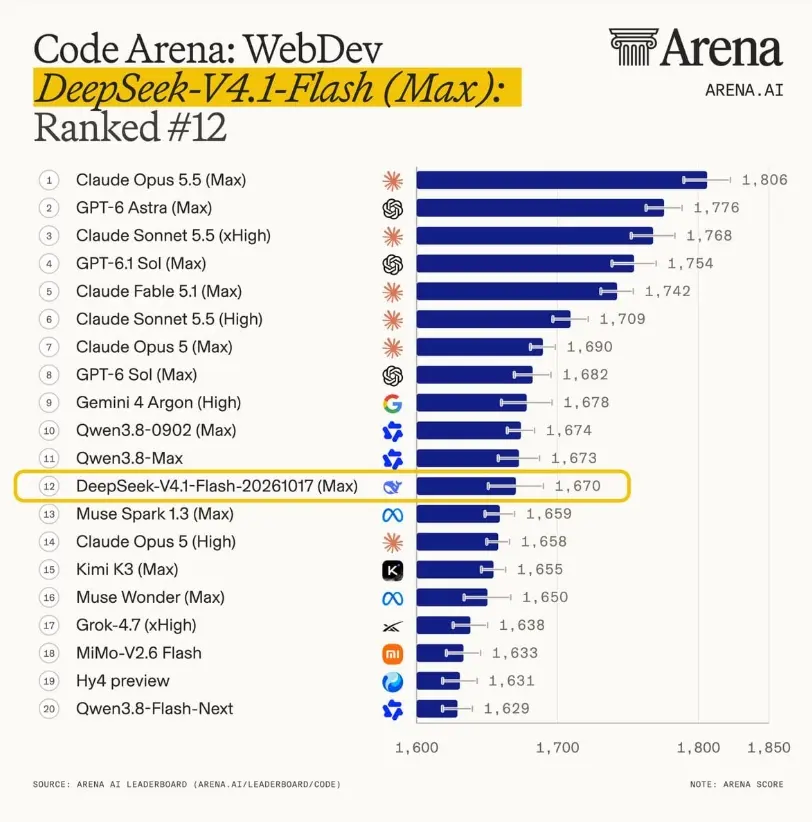
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography com ferramentas | 78.9 | 83.0 | +4.1 |
Estes são resultados reportados pelo fornecedor, não replicações independentes. A DeepSeek usou Claude Code para o Terminal-Bench 4.0 e Mini-SWE-V2 para o DeepSWE v1.1. O HLE é reportado sem ferramentas e utiliza as pontuações principais em vez do subconjunto marcado separadamente como apenas texto; Chartography usa ferramentas. A tabela de lançamento citada não fornece uma configuração completa por linha para cada outro benchmark, portanto não se podem supor orçamentos de raciocínio, hardware e condições de parada equivalentes. As mudanças acima são diferenças simples de pontuação, não melhorias percentuais relativas.
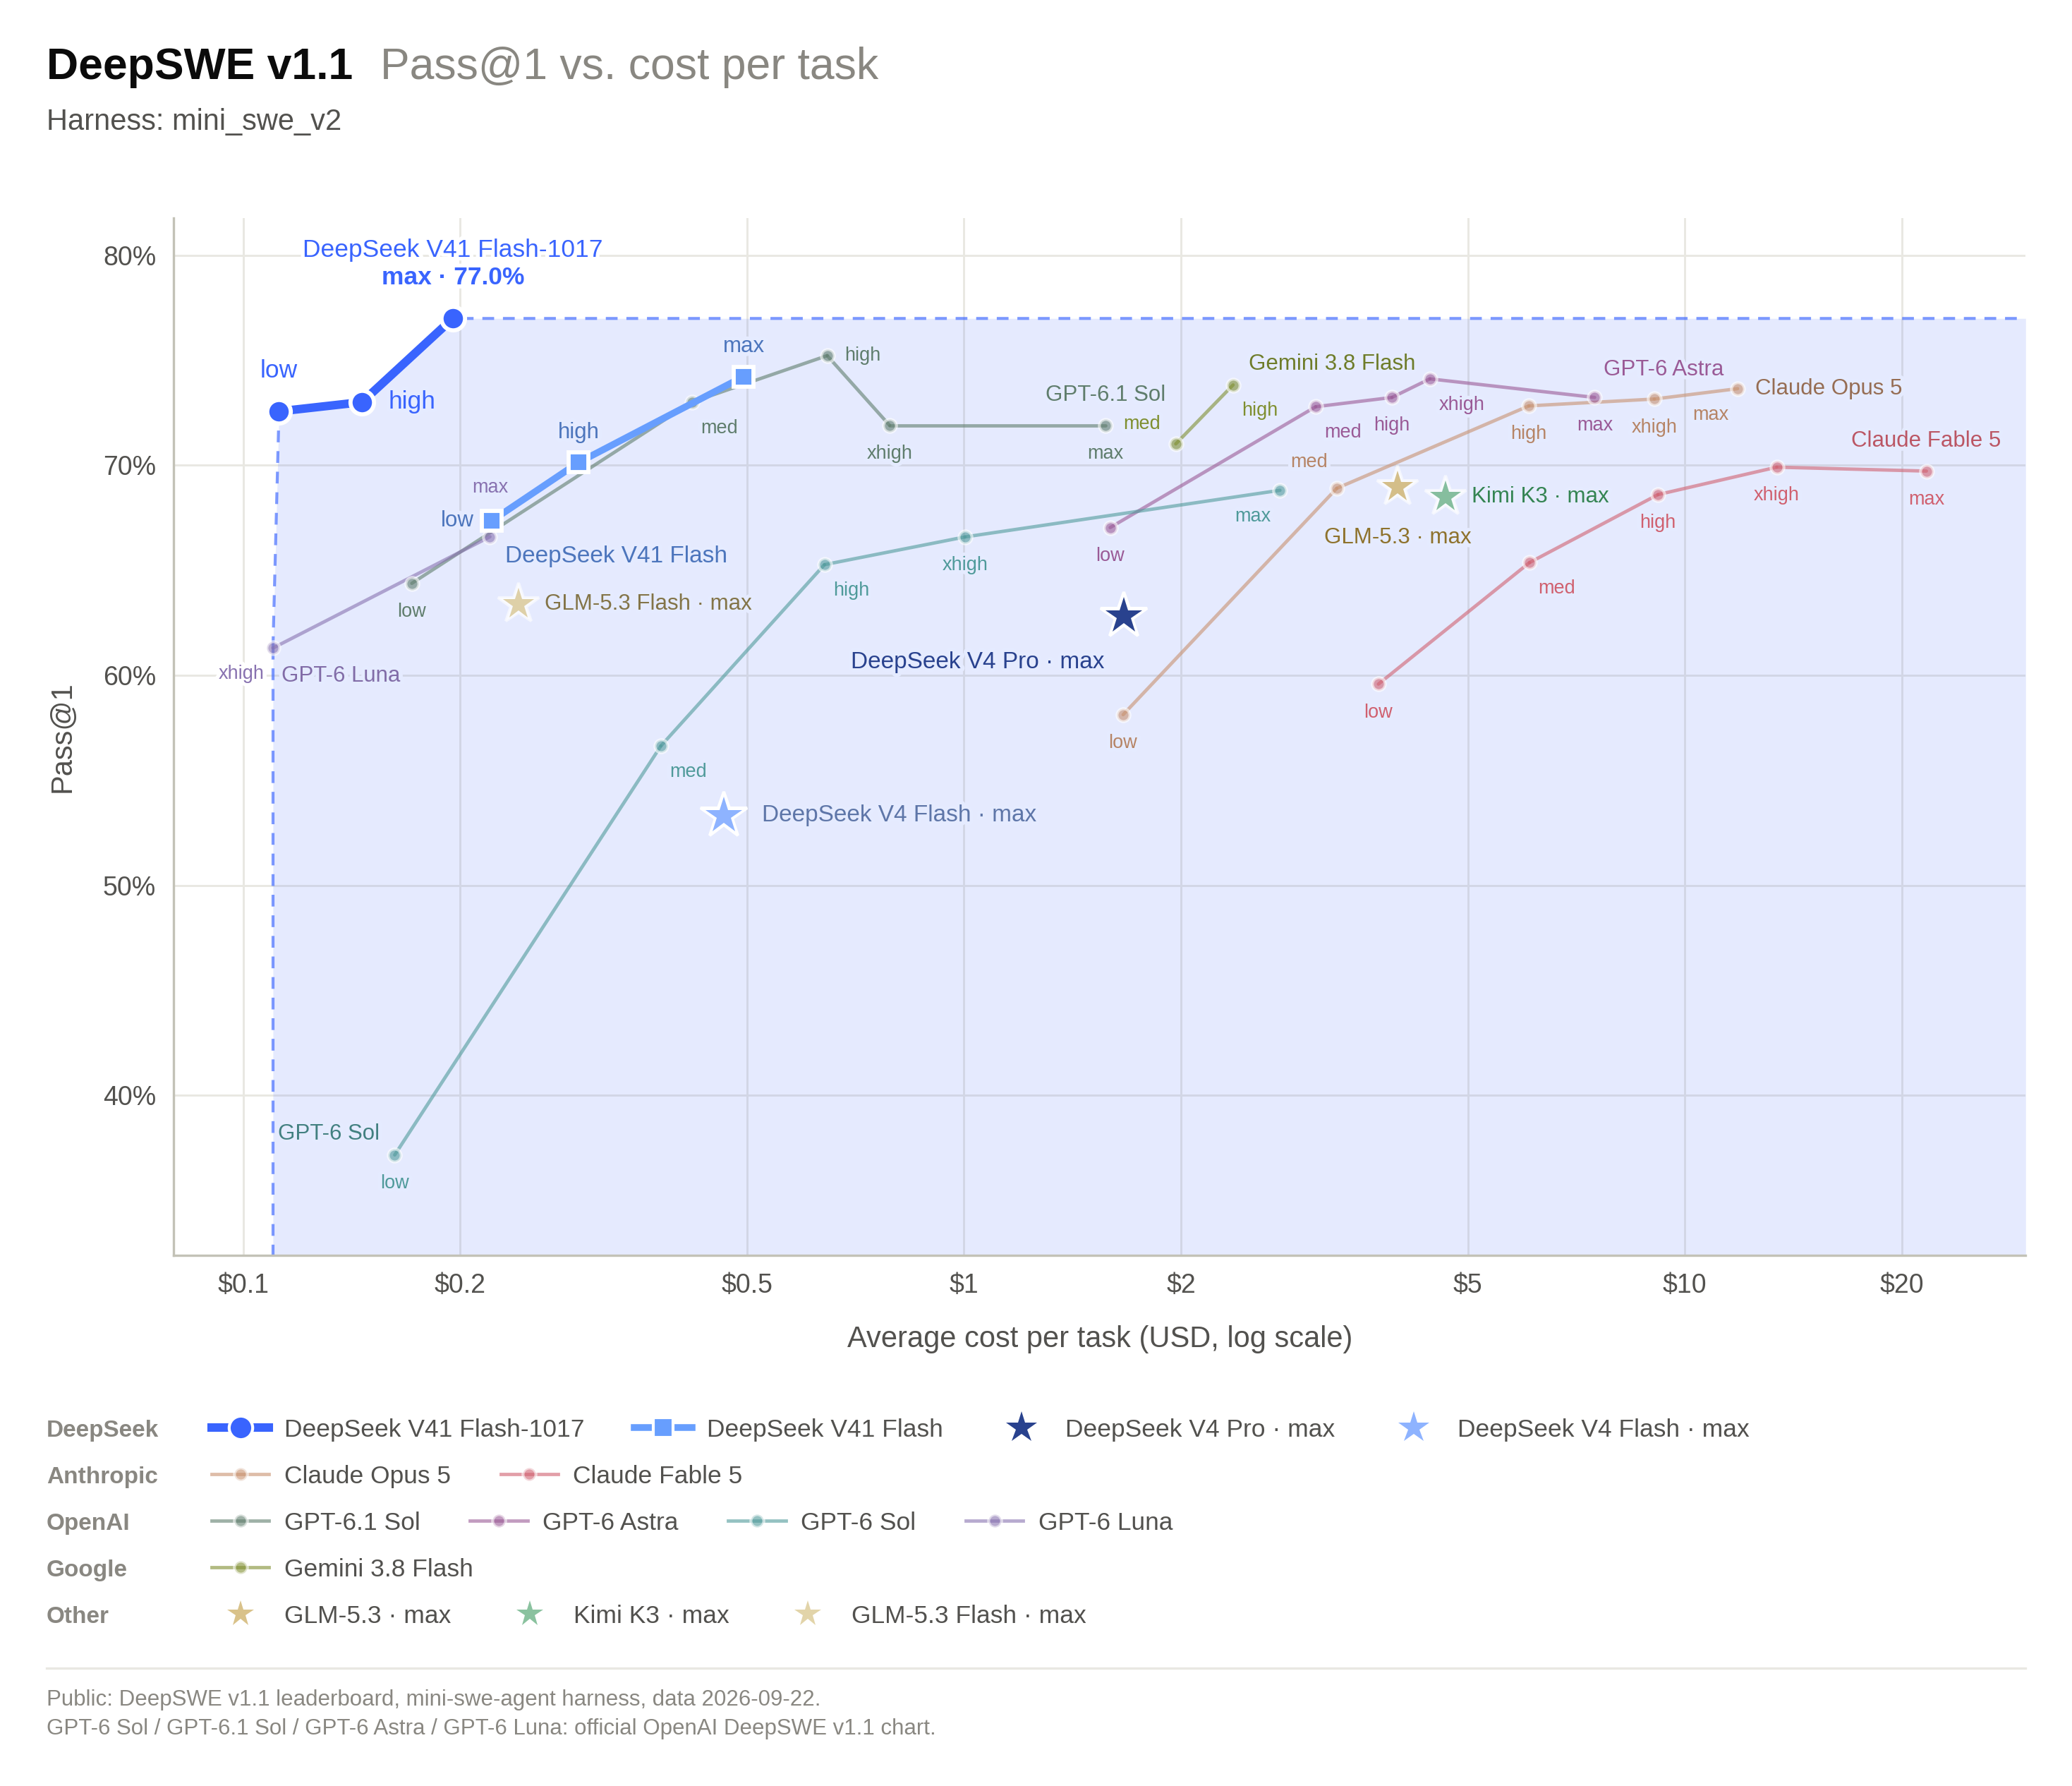
O gráfico de desempenho versus custo do DeepSWE v1.1 traça Pass@1 contra o custo médio da tarefa em USD em um eixo logarítmico, usando o harness Mini-SWE-V2. Configurações de raciocínio diferentes aparecem como pontos separados; compare uma taxa de sucesso e configuração adequadas antes de tirar uma conclusão de custo.
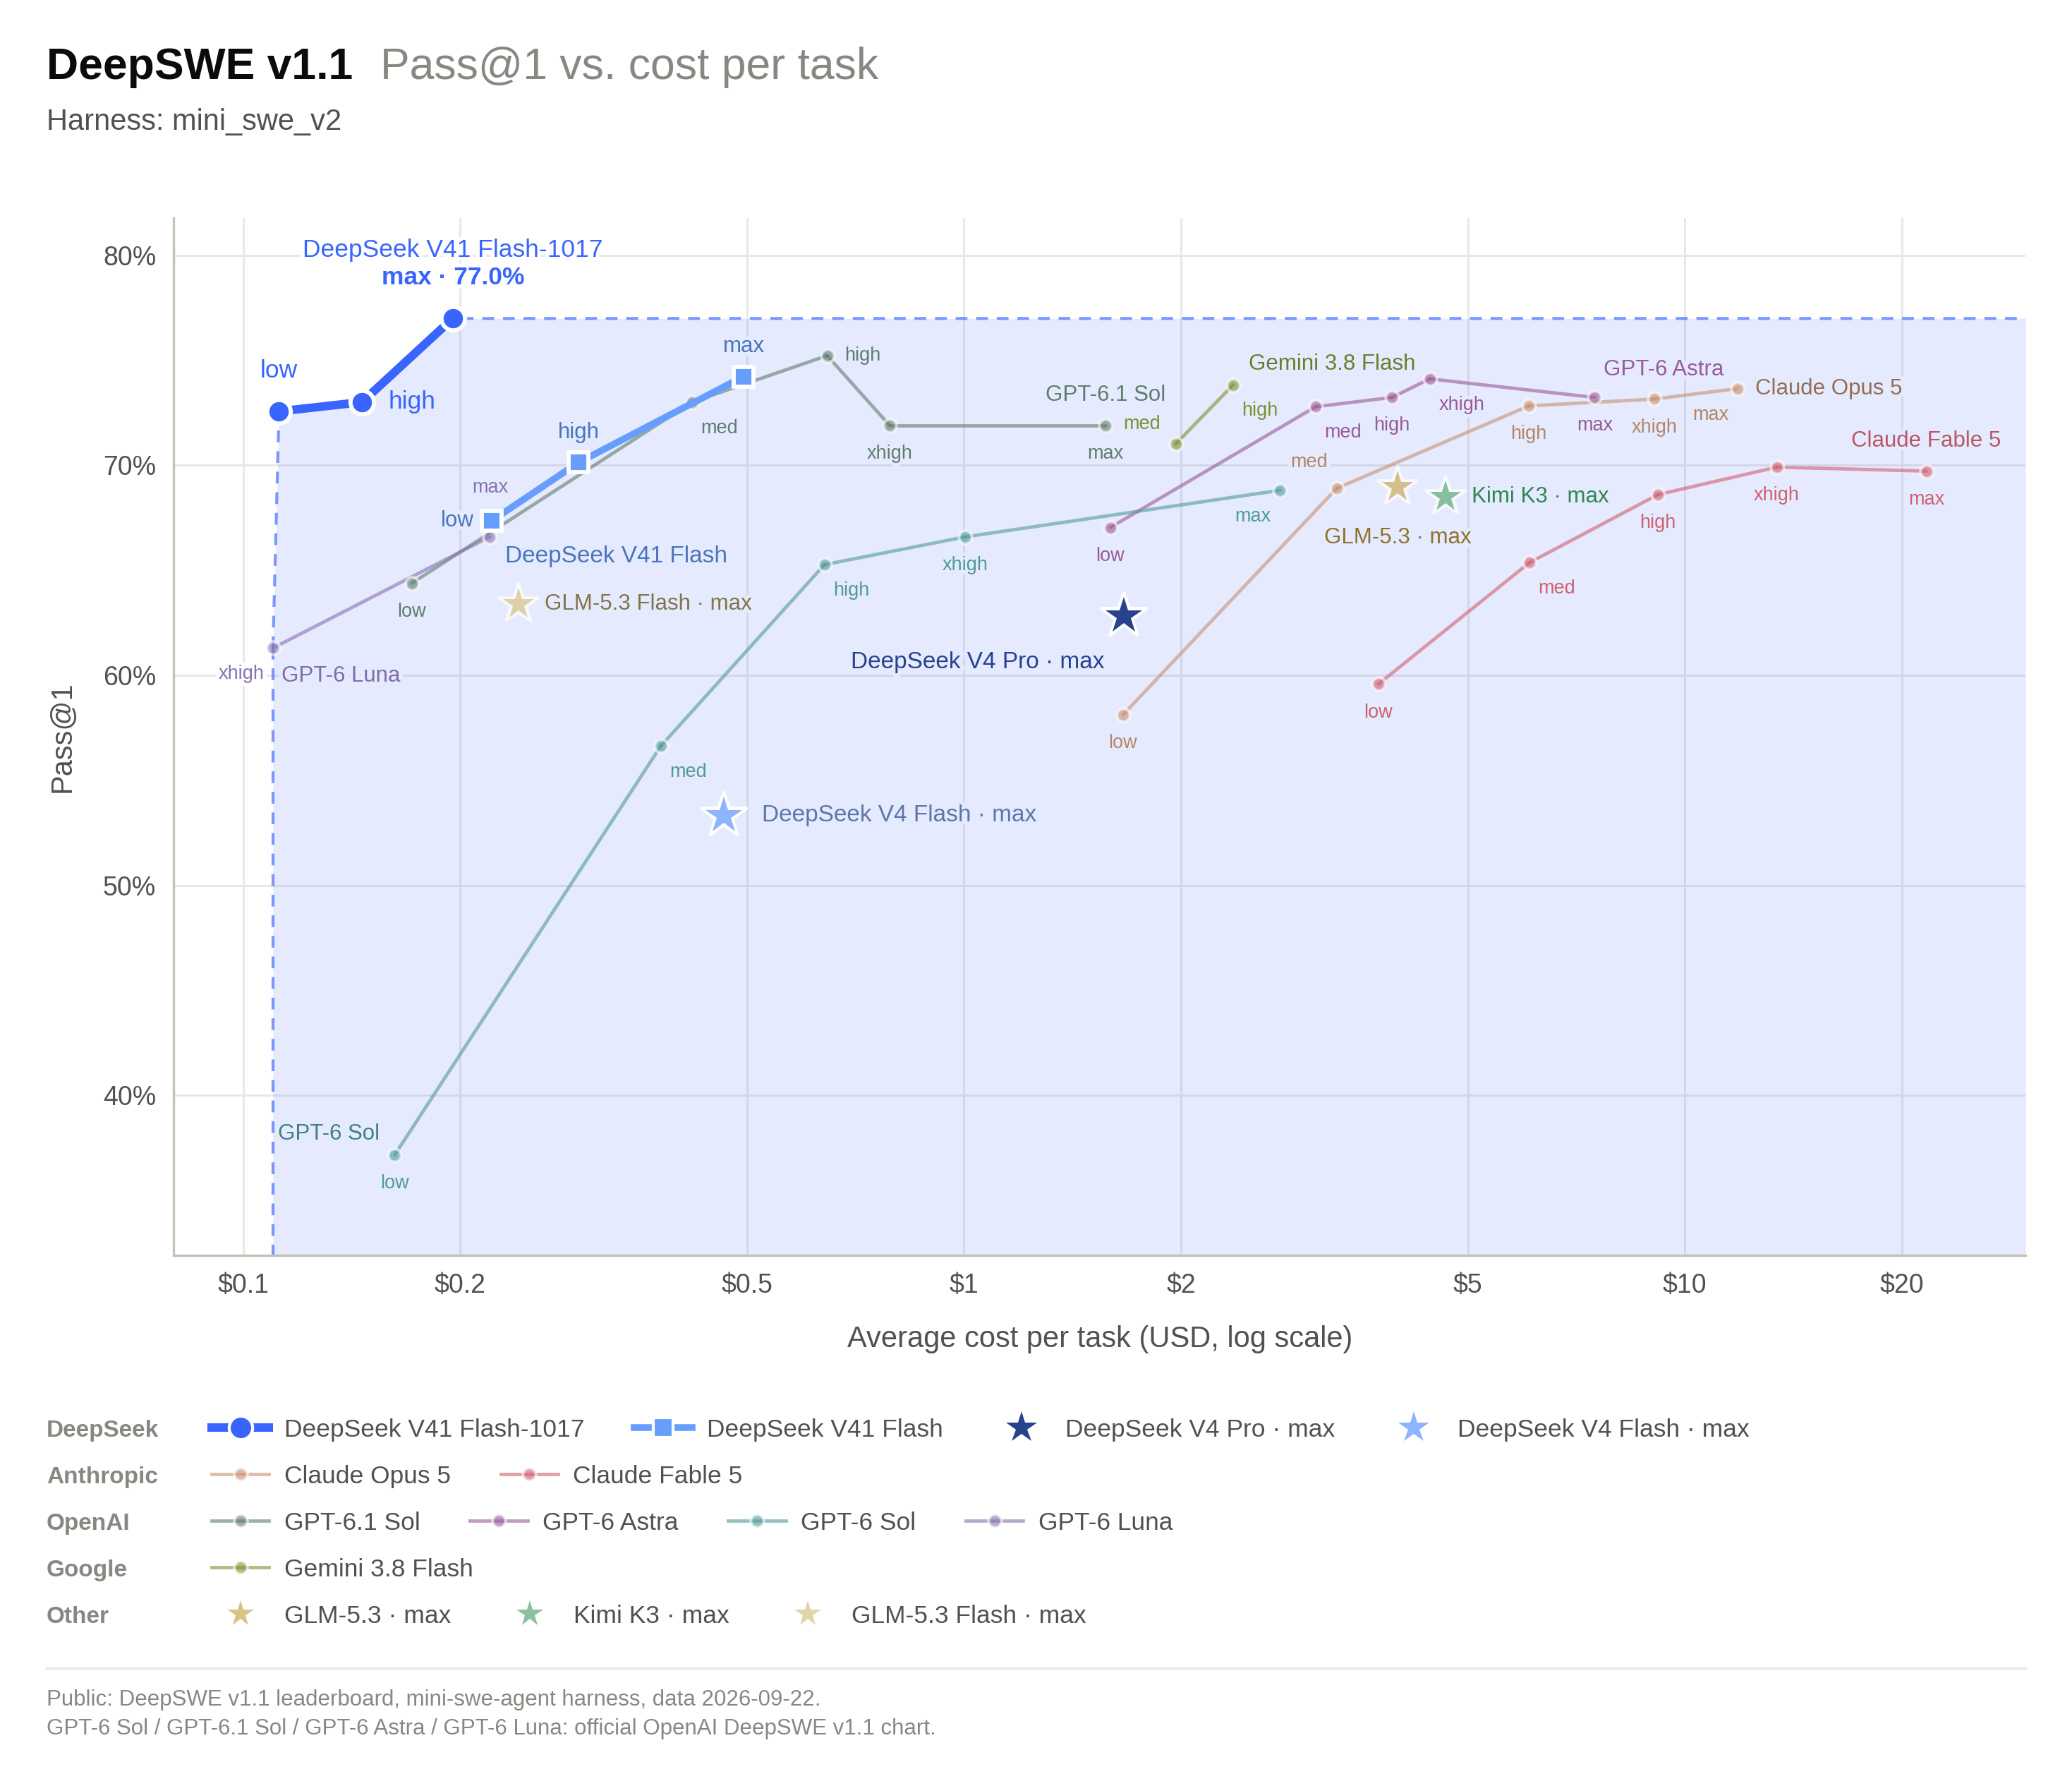
Code Arena: WebDev Leaderboard – Modelo open-source no topo
Na avaliação mais recente de fronteira em codificação e desenvolvimento web, o DeepSeek-V4.1-Flash-1017 não apenas superou o altamente respeitado Kimi K3 (Max), como também alcançou uma melhoria de ordem de grandeza na eficiência de custo de inferência — com uma despesa operacional aproximadamente um décimo da de seu contraparte. O DeepSeek-V4.1-Flash-20261017 (Max) assumiu oficialmente o primeiro lugar no Code Arena: WebDev Leaderboard, conquistando o título de “número um entre os modelos open-source”.
No ranking geral, o modelo ficou em 12º lugar com uma pontuação de 1670. Nesse nível elevado, supera o principal modelo fechado, Claude Opus5 (High), e reduziu a distância para o modelo de topo, GPT-6Sol (Max), para menos de 10 pontos.
Como a atualização de outubro se compara à versão de setembro?
Comparada à versão de setembro, a atualização de 17 de outubro mostra seus ganhos mais claros nos benchmarks de codificação selecionados: o Terminal-Bench 4.0 sobe de 31.2 para 42.3 (+11.1 pontos), enquanto o ProgramBench aumenta de 20.3 para 29.1 (+8.8 pontos). O DeepSWE v1.1 melhora de 74.2 para 77.0 (+2.8 pontos). Esses resultados reportados pelo fornecedor apoiam a avaliação da atualização para fluxos de trabalho em terminal e tarefas de programação mais amplas; eles não implicam ganhos de produtividade equivalentes em toda e qualquer base de código.
O lançamento também coloca maior ênfase no desenvolvimento de projetos completos por meio de aprendizado por reforço com auto-feedback. Velocidade e economia de tokens continuam dependentes da tarefa, como mostram os dois exemplos na próxima seção. Para integrações nativas existentes da API, o identificador do modelo permanece deepseek-flash. Assim, a decisão prática de upgrade deve se basear em tarefas aceitas, custo total e tempo de ponta a ponta medidos em trabalho representativo.
Quanto custa o DeepSeek V4.1-Flash-1017?
Sua vantagem de custo é enorme: o Flash é tipicamente 10–40× mais barato por token do que os principais modelos fechados, e saídas mais curtas ampliam ainda mais as economias em agentes de múltiplas etapas. Em relação ao seu predecessor, o 1017 é estritamente melhor nas métricas reportadas mantendo o mesmo preço — tornando-o um upgrade puro.
USD por milhão de tokens, conforme registrado no artigo-fonte em 19 de outubro de 2026. As taxas de pico da CometAPI aplicam seu multiplicador publicado de 2×.
| Categoria de tokens | DeepSeek nativo: fora do pico | DeepSeek nativo: pico | API DeepSeek V4.1 Flash na CometAPI: base | CometAPI: janela 2× |
|---|---|---|---|---|
| Entrada, acerto de cache | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Entrada, falha de cache | $0.15 | $0.30 | $0.12 | $0.24 |
| Saída | $0.60 | $1.20 | $0.48 | $0.96 |
Ambos os provedores listam janelas de pico nos dias úteis de 01:00–04:00 e 06:00–10:00 UTC. A DeepSeek exclui feriados públicos na China; as condições exibidas da CometAPI não especificam essa isenção. As demais horas usam tarifas fora do pico/de base. A coluna 2× da CometAPI é calculada a partir de seus preços base publicados.
Para a API nativa da DeepSeek, 10 milhões de tokens de entrada sem cache mais 2 milhões de tokens de saída custam:
- Fora do pico: (10 × $0.15) + (2 × $0.60) = $2.70.
- Pico: (10 × $0.30) + (2 × $1.20) = $5.40.
Para um orçamento piloto, divida todos os tokens e cobranças de ferramentas por todas as tentativas, pelo número de tarefas aceitas. Inclua reutilização de cache e janelas de pico; reporte separadamente custos de infraestrutura e revisão humana. Os exemplos acima cobrem apenas tokens do modelo.
Cobranças do Search e Fetch
As APIs Search e Fetch da DeepSeek custam $0.75 por 1.000 requisições bem-sucedidas. Sua cobrança é separada do uso de tokens do modelo; requisições com falha, resultados de busca vazios e timeouts não são cobrados sob as regras documentadas.
Para usuários da API da DeepSeek, chamadas de Search e Fetch no lado do servidor via DeepSeek Harness, Claude Code e Codex estão temporariamente gratuitas pela política oficial de cobrança. A cobrança para essas chamadas começa em 31 de outubro de 2026 às 16:00 UTC, equivalente a 1º de novembro à meia-noite em Pequim. Essa isenção limitada não torna todas as requisições autônomas das APIs Search e Fetch gratuitas.
O DeepSeek V4.1-Flash-1017 é sempre mais rápido e mais barato?
Não. O teste de duas tarefas da EmpirioLabs encontrou menor tempo e uso de tokens de saída para uma animação de aquário, mas valores maiores para uma animação de skyline:
| Testes práticos de codificação da EmpirioLabs | Versão de setembro | Atualização de 17 de outubro | Resultado observado |
|---|---|---|---|
| Tempo de conclusão do Aquarium | 162 segundos | 124 segundos | Atualização de outubro mais rápida |
| Tokens de saída do Aquarium | 41,833 | 33,149 | Atualização de outubro usou menos |
| Tempo de conclusão do Skyline | 163 segundos | 177 segundos | Atualização de outubro mais lenta |
| Tokens de saída do Skyline | 37,928 | 42,907 | Atualização de outubro usou mais |
Ambas as versões produziram animações funcionais nesses testes na plataforma de API da EmpirioLabs em 18 de outubro de 2026. Cada tarefa usou o mesmo prompt e solicitou um arquivo HTML autocontido com CSS e JavaScript inline, sem bibliotecas ou assets externos. Ambos os modelos rodaram com configurações padrão, raciocínio habilitado no orçamento padrão e limite de saída de 65.536 tokens. Eles foram executados simultaneamente para cada tarefa, com uma tentativa por modelo. Os tempos abrangem toda a requisição; as contagens de tokens de saída, incluindo tokens de raciocínio, vêm dos relatórios de uso da API. As capturas de tela foram renderizadas em um navegador headless após seis segundos. Esses dois exemplos ilustram variação de carga de trabalho, em vez de estabelecer um ranking geral.
Como acessar o DeepSeek V4.1-Flash-1017?
- API oficial da DeepSeek — Use o nome do modelo
deepseek-flashem https://api.deepseek.com. - Pesos abertos — Baixe do Hugging Face ou ModelScope para auto-hospedagem.
- CometAPI — CometAPI adiciona DeepSeek-V4.1-Flash-1017 Ver detalhes do modelo ID do modelo: deepseek-v4.1-flash-1017
Use a API nativa da DeepSeek
O guia de início rápido da API da DeepSeek e a CometAPI confirmam que o deepseek-flash agora atende à versão de 17 de outubro, sem mudança no método de chamada.
Envie uma solicitação de planejamento de projeto pela API com Python. Instale o pacote OpenAI para Python e defina API_KEY no seu ambiente antes de executar o exemplo.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Isso produz uma resposta do modelo. Para criar e validar um projeto automaticamente, um ambiente de agente deve adicionalmente fornecer acesso a arquivos, execução de comandos, feedback de testes e permissões apropriadas.
CometAPI Recomendação: a CometAPI já lista vários modelos da DeepSeek e é uma excelente forma de experimentar o V4.1-Flash-1017 ao lado de Claude, GPT, Gemini, Grok e modelos especializados em codificação/visão, sem aprisionamento a fornecedor. Cadastre-se, obtenha uma chave de API e aponte seu SDK OpenAI existente para a URL base da CometAPI. Essa abordagem é especialmente poderosa para frameworks de agentes que se beneficiam de rotear diferentes subtarefas para o modelo mais econômico ou de melhor desempenho disponível.
Conclusão
O DeepSeek-V4.1-Flash-1017 representa um avanço inteligente e eficiente nas capacidades de IA aberta. Ao melhorar o desempenho em benchmarks críticos de agentes e codificação enquanto reduz o comprimento das saídas e o tempo de execução das tarefas — tudo isso com preços baixos inalterados — ele fortalece a posição da DeepSeek como líder na corrida desempenho-por-dólar. Esteja você construindo agentes de software autônomos, aplicações multimodais ou sistemas de produção otimizados por custo, este modelo merece uma avaliação séria.
Com camadas de acesso convenientes como a CometAPI, os desenvolvedores podem integrar modelos de ponta como o V4.1-Flash-1017 em fluxos de trabalho robustos e multi-fornecedor com atrito mínimo. À medida que avaliações independentes continuam a surgir e o ecossistema de ferramentas (Harness, CodeBuddy, etc.) amadurece, espere que este checkpoint se torne a escolha padrão para muitas cargas de trabalho de alto volume e alta inteligência no fim de 2026 e além.