Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Eleven v4 vs Eleven v4 Turbo: Qual você deve escolher?
Compare Eleven v4 e v4 Turbo quanto à qualidade de voz, latência, preços da API, streaming e acesso ao CometAPI. Escolha o modelo adequado para conteúdo ou agentes.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
Escolha o Eleven v4 para audiolivros, narração e performances de personagens em que a qualidade de produção é prioridade. Escolha o Eleven v4 Turbo para agentes de voz e aplicações interativas em que o tempo de resposta importa. A ElevenLabs afirma que ambos compartilham a mesma faixa de expressividade; a tarifa publicada por caractere da API do Turbo é 50% menor. Faça a escolha final usando seus próprios scripts, testes de escuta e medições de latência de ponta a ponta.
Key Takeaways
Para áudio produzido: Comece com a variante padrão e avalie entrega, consistência e esforço de edição.
Para interação ao vivo: Comece com o Turbo e meça o tempo completo da entrada do usuário até a resposta audível.
Quanto ao custo: A tarifa publicada por caractere do Turbo é 50% menor, antes de contabilizar novas tentativas ou outros serviços.
Para benchmarks: Os resultados de preferência publicados comparam o modelo padrão com sistemas concorrentes; eles não estabelecem uma margem direta de qualidade sobre o Turbo.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Para integração: Streaming nativo e geração assíncrona de terceiros têm requisitos operacionais diferentes.
Eleven v4 vs v4 Turbo de relance
Dimensão — especificações nativas; preços nativos
Eleven v4
Eleven v4 Turbo
Uso principal
Narração produzida, audiolivros e performances de personagens
Agentes em tempo real e fala interativa
ID do modelo
eleven_v4
eleven_v4_turbo
Idiomas
90+
90+
Preço nativo
$0.08 / 1,000 caracteres
$0.04 / 1,000 caracteres
Latência mediana de inferência
Nenhum número diretamente comparável identificado
~100 ms
Tempo mediano até a primeira fala
Nenhum número comparável identificado
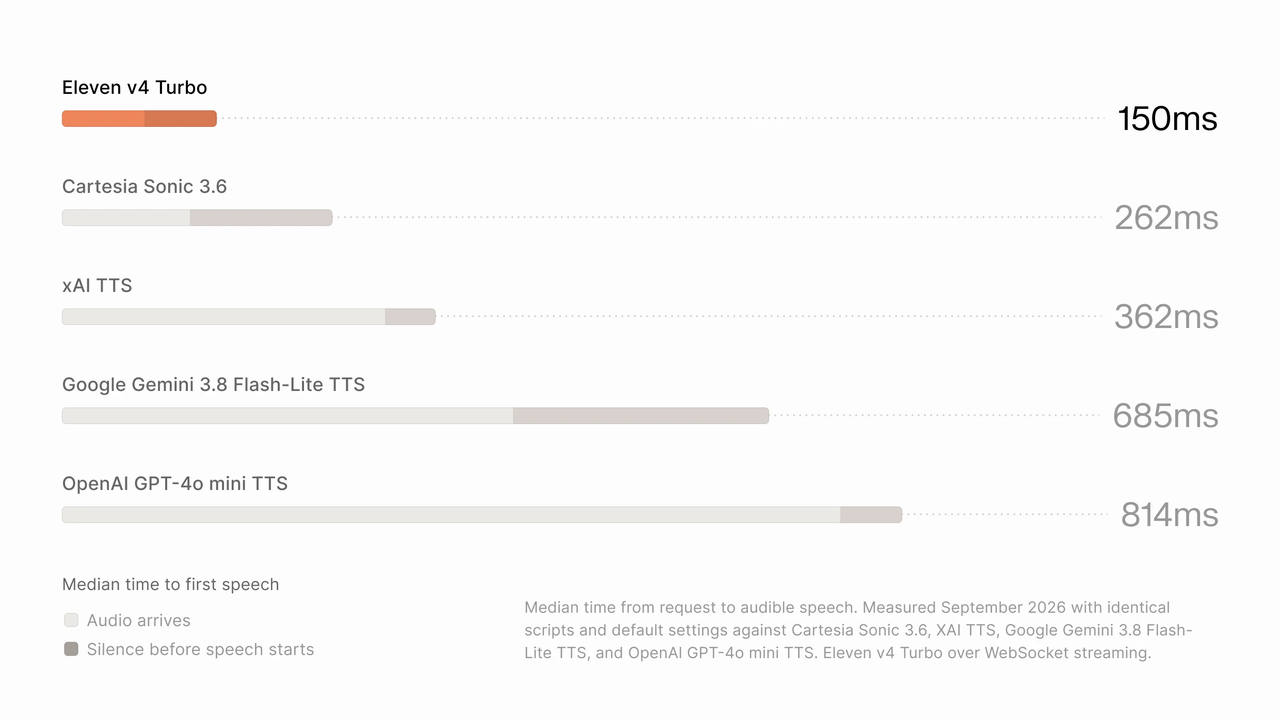
~150 ms de tempo mediano da solicitação até a fala audível via WebSocket; latência de rede medida excluída
Vozes registradas por conexão do Text to Dialogue WebSocket
Até 10
Exatamente 1
O número de 150 ms vem da comparação de setembro de 2026 da ElevenLabs usando scripts idênticos e configurações padrão. Ele mede o início da fala audível, e não o atraso total de uma conversa com agente de voz. Os limites de registro de voz aplicam-se ao endpoint Text to Dialogue WebSocket.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Visão geral e especificações
Eleven v4: Áudio produzido e performances multisspeaker
O posicionamento publicado do modelo padrão é produção de fala da mais alta qualidade, incluindo diálogos naturais multisspeaker e narração de longa duração. Isso o torna um primeiro candidato sensato quando uma gravação pode ser revisada e editada antes do lançamento. A questão relevante é se sua entrega permanece convincente em passagens completas e linhas regeneradas.
Eleven v4 Turbo: Fala expressiva em tempo real
O Eleven v4 Turbo é projetado para agentes em tempo real, assistentes e personagens interativos. A ElevenLabs diz que ele mantém toda a faixa de expressividade do Eleven v4 e oferece suporte a Professional Voice Clones, priorizando a geração de baixa latência.
Avalie-o enquanto o áudio é transmitido e reproduzido, porque um clipe isolado convincente não estabelece que a conversa completa responde com prontidão. Sua baixa latência de inferência é uma especificação inicial, não uma garantia para uma aplicação inteira.
Uma locução instrucional curta pode soar igualmente aceitável em ambos, enquanto uma cena dramática pode revelar diferenças que justificam uma geração mais cara.
Arquitetura e escopo de avaliação
O anúncio oficial de arquitetura descreve o Eleven v4 como construído sobre uma arquitetura totalmente nova e diz que o Turbo leva a mesma tecnologia a casos de uso de baixa latência. Ele não divulga detalhes suficientes para comparar contagem de parâmetros, estrutura de camadas, computação de treinamento ou as mudanças específicas responsáveis pela diferença de velocidade. Trate esses detalhes como não divulgados, em vez de inferir que o Turbo é menor ou destilado.
Limites nativos e controles de voz
Verifique o limite de entrada do modelo e do endpoint que você planeja usar antes de dividir um roteiro longo. Um limite publicado para uma interface não se aplica automaticamente a outra, e a ausência de limite não significa entrada ilimitada.
Ambas as variantes oferecem controles de Stability e Similarity. Ao selecionar um Professional Voice Clone com o Eleven v4, um Clone Strength slider adicional ajusta o quão de perto a saída segue as gravações de treinamento do clone. Valores mais baixos permitem uma entrega mais flexível com leve suavização da voz; valores mais altos preservam mais da performance original e traços vocais distintivos, incluindo sotaques. A ElevenLabs recomenda começar em 0% para a maioria das vozes. Os sliders Style e Speed não estão disponíveis na experiência nativa do v4, e SSML não é suportado.
A implicação para migração é prática: preserve o sentido de suas instruções de voz existentes, mas reveja como elas são expressas. Um roteiro antigo pesado em SSML deve ser adaptado e testado, não copiado sem alterações.
Eleven v4 vs v4 Turbo: Desempenho
Benchmarks publicados e limites de escopo
Dois resultados oficiais importam aqui: preferência de escuta e latência de resposta. Eles respondem a perguntas diferentes.
Evidência publicada — metodologia oficial de benchmark
Resultado reportado
O que estabelece
Testes cegos de preferência do modelo padrão
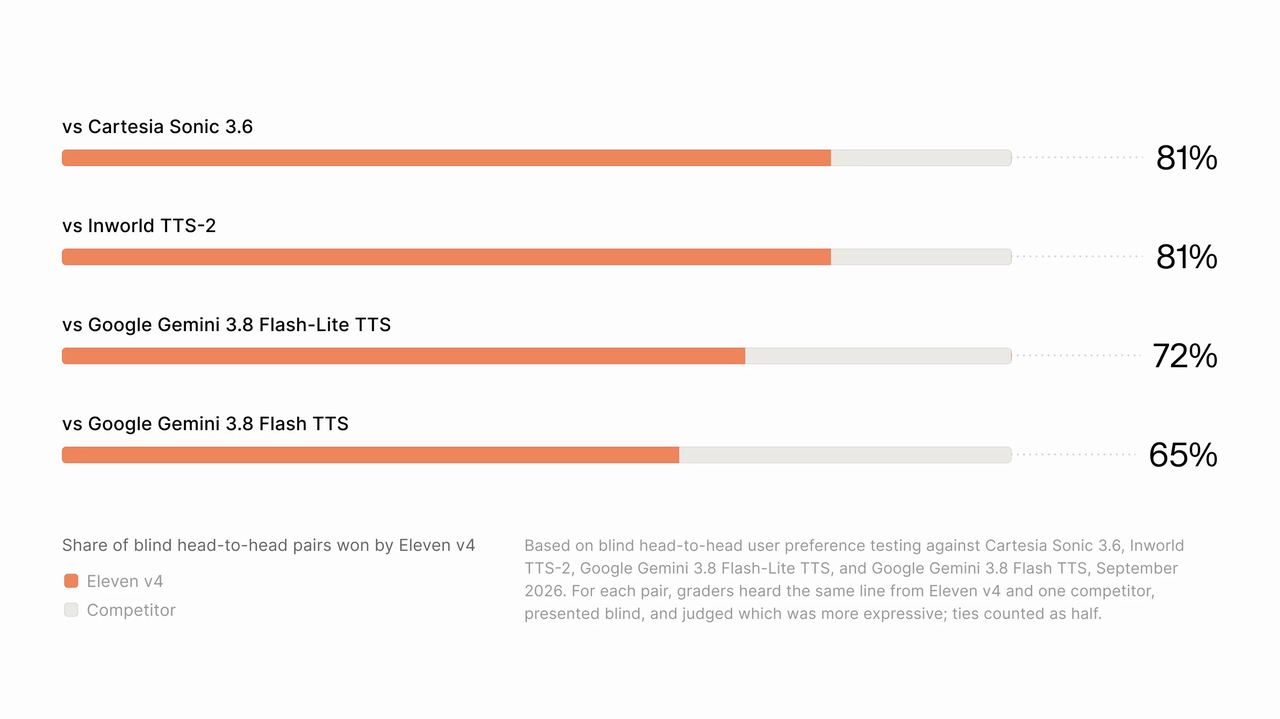
Aproximadamente 75% de preferência geral; resultados no gráfico variam de 65%–81%
Preferência de ouvintes sobre os modelos concorrentes testados
Latência mediana de inferência do Turbo
Aproximadamente 100 ms
Uma alegação de tempo de inferência do modelo
Tempo mediano do Turbo até a primeira fala
Aproximadamente 150 ms
Tempo da solicitação até a fala audível sob a configuração de teste declarada
Os testes de escuta publicados comparam o Eleven v4 com modelos de fala concorrentes. Eles não estabelecem o quanto, se é que há, os ouvintes o preferem em relação ao Eleven v4 Turbo. Para essa escolha, compare ambas as variantes usando os mesmos scripts e vozes em seus próprios testes cegos de escuta.
Gráfico oficial de latência da ElevenLabs. Seu tempo reportado exclui a latência de rede medida.
Condições de avaliação
O estudo oficial de escuta de setembro de 2026 usou comparações pareadas cegas da mesma linha do Eleven v4 e de um modelo concorrente, julgando expressividade e naturalidade; empates contaram como meio ponto. Os sistemas comparados e as taxas de preferência por sistema aparecem no gráfico oficial abaixo. Esses resultados reportados pelo fornecedor comparam o Eleven v4 com sistemas concorrentes. Eles não quantificam uma diferença de qualidade de escuta entre Eleven v4 e Eleven v4 Turbo.
A comparação de latência de setembro de 2026 usou scripts idênticos e configurações padrão, removeu a latência de rede medida para todos os sistemas e executou o Turbo via streaming WebSocket. Os 150 ms reportados medem da solicitação ao início da fala audível; é uma métrica diferente dos aproximadamente 100 ms de inferência. A metodologia citada não fornece um detalhamento completo de hardware, região, carga e tamanho de amostra, portanto não estabelece uma garantia de latência em produção.
Qualidade de voz e consistência de produção
A ElevenLabs destaca suporte a Professional Voice Clone, melhor consistência do locutor em linhas regeneradas e “stitching” de solicitações para áudio de longa duração. Avalie essas alegações com uma passagem completa e uma linha de substituição inserida em uma gravação existente.
Para áudio gravado, separe entrega expressiva de consistência de produção. Ouça ênfase, emoção, pronúncia e se o mesmo locutor permanece reconhecível entre passagens. O modelo padrão é a opção do fornecedor que prioriza qualidade, mas um roteiro instrucional simples pode não revelar uma diferença útil. Compare tomadas aceitas em vez de presumir que uma geração de preço mais alto sempre exigirá menos edição.
Direção de voz e entrega multilíngue
Ambas as variantes oferecem entrega expressiva, mas a expressão útil depende do roteiro e da voz escolhida. Comece com um pequeno número de instruções claras e ouça se elas melhoram o sentido pretendido.
Uma resposta de suporte tranquilizadora pode combinar um tom acolhedor com uma breve pausa:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Este é um prompt ilustrativo, não um resultado de performance medido. Teste-o ao lado de uma versão sem marcações. Instruções adicionais só são úteis quando melhoram a saída.
A localização também merece uma escuta separada. De acordo com o guia de produto nativo, a geração no mesmo idioma preserva o sotaque original da voz de referência, enquanto a geração entre idiomas adota a pronúncia natural do idioma de destino, em vez de manter o sotaque do idioma de origem.
Esse comportamento pode servir a um tutorial de produto localizado, mas um personagem fictício com um sotaque estrangeiro deliberadamente reconhecível pode precisar de orientação adicional. Avalie pronúncia, identidade e sotaque pretendido separadamente; uma voz pode soar fluente e ainda assim não cumprir o briefing criativo.
Latência e confiabilidade
Para um agente de voz em produção, a síntese de fala é apenas parte do atraso. Reconhecimento de fala, detecção de turno, saída do modelo de linguagem, percurso de rede e buffering de áudio podem afetar quando o usuário ouve uma resposta.
Meça tempos de resposta tanto medianos quanto de cauda lenta em sua própria aplicação. Uma mediana baixa pode coexistir com pausas ocasionais que tornam a conversa frustrante.
Eleven v4 vs v4 Turbo: Custo
Preços oficiais por caractere na API
A comparação de API nativa abaixo usa tarifas publicadas conferidas em 19 de outubro de 2026. Os totais de volume são cálculos a partir dessas tarifas, em vez de cotações de pacotes separados.
Uso — preços oficiais da API
Variante padrão
Variante Turbo
Economia calculada com o Turbo
1,000 caracteres
$0.08
$0.04
$0.04
100,000 caracteres
$8.00
$4.00
$4.00
1 milhão de caracteres
$80.00
$40.00
$40.00
10 milhões de caracteres
$800.00
$400.00
$400.00
Esses números descrevem geração de fala baseada em caracteres, não toda a fatura de um agente de voz. Franquias de assinatura, outros serviços e termos comerciais aplicáveis devem ser considerados separadamente.
Preços e condições de cobrança na CometAPI
A CometAPI exibe preços denominados em tokens, enquanto as tarifas nativas acima são por caractere. Compare custos apenas após confirmar como o endpoint selecionado mede e cobra o uso. Se precisar do Turbo, confirme que o modelo está disponível na rota da CometAPI escolhida antes de planejar a integração.
Custo por gravação ou interação aceita
Para orçamentação, use:
Custo de geração de fala = caracteres faturáveis ÷ 1,000 × tarifa por caractere aplicável
Para produção de conteúdo, uma medida operacional mais útil é custo por gravação aceita. Inclua tomadas regeneradas e tempo de edição. Se a variante mais barata errar repetidamente uma performance difícil, sua vantagem de preço unitário pode encolher.
Para agentes ao vivo, compare o custo de interações concluídas na qualidade e no tempo de resposta requeridos. Uma conta baixa de síntese tem valor limitado se os usuários abandonarem conversas lentas ou confusas.
Eleven v4 vs v4 Turbo: Comparação e seleção
Seleção por capacidade e tipo de trabalho
As recomendações a seguir combinam o posicionamento publicado com critérios práticos de avaliação. São pontos de partida para testes, não resultados adicionais de benchmark.
Projeto
Ponto de partida recomendado
Avaliação decisiva
Audiolivro ou documentário
Variante padrão
Consistência entre passagens e linhas regeneradas
Cena dramática com personagem
Variante padrão
Entrega emocional e interação entre locutores
Agente de suporte ao cliente
Turbo
Tempo de resposta audível, pronúncia e tratamento de interrupções
Personagem de jogo interativo
Turbo
Capacidade de resposta e performance em turnos curtos
Clipes instrucionais simples
Teste ambos
Se os ouvintes notam uma diferença significativa de qualidade
Produção multilíngue
Teste ambos por idioma
Pronúncia, sotaque e identidade da voz
Produto com áudio gravado e ao vivo
Roteamento separado por carga
Se cada rota atende a seus próprios critérios de aceitação
Para audiolivros, publicidade e cenas dramáticas, teste o Eleven v4 com uma passagem neutra, uma passagem emocional e uma linha regenerada inserida em uma gravação existente. Ouça identidade consistente da voz, cadência e pronúncia nas junções. Escolha a variante padrão quando a performance aceita ou o tempo economizado na edição justificar seu custo de geração mais alto.
Para agentes de suporte e personagens interativos, teste o Turbo ao longo da conversa completa: fala do usuário, detecção de turno, geração de resposta, síntese e reprodução. Inclua conexões lentas, falhas de conexão e interrupções. Confirme que a reprodução para prontamente quando o usuário interrompe e que a próxima resposta começa de forma limpa. Escolha o Turbo quando ele atender ao seu patamar de qualidade de escuta e à sua meta de tempo de resposta.
Construa um conjunto de teste representativo: inclua uma explicação neutra, uma resposta tranquilizadora, uma passagem emocional, nomes ou abreviações e texto multilíngue usado pela sua audiência.
Mantenha roteiro, voz e configurações de saída tão comparáveis quanto cada interface permitir.
Revise gravações sem rótulos de modelo. Registre erros de pronúncia, inconsistência de identidade da voz e as correções necessárias para cada tomada.
Meça o tempo de resposta ao vivo separadamente da qualidade de escuta, incluindo tanto a latência mediana quanto atrasos de cauda lenta.
Defina limiares de aceitação antes de escolher uma rota: pronúncia, consistência da voz, esforço de edição, tempo de resposta mediano e tempo de resposta de cauda lenta.
Faça tráfego representativo passar pelo endpoint que você irá implantar. Acompanhe saídas rejeitadas, novas tentativas e falhas de reprodução ou conexão.
Compare o custo por gravação aceita ou interação concluída, incluindo tomadas regeneradas e esforço de edição.
Para produtos com áudio pré-gravado e ao vivo, teste roteamento separado e confirme que cada rota atende aos próprios limiares de aceitação.
Onde acessar Eleven v4 e v4 Turbo?
Acesso pelo provedor oficial
Use a rota nativa do provedor que corresponde à carga de trabalho: fala e diálogo gerados para áudio produzido e streaming Text to Dialogue WebSocket para interação com o Turbo. O exemplo oficial abaixo documenta a conexão de streaming e suas restrições de registro de voz. Verifique o esquema atual do endpoint, requisitos de autenticação e limites de conta antes de conectar uma carga de produção.
A mesma referência especifica exatamente uma voz registrada por conexão do Turbo, em comparação com até dez para a variante padrão nesse endpoint. São regras no nível da conexão, não uma afirmação universal sobre todas as interfaces.
Acesso via CometAPI
A API do Eleven v4 na CometAPI fornece uma rota para gerar fala por meio de uma interface compatível com Runway. Seu anúncio de integração de 10 de outubro de 2026 documenta o comportamento específico do provedor resumido abaixo.
Detalhe de integração — anúncio da CometAPI
Comportamento publicado
ID do modelo
eleven_v4
Endpoint de envio
POST /runwayml/v1/text_to_speech
Processamento
Envio de tarefa assíncrona
Saída
Áudio MP3
Limite de entrada
Até 2,500 caracteres por solicitação
Configuração de voz
Vozes predefinidas
Controle adicional exposto
Velocidade da fala ajustável
Estes são detalhes específicos de integração do provedor. O limite nativo de 10.000 caracteres e os controles da interface nativa não devem ser substituídos pelo comportamento documentado desta interface. Da mesma forma, o fluxo assíncrono não estabelece que o desempenho nativo de WebSocket do Turbo esteja disponível por essa rota.
Uma sequência prática de integração é enviar um roteiro curto, seguir o fluxo documentado de status da tarefa, recuperar o resultado e verificar pronúncia e duração da saída antes de aumentar o volume.
Conclusão
Escolha o Eleven v4 quando suas gravações aceitas entregarem qualidade de performance suficiente ou economia de produção que justifique a tarifa mais alta por caractere. Escolha o Eleven v4 Turbo quando ele passar pelo seu patamar de escuta e oferecer a capacidade de resposta necessária para uma conversa ao vivo. Tome a decisão final no endpoint que você irá implantar, com scripts representativos, novas tentativas e custo operacional total incluídos.
FAQ
Como dividir roteiros longos do Eleven v4 para produção?
Divida em limites de parágrafo, frase ou cena, em vez de no meio de uma palavra ou de uma fala de personagem. Deixe espaço para qualquer texto de direção dentro do limite de entrada permitido pelo endpoint, mantenha um registro do roteiro e das configurações de voz para cada segmento e teste as junções após montar o áudio. Compare loudness, cadência, pronúncia e identidade da voz entre os limites; aceitar cada clipe individualmente não estabelece que a gravação combinada será contínua. Use o limite do endpoint do provedor real, já que os limites de solicitação nativos e da CometAPI diferem.
Como reprocessar uma solicitação interrompida do Eleven v4?
Acompanhe o identificador da solicitação ou tarefa original e determine seu estado antes de enviar o mesmo texto novamente. Para um fluxo assíncrono do provedor, verifique se a tarefa original foi concluída e se seu resultado ainda pode ser recuperado. Para um stream ao vivo, registre qual áudio já foi reproduzido e decida se deve reproduzir novamente a fala ou retomar em um limite limpo. Confirme as regras de nova tentativa, idempotência e cobrança do endpoint; não presuma que repetir uma solicitação é gratuito ou produz áudio idêntico.
Como as equipes podem fazer testes de regressão de uma versão de voz do Eleven v4?
Mantenha um conjunto de aceitação fixo contendo nomes de marca, abreviações, números, pronúncias difíceis, passagens emocionais e os idiomas usados pelo produto. Arquive o roteiro, identificador do modelo, identificador da voz, configurações disponíveis, data de geração e gravações de referência aceitas. Quando um modelo, voz ou integração mudar, ouça novas amostras em comparação a essas referências e documente quaisquer correções necessárias. Separe um procedimento de teste reprodutível da suposição de formas de onda idênticas: passar em uma gravação não garante que cada geração subsequente passará.