
TL;DR
A Google anunciou o Gemini 4 Argon em 30 de setembro de 2026 como um modelo de fronteira para workflows complexos e de longa duração. Seus resultados publicados mostram um padrão claro: desempenho forte em trabalho profissional de conhecimento, tarefas de longo contexto e avaliações selecionadas de engenharia de software, com resultados mais fracos em alguns benchmarks de terminal e uso de computador. A Google está introduzindo o modelo por meio de um rollout em fases. Separadamente, a CometAPI relata disponibilidade no catálogo a partir de 1º de outubro; a elegibilidade da conta e uma requisição de teste bem-sucedida devem ser verificadas antes da implantação. A história de desempenho mais útil é onde aparecem os ganhos.
O Argon marca 68.9% no Vals Index, 65.4% no Vals Finance Agent v2, 77.9% no DeepSWE v1.1, 91.7% no LVBench e 84.2% no GraphWalks em 256K–1M de contexto. Ao mesmo tempo, fica atrás de modelos de fronteira concorrentes no FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science e OSWorld-2.0.
Os resultados favorecem uma visão específica por carga de trabalho do Argon. Seus maiores scores se concentram em trabalho profissional de conhecimento, tarefas de contexto muito longo e avaliações multimodais e de engenharia de software selecionadas. Outros modelos mantêm vantagens em diversos testes de terminal e uso de computador.
Principais conclusões
- O Gemini 4 Argon é mais forte em trabalho de conhecimento empresarial, raciocínio de longo contexto, compreensão multimodal e várias avaliações de codificação de longo horizonte.
- Seu limite máximo de saída de 1 milhão de tokens oferece mais margem de geração para trajetórias longas de raciocínio; ele não estabelece uma especificação pública de contexto de entrada.
- O Argon lidera vários resultados publicados em trabalho de conhecimento e longo contexto, mas GPT-6 Astra e Claude Opus 5.5 permanecem à frente em avaliações selecionadas de codificação e uso de computador.
- Scores de benchmarks descrevem configurações específicas de modelo e agente. Métricas, condições de entrada e configurações de avaliação importam tanto quanto os percentuais de manchete.
- O rollout da Google e o acesso via CometAPI são declarações de disponibilidade separadas. Verifique a rota ativa, o identificador do modelo e a elegibilidade da conta antes de migrar tráfego.
O que é o Gemini 4 Argon?
O Gemini 4 Argon é o novo modelo de fronteira da família Gemini do Google DeepMind, construído em torno de workflows difíceis que exigem raciocínio em muitas etapas, em vez de responder a um único prompt curto.
O posicionamento oficial da Google enfatiza engenharia de software no mundo real, trabalho de conhecimento empresarial como jurídico e finanças, cibersegurança defensiva, compreensão multimodal e tarefas agentic de longa duração.
Isso o diferencia das recentes versões Flash. O Gemini 3.8 Flash API na CometAPI é projetado como um cavalo de batalha de menor custo para workloads agentic em escala. Já o Argon representa o extremo de fronteira do stack da Google, priorizando profundidade e execução sustentada.
Especificações do modelo
| Especificação | Gemini 4 Argon |
|---|---|
| Desenvolvedor | Google DeepMind |
| Anunciado | 30 de setembro de 2026 |
| Família do modelo | Gemini 4 |
| Posicionamento | Modelo de raciocínio de fronteira e longo horizonte |
| Saída máxima | 1.000.000 tokens |
| Avaliação de longo contexto | Testado entre 256K–1M no GraphWalks |
| Limite público de contexto de entrada | Não especificado formalmente em uma tabela pública de especificações de API no lançamento |
| Compreensão multimodal | Sim; inclui gráficos, documentos e avaliação de vídeos longos |
| Codificação agentic | Sim |
| Uso de computador | Avaliado |
| Cibersegurança | Capacidades defensivas especializadas |
| ID do modelo na API pública da Google | Não anunciado na documentação pública inicial da Google; a CometAPI usa gemini-4-argon como identificador de catálogo. |
Orçamento de saída e trade-offs
A Google anuncia um limite máximo de saída de 1 milhão de tokens para o Argon, acima do limite anterior de 64K citado em seu anúncio de lançamento. Isso fornece margem para trajetórias de raciocínio mais longas. Não deve ser interpretado como um orçamento total garantido para toda uma sessão de agente com múltiplas chamadas, nem como prova de que toda tarefa irá melhorar.
Saída máxima não é o mesmo que inteligência. Dar mais tokens de saída a um modelo não o torna automaticamente mais capaz; apenas remove um potencial gargalo. O modelo ainda precisa usar esse orçamento de maneira produtiva.
Há também um trade-off de custo e latência. Um modelo que de fato consome centenas de milhares de tokens gerados pode ser caro e lento, mesmo quando o preço nominal por token parece atraente.

Resultados de benchmarks selecionados reproduzidos do artigo. Compare modelos dentro de cada linha; métricas e condições de avaliação diferem. Este gráfico substitui a arte decorativa em gradiente e não representa testes independentes.
Um limite máximo de saída e uma janela de contexto de entrada descrevem capacidades diferentes. A faixa de avaliação do GraphWalks é evidência sobre as entradas testadas, não um substituto para uma especificação pública de API.
Como o Gemini 4 Argon se sai nos benchmarks?
A tabela de desempenho do Google DeepMind cobre workflows de agentes, trabalho profissional de conhecimento e tarefas multimodais. Os valores abaixo reproduzem essa comparação publicada. Eles medem desempenho de tarefa, não throughput de tokens ou latência de resposta; “—” significa que um resultado não é reportado nesta comparação.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Condições de avaliação |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Conjunto privado; Zapier leaderboard |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; fontes mistas |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Auto-teste / leaderboard |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; uma H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Timeout do verificador ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Ferramentas Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge leaderboard |
| GraphWalks até 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 itens |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 itens |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Aprovação binária; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Pontuação parcial offline; melhor de 3 execuções |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Sem ferramentas; Surge leaderboard |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Sem ferramentas; amostragem de quadros específica por modelo |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 desempata |
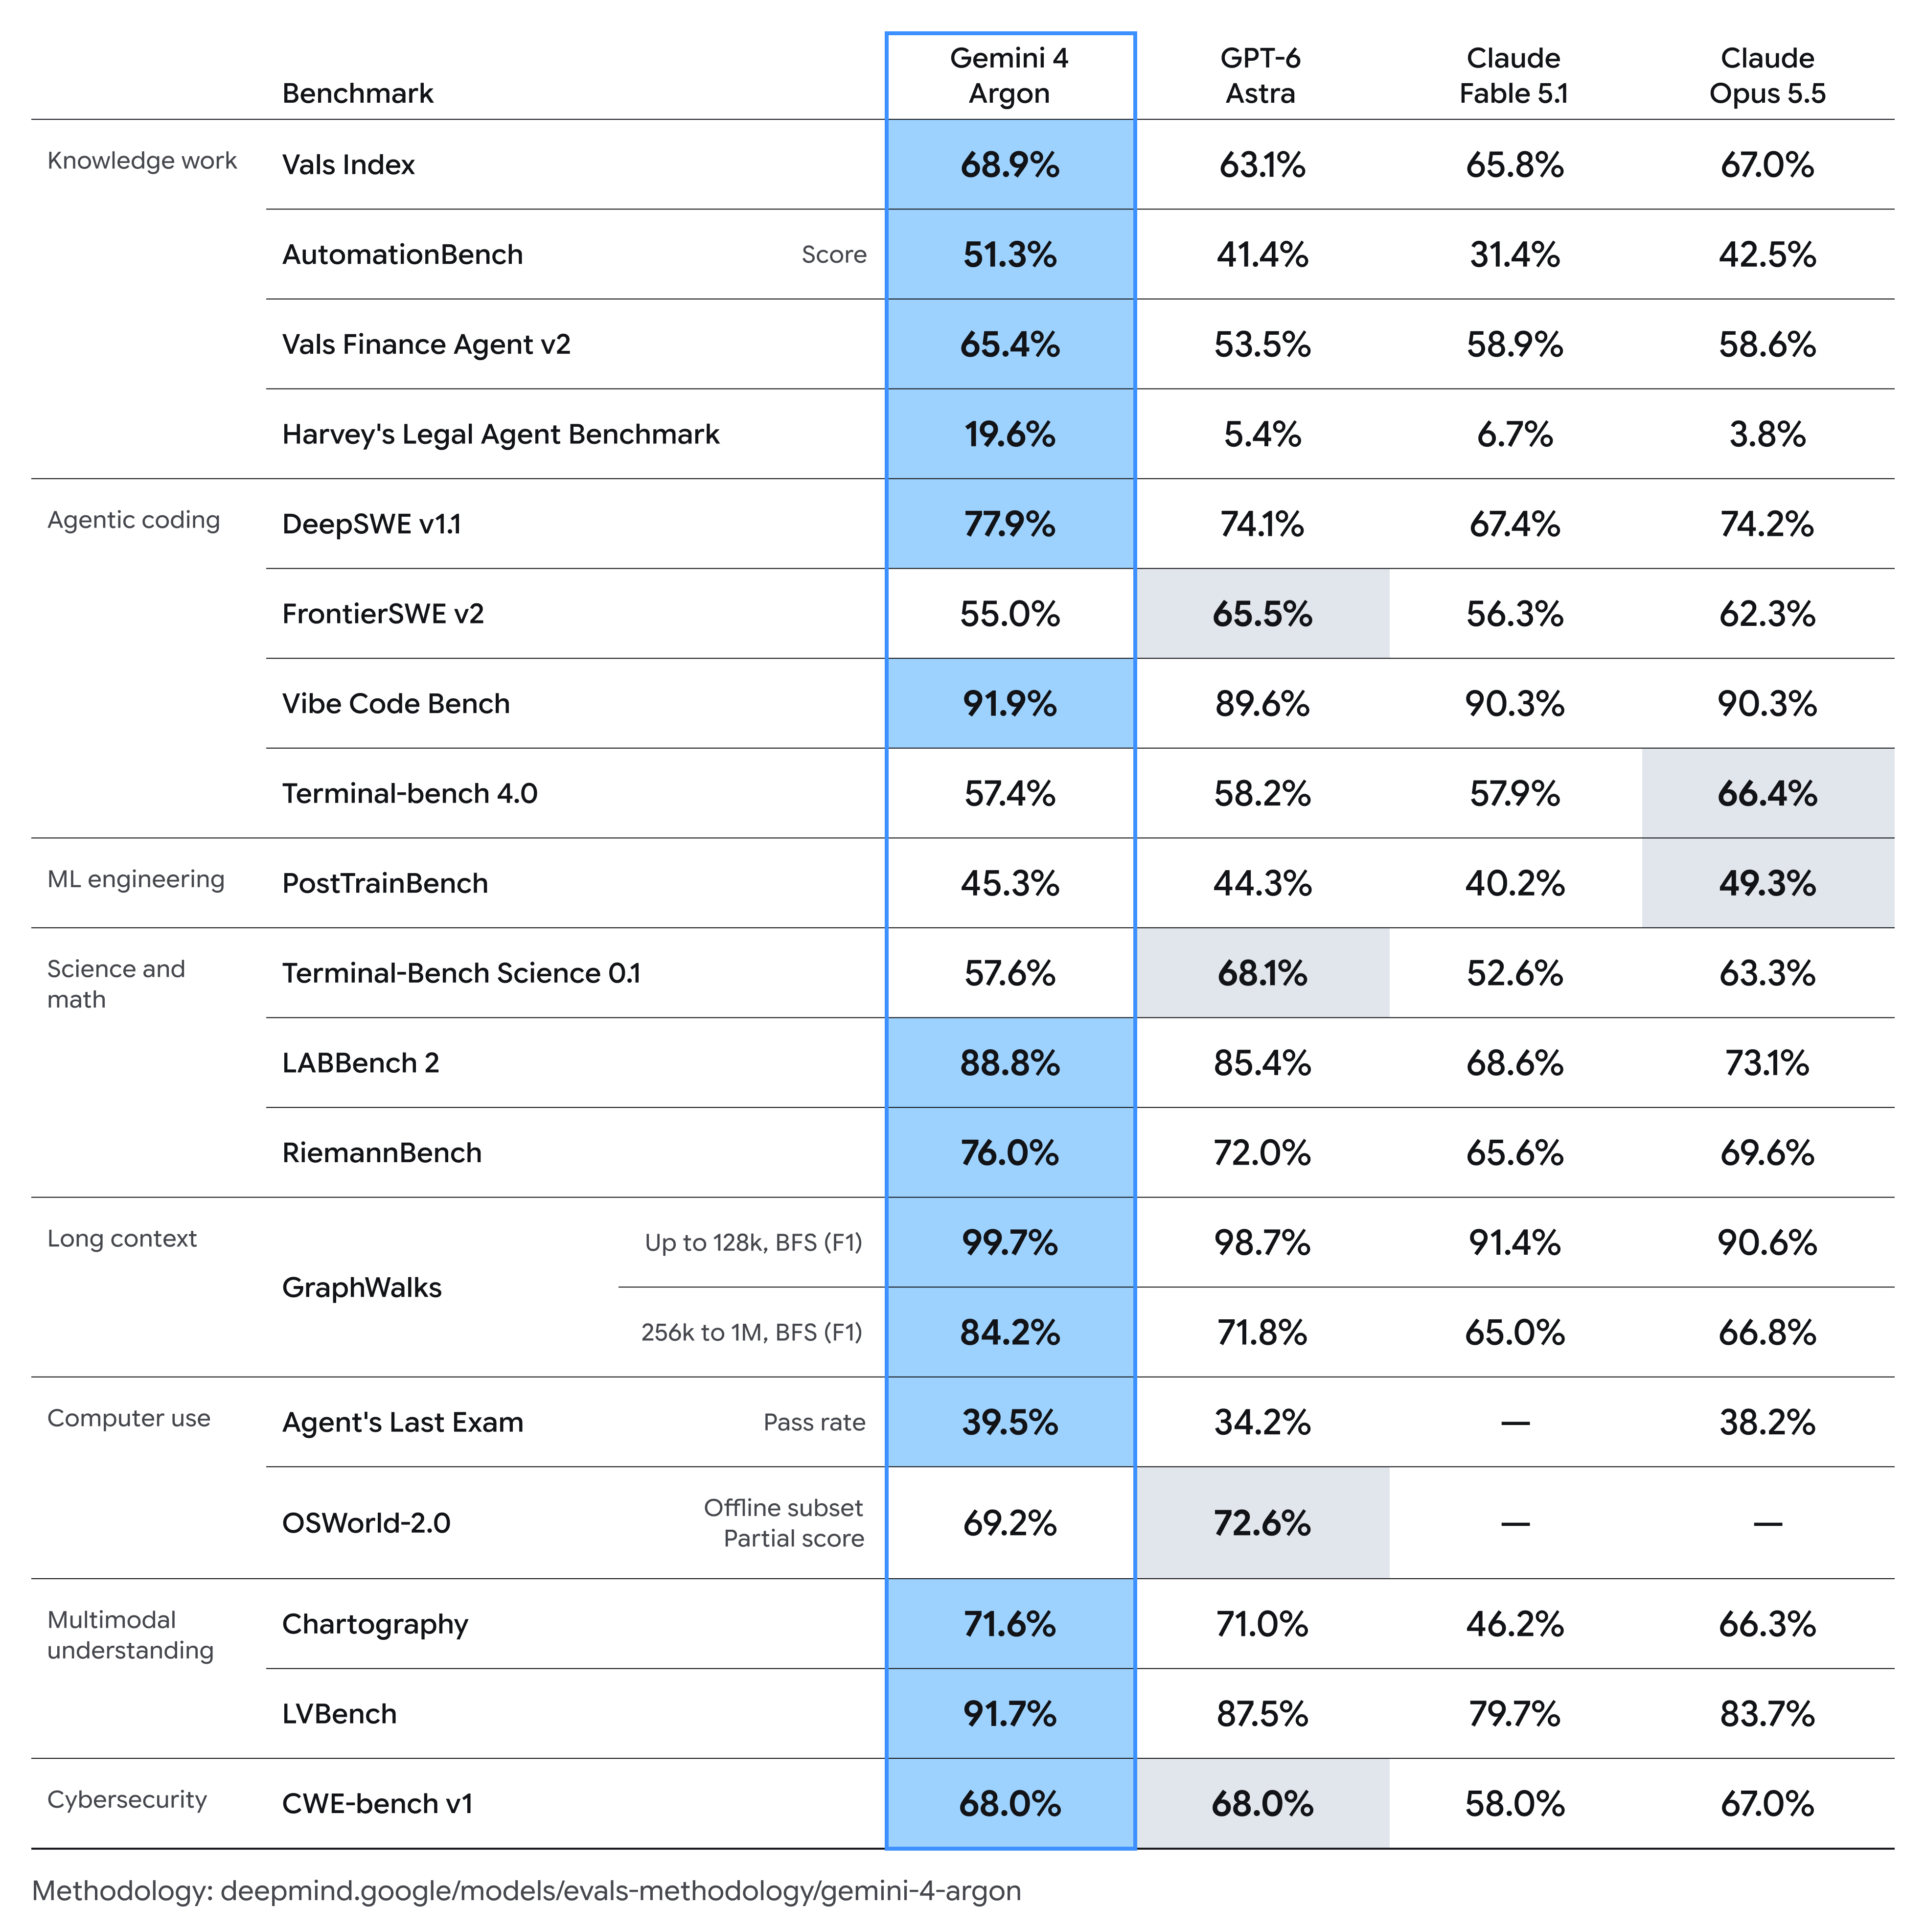
Comparação oficial de benchmarks do Gemini 4 Argon pela Google
Salvo indicação em contrário, os resultados do Argon usam uma única tentativa e a configuração de raciocínio mais alta. Os resultados de outros modelos geralmente vêm de relatórios dos provedores, com exceções específicas por benchmark. O LVBench usa 1 FPS para o Gemini, 800 quadros para o GPT-6 Astra, 300 para o Fable 5.1 e 600 para o Opus 5.5. Essas entradas não são idênticas, portanto compare as configurações reportadas em vez de tratar cada linha como uma repetição controlada.
Condições de avaliação e limitações
A tabela é útil, mas não deve ser interpretada como um ranking universal independente.
- A seleção de benchmarks é a seleção da Google.
- As configurações específicas de avaliação por benchmark variam entre as linhas, incluindo frameworks de agentes, orçamentos de tempo, ferramentas e amostragem de entrada.
- A metodologia oficial identifica resultados de competidores reportados pelos provedores como padrão, com exceções específicas de leaderboard e auto-cálculo.
- A configuração de benchmark mais alta pode não refletir uma configuração padrão de inferência em produção.
- Um score de benchmark de manchete sozinho não revela uso de tokens, chamadas de ferramentas, retentativas, tempo decorrido ou intervenção humana.
Para sistemas de produção, uma métrica melhor costuma ser o custo por tarefa concluída com sucesso, em vez do preço por token ou de um único percentual de benchmark.
Para quais workloads o Gemini 4 Argon é melhor?
Desempenho em trabalho de conhecimento
O padrão mais claro nos resultados do Argon aparece em trabalho profissional de conhecimento, com várias etapas.
No Vals Index, o Argon alcança 68.9%, comparado com 67.0% do Claude Opus 5.5. A diferença numérica é modesta, mas o padrão se torna mais evidente em workflows especializados.
- Vals Finance Agent v2: 65.4%, 6.5 pontos acima do competidor mais forte mostrado na tabela da Google.
- AutomationBench: 51.3%, 8.8 pontos acima do Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6%, comparado com 6.7% do próximo modelo mais alto reportado.
O perfil de desempenho sugere que o Argon se beneficia mais quando o modelo precisa coletar informações, preservar estado, raciocinar em várias etapas e produzir um artefato profissional, em vez de simplesmente responder a uma pergunta fechada.
O baixo score absoluto no benchmark jurídico também é importante. Um score de 19.6% sozinho não revela quantos critérios ou workflows completos falharam. A conclusão útil é que o Argon apresenta uma grande melhoria relativa nessa avaliação, enquanto o resultado não estabelece automação confiável de trabalho jurídico.
Raciocínio de longo contexto
A vantagem mais marcante do Argon pode estar na versão 256K–1M do GraphWalks.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Isso representa uma vantagem de 12.4 pontos sobre o modelo mais próximo na comparação publicada.
A diferença é bem menor em comprimentos de contexto mais curtos: no GraphWalks até 128K, o Argon marca 99.7% e o GPT-6 Astra marca 98.7%. Isso sugere que o Argon degrada menos acentuadamente do que os modelos comparados nessa avaliação específica de contexto muito longo.
O que a Google não divulgou é informação arquitetural suficiente para atribuir essa diferença a um mecanismo de atenção específico, sistema de recuperação, receita de treino ou estratégia de inferência. Afirmar, por exemplo, “Gemini 4 introduz uma nova arquitetura de atenção” iria além das evidências públicas.
Desempenho em codificação
A tabela oficial de benchmarks não sustenta um “sim” simples.
O Argon tem desempenho extremamente forte em algumas formas de codificação e perde claramente em outras. No DeepSWE v1.1 ele alcança 77.9%, contra 74.2% do Claude Opus 5.5 e 74.1% do GPT-6 Astra. Seu score no Vibe Code Bench também é forte, com 91.9%.
- FrontierSWE v2: 55.0% para o Argon vs. 65.5% para o GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% para o Argon vs. 66.4% para o Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% para o Argon vs. 68.1% para o GPT-6 Astra.
Essa divisão é importante para desenvolvedores. O Argon parece especialmente forte quando a codificação se torna um workflow de engenharia longo, com contexto substancial e planejamento, enquanto a execução intensiva em terminal permanece mais competitiva. Um benchmark de migração de repositório e um benchmark interativo de terminal não devem ser tratados como medidas intercambiáveis de “capacidade de codificação”.
Cibersegurança defensiva
Cibersegurança é uma área central de implantação. O posicionamento de cibersegurança defensiva da Google inclui descoberta autônoma de vulnerabilidades, validação e aplicação de patches. Esta é uma declaração de capacidade do provedor; o resultado no CWE-bench abaixo mede a remediação de vulnerabilidades em sua própria avaliação.
No CWE-bench v1, o Argon marca 68%, empatado com o GPT-6 Astra e ligeiramente à frente do Claude Opus 5.5 com 67%.
A Google também destaca proteções mais fortes contra uso indevido, injeção indireta de prompts, comportamento arriscado de agentes e comprometimento do ambiente de execução. Isso torna o Argon tanto um lançamento de segurança de agentes quanto uma atualização convencional de modelo.
Compreensão multimodal
O Argon marca 71.6% no Chartography e 91.7% no LVBench para compreensão de vídeos longos. O resultado do LVBench fica 4.2 pontos percentuais acima do GPT-6 Astra na tabela da Google. Como os modelos recebem configurações diferentes de amostragem de quadros, trata-se de uma comparação das configurações reportadas, e não de uma vantagem puramente do modelo.
Isso é relevante porque muitos workflows profissionais não são apenas texto. Um agente de pesquisa financeira pode precisar inspecionar um gráfico; um assistente empresarial pode combinar relatórios, PDFs e capturas de tela; um sistema de análise de vídeo pode precisar preservar eventos ao longo de uma sequência longa, em vez de processar quadros individuais de forma independente.
A combinação do Argon de percepção multimodal e raciocínio sustentado é, portanto, mais relevante do que apenas o suporte multimodal.
Desempenho em ciência e matemática
Os resultados são mistos, porém geralmente fortes. O Argon alcança 88.8% no LABBench 2 e 76.0% no RiemannBench, à frente dos modelos comparados na tabela da Google. Contudo, no Terminal-Bench Science 0.1, o GPT-6 Astra alcança 68.1% contra 57.6% do Argon.
Essa diferença aponta para um padrão mais amplo: o Argon parece mais forte em raciocinar sobre informação científica do que em toda forma de execução científica orientada a ferramentas.
Desempenho em uso de computador
No Agent's Last Exam, o Argon marca uma taxa de aprovação binária de 39.5%, à frente do GPT-6 Astra com 34.2% e do Claude Opus 5.5 com 38.2%. No subset offline do OSWorld-2.0, sua pontuação parcial é 69.2%, abaixo dos 72.6% do GPT-6 Astra. O valor do OSWorld não é uma taxa de sucesso de tarefa completa, e a ausência de entradas do Claude não implica capacidade zero.
Portanto, os dados atuais não mostram uma vantagem geral em uso de computador. Para implantação em produção, scores de benchmark devem ser complementados por testes em nível de tarefa de precisão de navegação, cliques falhos, frequência de retentativas, ações não intencionais, tempo até conclusão e taxa de correção humana.
Gemini 4 Argon vs GPT-6 Astra e Claude
| Dimensão | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Trabalho de conhecimento | Muito forte | Forte | Muito forte | Forte |
| Benchmark de longo contexto | Resultado mais forte publicado | Forte | Moderado–forte | Moderado |
| Codificação de longo horizonte | Muito forte | Muito forte | Muito forte | Forte |
| Codificação em terminal | Competitivo | Forte | Mais forte em teste selecionado | Competitivo |
| Agentes científicos em terminal | Competitivo | Mais forte em teste selecionado | Forte | Competitivo |
| Compreensão multimodal | Muito forte | Muito forte | Forte | Competitivo |
| Uso de computador | Competitivo | Forte | Misto / comparação limitada | Comparação limitada |
| Cibersegurança | Empatado no topo no CWE-bench v1 | Empatado no topo | Muito próximo | Inferior |
O Argon se destaca nesta comparação por longo contexto, trabalho com muitos documentos e agentes profissionais. Desenvolvedores podem compará-lo com o GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1 por meio da CometAPI.
Seleção baseada em desempenho
As etiquetas qualitativas acima resumem a tabela de benchmarks selecionada, não um ranking universal. Prefira o Argon para um piloto quando o trabalho se assemelhar às suas avaliações líderes; teste o Astra e o Opus em workloads intensivos de terminal antes de selecionar um padrão.
Especificações e restrições de implantação
Esta comparação de desempenho não estabelece uma vantagem de arquitetura ou um vencedor geral em preço-desempenho. A contagem de parâmetros e a arquitetura do Argon não estão especificadas nos materiais de lançamento da Google revisados. Seu limite de contexto de entrada público requer documentação oficial de API. A CometAPI relata uma rota gemini-4-argon; confirme seus parâmetros suportados e o acesso da conta independentemente do rollout mais amplo da Google. Compare os limites de cada rota e os custos reais por tarefa antes de implantar.
Como os desenvolvedores podem acessar o Gemini 4 Argon via CometAPI?
A CometAPI reporta o modelo como disponível sob gemini-4-argon. Use o dashboard da conta para criar uma chave de API, selecione esse identificador no playground e execute uma requisição de teste antes da integração. Seu exemplo compatível com OpenAI usa a base URL https://api.cometapi.com/v1. Confirme o endpoint e os parâmetros suportados do modelo na documentação da conta; um badge de catálogo sozinho não verifica uma chamada bem-sucedida.
- Crie uma conta na CometAPI e gere uma chave de API no dashboard.
- Escolha gemini-4-argon e valide uma requisição representativa no playground.
- Configure o cliente compatível com a base URL da CometAPI, sua chave e o identificador do modelo; confirme o esquema de requisição suportado e a cobrança antes da implantação.
CometAPI e preços oficiais
A Google anunciou preços introdutórios de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, com entrada em cache precificada com 95% de desconto sobre a taxa de entrada. Após o período introdutório, as tarifas anunciadas são $4 para entrada e $20 para saída por milhão de tokens. Estes são os preços anunciados pela Google, não os preços da CometAPI nem confirmação de acesso imediato geral à API.
| Base de cobrança | Gemini 4 Argon API na CometAPI | Anúncio oficial da Google | Comparação |
|---|---|---|---|
| Entrada / 1M tokens | $3.20 | $4.00 após o período introdutório | 20% abaixo da taxa pós-introdutória anunciada |
| Saída / 1M tokens | $16.00 | $20.00 após o período introdutório | 20% abaixo da taxa pós-introdutória anunciada |
Conclusão
O perfil de benchmarks do Gemini 4 Argon é mais interessante do que uma simples reivindicação de leaderboard.
Os resultados mais fortes nesta comparação se concentram em trabalho profissional de conhecimento, longo contexto e execução sustentada de agentes. Esse padrão é útil para seleção de workloads, mas não identifica a arquitetura subjacente nem prova qual mecanismo causou os ganhos.
Os resultados reportados em finanças, jurídico, vídeo longo e engenharia de software suportam um piloto focado nesses workloads. Se a mesma vantagem persiste em produção depende do mix de entradas, do framework de agente, das configurações de inferência e dos requisitos de verificação.
Ao mesmo tempo, os resultados mostram que o desempenho de modelos de fronteira está se tornando cada vez mais especializado. O Argon pode liderar no DeepSWE enquanto fica atrás no FrontierSWE; liderar no Agent's Last Exam enquanto fica atrás no OSWorld; e liderar no LABBench enquanto fica atrás no Terminal-Bench Science. Esses benchmarks estressam partes diferentes de um sistema de agente.
Para desenvolvedores, a lição mais importante é que a seleção de modelo precisa acontecer cada vez mais no nível da carga de trabalho, e não da marca ou família.
FAQ
Como os desenvolvedores devem validar o Gemini 4 Argon em seus próprios workloads?
Construa um conjunto de tarefas representativo com critérios de aceitação explícitos. Mantenha ferramentas, limites de tempo, preparação de entradas e políticas de retentativas comparáveis entre os modelos. Registre tarefas concluídas, tokens totais, tempo decorrido e correções humanas. Comece com um piloto pequeno e examine casos de falha antes de direcionar tráfego de produção.
As porcentagens de benchmark do Gemini 4 Argon devem ser combinadas em um único score?
Não. A tabela combina diferentes métricas, incluindo F1, taxas de aprovação e scores parciais. Use critérios específicos por tarefa em vez de fazer a média de todos os percentuais.
Um agente Gemini 4 Argon deve sempre usar todo o seu orçamento de saída?
Não. Escolha o menor orçamento testado que atenda aos seus requisitos de qualidade e confiabilidade. O limite máximo de saída é um teto, não uma meta.
Como as equipes devem avaliar o acesso ao Gemini 4 Argon via CometAPI?
Comece com uma verificação de disponibilidade no nível da conta e uma pequena requisição usando a rota documentada da CometAPI. Meça a qualidade da resposta, latência, limites e tokens cobrados, depois aplique os mesmos testes de aceitação usados para modelos alternativos. Trate a reivindicação de acesso da CometAPI separadamente do rollout mais amplo da Google e mantenha o roteamento configurável até que a rota atenda aos seus requisitos.