
TL;DR
O Gemini 4 Argon não está incluído no Gemini API Free tier, e apenas uma assinatura do Google AI Pro não concede acesso à API do Argon. O Google AI Ultra pode oferecer acesso por meio de produtos Gemini selecionados, enquanto o uso pago da API continua sendo cobrado separadamente. A CometAPI oferece uma rota de API independente sem exigir que cada usuário final tenha uma assinatura Google AI Pro ou Ultra. Suas tarifas publicadas para entrada e saída não armazenadas em cache são de $1,60 e $8 por milhão de tokens, em comparação com as tarifas Padrão introdutórias do Google de $2 e $10.
Acesso e tarifas de provedores em destaque verificadas em 16 de outubro de 2026.
Principais pontos
- Preço introdutório: $2 / 1M tokens de entrada e $10 / 1M tokens de saída; a partir de 1º de dezembro, as tarifas dobram.
- Entrada em cache: desconto de 95% de cache implícito em acertos elegíveis; o mínimo do cache é 4,096 tokens de prompt.
- A cobrança de saída inclui tokens de raciocínio; entrada, raciocínio e saída visível compartilham um orçamento de 1,048,576 tokens.
- Separe as assinaturas do app Gemini dos direitos no Antigravity e do acesso pago à API. A ausência de um modelo em um produto não estabelece que todas as rotas de acesso estejam indisponíveis.
- A CometAPI fornece uma rota de API independente com tarifas publicadas de entrada e saída sem cache mais baixas. Os aplicativos podem atender vários usuários finais por meio de uma única conta CometAPI sem exigir que cada usuário mantenha uma assinatura Google AI Pro ou Ultra; ainda se aplicam limites de cota, saldo, tarifa e concorrência no nível da conta.
Quais são os limites atuais de acesso ao Gemini 4 Argon do Google?
A primeira decisão é onde você precisa do Argon: um app interativo, um ambiente de codificação local ou uma integração de API. O anúncio de acesso para desenvolvedores do Google diferencia o acesso pago ao Gemini API do acesso dos assinantes Ultra no AI Studio e no Antigravity. Não interprete uma restrição de assinatura do Antigravity como uma exigência de comprar Ultra para todo fluxo de trabalho pago da API.
Para um aplicativo de API, a CometAPI fornece uma rota alternativa de conta e cobrança. Isso pode ser útil quando você quer avaliar o Argon ao lado de outros modelos sem comprar uma assinatura de consumidor do Google para esse fim. Isso não altera direitos de acesso dentro dos próprios apps do Google e não deve ser descrito como uso ilimitado.
Quanto custa a API do Gemini 4 Argon?
As tarifas Standard do Gemini 4 Argon do Google se aplicam até 30 de novembro de 2026, com tarifas mais altas a partir de 1º de dezembro. Todos os valores abaixo são em USD por milhão de tokens, salvo indicação em contrário. Batch, Flex e Priority têm tarifas separadas.
| Categoria de cobrança (USD / 1M tokens) | Google Standard: até 30 de novembro de 2026 | Google Standard: a partir de 1º de dezembro de 2026 | Gemini 4 Argon API na CometAPI |
|---|---|---|---|
| Entrada | $2.00 | $4.00 | $1.60 |
| Entrada em cache | $0.10 | $0.20 | $0.16 |
| Saída, incluindo raciocínio | $10.00 | $20.00 | $8.00 |
As tarifas da CometAPI foram verificadas em 14 de outubro de 2026. Seus preços publicados de entrada e saída estão 20% abaixo das tarifas Standard introdutórias do Google. A cifra de entrada em cache vem da calculadora de custos da CometAPI; confirme a tarifa ativa da conta e a elegibilidade de cache antes de confiar nela. A mudança de preços de dezembro no Google não determina as tarifas futuras da CometAPI; verifique as tarifas exibidas na sua conta CometAPI ao elaborar o orçamento.
A essas tarifas, 200,000 tokens de entrada sem cache mais 60,000 tokens de saída faturáveis custam $0.80 pela CometAPI, em comparação com $1.00 pelo Google durante o período introdutório. Este exemplo calculado exclui ferramentas e novas tentativas.
Quanto custa o Gemini 4 Argon em cargas de trabalho realistas?
Os cenários a seguir são exemplos calculados, não uso de modelo medido. A entrada não usa cache; a saída inclui tanto o raciocínio quanto o texto visível. Uma solicitação de agente de codificação com 200,000 tokens de entrada e 60,000 tokens de saída faturáveis custa $1.00 durante o período introdutório e $2.00 posteriormente. A mesma carga repetida 1,000 vezes custa $1,000 ou $2,000 antes de novas tentativas, ferramentas e impostos.
| Solicitação de exemplo | Tokens de entrada não em cache | Tokens de saída faturáveis | Preço introdutório | Preço Standard |
|---|---|---|---|---|
| Resposta curta do assistente | 5K | 1K | $0.02 | $0.04 |
| Análise de documento | 100K | 10K | $0.30 | $0.60 |
| Agente de codificação complexo | 200K | 60K | $1.00 | $2.00 |
| Fluxo de pesquisa | 500K | 100K | $2.00 | $4.00 |
| Solicitação de decodificação longa | 100K | 500K | $5.20 | $10.40 |
Fórmula: Custo = (tokens de entrada não em cache × tarifa de entrada + tokens de entrada em cache × tarifa em cache + tokens de saída faturáveis × tarifa de saída) / 1,000,000. Os exemplos acima são ilustrativos e presumem ausência de cache.
Como reduzir os custos da API do Gemini 4 Argon?
Cache implícito e prefixos de prompt reutilizados
O cache reduz o gasto de entrada reutilizada, não o preço do pedido inteiro. Para o exemplo de 200K de entrada / 60K de saída, um acerto completo elegível de cache de entrada reduz o custo introdutório de entrada de $0.40 para $0.02. O custo total de tokens passa a $0.62 em vez de $1.00: uma redução de 38%, embora o desconto de entrada seja de 95%. Se 50% dos tokens de entrada forem atendidos a partir do cache, a mesma solicitação custa $0.81: 100,000 tokens de entrada em cache × $0.10 / 1M + 100,000 tokens de entrada sem cache × $2 / 1M + 60,000 tokens de saída faturáveis × $10 / 1M = $0.01 + $0.20 + $0.60. Aqui, 50% refere-se especificamente ao volume de tokens de entrada. Trate isso como cenários e use o uso observado de tokens em cache para previsão.
O Google habilita cache implícito para prompts de pelo menos 4,096 tokens e não oferece suporte à criação explícita de cache para o Argon. Preserve prefixos de prompt reutilizáveis, mas orce a entrada sem cache até que acertos observados no cache justifiquem uma estimativa menor.
Níveis de raciocínio e gasto com saída
Uma resposta visível curta ainda pode carregar um custo de saída substancial porque o raciocínio é faturável. Comece com raciocínio médio e depois teste níveis mais baixos e mais altos em tarefas representativas. Acompanhe tanto a qualidade quanto o uso total de saída; escolha o nível de raciocínio mais baixo que atenda aos seus critérios de aceitação.
Como o raciocínio e a saída visível compartilham o limite de resposta, um valor baixo de max_output_tokens pode deixar espaço insuficiente para a resposta final. Compare a conclusão bem-sucedida da tarefa em cada nível de raciocínio antes de reduzir o limite de saída.
Controles operacionais para os custos do Gemini 4 Argon
- Use limites de saída realistas e evite gerações longas desnecessárias.
- Reutilize prefixos de prompt compartilhados quando elegíveis para cache implícito.
- Direcione tarefas simples para modelos mais baratos, reservando o Argon para casos difíceis.
- Registre tokens faturáveis totais, falhas, novas tentativas e custo por tarefa concluída.
- Avalie a economia nas tarifas pós-promocionais antes de se comprometer com uma implantação grande.
Como acessar o Gemini 4 Argon?
Escolha o acesso via app Gemini para trabalho interativo pessoal e uma rota de API paga para aplicativos e agentes automatizados. O Argon está excluído do Free tier do Gemini API; uma assinatura Google AI Pro por si só não concede acesso à API do Argon. As concessões de app Pro e Ultra são separadas da cobrança por tokens na API, e o Ultra não é obrigatório para a Gemini API paga.
| Rota de acesso | Acesso ao Argon | Cobrança / direito |
|---|---|---|
| App Gemini | Assinantes Pro e Ultra elegíveis | Assinatura e limites do app |
| Google AI Studio | Assinantes Ultra elegíveis ou usuários da API paga | Depende da rota de acesso |
| Gemini API | Projetos pagos elegíveis | Cobrança de API por uso |
| Google Antigravity | Assinantes Ultra elegíveis | Direito específico do produto |
| CometAPI | Contas CometAPI compatíveis | Tarifas e condições da CometAPI |
Integração direta com a API do Gemini 4 Argon
Desenvolvedores podem integrar o Gemini 4 Argon diretamente por meio de um projeto pago elegível do Gemini API. O ID do modelo é gemini-4-argon. Essa rota é destinada a aplicativos, agentes automatizados e fluxos de produção que exigem acesso direto à API do Google, cobrança por uso e recursos oficiais da API.
O Free tier do Gemini API não inclui o Argon. O acesso ao app Google AI Pro também não fornece automaticamente acesso à API ou créditos de API. Os desenvolvedores devem configurar cobrança e elegibilidade para o projeto associado às credenciais da API.
Erros de autenticação, cobrança ou elegibilidade devem ser resolvidos para o projeto que possui a chave antes de tentar novamente; alterar apenas uma assinatura de consumidor não configura a cobrança da API.
Acesso via CometAPI ao Gemini 4 Argon
Os desenvolvedores podem acessar a Gemini 4 Argon API in CometAPI por meio de uma conta e chave de API separadas. As vantagens práticas são cobrança de API independente, acesso a vários modelos por um único provedor e as tarifas de entrada/saída publicadas comparadas acima. Essa rota não exige a compra do Google AI Pro ou Ultra como assinatura de consumidor.
O acesso por conta não é uma promessa de capacidade irrestrita. Confirme disponibilidade do modelo, saldo, limites de taxa e concorrência, regiões compatíveis, cache, controles de raciocínio e relatórios de uso para sua conta CometAPI. O acesso à API também não desbloqueia o Argon dentro do app Gemini ou do Antigravity.
Comece com uma solicitação pequena pelo provedor escolhido, verifique os campos de modelo e uso retornados e, em seguida, defina um limite de gastos antes de aumentar o tráfego.
Vale a pena o custo do Gemini 4 Argon?
O Gemini 4 Argon é um candidato para trabalhos exigentes de raciocínio, codificação, pesquisa e longo contexto. Seu valor depende de melhorar a conclusão bem-sucedida de tarefas ou reduzir novas tentativas o suficiente para justificar o gasto de tokens. Use as especificações e benchmarks publicados abaixo para identificar cargas de trabalho a testar e, depois, avalie qualidade e custo com seus próprios prompts, ferramentas e rota de acesso.
Especificações do Gemini 4 Argon
| Especificação | Gemini 4 Argon |
|---|---|
| ID do modelo | gemini-4-argon |
| Desenvolvedor | Google DeepMind |
| Tipo de modelo | Modelo multimodal orientado a raciocínio |
| Janela unificada de entrada + raciocínio + saída | Até 1,048,576 tokens combinados |
| Níveis de raciocínio | Baixo / médio / alto |
| Nível de raciocínio padrão | Médio |
| Suporte a saídas longas | Execução em segundo plano; máximo sujeito ao orçamento compartilhado |
| Cache de contexto | Implícito; prompts elegíveis ≥ 4,096 tokens |
| Cache explícito | Não suportado |
O limite de um milhão de tokens é compartilhado entre entrada, raciocínio e saída gerada. Na Interactions API, gerar mais de 65,536 tokens requer tanto background=True quanto generation_config.max_output_tokens acima de 65,536. Definir apenas background=True não eleva o limite padrão de saída. A GenerateContent API também oferece suporte à continuação no lado do cliente para decodificação longa
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: benchmarks publicados
Os valores a seguir correspondem aos resultados de avaliação publicados pelo Google. São resultados publicados pelo fornecedor, compilados de múltiplas fontes de avaliação, em vez de uma nova comparação controlada feita para este artigo.
| Benchmark publicado | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Condições de avaliação e comparabilidade
A metodologia de avaliação do Google usa o Gemini API no nível mais alto de raciocínio, salvo especificação em contrário, geralmente com pass@1. DeepSWE usa mini-swe para o Argon; os números dos concorrentes vêm de rankings ou cards do sistema. GraphWalks 256K–1M usa 200 problemas. LVBench roda sem ferramentas, com 1 FPS para o Gemini, 800 frames para o GPT-6 Astra e 600 para o Opus 5.5. Os resultados do Vals vêm da Vals AI; o AutomationBench usa a classificação de conjunto privado da Zapier. Essas diferenças limitam a comparabilidade direta.
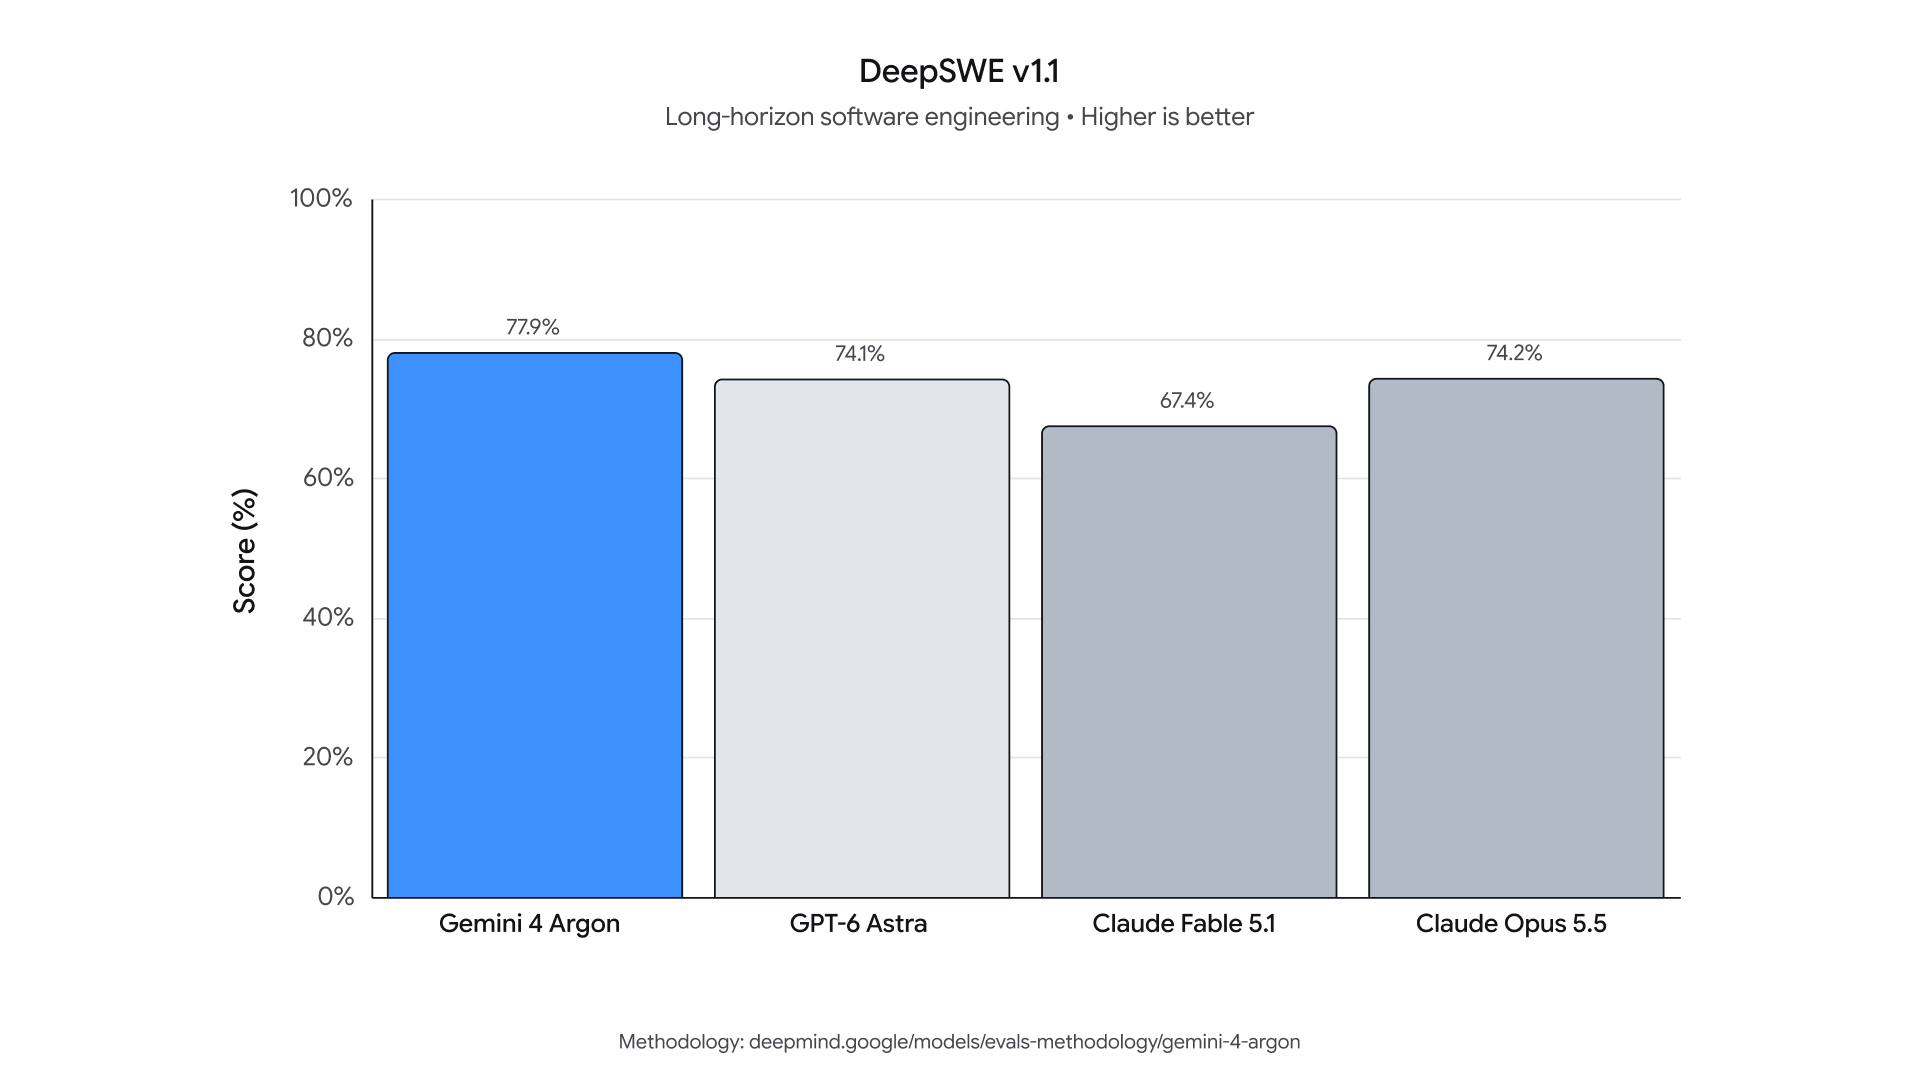
O gráfico original do DeepSWE v1.1 do Google mostra Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) e Claude Opus 5.5 (74.2%), da esquerda para a direita. A tabela acima seleciona três desses modelos; a imagem oficial inclui todos os quatro.
Implicações de desempenho para usuários do Gemini 4 Argon
Interpretação: o Argon lidera nas linhas selecionadas de Vals Index, AutomationBench, agente financeiro e longo contexto; não lidera em FrontierSWE ou Terminal-bench. Como os arcabouços de avaliação e prompts podem variar, use esses resultados como evidência direcional e rode testes específicos para suas cargas de trabalho.
Para compras, meça o custo de uma tarefa bem-sucedida ao lado de acurácia, latência, novas tentativas e uso de tokens. Uma pontuação publicada mais alta não estabelece menor custo de produção sob seus prompts, ferramentas ou rota de acesso.
Escolher o Gemini 4 Argon ou um modelo mais barato
Teste o Argon em tarefas difíceis de raciocínio, codificação e longo contexto, nas quais menos novas tentativas ou uma taxa de conclusão mais alta possam justificar maior gasto de tokens. Para classificação rotineira, extração e sumarização em alto volume, teste primeiro modelos de menor custo.
Compare o custo total por tarefa bem-sucedida, incluindo tokens de raciocínio, uso de cache, chamadas de ferramentas e novas tentativas. Escolha o modelo e a rota de acesso que atendam aos seus requisitos de qualidade a um custo aceitável.
Perguntas frequentes
Batch e Flex do Gemini 4 Argon são mais baratos que Standard?
As tarifas de tokens do Argon Batch e Flex do Google são $1 de entrada e $5 de saída por milhão de tokens até 30 de novembro de 2026, subindo para $2 e $10 depois. A entrada em cache é $0.05, subindo para $0.10. Essas são opções de processamento separadas, portanto valide suas restrições operacionais em relação à sua carga de trabalho antes de substituir uma integração Standard.
Estime separadamente o uso de Standard, Batch e Flex usando as tarifas aplicáveis a cada opção e, em seguida, some os subtotais para um orçamento de carga de trabalho mista.
As estimativas de tokens do Gemini 4 Argon incluem cobranças de pesquisa?
Não. A aritmética de tokens por si só exclui serviços cobrados separadamente. A Search grounding charge do Google é $14 por 1,000 consultas após a franquia mensal compartilhada de 5,000 solicitações para modelos Gemini 3 e mais novos. Uma solicitação enviada pode emitir mais de uma consulta de pesquisa, portanto acompanhe o uso real de grounding separadamente em vez de supor que um prompt do usuário seja igual a uma consulta faturável.
Como devo orçar o Gemini 4 Argon ao longo da mudança de preço?
Divida a previsão de uso de tokens nos períodos introdutório e padrão e aplique as tarifas de cada período. Por exemplo, 10 milhões de tokens de entrada sem cache mais 1 milhão de tokens de saída custam $30 nas tarifas Standard introdutórias ou $60 depois. Se metade desse volume ocorrer em cada período, a estimativa de tokens é $45. Adicione separadamente os custos de ferramentas e novas tentativas e use as tarifas pós-promoção para um orçamento de estado estável.
Por que uma resposta do Gemini 4 Argon pode parar antes de ser concluída?
O limite de saída inclui o raciocínio além do texto visível. Um prompt exigente pode esgotar essa cota antes da conclusão da resposta final. Para respostas longas, a execução em segundo plano continua a geração em etapas até a conclusão ou o limite configurado; ainda é necessário um valor adequado de max_output_tokens. Verifique o status de conclusão e o uso e, então, ajuste a profundidade de raciocínio ou o limite em vez de reenviar repetidamente a mesma solicitação com orçamento insuficiente.
Conclusão
Escolha o acesso ao Gemini 4 Argon por fluxo de trabalho e, em seguida, compare o custo de concluir uma tarefa útil. As concessões de app do Google e do Antigravity diferem do acesso pago à API. A CometAPI oferece uma rota de API separada com preços de entrada/saída publicados 20% abaixo das tarifas Standard introdutórias do Google, tornando-a uma opção prática para uma avaliação pequena e orçada. Valide limites de conta e recursos necessários, acompanhe tokens de raciocínio e novas tentativas e só aumente a escala quando a qualidade e o custo total atenderem às suas necessidades.