


TL;DR
Escolha Gemini 4 Carbon quando menor custo for sua prioridade e ele atender aos seus requisitos de qualidade, especialmente para áudio, vídeo e automação empresarial repetitiva. Escolha Claude Fable 5.2 para mudanças de código difíceis e pesquisa técnica quando seus resultados mais fortes ou esperas mais curtas justificarem a fatura mais alta. Com volumes iguais de entrada e saída não em cache, as tarifas padrão listadas do Carbon são 75% menores durante seu período introdutório e 50% menores a partir de 1º de dezembro de 2026. Fable lidera seis dos sete benchmarks selecionados publicados pelos fornecedores, mas uma pontuação mais alta por si só não o torna a escolha de melhor valor. Compare o custo de um resultado utilizável, incluindo novas tentativas e tempo de revisão.
Principais pontos
- Melhor para codificação difícil e pesquisa: Claude Fable 5.2. Ele lidera seis dos sete benchmarks selecionados publicados pelos fornecedores, incluindo FrontierSWE v2 e Terminal-Bench-Science 0.1.
- Melhor para áudio, vídeo e automação empresarial: Gemini 4 Carbon. Ele aceita áudio e vídeo diretamente e lidera o AutomationBench na comparação publicada.
- Preços padrão de tokens mais baixos: Gemini 4 Carbon. Suas tarifas de entrada e saída não em cache são 75% abaixo das do Fable durante o período introdutório e 50% abaixo a partir de 1º de dezembro de 2026.
- Mais rápido no snapshot de alto esforço: Claude Fable 5.2. O tempo relatado por tarefa é de 16,7 minutos versus 25,7 do Carbon. Escolha o Carbon quando o menor custo por tarefa importar mais: $7,76 versus $9,08 nesse mesmo snapshot.
Visão geral: Gemini 4 Carbon vs Claude Fable 5.2
Os preços estão em USD por milhão de tokens. Configurações de benchmark e categorias adicionais de cobrança aparecem nas seções abaixo.
O que é Gemini 4 Carbon?
Gemini 4 Carbon é o modelo de raciocínio do Google DeepMind para engenharia de software complexa, problemas científicos e trabalho de conhecimento. Ele aceita texto, imagens, áudio e vídeo, com um orçamento unificado de 1.048.576 tokens para entrada, raciocínio e saída. O acesso mais amplo foi aberto em 10 de novembro de 2026 (https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/). Sua combinação de suporte a mídia e preços padrão de tokens mais baixos o torna um ponto de partida útil para automação pesada de documentos, reuniões gravadas e pesquisa multimodal.
O que é Claude Fable 5.2?
Claude Fable 5.2 é o modelo da Anthropic para trabalho técnico exigente e sessões de agentes de longa duração. Lançado em 9 de novembro de 2026 (https://platform.claude.com/docs/en/models/fable-5-2/overview), ele suporta texto e imagens, uma janela de contexto de 1M tokens e até 128K tokens de saída. O raciocínio adaptativo permanece ligado, com controles de esforço para profundidade de raciocínio. É um forte primeiro candidato quando você precisa de ajuda com mudanças de código difíceis, pesquisa em múltiplas etapas ou um problema complexo que justifique um orçamento de tokens maior.
Comparação de recursos e parâmetros
Capacidades de entrada multimodal
Carbon tem uma gama publicada mais ampla de modalidades de entrada. O suporte a áudio e vídeo o torna atraente para análise de vídeo, reuniões gravadas, pesquisa multimodal e documentos visuais de engenharia. Fable 5.2 concentra-se em texto e imagens, incluindo análise de documentos, revisão de código visual, diagramas técnicos e raciocínio assistido por imagem.
Para um fluxo de mídia, experimente cedo uma gravação típica ou vídeo e verifique a qualidade das evidências extraídas. Para trabalho apenas em texto, concentre-se na qualidade da resposta, velocidade e custo. Carbon tem uma gama publicada mais ampla de modalidades de entrada. O suporte a áudio e vídeo o torna atraente para análise de vídeo, reuniões gravadas, pesquisa multimodal e documentos visuais de engenharia. Fable 5.2 concentra-se em texto e imagens, incluindo análise de documentos, revisão de código visual, diagramas técnicos e raciocínio assistido por imagem.
Especificações do modelo e suporte de API
O cartão do modelo Carbon identifica Gemini 4 Argon como sua base (https://deepmind.google/models/model-cards/gemini-4-carbon/). Desenvolvedores também podem acessar a API do Gemini 4 Argon no CometAPI (https://www.cometapi.com/models/google/gemini-4-argon/).
Carbon expõe níveis de raciocínio configuráveis; Fable usa raciocínio adaptativo que permanece habilitado enquanto o esforço controla a profundidade. Para desenvolvedores, a distinção útil é quanto controle cada API oferece sobre o esforço de raciocínio.
CometAPI oferece uma interface compartilhada para experimentar ambos os modelos. Use a documentação oficial da API quando sua aplicação precisar de controles especializados, como decodificação longa. Embora ambos os modelos estejam acessíveis pela interface Chat Completions compatível com OpenAI do CometAPI, os controles de raciocínio específicos do provedor não são necessariamente intercambiáveis. Comece com as configurações padrão, depois verifique os parâmetros suportados em cada rota de modelo.
Gemini 4 Carbon vs Claude Fable 5.2: Desempenho
Resultados de benchmarks publicados e condições de teste
A comparação de benchmark de 9 de novembro da Anthropic (https://www.anthropic.com/claude-fable-and-mythos-5-2) fornece os seguintes resultados para ambos os modelos. Ela relata o maior esforço disponível, a menos que especificado de outra forma. FrontierCode 2.0 é uma exceção explícita: Fable usa Xhigh e Carbon usa Medium. A tabela registra as condições relatadas para que você possa interpretar as pontuações juntamente com as configurações.
Fable vence seis dessas sete comparações relatadas; Carbon vence o AutomationBench. A coluna Vencedor identifica a pontuação mais alta em cada linha. Leia-a juntamente com as configurações de teste, particularmente os diferentes níveis de esforço usados no FrontierCode 2.0.
A metodologia de avaliação do Google distingue seus próprios testes de resultados de rankings externos (https://deepmind.google/models/evals-methodology/gemini-4-carbon/). Por exemplo, sua avaliação OSWorld usa um subconjunto offline e um harness específico de uso de computador. Seus resultados de cibersegurança relatados refletem o acesso pelo Fairwind Program.
Codificação e pesquisa científica
Fable lidera os resultados selecionados do FrontierSWE v2 por 8,7 pontos percentuais e do Terminal-Bench-Science 0.1 por 9,8 pontos. Essas diferenças o tornam um primeiro candidato útil para tarefas exigentes de engenharia e pesquisa.
O preço mais alto do Fable é mais fácil de justificar quando um patch melhor ou uma análise mais confiável economiza tempo substancial de depuração e revisão. Para mudanças rotineiras que o Carbon já lida bem, pagar mais pela força em benchmarks pode não melhorar o resultado que você recebe.
A Anthropic descreve demonstrações multiagente em engenharia de software e matemática formal (https://www.anthropic.com/claude-fable-and-mythos-5-2), incluindo um projeto de sistema operacional protótipo de oito dias e uma formalização de 30 horas do Último Teorema de Fermat. As demonstrações mostram como agentes coordenados podem contribuir para projetos prolongados de engenharia e matemática.
Automação empresarial e compreensão visual
Carbon lidera o AutomationBench por 2,5 pontos percentuais na comparação publicada, enquanto Fable lidera o Chartography por 0,9 ponto. Para fluxos de trabalho de escritório, compare extração de campos, precisão de cálculos e a qualidade do documento finalizado. Carbon também é o ponto de partida mais relevante quando o material de origem inclui áudio ou vídeo.
Para fluxos repetidos, mesmo uma pequena diferença de custo pode se acumular ao longo de muitas execuções. Comece com o Carbon se ele atender à sua meta de precisão e migre para o Fable apenas quando ele produzir uma melhoria mensurável que valha a diferença de custo.
Velocidade e desempenho de tarefas independentes
A comparação de alto esforço do Artificial Analysis (https://artificialanalysis.ai/models/releases/comparisons/claude-fable-5-2-vs-gemini-4-carbon) oferece uma segunda perspectiva. Os números abaixo são um snapshot de 12 de novembro de 2026. Ambos os modelos usam suas respectivas configurações High nesta comparação.
Neste snapshot de 12 de novembro, Carbon custa cerca de 14,5% menos por tarefa medida, enquanto Fable leva cerca de 35,0% menos tempo e gera tokens de saída 22,5% mais rápido. Fable também atinge seu primeiro token de resposta mais cedo. Escolha o Carbon para trabalho em segundo plano onde o custo importa mais; escolha o Fable quando você valoriza mais uma espera mais curta. Estes são resultados de cargas de trabalho medidas, não uma promessa de que toda tarefa de codificação terminará na mesma velocidade. Os valores de benchmark ao vivo podem mudar conforme os provedores e as configurações de avaliação mudam.
Mantenha o custo da tarefa separado do preço de tokens. A economia de 14,5% do Carbon nesta carga medida é uma comparação diferente de suas tarifas introdutórias 75% mais baixas: modelos podem usar quantidades diferentes de raciocínio, saída e novas tentativas para concluir uma tarefa.
Gemini 4 Carbon vs Claude Fable 5.2: Custo
Carbon é a opção mais barata com volumes iguais de entrada padrão não em cache e saída faturável sob as tarifas abaixo. Os resultados mais fortes do Fable em vários benchmarks ainda podem justificar seu prêmio se reduzirem tentativas fracassadas, correções manuais ou tempo de espera. Compare tanto a fatura da API quanto o trabalho necessário para obter um resultado utilizável. Os preços oficiais dos provedores e os preços das rotas do CometAPI são tabelas separadas; use as tarifas do endpoint que você realmente chama. Todos os preços abaixo estão em USD por milhão de tokens.
- Durante o período introdutório do Carbon: entrada e saída padrão não em cache custam 75% menos que as do Fable em volumes iguais de tokens. Para 100.000 tokens de entrada e 20.000 tokens de saída faturável, isso é $0,40 para o Carbon versus $1,60 para o Fable.
- A partir de 1º de dezembro de 2026: as tarifas padrão programadas do Carbon permanecem 50% menores. O mesmo exemplo sobe para $0,80 para o Carbon, enquanto o Fable permanece em $1,60 sob as tarifas listadas.
- Para leituras em cache: Carbon é mais barato durante a introdução, com $0,10 versus $0,20 por milhão de tokens. Ambos ficam listados em $0,20 depois. Escritas em cache, ferramentas e novas tentativas podem alterar a fatura final.
Preços oficiais da API
A agenda de preços padrão do Google (https://aistudio.google.com/docs/pricing) aplica tarifas introdutórias do Carbon até 30 de novembro de 2026. O preço do Fable da Anthropic separa leituras de cache de escritas de cache (https://platform.claude.com/docs/en/models/fable-5-2/overview). Todos os valores abaixo são USD por milhão de tokens.
Carbon suporta caching implícito em vez de criação explícita de cache. O preço baixo de leitura de cache do Fable aplica-se a leituras bem-sucedidas; escritas iniciais e reescritas posteriores têm suas próprias tarifas. Use os tokens de leitura de cache relatados em seus dados de uso para calcular economias.
Ambos os provedores oferecem preços de entrada/saída em lote pela metade de suas tarifas padrão. A Anthropic também oferece Fast mode a $16 de entrada e $80 de saída por milhão de tokens (https://www.anthropic.com/claude-fable-and-mythos-5-2) para até 2,5 vezes velocidade maior de geração de tokens.
Exemplo de custo para revisão de repositório
Suponha que um pedido de revisão de repositório use 100.000 tokens de entrada não em cache e 20.000 tokens de saída faturável, incluindo qualquer raciocínio faturável. Este exemplo se encaixa no orçamento geral de tokens do Carbon e ilustra apenas as cobranças de tokens.
| Agenda de cobrança | Carbon | Fable 5.2 |
|---|---|---|
| Tarifas oficiais até 30 de novembro de 2026 | $0,40 | $1,60 |
| Tarifas oficiais a partir de 1º de dezembro de 2026 | $0,80 | $1,60 |
Na tarifa introdutória do Carbon, a entrada custa $0,20 e a saída custa $0,20. Após a promoção, esses componentes tornam-se $0,40 cada. Os componentes do Fable são $0,80 cada. Adicione escritas em cache, ferramentas e novas tentativas para estimar sua fatura completa da API; acompanhe separadamente o tempo de revisão humana.
Preços do CometAPI
CometAPI atualmente oferece Gemini 4 Carbon (https://www.cometapi.com/models/google/gemini-4-carbon/) e Claude Fable 5.2 (https://www.cometapi.com/models/anthropic/claude-fable-5-2/) a 80% das tarifas oficiais correspondentes — uma economia de 20% para o grupo padrão exibido. Por exemplo, as tarifas oficiais de entrada/saída do Carbon de $2/$10 tornam-se $1,60/$8, enquanto as tarifas do Fable de $8/$40 tornam-se $6,40/$32. Os preços do CometAPI podem mudar quando os preços oficiais mudarem, então verifique as tarifas atuais da sua conta antes de enviar uma carga grande, especialmente após o fim da oferta introdutória do Carbon. O grupo da sua conta determina o desconto que você recebe.
| Categoria de cobrança | API do Gemini 4 Carbon | API do Claude Fable 5.2 |
|---|---|---|
| Entrada por 1M tokens |
Use acertos de cache reais, raciocínio faturável e quaisquer ferramentas cobradas separadamente ao reconciliar uma fatura. Verifique novamente as tarifas ao vivo da sua conta quando o período introdutório do Carbon terminar.
Nessas tarifas do CometAPI, o mesmo pedido de 100.000 de entrada e 20.000 de saída custa $0,32 com Carbon e $1,28 com Fable. Carbon economiza $0,96, ou 75%, neste exemplo de tokens fixos. Ambos os totais estão 20% abaixo dos totais oficiais atuais correspondentes. Para um fluxo real, compare também quantos tokens de raciocínio e novas tentativas cada modelo precisa para produzir uma resposta que você possa usar.
Comparação de tarefas do mundo real: Gemini 4 Carbon vs Claude Fable 5.2
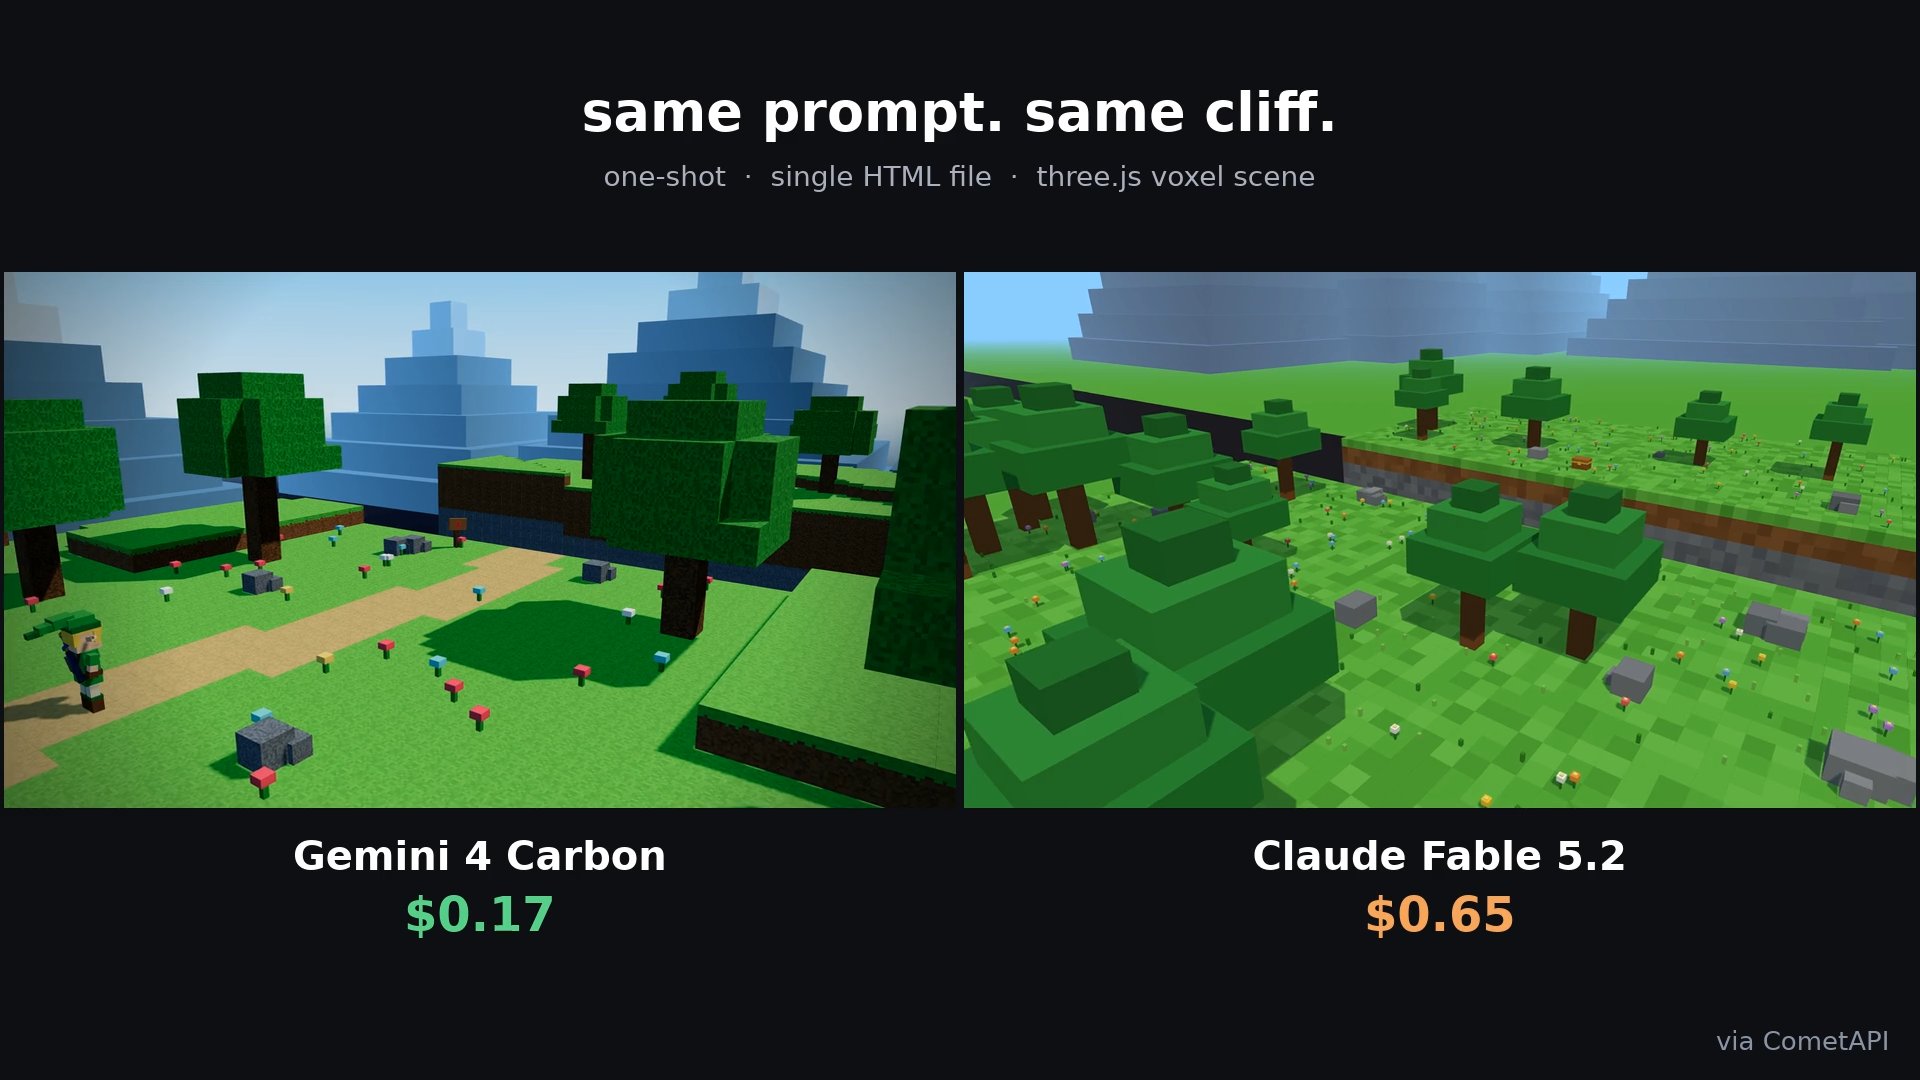
Por curiosidade, eu também dei a ambos os modelos o mesmo prompt para criar uma página HTML em pixel art, com o mesmo layout, interação e requisitos de navegador. Os resultados diferiram significativamente; o vídeo abaixo ilustra a expressividade visual e o custo de cada um.
()
Pessoalmente, eu escolheria Gemini 4 Carbon. Você também pode testar ambos os modelos usando o CometAPI — talvez chegue a uma conclusão diferente da minha. Escolha o Carbon se ambos os resultados atenderem aos seus requisitos e seu custo total for menor; escolha o Fable se um resultado melhor ou uma entrega mais rápida valerem a diferença.
Limitações de Gemini 4 Carbon e Claude Fable 5.2
Gemini 4 Carbon
- O raciocínio usa o mesmo orçamento de contexto que seu prompt e resposta. Entrada, raciocínio e saída compartilham a janela de 1.048.576 tokens, então uma entrada muito grande deixa menos espaço para raciocínio e geração.
- Raciocínio mais profundo pode custar mais e levar mais tempo. Tokens de raciocínio contribuem para a cobrança de saída. Comece com a configuração padrão Medium e aumente o esforço quando isso melhorar o resultado o suficiente para justificar o custo extra e a espera.
- Saída longa precisa do fluxo correto. Gerar além de uma resposta normal requer um fluxo de continuação de decodificação longa suportado (https://aistudio.google.com/docs/long-decode), usando execução em segundo plano ou continuação no cliente.
- Verifique o suporte a mídia na rota do CometAPI escolhida. Os recursos nativos de áudio e vídeo do Carbon são úteis apenas se a interface que você chama aceitar essas entradas e expor os controles que sua tarefa precisa.
Claude Fable 5.2
- O raciocínio adaptativo não pode ser desligado. Você pode ajustar o esforço para influenciar a profundidade do raciocínio, mas não pode colocar o modelo em modo sem raciocínio.
- Uma janela de contexto de 1M não significa uma resposta de 1M tokens. A saída máxima é de 128K tokens. Planeje entregáveis grandes em seções quando excederem esse limite de resposta.
- O esforço padrão da API é High. Isso pode servir ao trabalho técnico difícil, mas um esforço mais baixo suportado pode ser melhor quando você precisa de uma resposta mais rápida.
- Algumas escolhas forçadas de ferramentas são incompatíveis. A API nativa retorna erro 400 para tipos tool_choice any ou tool. Verifique os parâmetros de solicitação suportados antes de reutilizar uma configuração de outro modelo.
- As entradas são limitadas a texto e imagens. Áudio e vídeo precisam ser transcritos ou convertidos em entradas adequadas antes que o Fable possa trabalhar com eles. Veja a especificação oficial do modelo () para os limites atuais.
Qual modelo você deve escolher para seu fluxo de trabalho?
Comece com o modelo menos caro que possa atender à sua meta de qualidade. Pague o prêmio do Fable quando seus resultados ou velocidade fizerem uma diferença significativa no trabalho:
- Depuração ou migração em todo o repositório: comece com o Fable 5.2 para mudanças difíceis onde um patch inicial mais forte pode economizar tempo substancial de reparo. Para edições rotineiras, tente primeiro o Carbon e compare o custo de chegar a um patch testado e revisado.
- Análise de áudio ou vídeo: comece com o Carbon pela entrada nativa de mídia e preços padrão mais baixos de tokens. Confirme que a rota escolhida aceita os arquivos de que você precisa e que o resultado captura as evidências relevantes.
- Automação empresarial repetida: comece com o Carbon e verifique a precisão de extração e as ações concluídas em casos representativos. Se ele atender à sua meta de qualidade, suas tarifas mais baixas o tornam a opção natural para testar em escala. Use o Fable quando ele reduzir demonstravelmente erros ou retrabalho caros.
- Análise científica: comece com o Fable 5.2 para raciocínio difícil, depois compare o Carbon no mesmo problema. Verifique cálculos, derivações e evidências citadas. Mantenha o Fable quando a melhoria de qualidade justificar o custo extra; use o Carbon quando ambos produzirem um resultado igualmente utilizável a um custo total menor.
Se ambos os modelos atenderem à sua meta de qualidade e prazo, escolha o Carbon quando ele entregar menor custo total por tarefa. Escolha o Fable quando a conclusão mais rápida ou menos correções valham mais do que o gasto extra da API. Sua escolha pode variar por tarefa: Carbon pode lidar com trabalho rotineiro em segundo plano enquanto Fable trata os casos difíceis. Meça essas economias em sua própria carga de trabalho antes de ampliar o uso.
Onde você pode acessar Gemini 4 Carbon e Claude Fable 5.2?
Acesso oficial do provedor
Gemini 4 Carbon: para uso direto, o rollout do Google (https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/) inclui o app Gemini, Google Antigravity e Modo de IA na Busca para assinantes do Google AI Ultra. Desenvolvedores podem usar o Google AI Studio e a Gemini API; acesso empresarial também está disponível pela própria oferta corporativa do Google. A disponibilidade depende do país, da conta e do rollout em cada produto.
Nos EUA, o Google AI Ultra (https://one.google.com/about/google-ai-plans/) atualmente mostra $99,99 por mês para seu nível 5x. Este é um nível de uso por assinatura, não uma franquia fixa de tokens da API do Carbon. Carbon não tem nível gratuito de API (https://aistudio.google.com/docs/pricing#gemini-4-carbon): tarifas padrão de entrada/saída são $2/$10 por milhão de tokens até 30 de novembro e $4/$20 a partir de 1º de dezembro de 2026. As cotas de solicitações e tokens da API variam por projeto e nível de cobrança; verifique seus limites ativos no Google AI Studio (https://aistudio.google.com/docs/rate-limits).
Claude Fable 5.2: use o app Claude para conversas diretas, Claude Code para fluxos de trabalho de codificação suportados, ou a Claude API para uma aplicação que você constrói. A página de assinatura dos EUA (https://claude.com/pricing) lista Pro a $20 por mês, Max a $100 e Ultra a $200, antes de impostos. Free não inclui Fable. Pro normalmente paga pelo Fable via créditos de uso; Max e Ultra incluem Fable dentro de até metade de sua franquia semanal. Conversas longas, arquivos grandes e raciocínio mais pesado consomem essa franquia mais rapidamente.
Para planos Pro elegíveis e assentos Team padrão, a oferta de lançamento (https://support.claude.com/en/articles/17506494-claude-fable-5-2-launch-offers) inclui temporariamente o Fable dentro de até 50% do uso semanal até 16 de novembro de 2026, às 23h59 PT. Depois, esses planos retornam à cobrança por créditos de uso para o Fable. A cobrança da API permanece separada nas tarifas listadas de $8/$40 por milhão de tokens de entrada/saída, sujeita à tarifa e aos limites de gastos da sua conta. O acesso por assinatura não deve ser tratado como uso ilimitado da API.
Acesso via CometAPI: altamente recomendado
CometAPI fornece um ambiente de API unificado para diferentes famílias de modelos. Desenvolvedores podem comparar modelos sem construir integrações separadas do provedor para cada teste.
CometAPI oferece acesso à API no modelo pay-as-you-go sem assinatura mensal comparado ao Fornecedor Oficial, reduzindo a dificuldade de acesso. Você usa uma conta CometAPI e uma chave de API em vez de uma franquia de assinatura de consumidor oficial; o uso é cobrado pelo CometAPI. Isso mantém o acesso à API separado das franquias semanais de mensagens descritas acima. Seu saldo disponível, rotas suportadas e limites de serviço ainda se aplicam. Veja a visão geral de acesso e cobrança do CometAPI (https://www.cometapi.com/).
Os preços mostrados nesta comparação estão 20% abaixo das tarifas oficiais correspondentes: $1,60/$8 por milhão de tokens de entrada/saída para Carbon e $6,40/$32 para Fable. Seu desconto real depende do grupo da sua conta, e os preços podem mudar quando os preços oficiais mudarem. Verifique a tarifa ao vivo de cada modelo antes de enviar uma carga grande.
Crie uma conta no CometAPI e gere uma chave de API no painel. Armazene a chave em uma variável de ambiente em vez de fixá-la no código-fonte de produção.
FAQ
Gemini 4 Carbon é melhor que Claude Fable 5.2?
Gemini 4 Carbon é o melhor ponto de partida se você precisa de entrada nativa de áudio ou vídeo, preços padrão mais baixos de tokens ou automação empresarial consciente de custos. Claude Fable 5.2 é o candidato mais forte para as tarefas difíceis de codificação e pesquisa científica cobertas pelos benchmarks selecionados. O preço mais baixo do Carbon não o torna automaticamente a maneira mais barata de terminar todo trabalho: uma tarefa que precisa de correções repetidas pode custar mais no total. Compare ambos os modelos em algumas tarefas representativas, depois escolha aquele que produz um resultado aceitável no tempo e custo que seu fluxo de trabalho pode suportar.
Qual modelo é melhor para codificação, Gemini 4 Carbon ou Claude Fable 5.2?
Comece com Claude Fable 5.2 para mudanças complexas de repositório, depuração em vários arquivos e investigação técnica exigente. Ele marca 69,9% na comparação publicada FrontierSWE v2 versus 61,2% do Carbon, uma liderança de 8,7 pontos percentuais. Isso o torna uma escolha inicial útil, não uma garantia de que todo patch estará correto. Carbon vale o teste quando suas tarefas de codificação são frequentes e o custo de tokens importa. Dê a ambos o mesmo contexto de repositório, execute os testes propostos e compare o patch finalizado, o número de tentativas de reparo e o tempo que você gasta revisando.
Claude Fable 5.2 é mais caro que Gemini 4 Carbon?
Sim, com volumes iguais de entrada não em cache e saída faturável, as tarifas padrão da API do Fable são mais altas. Seus $8 de entrada e $40 de saída por milhão de tokens são quatro vezes as tarifas introdutórias de $2/$10 do Carbon e duas vezes as tarifas programadas de $4/$20 do Carbon a partir de 1º de dezembro de 2026. Uma solicitação usando 100.000 tokens de entrada e 20.000 tokens de saída faturável, portanto, custa $1,60 com Fable, comparado a $0,40 com Carbon durante a oferta ou $0,80 depois. Cache, comprimento do raciocínio, ferramentas e novas tentativas podem mudar a fatura real da tarefa, então use essas cifras como uma comparação de tokens fixos.
Uma chamada de chat padrão pode usar automaticamente o long decode do Carbon?
Uma chamada de chat padrão não habilita automaticamente o long decode. O fluxo de decodificação longa do Google (long-decode) usa execução em segundo plano ou continuação no cliente (https://aistudio.google.com/docs/long-decode) na Interactions API. Antes de solicitar uma resposta longa por meio de um gateway, verifique se essa rota expõe o mecanismo necessário e como ela relata a conclusão. Se não expuser, use uma rota nativa suportada ou divida o trabalho em seções verificáveis de forma independente.
Se sua integração expõe apenas uma solicitação padrão de chat-completions, não presuma que aumentar um limite de saída ativará o fluxo de continuação nativo. Confirme que a rota suporta continuação e que sua aplicação lida com respostas incompletas. Para um relatório longo ou entrega de código, gerar e verificar uma seção por vez também pode tornar o progresso mais fácil de revisar.
Claude Fable 5.2 suporta raciocínio adaptativo?
Sim. Fable 5.2 usa raciocínio adaptativo, e ele permanece habilitado em toda solicitação. Você controla a profundidade do raciocínio por meio da configuração de esforço em vez de um interruptor liga/desliga; o esforço padrão da API é High. Para uma mudança de código difícil ou uma pergunta de pesquisa em múltiplas etapas, esse raciocínio mais profundo pode ser útil. Para uma tarefa mais simples, tente um esforço mais baixo suportado e verifique se a resposta ainda atende às suas necessidades. Acompanhe tanto o tempo de espera quanto o uso faturado ao comparar configurações. Uma resposta visível mais curta não significa necessariamente que o modelo usou pouco raciocínio para produzi-la.
Posso acessar ambos os modelos pelo CometAPI?
Sim. CometAPI dá acesso a ambos os IDs de modelo, gemini-4-carbon e claude-fable-5-2, por meio de um formato de solicitação de texto compartilhado. Crie uma conta, gere uma chave de API e envie uma lista de mensagens com o modelo que deseja usar. Isso permite testar o mesmo prompt em ambos sem construir integrações separadas para uma comparação básica de texto. Antes de usar áudio, vídeo, saída longa ou opções avançadas de raciocínio, verifique quais parâmetros a rota selecionada suporta. Confirme também os preços ao vivo do seu grupo de conta e o saldo disponível, já que o desconto padrão exibido pode diferir da tarifa aplicada à sua conta.
Qual modelo é mais rápido para tarefas de codificação agentic?
Fable é a opção mais rápida no snapshot de alto esforço mostrado acima: o tempo por tarefa medida é de 16,7 minutos versus 25,7 do Carbon, cerca de 35% menos tempo. Ele também atinge o primeiro token de resposta mais cedo e produz 98 tokens por segundo versus 80 do Carbon. Essas cifras fornecem uma expectativa inicial útil, mas as métricas de carga de trabalho não são uma cronometragem controlada das tarefas de codificação do seu repositório. Para um fluxo de codificação agentic, meça o tempo até um patch aprovado e revisado, incluindo chamadas de ferramentas, testes, novas tentativas e correções manuais. Carbon ainda pode ser atraente quando menor custo importa mais do que terminar mais cedo.
Conclusão
Gemini 4 Carbon é o ponto de partida mais forte para trabalho consciente de custos, entrada nativa de áudio ou vídeo e automação recorrente. Claude Fable 5.2 vale o preço mais alto quando seus resultados técnicos mais fortes ou conclusão mais rápida economizam tempo e retrabalho suficientes para compensar o prêmio. Se ambos atenderem à sua meta de qualidade e prazo, escolha aquele que custa menos para entregar o resultado final. Compare tarefas representativas pelo CometAPI ou pelas APIs oficiais, inclua novas tentativas e esforço de revisão e confira os preços novamente após o término da oferta introdutória do Carbon.