

TL;DR
O nível gratuito do Gemini API está disponível em outubro de 2026 para modelos selecionados, incluindo Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite e Gemini 3.1 Flash-Lite. Você pode começar sem configurar faturamento, mas a cota disponível para o seu projeto determina quanto você pode realmente executar.
Comece com o Gemini 3.8 Flash para experimentos exigentes de programação e raciocínio, ou com um modelo Flash-Lite para extração e classificação rotineiras. Antes de usar dados reais de clientes, verifique os termos de dados aplicáveis. Se precisar de capacidade paga, compare as tarifas nativas do Google com o acesso faturado separadamente do CometAPI.
Key Takeaways
- O Gemini 3.8 Flash é a opção Flash mais recente abordada aqui, com entrada multimodal e esforço de raciocínio ajustável.
- O Gemini 3.6 Flash permanece como opção suportada para integrações existentes; Gemini 3.5 Flash-Lite e Gemini 3.1 Flash-Lite visam cargas de trabalho mais leves.
- Gemini 4 Argon requer acesso pago à API. A disponibilidade gratuita em outro produto Google não estabelece elegibilidade gratuita pela API.
- Verifique as cotas no AI Studio. A janela de contexto de um modelo é diferente da sua permissão de requisições e de tokens no projeto.
- Compare as rotas de acesso. A cota gratuita do Google e os preços, créditos e limites de conta do CometAPI são separados.
Is the Gemini API Free in 2026?
O Google oferece tokens de entrada e saída gratuitos para modelos selecionados do Gemini API, sujeitos a cotas em nível de projeto. Você pode começar sem habilitar faturamento. Este é um nível gratuito baseado em cotas, e não um crédito promocional único.
A distinção importante é que o Google AI Studio, o Gemini API e as assinaturas de consumo do Gemini são experiências de acesso separadas. Um modelo disponível em uma interface não está necessariamente disponível gratuitamente por outra.
Which Gemini API Models Are Free in October 2026?
Os quatro modelos abaixo são pontos de partida úteis para aplicações de texto e multimodais. Eles não são uma lista exaustiva de todos os endpoints elegíveis gratuitamente. Siga os links dos modelos para explorar o acesso via CometAPI; as especificações do Google estão vinculadas abaixo da tabela.
Todos os quatro aceitam entrada de texto, imagem, vídeo, áudio e PDF e produzem texto. Seu limite de entrada publicado é de 1.048.576 tokens, com até 65.536 tokens de saída. Esses limites de modelo não garantem que seu projeto gratuito possa enviar uma requisição desse tamanho.
Audio, Embeddings and Image Generation: Access and Limits
O Google também lista acesso gratuito para modelos especializados selecionados, como Gemini 3.8 Live, Gemini 3.8 Flash TTS e Gemini Embedding 2. Verifique a entrada de preços para o modelo e endpoint exatos antes de integrar: entender uma imagem ou clipe de áudio é uma capacidade diferente de gerar uma imagem ou uma resposta de voz.
Os métodos da API, formatos de requisição e limites variam por capacidade. Consulte a documentação do modelo e da operação específicos que você planeja usar.
O acesso gratuito não se estende a todos os modelos Gemini ou endpoints de geração. O Gemini 4 Argon requer acesso pago ao Gemini API, enquanto endpoints premium de geração de imagem e vídeo têm suas próprias regras de elegibilidade. Antes de integrar um recurso, verifique o modelo e a operação exatos em vez de presumir que compartilham a mesma permissão gratuita.
How Does Gemini 3.8 Flash Perform?
A avaliação publicada pelo Google compara o Gemini 3.8 Flash com o Gemini 3.7 Flash e outros modelos. Ela relata 73.7% no DeepSWE v1.1, em comparação com 65.3% para o 3.7 Flash — um aumento de 8.4 pontos percentuais. No HLE-Verified, a pontuação relatada sobe de 53.6% para 54.9%.
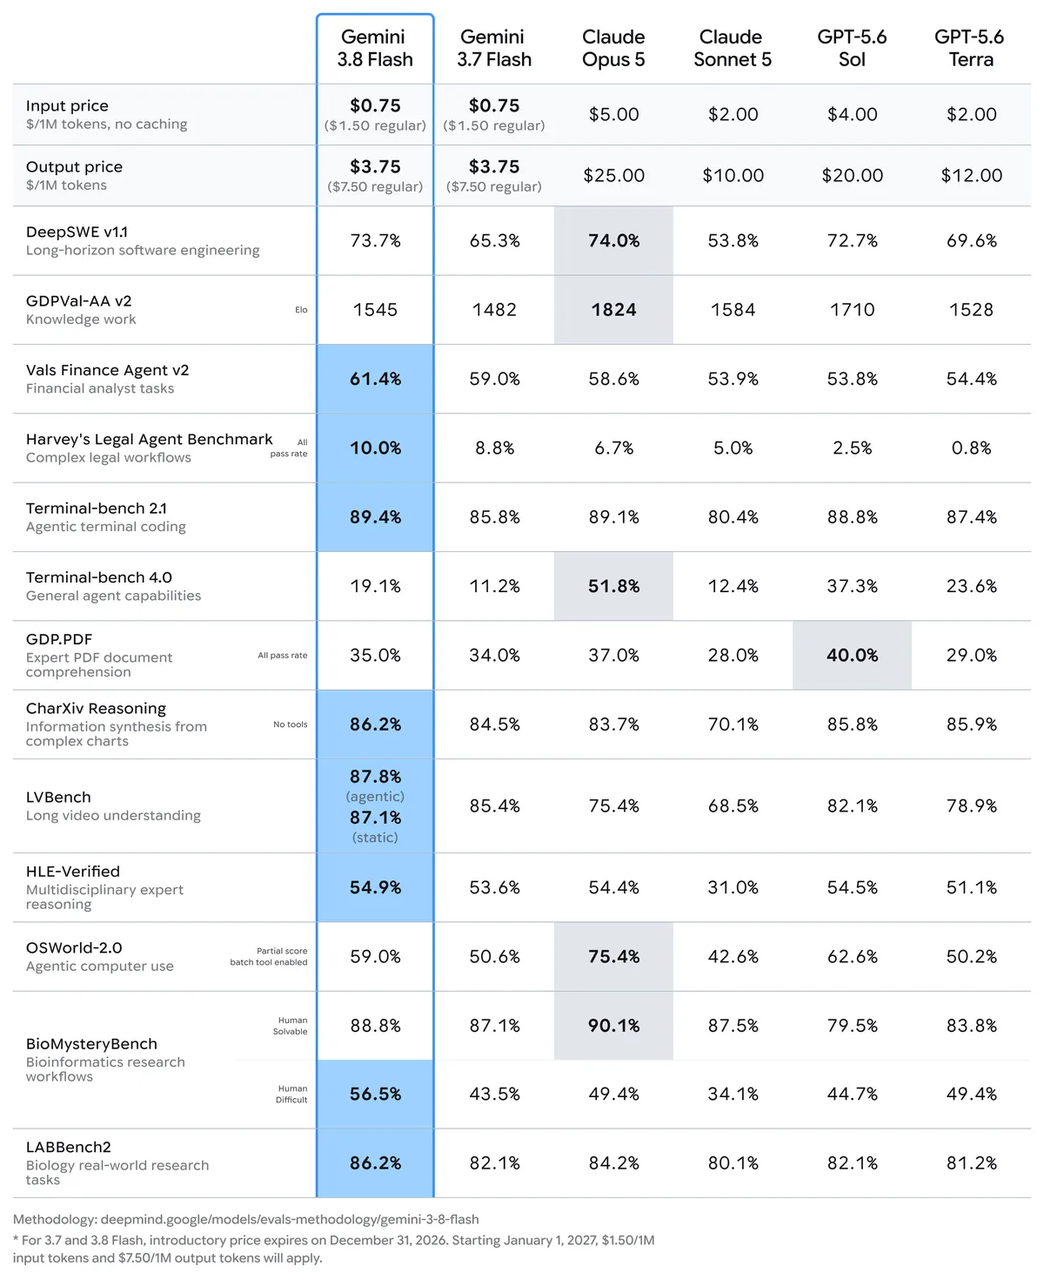
Use esses resultados para escolher um modelo para teste e, em seguida, avalie-o com exemplos da sua própria aplicação. Para um extrator de documentos, campos corretos e formatação de saída estável podem importar mais do que um benchmark de codificação. Para um assistente de codificação, meça se a alteração proposta funciona, quanto tempo leva e quantos tokens consome.
What Are the Gemini API Free Tier Rate Limits in 2026?
O maior equívoco sobre o nível gratuito do Gemini é que todas as contas recebem o mesmo número fixo de requisições.
Abra o Google AI Studio, escolha o projeto por trás da sua chave de API e revise os limites ativos para o modelo selecionado. O guia de limites de taxa do Google explica as dimensões de cota; o painel mostra a permissão aplicável à sua conta.
- RPM (requests per minute): Limita quantas requisições você pode enviar por minuto. Atenção a rajadas curtas e a workers paralelos que enviam muitas requisições de uma vez.
- TPM (input tokens per minute): Limita o volume de tokens de entrada que você pode enviar por minuto. Prompts grandes, históricos de conversa e documentos usam essa permissão mesmo quando a contagem de requisições é baixa.
- RPD (requests per day): Limita seu total diário de requisições. Planeje sua carga de trabalho em torno da permissão diária e do horário de redefinição.
Um limite de entrada de um milhão de tokens descreve o tamanho máximo de entrada suportado pelo modelo. Isso não garante que um projeto no nível gratuito tenha capacidade de TPM suficiente para enviar um milhão de tokens em uma única requisição. Capacidade de contexto e capacidade de limite de taxa devem ser avaliadas separadamente.
As cotas diárias de requisições são redefinidas à meia-noite no horário do Pacífico. Múltiplas chaves em um projeto compartilham seus limites de uso, portanto criar outra chave não adiciona capacidade. Outros limites podem se aplicar a modelos ou operações especializados.
Handle Gemini API 429 Errors
Leia o corpo do erro antes de tentar novamente. No Interactions API atual, um 429 pode distinguir um limite de requisições ou tokens de curto prazo de uma cota diária esgotada. Para um limite de curto prazo, reduza a fila e use backoff exponencial com jitter. Para exaustão diária, aguarde a redefinição ou altere o plano de capacidade da aplicação. Um 503 sinaliza indisponibilidade temporária do serviço. Consulte a referência de erros da API do Google.
How Do Google and CometAPI Prices Compare?
When Gemini API Billing Begins
Consumir sua cota gratuita não muda automaticamente seu projeto para uso pago. Sem uma conta de faturamento ativa, requisições que excedem a permissão gratuita disponível encontram restrições de acesso ou capacidade, em vez de cobranças Standard por tokens.
Para usar capacidade paga, você precisa vincular o faturamento. Se sua conta estiver em um plano pré-pago, você também deve adicionar créditos, a partir de US$ 5 ou o equivalente local. Verifique o plano atribuído e os controles de gasto no AI Studio antes de atualizar. Saldos e contabilização de uso podem atualizar com atraso, portanto um saldo pré-pago exibido não é um corte de gasto instantâneo.
O crédito de boas-vindas de US$ 300 do Google Cloud é separado do nível gratuito do Gemini API. Contas abertas após 2 de março de 2026 não podem usar esse crédito para cobranças do Gemini API ou do AI Studio. Revise o guia de faturamento para as regras aplicáveis à sua conta.
Google and CometAPI Token Prices
A tabela compara o preço de tokens Standard do Google com as tarifas publicadas do CometAPI verificadas em 26 de outubro de 2026. Todos os valores são em USD por um milhão de tokens; a saída inclui raciocínio faturável quando aplicável. A entrada e a saída gratuitas do Google se aplicam apenas a requisições elegíveis dentro da permissão do projeto.
Os preços introdutórios do Google para Flash acima terminam em 31 de dezembro de 2026; 3.8 Flash e 3.6 Flash passam então para US$ 1.50 de entrada e US$ 7.50 de saída. O preço introdutório do Argon termina em 30 de novembro de 2026, após o qual passa a US$ 4 de entrada e US$ 20 de saída. As tarifas do CometAPI devem ser verificadas independentemente quando essas promoções mudarem. Ferramentas, caching, armazenamento, impostos e outros serviços podem adicionar cobranças.
A Small Workload Example
Suponha que você envie 1.000 requisições de texto, cada uma com 2.000 tokens de entrada e 500 tokens de saída. Isso resulta em dois milhões de tokens de entrada e meio milhão de tokens de saída. Nas tarifas acima, o Gemini 3.8 Flash custa US$ 3.375 pelo Google, ou cerca de US$ 3.38, e US$ 2.70 pelo CometAPI. Uma carga de trabalho elegível ao nível gratuito do Google custa US$ 0 apenas se couber nas cotas disponíveis. Estes são estimativas de custo por token, não faturas medidas.
How Can You Start Using the Gemini API Free Tier?
Você precisa de uma conta Google e região elegíveis, uma chave de API e Python com pip disponível. O exemplo abaixo segue o guia de início atual do Google e usa o Interactions API.
Create a Key and Install the SDK
No Google AI Studio, copie ou crie uma chave de API para um projeto que não tenha habilitado faturamento pago. Instale o SDK e, em seguida, defina a chave no ambiente do seu terminal. Mantenha a chave no servidor em vez de incorporá-la no código do navegador.
pip install -U google-genai
No macOS ou Linux:
export GEMINI_API_KEY="your_api_key"
No Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Send a Request and Check the Result
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explique bancos de dados vetoriais em 100 palavras."
)
print(interaction.output_text)
Salve isto como um arquivo Python e execute a partir do mesmo ambiente. Uma requisição bem-sucedida imprime uma explicação curta. Em seguida, verifique o painel de uso do AI Studio para confirmar o projeto e o modelo que estão recebendo o tráfego. Se falhar, inspecione o código de erro e verifique a chave, o acesso ao modelo, a cota e o estado de faturamento antes de alterar o código.
How Can Developers Access Gemini API Models Through CometAPI?
O CometAPI fornece uma rota de acesso separada para modelos Gemini suportados e outros provedores de IA.
Escolha essa rota quando uma interface compartilhada entre provedores simplificar sua aplicação. Use uma chave do CometAPI com seu endpoint e, em seguida, verifique o ID do modelo suportado e os limites da conta. A cota gratuita do Google não se transfere para esse serviço. O exemplo a seguir usa a interface compatível com OpenAI documentada pelo CometAPI.
pip install -U openai
Defina COMETAPI_KEY no seu ambiente usando o mesmo método específico do shell mostrado acima e, em seguida, execute:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Resuma os benefícios de RAG."
    }]
)
print(response.choices[0].message.content)
Antes da implantação, confirme que o ID de modelo pretendido é suportado pela sua conta do CometAPI. Identificadores nativos do Google e aliases específicos de provedor não têm correspondência garantida para todos os modelos.
What Privacy Restrictions Apply to the Gemini API Free Tier?
Nos Termos Adicionais de Serviço do Gemini API do Google, prompts e saídas de serviços não pagos podem ser usados para melhorar produtos do Google, e avaliadores humanos podem examiná-los. Não envie informações sensíveis, confidenciais ou pessoais para serviços não pagos. Serviços pagos de API possuem termos de uso de dados diferentes.
Regras regionais importam: disposições de uso de dados de serviços pagos se aplicam a determinados usos não pagos no EEE, Suíça e Reino Unido, mas disponibilizar um cliente de API para usuários nessas regiões requer Paid Services. Essas são condições separadas. Verifique os termos atuais para seus usuários e implantação antes do lançamento.
How Can You Optimize Gemini API Free Tier Usage?
Construa em torno da cota que você mediu. Mantenha um pequeno conjunto de tarefas representativas e registre sucesso da tarefa, latência, tokens de entrada e saída e tentativas. Em seguida, altere uma parte da carga de trabalho por vez:
- Roteie por dificuldade. Teste o Flash-Lite em extrações rotineiras e use um modelo maior apenas onde ele melhora o resultado.
- Apare a entrada. Envie a seção relevante do documento e o histórico de conversa necessário em vez de reenviar tudo repetidamente.
- Controle a geração. Solicite um comprimento de saída útil e ajuste o esforço de raciocínio apenas onde o modelo e a API o suportam.
- Reutilize o trabalho. Armazene resultados repetidos da aplicação e verifique a elegibilidade de caching por modelo antes de presumir que o caching da API é gratuito.
- Orce a concorrência. Mantenha os workers atrás de uma fila compartilhada para que tarefas independentes não criem uma rajada evitável.
Por fim, monitore qualidade tanto quanto consumo. Um modelo mais barato que falha frequentemente ou exige várias tentativas pode criar mais trabalho do que um modelo um pouco mais caro que acerta na primeira.
Uma métrica interna útil de avaliação é:
Custo efetivo por tarefa bem-sucedida = Custo total de inferência / Número de tarefas bem-sucedidas
Para experimentação no nível gratuito, uma métrica operacional adicional é tarefas bem-sucedidas por janela de cota disponível.
FAQ
Como posso saber se um problema de cota é causado por rajadas de requisições ou por documentos grandes?
Compare os timestamps das falhas com a contagem de requisições e o volume de tokens de entrada. Uma rajada de prompts curtos aponta para frequência de requisições; alguns documentos longos podem esgotar a capacidade de tokens mesmo com RPM baixo. No Interactions API, inspecione o código de erro legível por máquina e distinga esgotamento de cota diária de um limite de curto prazo. Registre uso de tokens e concorrência dos workers juntos para poder alterar a parte relevante da fila.
O que devo fazer se uma requisição expirar (timeout) após o envio?
Um timeout nem sempre informa se uma operação remota foi concluída. Para uma interação da qual você tem um ID, verifique seu estado antes de iniciar outra tarefa dispendiosa. Coloque um ID de tarefa em nível de aplicação em seu fluxo de trabalho e deduplicate ações downstream, especialmente e-mails, gravações em banco de dados e chamadas de ferramenta. Uma nova tentativa de geração de texto não deve repetir silenciosamente uma ação de negócio. A documentação de Interactions do Google descreve recuperação de interações e estados de execução.
Como devo comparar Flash e Flash-Lite para extração de documentos?
Use os mesmos documentos, campos exigidos e regras de aceitação para ambos os modelos. Inclua digitalizações ruidosas, campos ausentes e valores ambíguos. Meça a precisão factual dos campos e a validade da saída, depois conte tentativas e correções manuais. Um modelo que produz menos tokens ainda pode consumir mais esforço se seus erros exigirem outra requisição. Mantenha um conjunto de documentos reservado para que mudanças de prompt não sejam julgadas apenas com exemplos que você já ajustou.
O que devo verificar antes de migrar uma aplicação do Google para o CometAPI?
Teste o endpoint exato, o ID do modelo, o formato de mensagem e os recursos que sua aplicação usa. Uma requisição compatível de chat-completions não estabelece suporte idêntico para arquivos, ferramentas, caching ou configurações de raciocínio. Compare campos de uso retornados e tratamento de erros, além da resposta de texto, e revise as políticas de dados do intermediário e do provedor upstream. Comece com uma pequena carga de trabalho não sensível antes de mover o restante do tráfego.
Como manter uma integração estável conforme modelos e preços mudam?
Mantenha IDs de modelo, configurações de endpoint e premissas de preço em configuração. Registre o modelo e a data com resultados de avaliação, monitore avisos de descontinuação e reexecute tarefas representativas antes de mudar um modelo. Defina alertas de orçamento e revise tarifas promocionais antes de seus prazos. Mantenha um fallback testado para cargas essenciais em vez de presumir que uma cota gratuita ou um determinado alias de modelo permanecerá disponível indefinidamente.
Conclusion
O nível gratuito do Gemini API é uma forma útil de validar uma aplicação antes de pagar por capacidade. Escolha um modelo para a tarefa, meça a cota disponível para seu projeto e verifique os termos de dados antes de usar entradas de produção.
Para um primeiro experimento, faça uma pequena requisição e confirme-a no AI Studio. Em seguida, meça uma carga de trabalho representativa. Se a capacidade gratuita se tornar o limitador, compare a API paga do Google com o CometAPI usando os mesmos prompts, requisitos de qualidade e custos completos de tokens.