Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
GLM-5.3 Flash vs GLM-5.3: qual modelo da Z.ai deve usar?
Compare o GLM-5.3 Flash com o GLM-5.3 em termos de especificações, arquitetura, benchmarks de programação, multimodalidade, velocidade, preços, acesso à API e casos de uso.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
GLM-5.3 Flash é a melhor opção padrão para a maioria das cargas de trabalho em produção: adiciona entrada visual nativa e uma janela de contexto de 1M de tokens, enquanto seu preço de tabela padrão é dramaticamente mais baixo. GLM-5.3 continua sendo a escolha mais forte quando profundidade máxima de codificação, raciocínio difícil de longo horizonte ou desempenho em cibersegurança importam mais do que o custo unitário.
Não se trata de uma história de modelo pequeno versus modelo grande. Flash é um MoE de 320B no total/18B ativos treinado a partir de uma nova base multimodal com atenção híbrida esparsa e linear. O carro-chefe é um cujos ganhos do GLM-5.3 vêm de pós-treinamento em escala sobre a base do GLM-5.2.
Escolha o Flash para codificação multimodal, compreensão de documentos, agentes de navegador ou GUI, automação em alto volume e aplicações sensíveis a custo.
Escolha o carro-chefe para as tarefas de engenharia mais difíceis em escala de repositório, raciocínio mais profundo assistido por ferramentas e pesquisa de segurança defensiva.
Ambos os modelos suportam contexto de 1M de tokens, raciocínio sempre ativo, chamadas de função, streaming e implantação com pesos abertos.
Em benchmarks equivalentes relatados pela Z.ai, o carro-chefe lidera DeepSWE, NL2Repo, HLE with tools e Agents’ Last Exam; o Flash lidera AutomationBench, Toolathlon e GDPval-AA v2.
Testes independentes dão ao carro-chefe um Índice de Inteligência mais alto e saída mais rápida, enquanto o Flash tem um tempo até o primeiro token ligeiramente melhor e um custo composto muito menor.
GLM-5.3 Flash vs GLM-5.3 de relance
Dimensão
GLM-5.3 Flash
GLM-5.3
Resultado prático
Posicionamento
Modelo eficiente de codificação nativamente multimodal e de agentes
Carro-chefe em raciocínio em texto, codificação, agentes de longo horizonte, cibersegurança
A Z.ai posiciona o Flash como o primeiro modelo multimodal nativo da série GLM-5. Ele tem 320B de parâmetros totais e 18B ativos, mas “Flash” não deve ser entendido como “pequeno”. O checkpoint completo continua sendo um modelo muito grande; sua eficiência vem de ativar um subconjunto menor de especialistas e redesenhar a pilha de atenção.
Seu modelo base foi treinado em um corpus multimodal de 30 trilhões de tokens. A visão nativa é integrada ao ciclo de codificação, permitindo que o modelo inspecione capturas de tela, interfaces renderizadas, gráficos, layouts de página e outros feedbacks visuais antes de refinar sua próxima ação.
O modelo carro-chefe é otimizado para engenharia de software complexa, agentes de longo horizonte e cibersegurança. A Z.ai diz que usa a mesma base do GLM-5.2; a atualização vem do pós-treinamento em escala, e não de um novo pré-treinamento.
O repositório oficial lista o checkpoint com 744B de parâmetros totais e 40B ativos. Em comparação com o Flash, ele ativa mais que o dobro de parâmetros por token e aloca mais capacidade para raciocínio difícil e multiestágio.
Especificações do GLM-5.3
Especificação
GLM-5.3
Developer
Z.ai / Zhipu AI
Model ID
glm-5.3
Model type
Modelo carro-chefe de texto com Mixture-of-Experts
Total / active parameters
744B / 40B
Base model
Base do GLM-5.2; todos os ganhos do GLM-5.3 vêm do pós-treinamento
Input / output
Texto / texto
Context / max output
1M / 128K tokens
Reasoning
Sempre ativado; esforços baixo, alto, máximo
Tools
Chamadas de função, chamadas de ferramenta em streaming, cache de contexto, saída estruturada
Primary focus
Codificação complexa, agentes de longo horizonte, engenharia, cibersegurança
Weights / license
Pesos abertos sob a Licença GLM-5.3 separada; código do repositório de suporte sob Apache-2.0.
Fontes: documentação do carro-chefe da Z.ai e o repositório oficial GLM-5.
Arquitetura: por que o Flash é mais barato sem ser pequeno
O Flash alterna blocos de atenção linear com blocos de atenção esparsa e usa mHC em torno dos componentes de atenção e de MoE. Seu mecanismo IndexPool comprime quatro vetores de chaves do indexador em um. A Z.ai reporta 3,01× menos computação de atenção por camada e um cache KV 4,44× menor por camada do que o carro-chefe em um comprimento de sequência de 1M de tokens.
Essas são comparações no nível da arquitetura, não multiplicadores garantidos de latência ponta a ponta. A velocidade real da API também depende de hardware, quantização, batching, comprimento de raciocínio, software de serving e carga do provedor.
Arquitetura de atenção híbrida do GLM-5.3-Flash e comparação de computação/cache em contexto longo.
Fonte: documentação oficial de arquitetura da Z.ai
Desempenho em benchmarks: onde cada modelo vence
A comparação mais limpa separa benchmarks de tarefas reportados pelo fornecedor de medições independentes de API. Mesmo quando os nomes de benchmarks coincidem, versões dos harnesses, configurações de ferramentas, gestão de contexto e esforço de raciocínio podem diferir. A tabela abaixo usa os valores mais próximos na avaliação do carro-chefe e na avaliação do Flash, tratando pequenas lacunas como direcionais e não definitivas.
Benchmark
GLM-5.3 Flash
GLM-5.3
Pontuação mais alta
O que testa
Terminal-Bench 2.1
84.3
88.2
GLM-5.3
Codificação em terminal e baseada em agentes
DeepSWE v1.1
63.4
66.9
GLM-5.3
Engenharia de software
NL2Repo
56.3
58.0
GLM-5.3
Geração de repositório
Toolathlon Verified
78.4
73.0
Flash
Uso de ferramentas
AutomationBench
48.8
48.2
Empate/Flash
Automação de uso de computador
Agents’ Last Exam
26.3
28.5
GLM-5.3
Raciocínio de agente de longo horizonte
HLE with tools
55.3
62.5
GLM-5.3
Raciocínio difícil assistido por ferramentas
GDPval-AA v2
1773 Elo
1769 Elo
Empate/Flash
Trabalho profissional baseado em conhecimento
Fontes: avaliação do carro-chefe e avaliação do Flash. Compare de forma direcional porque as configurações de avaliação podem diferir.
Codificação e engenharia de repositórios
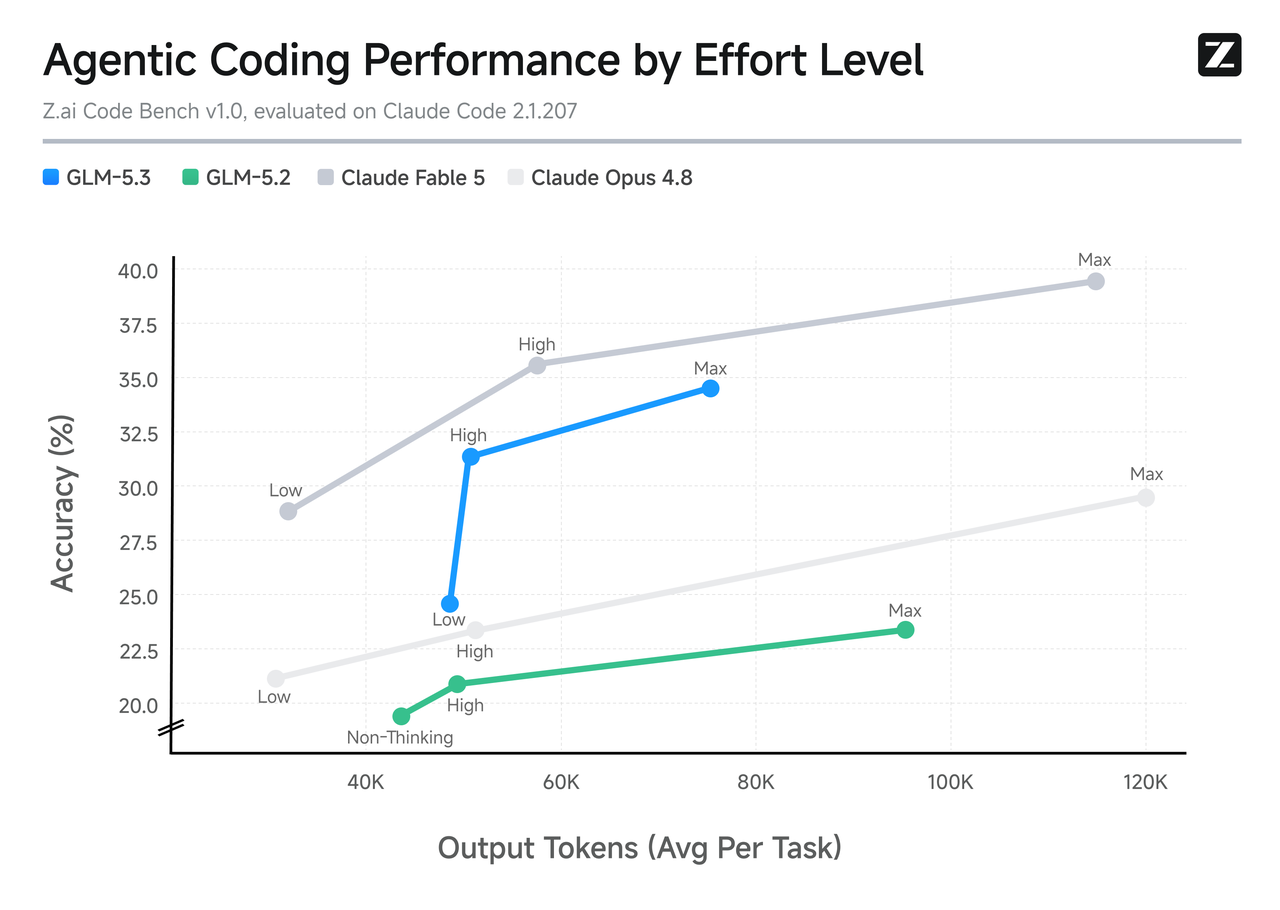
O carro-chefe tem um teto de desempenho mais alto. Ele lidera o Flash por 3,5 pontos no DeepSWE e 1,7 pontos no NL2Repo. No Z.ai Code Bench v1.0, com ambos os modelos avaliados usando Claude Code 2.1.207, o carro-chefe alcança 34,5% no esforço máximo, enquanto o Flash chega a 29,0% — uma vantagem de 5,5 pontos.
O Flash ainda é competitivo o suficiente para ser o primeiro modelo testado para manutenção rotineira de repositórios, geração de testes, depuração, refatoração e agentes de codificação em alto volume. Escalone apenas as tarefas mais difíceis ou trajetórias com falha para o carro-chefe.
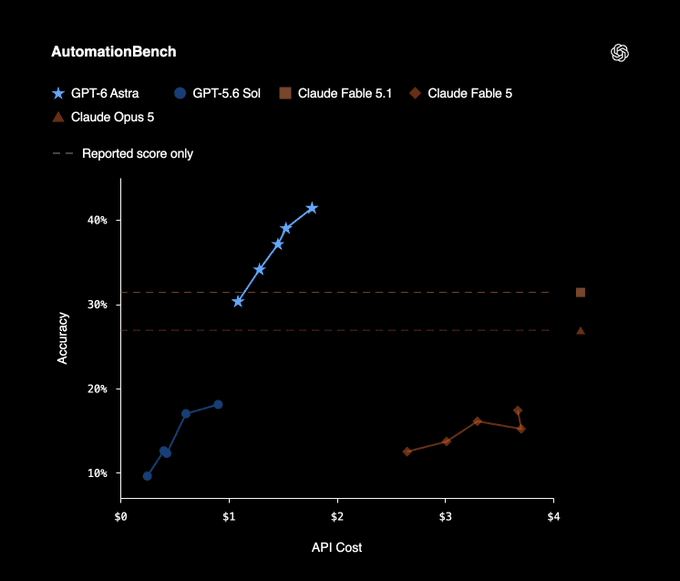
A avaliação de seis benchmarks da Z.ai do GLM-5.3-Flash e outros modelos de codificação/agentes.
Fonte: documentação oficial do Flash da Z.ai
Precisão de codificação baseada em agentes do GLM-5.3 e uso de tokens de saída em diferentes níveis de esforço de raciocínio.
Fonte: documentação oficial do carro-chefe
Uso de ferramentas, automação e trabalho do conhecimento
O Flash não é uniformemente mais fraco. Ele marca 78,4 no Toolathlon Verified contra 73,0 do carro-chefe e supera no AutomationBench por 48,8 a 48,2. Está essencialmente empatado no GDPval-AA v2. Isso torna o Flash particularmente atraente quando a tarefa é menos sobre uma única cadeia de raciocínio extremamente difícil e mais sobre coordenar ferramentas de forma confiável em muitos pedidos baratos.
Inteligência, velocidade e latência independentes
Medição independente
GLM-5.3 Flash
GLM-5.3 (máx.)
Resultado
Artificial Analysis Intelligence Index
57
60
GLM-5.3
Output speed
50.2 tokens/s
76.6 tokens/s
GLM-5.3
Time to first token
1.49 s
1.61 s
Flash
Context window
1M
1M
Empate
Blended price in AA comparison
$0.10 / 1M tokens
$0.90 / 1M tokens
Flash
Fonte: comparação de API igualada da Artificial Analysis.
O resultado independente adiciona uma correção importante à suposição de “Flash significa mais rápido”. O Flash responde um pouco mais cedo, mas o endpoint do carro-chefe testado gera tokens mais rápido depois que a saída começa. Trate essas medições como instantâneos específicos do provedor, não como propriedades imutáveis do modelo.
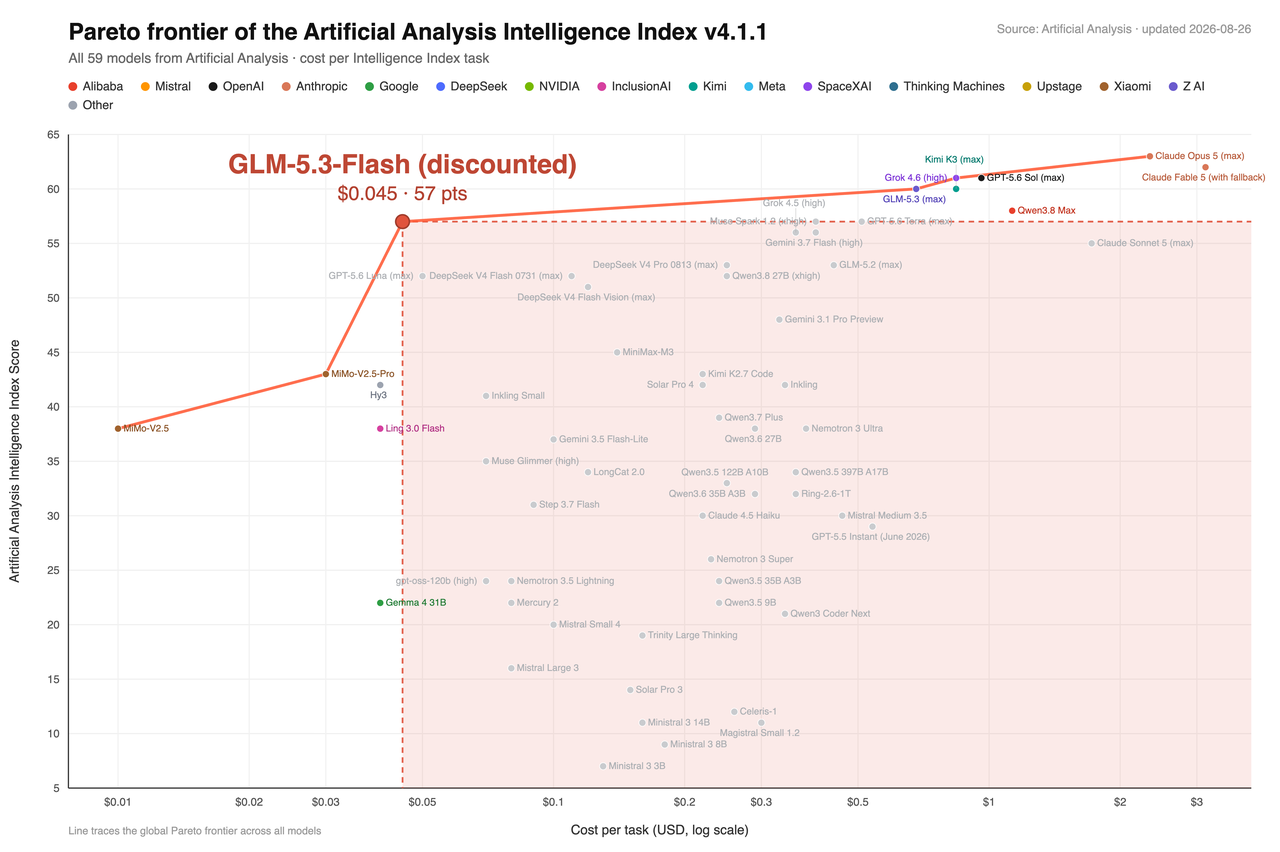
Fronteira custo–inteligência da Artificial Analysis reproduzida na documentação oficial do Flash da Z.ai.
Fonte: documentação oficial do Flash da Z.ai
Multimodalidade: o Flash tem vantagem clara
O Flash aceita entradas visuais e as integra em fluxos de trabalho baseados em agentes. Ele pode inspecionar capturas de tela, imagens de páginas, gráficos, estados de interface, gravações de tela e arquivos compatíveis, e então usar a evidência visual ao codificar ou operar ferramentas. O carro-chefe atualmente suporta apenas entrada de texto.
Frontend e design-to-code: o Flash pode inspecionar uma captura de tela de referência e validar a implementação renderizada.
Documentos e fluxos de trabalho de Office: o Flash pode raciocinar sobre estrutura de página, gráficos, layout e posicionamento de imagens.
Navegador e uso de computador: o Flash pode combinar estado visual com chamadas de ferramentas e correções iterativas.
Trabalho de repositório apenas com texto: o carro-chefe continua preferível quando a entrada é código e texto e a tarefa requer máxima profundidade de raciocínio.
Contexto longo e controles de raciocínio
O GLM-5.3 Flash suporta uma janela de contexto de 1M de tokens e até 128K tokens de saída; o GLM-5.3 oferece os mesmos limites. Ambos mantêm o raciocínio ativado e aceitam níveis de esforço baixo, alto e máximo. A Z.ai recomenda máximo para codificação difícil e reprodução de benchmarks.
A capacidade de contexto, portanto, não é o principal diferenciador. A diferença está em quão economicamente cada modelo atende sequências longas e quanta capacidade de raciocínio consegue trazer para as tarefas mais difíceis. Arquiteturalmente, o Flash é mais barato em contexto longo; o carro-chefe tem um teto de qualidade mais forte.
Cibersegurança: o GLM-5.3 é o especialista
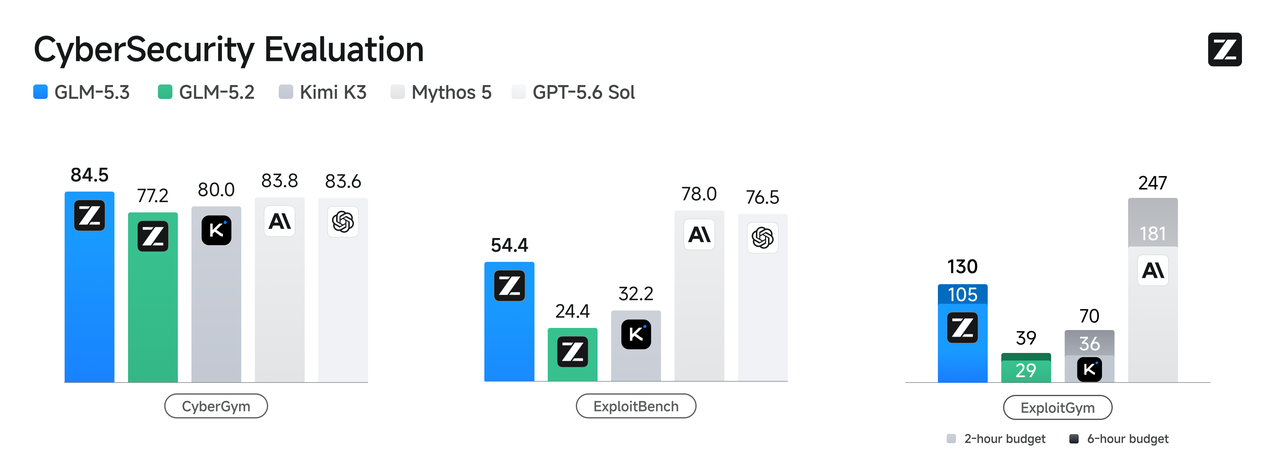
Cibersegurança é a capacidade mais distintiva do carro-chefe. A Z.ai reporta 84,5 no CyberGym e 54,4 no ExploitBench. Sob orçamentos normalizados de duas e seis horas, ele completou 105 e 130 tarefas do ExploitGym.
O Flash não tem um foco equivalente de lançamento ou uma suíte cibernética pública correspondente. Para revisão de código, desenvolvimento seguro e descoberta autorizada de vulnerabilidades, use o carro-chefe como modelo principal e mantenha aprovação humana, ferramentas isoladas, logs de auditoria e controles de divulgação no fluxo de trabalho.
Desempenho do GLM-5.3 em benchmarks de descoberta de vulnerabilidades e exploração.
Fonte: documentação oficial de cibersegurança da Z.ai
Custo e implantação
Preços de API
A Z.ai lista o Flash a $0.15 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída antes de promoções, em comparação com $1.40 e $4.40 para o carro-chefe.
Rota de acesso
Entrada do Flash
Flash em cache
Saída do Flash
Entrada do 5.3
5.3 em cache
Saída do 5.3
Lista padrão da Z.ai
$0.15
$0.03
$0.50
$1.40
$0.26
$4.40
Tarifa promocional do Flash da Z.ai
$0.075
$0.015
$0.25
$1.40
$0.26
$4.40
Rota CometAPI
$0.06
Check live route
$0.20
$1.12
Check live route
$3.528
Os preços estão em USD por 1M de tokens. Fontes: preços da Z.ai, rota do Flash e rota do GLM-5.3. Promoções podem mudar.
Exemplo de custo mensal
Para uma carga de trabalho usando 100M de tokens de entrada e 20M de tokens de saída, as tarifas atuais da CometAPI produzem uma estimativa de $10.00 para o Flash contra $182.56 para o carro-chefe, antes de efeitos de cache ou cobranças de ferramentas. O Flash reduz a conta de tokens em cerca de 94,5% neste exemplo.
O Flash é mais fácil de servir do que o carro-chefe, mas não é um modelo para GPU de consumidor. O checkpoint de 320B, componentes multimodais, cache KV e contexto de 1M ainda exigem infraestrutura séria. A auto-hospedagem é mais atraente quando controle de dados, serving personalizado ou alta utilização sustentada justificam o custo operacional.
Qual modelo você deve escolher?
Escolha o GLM-5.3 Flash se:
Você precisa de entendimento de imagens, capturas de tela, gráficos, documentos, navegador ou GUI.
Você executa agentes de codificação em alto volume, fluxos de pesquisa ou automação de negócios.
Você quer bom desempenho em uso de ferramentas e trabalho do conhecimento ao menor custo por token.
Você precisa de uma janela de contexto de 1M, mas não deseja a economia do carro-chefe em cada requisição.
Você planeja auto-hospedar e 320B/18B é mais viável do que 744B/40B.
Escolha o GLM-5.3 se:
Você está resolvendo as tarefas de codificação mais difíceis em escala de repositório ou engenharia de longo horizonte.
Sua avaliação recompensa raciocínio mais profundo mais do que baixo custo unitário.
Você precisa do resultado mais forte em DeepSWE, HLE with tools ou Agents’ Last Exam.
Você está construindo fluxos de trabalho de segurança defensiva ou descoberta de vulnerabilidades autorizada.
Uma taxa de sucesso mais alta pode compensar um prêmio de preço por token de aproximadamente uma ordem de magnitude.
Matriz de decisão por caso de uso
Carga de trabalho
Modelo inicial recomendado
Por quê
Chat e automação em alto volume
GLM-5.3 Flash
Custo muito menor; forte uso de ferramentas
Codificação visual e depuração de UI
GLM-5.3 Flash
Entrada visual nativa
Análise de documentos, gráficos e Office
GLM-5.3 Flash
Fluxos de trabalho profissionais multimodais
Manutenção rotineira de repositórios
Comece com o Flash
Escalone tarefas falhas ou incomuns
Engenharia difícil em escala de repositório
GLM-5.3
Teto de codificação mais alto
Pesquisa de longo horizonte com ferramentas
GLM-5.3
Resultado mais forte em HLE-with-tools
Segurança defensiva e descoberta de vulnerabilidades
GLM-5.3
Treinamento e benchmarks de cyber dedicados
Auto-hospedagem sensível a custos
GLM-5.3 Flash
Pegada total e ativa menor
Carga mista incerta
Roteamento híbrido
Flash por padrão; escalonamento para o carro-chefe
Uma estratégia de produção melhor: roteie, não substitua
Para a maioria das equipes, a melhor arquitetura não é uma escolha exclusiva. Use o Flash como rota padrão e escalone apenas tarefas com alta complexidade, validação falha, sensibilidade de segurança ou valor econômico esperado que justifique o prêmio do carro-chefe.
Envie tarefas visuais, rotineiras e de alto volume para o Flash.
Meça taxa de aceitação, tokens, latência, falhas de ferramentas e intervenção humana.
Escalone tarefas de texto com falha ou de alto risco para o carro-chefe.
Roteie trabalho sensível à segurança por controles adicionais de autorização e sandbox.
Otimize por custo por resultado aceito, e não apenas por ranking de benchmark ou preço.
Como testar ambos os modelos via CometAPI
A CometAPI lista a rota do GLM-5.3 Flash e a rota do GLM-5.3 atrás da mesma URL base compatível com OpenAI. Crie uma chave de API e execute a mesma tarefa de texto em ambos os IDs de modelo. Para um teste justo, mantenha fixos o prompt, o esforço de raciocínio, as definições de ferramentas, a saída máxima e a rubrica de aceitação.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Para avaliação multimodal, use a documentação ao vivo da rota do Flash para verificar o esquema de conteúdo de imagem compatível. A comparação com o carro-chefe deve usar um equivalente apenas em texto porque ele não aceita entrada visual.
Limitações desta comparação
Várias pontuações de codificação e agentes são reportadas pelo fornecedor. A reprodução independente pode usar ferramentas, prompts e configurações de inferência diferentes.
Nomes de benchmarks iguais não garantem versões de harness idênticas ou estratégias de gestão de contexto.
Reduções no nível da arquitetura em computação de atenção e cache KV não predizem diretamente a latência da API.
Preços, promoções, disponibilidade de modelos, limites de taxa e capacidades de rota podem mudar; verifique as páginas de modelo ao vivo antes da implantação.
Pesos abertos não tornam nenhum dos checkpoints barato para auto-hospedar em contexto cheio.
A capacidade de cibersegurança é de uso dual e requer autorização, sandboxing, logging, revisão por especialistas e divulgação responsável.
Conclusão
O GLM-5.3 Flash é o padrão prático. Ele preserva contexto longo, adiciona visão nativa, tem desempenho forte em uso de ferramentas e trabalho profissional, e muda a economia o suficiente para permitir implantações muito mais amplas. O GLM-5.3 é o modelo de escalonamento especializado: mais caro, apenas texto, mas mais forte nas tarefas mais difíceis de codificação, raciocínio e cibersegurança.
O veredito final é, portanto, baseado na carga de trabalho: comece com o Flash, meça a taxa real de aceitação e roteie para o carro-chefe apenas quando sua capacidade extra de raciocínio produzir resultados adicionais suficientes para justificar o prêmio.
Perguntas frequentes
O GLM-5.3 Flash é melhor que o GLM-5.3?
Não universalmente. O Flash é melhor em preço, multimodalidade e vários benchmarks de ferramentas/automação. O carro-chefe é mais forte nas tarefas mais difíceis de codificação, raciocínio assistido por ferramentas e cibersegurança.
O GLM-5.3 Flash é um modelo pequeno?
Não. Ele tem 320B de parâmetros totais e ativa 18B por token. É mais eficiente que o carro-chefe de 744B/40B, mas ainda requer hardware substancial para auto-hospedagem.
Qual modelo é mais barato?
O Flash é dramaticamente mais barato. O preço de tabela padrão da Z.ai é cerca de um décimo do preço do carro-chefe, e as rotas atuais da CometAPI mostram uma diferença ainda maior enquanto a promoção estiver ativa.
Qual modelo é mais rápido?
Depende da métrica e do provedor. A Artificial Analysis mediu tempo até o primeiro token ligeiramente menor para o Flash, mas velocidade de saída maior para o carro-chefe.
Qual modelo suporta imagens?
O Flash suporta entrada visual nativa. O carro-chefe atualmente suporta apenas entrada de texto.
Ambos os modelos suportam contexto de 1M tokens?
Sim. O Flash suporta 1M de contexto e até 128K de saída; o carro-chefe fornece os mesmos limites.
Qual modelo é melhor para codificação?
Use o Flash para agentes de codificação rotineiros e em alto volume. Use o carro-chefe para as tarefas mais difíceis de engenharia em escala de repositório ou quando a falha custa mais do que a diferença de preço.
Qual modelo é melhor para cibersegurança?
O carro-chefe. A Z.ai o treinou e avaliou especificamente para descoberta de vulnerabilidades e raciocínio de cadeias de exploração. Use-o apenas em ambientes autorizados e controlados.
Ambos os modelos podem ser auto-hospedados?
Sim. O repositório da Z.ai lista checkpoints para download e frameworks de serving compatíveis, mas ambos continuam sendo projetos de infraestrutura de grande porte.
Qual é a melhor estratégia de implantação?
Use o Flash como rota padrão e escalone tarefas de texto difíceis, com falha ou sensíveis à segurança para o carro-chefe. Meça o custo por resultado aceito.
Flash
Melhor ajuste
Roteamento padrão, agentes multimodais, escala
Tarefas complexas de texto e segurança de altíssima criticidade