
TL;DR
GLM 5.4 é um nome usado pela comunidade para um possível sucessor na família GLM da Z.ai. Em 14 de outubro de 2026, a documentação oficial do modelo e os registros de lançamento revisados para este artigo não estabelecem um lançamento do GLM-5.4, ficha técnica ou identificador de API. Union Alpha é uma pista de rumor, enquanto um lançamento em outubro é uma possibilidade baseada na cadência. A pergunta útil é se um lançamento futuro melhora a confiabilidade em codificação e o custo por tarefa concluída; os modelos GLM existentes fornecem a referência para essa avaliação.
Principais pontos
- Status do lançamento: As fontes oficiais revisadas em 14 de outubro de 2026 não confirmam o GLM-5.4; não há data exata de lançamento estabelecida.
- Evidência de rumor: A associação de Union Alpha com o GLM-5.4 permanece não verificada, e o resumo citado não identifica um post de atribuição original.
- Linha de base de desempenho: Resultados existentes do GLM-5.3 são um contexto útil, mas não são medições do GLM-5.4.
- Arquitetura: O GLM-5.3-Flash demonstra uma direção diferente de eficiência e multimodalidade; a herança pelo GLM-5.4 é uma questão em aberto.
- Ação para desenvolvedores: Avalie os modelos disponíveis agora e exija IDs de modelo verificados, compatibilidade e medições em nível de tarefa antes de atualizar.
O GLM 5.4 já foi lançado?
GLM 5.4 é um nome não oficial para um potencial sucessor do GLM. O índice da documentação oficial (https://docs.z.ai/llms.txt) e os registros de lançamento (https://docs.z.ai/release-notes/new-released) revisados em 14 de outubro de 2026 identificam modelos GLM existentes, mas não estabelecem um lançamento do produto GLM-5.4. Esta é uma verificação de fontes datada, não uma prova de que não exista desenvolvimento privado.
Dois caminhos de desenvolvimento documentados explicam por que um possível sucessor atrai atenção.
A Z.ai confirma que o GLM-5.3 reutiliza o modelo base GLM-5.2 (https://huggingface.co/zai-org/GLM-5.3) e obtém seus ganhos por meio de pós-treinamento. O GLM-5.3-Flash, por sua vez, usa um novo base multimodal e uma arquitetura de atenção híbrida esparsa-linear. Esses fatos descrevem modelos existentes, não um design divulgado do GLM-5.4.
Em termos práticos, um caminho aprimora um modelo existente com treinamento adicional, enquanto o outro redesenha a arquitetura para reduzir custos computacionais e suportar novas capacidades.
Um futuro GLM-5.4 poderia se basear em qualquer uma dessas direções, mas ainda não há evidências suficientes para determinar qual abordagem a Z.ai selecionará.
Quão confiáveis são os rumores e vazamentos sobre o GLM-5.4?
Informações confirmadas
A base técnica confirmada vem do GLM-5.3 e do GLM-5.3-Flash, não do GLM-5.4. O nome GLM-5.4, especificações finais, data de lançamento e resultados de benchmarks permanecem não confirmados nas fontes oficiais revisadas para este artigo.
Relatos da comunidade / vazamentos
Um post no X de 8 de outubro de 2026 por @NFT_Chen (https://x.com/NFT_Chen/status/2108131637502628341) atribui uma possível direção de desenvolvimento do GLM-5.4/5.5 a comentários de Tang Jie. O post descreve três prioridades de escalonamento: expansão do pré-treinamento, fortalecimento do pós-treinamento por meio de SFT, RLHF e RLVR, e extensão do raciocínio e da execução de agentes em tarefas mais difíceis e longas.
O autor interpreta a próxima direção como agentes autônomos mais longos e aprimoramento recursivo autônomo (RSI). Este é um relato comunitário de uma palestra, não um anúncio de lançamento da Z.ai. Os nomes de versão e alegações de desenvolvimento permanecem atribuídos ao post; eles não estabelecem data de lançamento, arquitetura final, contagem de parâmetros ou capacidade demonstrada de autoaperfeiçoamento para o GLM-5.4.
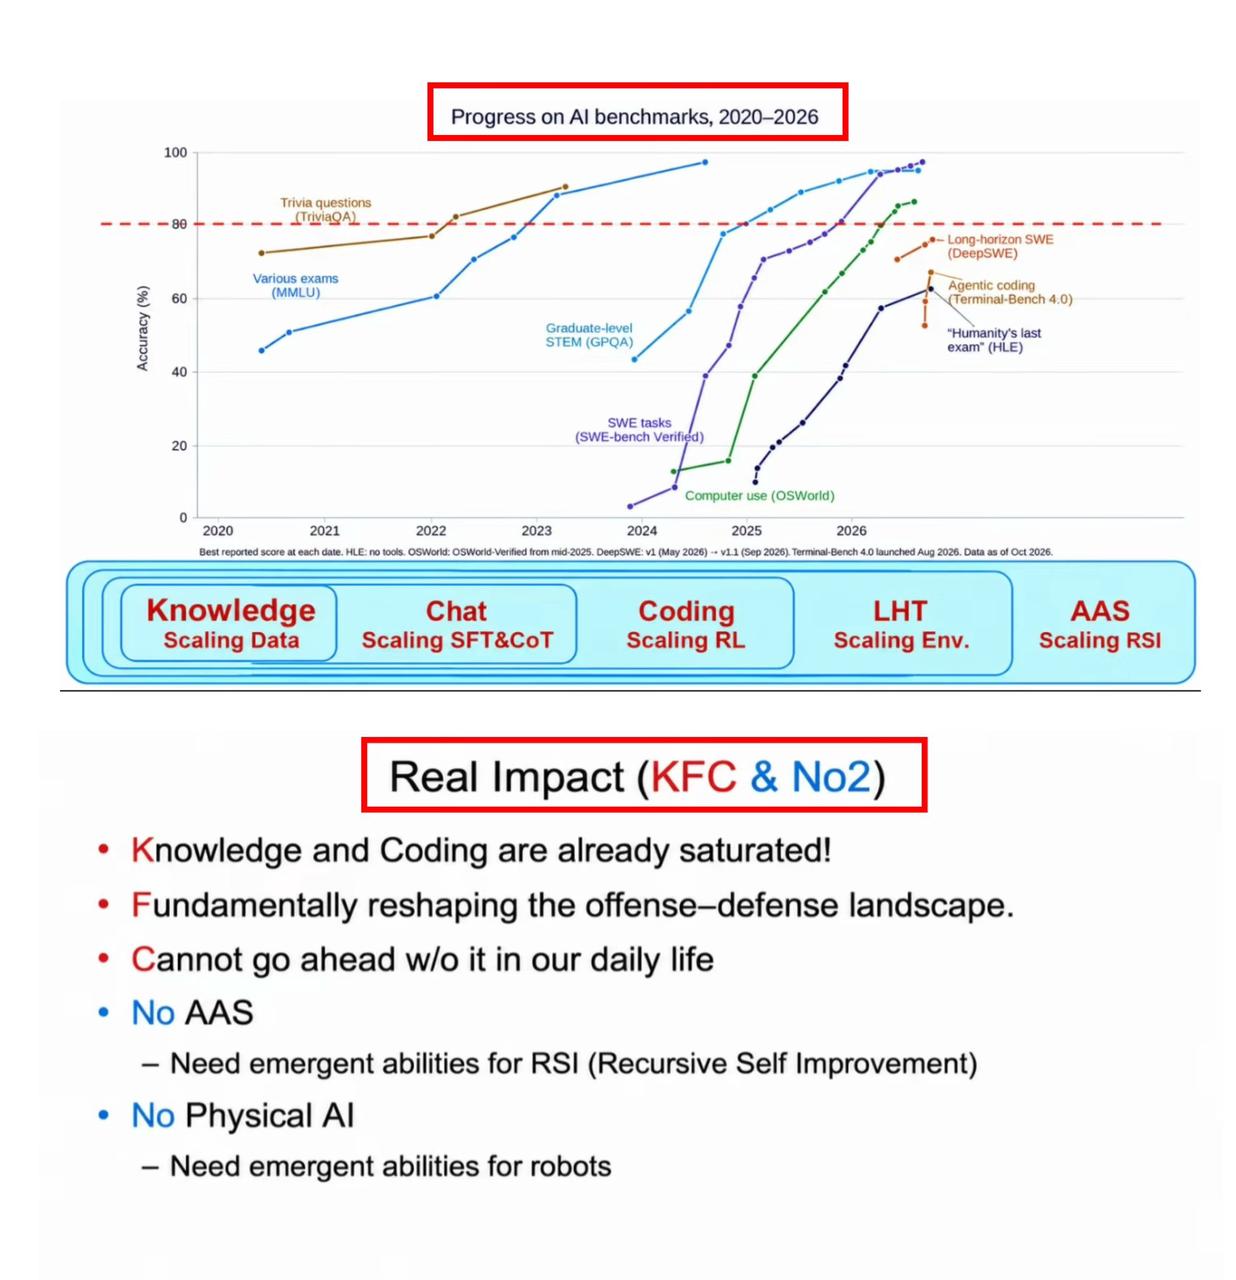
Imagem de slide de apresentação anexada ao post original de @NFT_Chen no X, 8 de outubro de 2026. Ela discute progresso em benchmarks e RSI como direção futura; não é um relatório de benchmark do GLM-5.4.
Fotografia da palestra anexada ao post original de @NFT_Chen no X, 8 de outubro de 2026.
Análise
Uma análise útil de rumores pergunta que observação mudaria a conclusão. Um identificador de modelo oficial, um anúncio de lançamento ou um mapeamento divulgado de um alias anônimo fortaleceria materialmente o caso. Um padrão de nomenclatura semelhante ou apenas o intervalo entre lançamentos não consegue fazê-lo. Especulações antigas sobre outros números de versão futuros do GLM não estabelecem especificações para o GLM-5.4.
Quando o GLM 5.4 poderia ser lançado?
A linha do tempo das notas de lançamento da Z.ai (https://docs.z.ai/release-notes/new-released) registra GLM-5 em 12 de fevereiro, GLM-5.1 em 7 de abril, GLM-5.2 em 16 de junho, GLM-5.3 em 18 de agosto e GLM-5.3-Flash em 26 de agosto de 2026. Essas são datas registradas nas notas de lançamento; não devem ser confundidas com todos os anúncios de pesquisa ou datas de disponibilidade por provedor.
A progressão aproximada de dois meses das versões principais torna outubro uma janela analítica razoável para observar. Isso não estabelece um lançamento em outubro, um dia específico ou mesmo o próximo nome de versão. Sem uma fonte de previsão rastreável e sua metodologia, uma previsão exata para 20 de outubro ou 23 de outubro implicaria mais precisão do que as evidências suportam.
Um lançamento posterior, um nome diferente ou uma variante de produto separada continuam possíveis. Os desenvolvedores devem planejar com base nas APIs atualmente disponíveis, em vez de uma estimativa de calendário.
Quais são as especificações esperadas do GLM 5.4?
Não há uma ficha técnica confiável do GLM-5.4 disponível. Em vez de atribuir hardware e parâmetros de modelo rumorados a um produto não lançado, é mais informativo comparar os modelos GLM mais recentes documentados e identificar o que permanece desconhecido.
| Especificação | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Lançamento | 18 de agosto de 2026 | 26 de agosto de 2026 | Não anunciado |
| Fundação do modelo | Base GLM-5.2; pós-treinamento extra | Nova base multimodal | Desconhecido |
| Arquitetura | Base MoE | MoE; atenção híbrida esparsa-linear | Desconhecido |
| Suporte de contexto | 1M de contexto documentado na API | 1M | Desconhecido |
| Multimodalidade nativa | Entrada apenas de texto | Entradas de texto, imagem, vídeo e arquivo | Desconhecido |
| Ênfase principal | Codificação, agentes, segurança cibernética | Eficiência, codificação, multimodalidade | Desconhecido |
| Benchmarks publicados | Disponível | Disponível | Não disponível |
| Pesos do modelo | Liberados | Liberados | Não disponível |
A tabela relata capacidades documentadas de modelos existentes. As entradas do GLM-5.4 permanecem desconhecidas, em vez de herdar valores de qualquer predecessor. O contexto de avaliação de um modelo, a janela de contexto da API e o comprimento máximo de saída são limites distintos.
A visão geral da arquitetura do GLM-5.3-Flash (https://docs.z.ai/guides/vlm/glm-5.3-flash) reporta 320B de parâmetros totais, 18B de parâmetros ativados e atenção híbrida esparsa-linear. Essas são especificações divulgadas do Flash e não devem ser atribuídas ao GLM-5.4.
Codificação agentiva como direção potencial de upgrade
A codificação agentiva é uma das áreas mais críveis a observar. O GLM-5.3 já demonstrou que escalar o pós-treinamento pode melhorar substancialmente o desempenho em tarefas de engenharia de múltiplas etapas. Seus desenvolvedores enfatizaram trabalho com repositórios complexos, horizontes de execução mais longos e resolução de problemas orientada por ferramentas aprimorada.
Um modelo futuro poderia estender essas capacidades por meio de melhor interação com o ambiente, planejamento mais confiável e menos falhas em chamadas de ferramentas.
A avaliação mais útil não mediria apenas a porcentagem de questões de codificação respondidas corretamente. Ela mediria se um agente consegue concluir tarefas complicadas de ponta a ponta, incluindo depuração, testes, revisão e recuperação após falhas.
Arquitetura multimodal eficiente como possível direção
O GLM-5.3-Flash fornece um ponto de referência arquitetural para desenvolvimento futuro, enquanto nenhuma fonte oficial revisada estabelece seu uso no GLM-5.4.
A Z.ai descreve um corpus multimodal de pré-treinamento de 30T tokens como parte do design orientado à eficiência do GLM-5.3-Flash. Isso descreve a escala de dados de treinamento de um modelo existente e não é um compromisso de roadmap para o GLM-5.4.
A visão geral oficial do Flash reporta 3.01× menos computação de atenção e 4.44× menores requisitos de cache KV em relação ao GLM-5.3 sob a comparação indicada. Esses são resultados de eficiência em nível de componente, não uma garantia de aceleração em produção ou desconto na API.
São melhorias de engenharia significativas, mas não há confirmação de que o GLM-5.4 herdará a mesma arquitetura. Um modelo de próxima geração maior pode priorizar o máximo desempenho de raciocínio, enquanto uma variante Flash separada pode continuar a otimizar latência e custo.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Linha de base de benchmarks do GLM-5.3
Os dados de benchmark disponíveis suportam uma análise da trajetória de desempenho do GLM-5.3, não uma medição direta do GLM-5.4. Os valores abaixo são avaliações reportadas pela Z.ai de modelos existentes. Eles não foram reproduzidos de forma independente para este artigo e não medem o GLM-5.4. Cada benchmark usa seu próprio conjunto de tarefas e método de pontuação; diferenças de pontuação não devem ser interpretadas como ganhos equivalentes entre tarefas.
| Benchmark e metodologia | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Diferença GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Não reportado na comparação citada do Flash | +23.7 pontos |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 pontos |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 pontos |
| CyberGym | 77.2 | 84.5 | Não reportado na comparação citada do Flash | +7.3 pontos |
| ExploitBench | 24.4 | 54.4 | Não reportado na comparação citada do Flash | +30.0 pontos |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 pontos |
| GDPval-AA v2 | 1508 | 1769 | Não reportado na comparação citada do Flash | +261 Elo |
| Toolathlon Verified | 59.9 | Não reportado na comparação citada do GLM-5.3 | 78.4 | Não disponível |
A tabela combinada coloca os resultados de modelos existentes lado a lado; ela não contém medições do GLM-5.4. Um valor não reportado não é uma pontuação zero. Mantenha as condições de avaliação de cada benchmark em vista e trate diferenças do GDPval-AA como Elo, e não como pontos percentuais.
Metodologia: DeepSWE v1.1 usa mini-swe-agent, temperatura 0.95, top_p 1.0, tempo limite de seis horas e 400K de contexto. AutomationBench usa a v1.0.6. HLE with Tools usa temperatura 1.0, top_p 0.95, limite de geração de 163,840 tokens e limite de contexto de 300K com gerenciamento de contexto. GDPval-AA v2 usa uma escala Elo, então sua diferença não é um ganho em pontos percentuais.
Para CyberGym e ExploitBench, a Z.ai reporta Claude Code 2.1.207 com esforço máximo de raciocínio, sem ferramentas web, temperatura 1.0, top_p 1.0 e limite de saída de 128,000 tokens. CyberGym reporta pass@1 de execução única em 1,507 tarefas com tempo limite por tarefa ilimitado. ExploitBench usa até 300 rodadas de interação e faz a média de cobertura em 41 tarefas ao longo de três revisões. As notas de rodapé do card do modelo fornecem os detalhes do ambiente específico do benchmark.
Metodologia do Flash: DeepSWE usa mini-swe-agent, 400K de contexto e tempo limite de seis horas; AutomationBench usa a v1.0.6. Toolathlon Verified reporta pass@1 em média ao longo de três execuções independentes por meio do serviço oficial de avaliação. HLE usa as configurações de amostragem e gerenciamento de contexto descritas acima. Veja a metodologia do card do modelo Flash (https://huggingface.co/zai-org/GLM-5.3-Flash). Esses resultados de benchmark não estabelecem latência em produção ou custo.
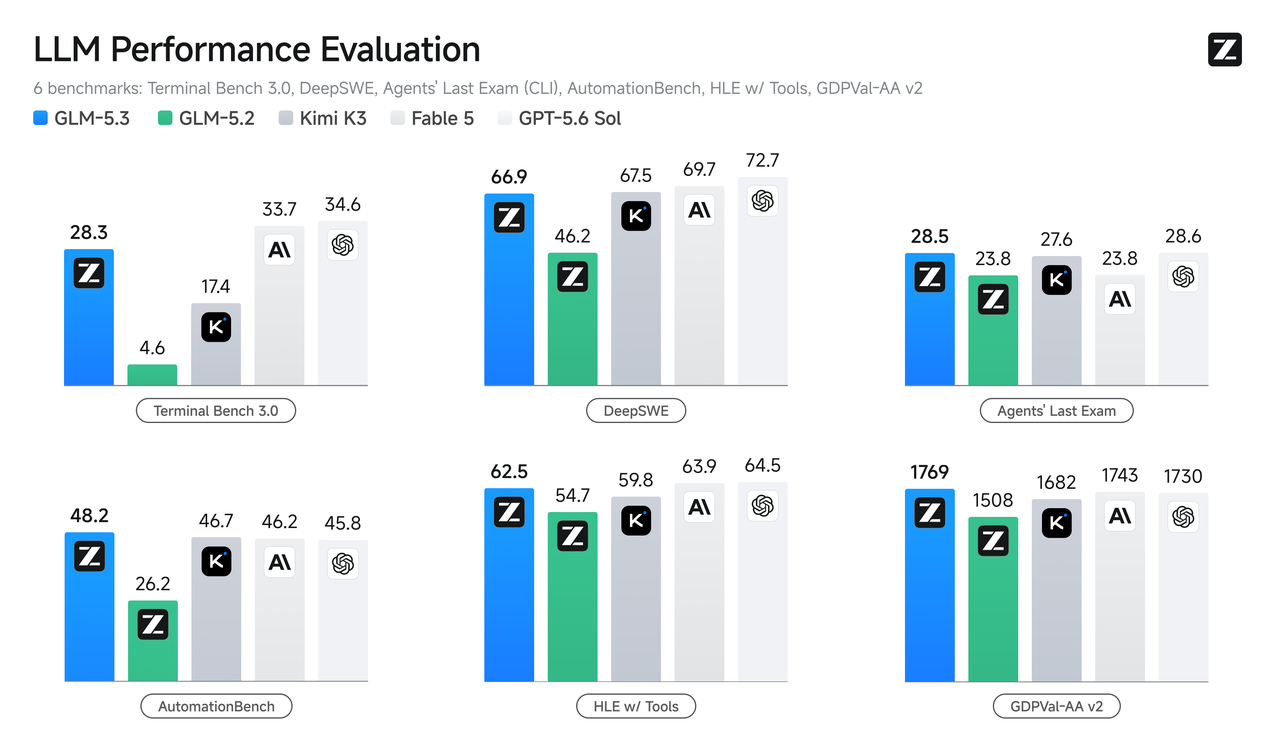
Gráfico oficial de desempenho do GLM-5.3, reproduzido do anúncio de benchmarks da Z.ai (https://z.ai/blog/glm-5.3). A imagem mostra avaliações de modelos predecessores; ela não contém resultados do GLM-5.4.
Os maiores avanços aparecem em tarefas que exigem interação sustentada com um ambiente. O Terminal Bench 3.0 aumentou de 4.6 para 28.3, enquanto o ExploitBench melhorou de 24.4 para 54.4.
Esses ganhos sugerem que o pós-treinamento e ambientes orientados a agentes podem alterar dramaticamente o desempenho de um modelo sem mudar sua arquitetura base subjacente. No entanto, eles não devem ser extrapolados para uma previsão numérica para o GLM-5.4.
Capacidades e adequação à produção
Para produção, o GLM-5.3 é a referência mais forte para codificação complexa, engenharia de longo horizonte e avaliação de segurança cibernética. O GLM-5.3-Flash adiciona entradas visuais nativas e enfatiza o uso eficiente de ferramentas. As ofertas existentes do GLM-5.2, GLM-5.3 e Flash fornecem uma linha de base; nenhuma capacidade ou disponibilidade equivalente do GLM-5.4 está estabelecida nas fontes revisadas para este artigo.
Os modelos documentados suportam até 1M de contexto, mas esse limite não garante contexto utilizável idêntico ou desempenho de tarefa em cada endpoint. Escolha entre eles usando cargas de trabalho representativas e custo por tarefa concluída com sucesso.
Um futuro GLM-5.4 precisaria oferecer uma melhora mensurável para justificar a migração. Melhorar a precisão de benchmarks enquanto dobra o custo de conclusão de tarefas pode não ser atraente para implantações em produção. Por outro lado, um ganho modesto de precisão e substancialmente menos chamadas de ferramentas pode ser valioso em escala.
Compare sucesso em tarefas, tokens de entrada e saída, latência, chamadas de ferramentas fracassadas e custo por tarefa bem-sucedida sob o mesmo arcabouço de avaliação. Descrições qualitativas de modelos não são um teste controlado frente a frente.
Qual é o status atual da API do GLM-5.4 na CometAPI?
A CometAPI criou uma página dedicada ao modelo GLM 5.4 com uma entrada de identificador de modelo estável. No entanto, a página ainda rotula o modelo como “Coming soon” e o descreve como um modelo pré-lançamento. Os desenvolvedores devem verificar o ID real do modelo, acesso à conta, disponibilidade do endpoint, parâmetros suportados, limites de contexto e preços antes de tentar uso em produção.
Para uma integração atualmente documentada, use um modelo GLM disponível, como o GLM-5.2 ou GLM-5.3. A página do GLM-5.4 da CometAPI deve ser tratada atualmente como uma entrada de catálogo pré-lançamento até que o ID do modelo e o endpoint sejam confirmados como chamáveis.
Preparando-se para a integração da API do GLM 5.4
A preparação mais prática é evitar acoplar a lógica da aplicação a uma única versão de modelo. Um identificador de modelo configurável facilita avaliar upgrades sem reescrever o pipeline de requisições.
Mantenha o identificador do modelo configurável e use um modelo GLM disponível para estabelecer uma linha de base funcional. Antes de mudar para o GLM-5.4, confirme um ID de modelo chamável, acesso à conta, parâmetros de requisição suportados, limites de contexto e de saída, comportamento de streaming e compatibilidade de chamadas de ferramentas. Mantenha uma opção de rollback pronta.
Quando o GLM-5.4 se tornar oficialmente disponível, verifique o ID do modelo, parâmetros suportados, limites de contexto e compatibilidade de endpoint. Execute o modelo antigo e o novo no mesmo conjunto de avaliação, acompanhando taxa de sucesso, latência, tokens de saída, falhas de chamadas de ferramentas e custo por execução bem-sucedida.
Como poderia ser o preço da API do GLM 5.4?
Nenhum preço oficial de API do GLM-5.4 foi anunciado. Portanto, seria enganoso publicar uma tarifa específica de tokens de entrada ou saída como se fosse um vazamento genuíno.
A família GLM atual ilustra por que o tamanho do modelo por si só é insuficiente para prever preços. O GLM-5.3-Flash introduziu otimizações arquiteturais projetadas para oferecer inteligência competitiva a um custo de inferência substancialmente menor.
A comparação “Artificial Analysis Intelligence Index v4.1.1” da Z.ai (https://z.ai/blog/glm-5.3-flash) reporta uma pontuação de 57 a um custo estimado com desconto de $0.045 por tarefa para o GLM-5.3-Flash. Esse custo de avaliação não é uma tarifa de tokens de entrada/saída e não prevê o preço do GLM-5.4.
O preço futuro do GLM-5.4 pode depender da arquitetura, esforço de raciocínio, descontos de tokens em cache, infraestrutura de hospedagem e variantes. Para planejamento de produção, o custo por tarefa concluída com sucesso costuma ser mais valioso do que a menor tarifa de tokens de entrada no título.
Os desenvolvedores devem esperar pelo GLM 5.4?
Para a maioria dos desenvolvedores, esperar por um modelo não anunciado é desnecessário. Os modelos GLM existentes fornecem capacidades documentadas de codificação e agentivas que podem ser testadas em aplicações reais.
Equipes construindo assistentes de codificação ou agentes de engenharia de múltiplas etapas podem estabelecer uma linha de base com o GLM-5.3. Aplicações que enfatizam compreensão visual, contexto longo e chamadas repetidas eficientes podem avaliar o GLM-5.3-Flash.
Construa um arcabouço de avaliação agora e reserve um espaço para comparação futura com o GLM-5.4. Quando disponível, seu lançamento importará se ele melhorar resultados que contam para uma aplicação específica.
Pesquisadores devem observar por uma nova arquitetura base, mudanças em benchmarks de longo horizonte e confiabilidade de ponta a ponta. Empresas devem priorizar disponibilidade, custo, latência, compatibilidade e qualidade em dados representativos de produção.
Conclusão
GLM 5.4 é um próximo passo plausível na família de modelos em rápida evolução da Z.ai, mas sua narrativa atual permanece mais especulativa do que confirmada.
Union Alpha é uma pista de identidade não verificada, e a cadência de lançamentos suporta apenas uma hipótese de tempo ampla. Nenhuma estabelece uma data de lançamento. As fontes oficiais revisadas em 14 de outubro de 2026 fornecem uma linha de base para modelos existentes, e não um lançamento confirmado do GLM-5.4.
O que é verificável é o progresso já feito pelo GLM-5.3 e GLM-5.3-Flash. Ganhos significativos em codificação agentiva, avaliação de segurança cibernética e eficiência de inferência estabelecem uma referência exigente para qualquer sucessor.
A questão-chave é se a Z.ai pode entregar execução autônoma confiável, raciocínio mais forte e um custo competitivo por tarefa concluída. Até que especificações e benchmarks oficiais apareçam, o GLM-5.4 deve ser tratado como um lançamento potencial, e não como um produto disponível.
Perguntas frequentes
Como posso verificar uma listagem de API do GLM 5.4?
Verifique se o provedor fornece um identificador de modelo chamável, endpoint suportado, condições de acesso e preços atuais. Em seguida, compare a identidade com um anúncio ou documentação oficial da Z.ai. Uma listagem de provedor pode estabelecer a oferta desse provedor, mas por si só não autentica o desenvolvedor subjacente de um modelo anônimo.
Quais verificações de compatibilidade importam antes de uma migração para o GLM 5.4?
Valide parâmetros de requisição, configurações de raciocínio, esquema de chamadas de ferramentas, saída estruturada, comportamento de streaming, limites de contexto e saída máxima no seu endpoint real. Inclua testes negativos para parâmetros não suportados e mantenha o modelo existente disponível para rollback. Compatibilidade com OpenAI descreve uma interface; não garante comportamento de modelo idêntico.
Como devo avaliar o GLM 5.4 para agentes de codificação?
Use um conjunto fixo de tarefas representativas de repositório com as mesmas ferramentas, permissões, tempo limite e arcabouço para ambos os modelos. Conte alterações testadas com sucesso, recuperação de falhas de ferramentas, uso de tokens, latência e custo total. Registre cada execução e repita tarefas o suficiente para expor variabilidade, em vez de promover um exemplo favorável.
O que justificaria esperar pelo GLM 5.4?
Esperar é razoável apenas quando uma capacidade futura documentada atende a um requisito que os modelos disponíveis não conseguem cumprir, e o atraso se encaixa no seu cronograma de entrega. Com apenas um rumor, desenvolva com um modelo disponível e mantenha a seleção de modelo configurável. Defina os limiares de capacidade e custo que um lançamento posterior deve atender antes de substituir sua linha de base.