
TL;DR
O Claude Fable 5.1 apresenta o caso mais forte, em benchmarks, para codificação autônoma difícil e trabalho de longo horizonte. O GPT-5.6 Sol oferece custos de token usuais mais baixos, um amplo conjunto de ferramentas nativas e menor tempo até o primeiro token na comparação independente em esforço máximo. A escolha padrão correta depende do custo de uma tarefa fracassada, não apenas da maior pontuação em benchmark.
No Instantâneo do Intelligence Index de 8 de setembro de 2026, o Fable 5.1 marca 53, contra 47 do GPT-5.6 Sol. A vazão de saída é praticamente igual: 69.9 contra 69.8 tokens/s. Esses resultados sustentam uma decisão qualidade versus custo; eles não estabelecem um vencedor universal em velocidade.
Principais conclusões
- Escolha o Fable 5.1 para as tarefas autônomas mais difíceis quando suas próprias avaliações justificarem o preço mais alto.
- Comece com o GPT-5.6 Sol para inferência na fronteira sensível a custos e aplicações que se beneficiam de suas ferramentas integradas.
- Compare a latência inicial separadamente da velocidade de saída: o GPT-5.6 Sol tem menor tempo até o primeiro token, enquanto a vazão é quase igual.
- Modele gravações, leituras, retenção de cache e tarifas de contexto longo separadamente. Preços de entrada/saída em destaque não descrevem todo workload de agentes.
Dados verificados em 8 de setembro de 2026. Resultados independentes usam GPT-5.6 Sol no esforço máximo e Fable 5.1 com Adaptive Reasoning, Max Effort, Default Fallback. Benchmarks de fornecedores e independentes usam configurações de avaliação diferentes. Preços em USD por milhão de tokens (MTok), salvo indicação em contrário.
GPT-5.6 Sol vs Fable 5.1: veredito rápido
| Dimensão | GPT-5.6 Sol | Claude Fable 5.1 | Melhor escolha |
|---|---|---|---|
| Intelligence Index v4.3 independente (8 set.) | 47 | 53 | Fable 5.1 |
| Terminal-Bench 4.0 independente (7 set.) | 39.9% | 52.0% | Fable 5.1 |
| Terminal-Bench 4.0 conduzido pela Anthropic | 37.3% | 55.8% | Fable 5.1 |
| Janela de contexto | 1.05M | 1M | Praticamente empatado |
| Saída máxima | 128K | 128K | Empate |
| Entrada de texto/imagem | Sim | Sim | Empate |
| Preço oficial de entrada / MTok | $4 | $10 | Sol |
| Preço oficial de saída / MTok | $20 | $50 | Sol |
| Leitura oficial de cache / MTok | $0.40 | $0.25 | Fable 5.1 |
| Velocidade de saída independente (8 set.) | 69.8 tok/s | 69.9 tok/s | Praticamente empatado |
| Amplitude de ferramentas de API | Muito ampla | Forte | Sol |
| Trabalho autônomo de longa duração | Excelente | Ponto forte | Fable 5.1 |
| Produção sensível a custos | Melhor padrão | Escalonamento premium | Sol |
Uma política inicial útil é Sol para trabalho de fronteira rotineiro, com Fable 5.1 como rota de escalonamento quando uma tarefa falhar seu limiar de qualidade ou autonomia. Valide essa política contra o custo por tarefa bem-sucedida.
O GPT-5.6 Sol expõe seis níveis de esforço de raciocínio, de none até max, com medium como padrão. O Fable 5.1 usa pensamento adaptativo sempre ativo; effort controla a profundidade do raciocínio, e o padrão é high.
Os 50.000 tokens extras no contexto do GPT-5.6 Sol raramente decidirão a arquitetura. Cobrança e reutilização de cache tornam-se mais relevantes conforme uma solicitação se aproxima de um milhão de tokens; a seção de contexto longo abaixo mostra por quê.
O que é o GPT-5.6 Sol?
GPT-5.6 Sol é um nível de alta capacidade na família GPT-5.6 da OpenAI para workflows exigentes de código, pesquisa, planejamento e agentes. Seu principal apelo nesta comparação é a combinação de controles de raciocínio e o ambiente de execução ao redor.
Pela Responses API, o GPT-5.6 Sol suporta um amplo portfólio de ferramentas nativas: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills e tool search. Isso pode reduzir o número de componentes de runtime separados que uma aplicação precisa integrar.
A OpenAI também descreve programmatic tool calling e execução multiagente para a família. Esses recursos de plataforma importam quando um modelo precisa coordenar trabalho entre ferramentas em vez de retornar uma única resposta.
O que é o Claude Fable 5.1?
O Claude Fable 5.1 mira codificação exigente, trabalho de conhecimento profissional, pesquisa e agentes de longa duração. Seus resultados diretos em benchmarks fazem dele um forte candidato para tarefas em que recuperação, persistência e conclusão bem-sucedida importam mais do que uma resposta curta.
A Anthropic enfatiza execução autônoma sustentada em aplicações, incluindo planejamento, recuperação de etapas com falha e comunicação de progresso. Trate esse posicionamento como um motivo para testar tarefas mais longas, não como garantia de que todo workflow terminará corretamente.
O Fable 5.1 também difere do GPT-5.6 Sol no comportamento da API: suas restrições de forced tool-choice importam para workflows que exigem que o modelo chame uma ferramenta específica. Verifique os modos de tool_choice suportados ao migrar um loop de agente determinístico.
A questão de integração é, portanto, prática: sua aplicação pode tolerar um loop de raciocínio mais autônomo ou requer controle mais fino sobre cada etapa? Teste o comportamento exato das ferramentas antes de escolher uma rota.
Comparação de benchmarks: Fable 5.1 tem a evidência direta mais forte
Comparações de benchmark entre fornecedores concorrentes são fáceis de usar mal. As avaliações originais de lançamento do GPT-5.6 pela OpenAI são anteriores ao Fable 5.1, enquanto o lançamento do Fable 5.1 pela Anthropic contém comparações diretas mais novas com o GPT-5.6 Sol.
A forma mais limpa de ler a evidência é, portanto, em três camadas: a comparação direta da Anthropic, os testes independentes atuais e o perfil de capacidade do próprio GPT-5.6 Sol pela OpenAI.
Resultados diretos Fable 5.1 vs GPT-5.6 Sol da Anthropic
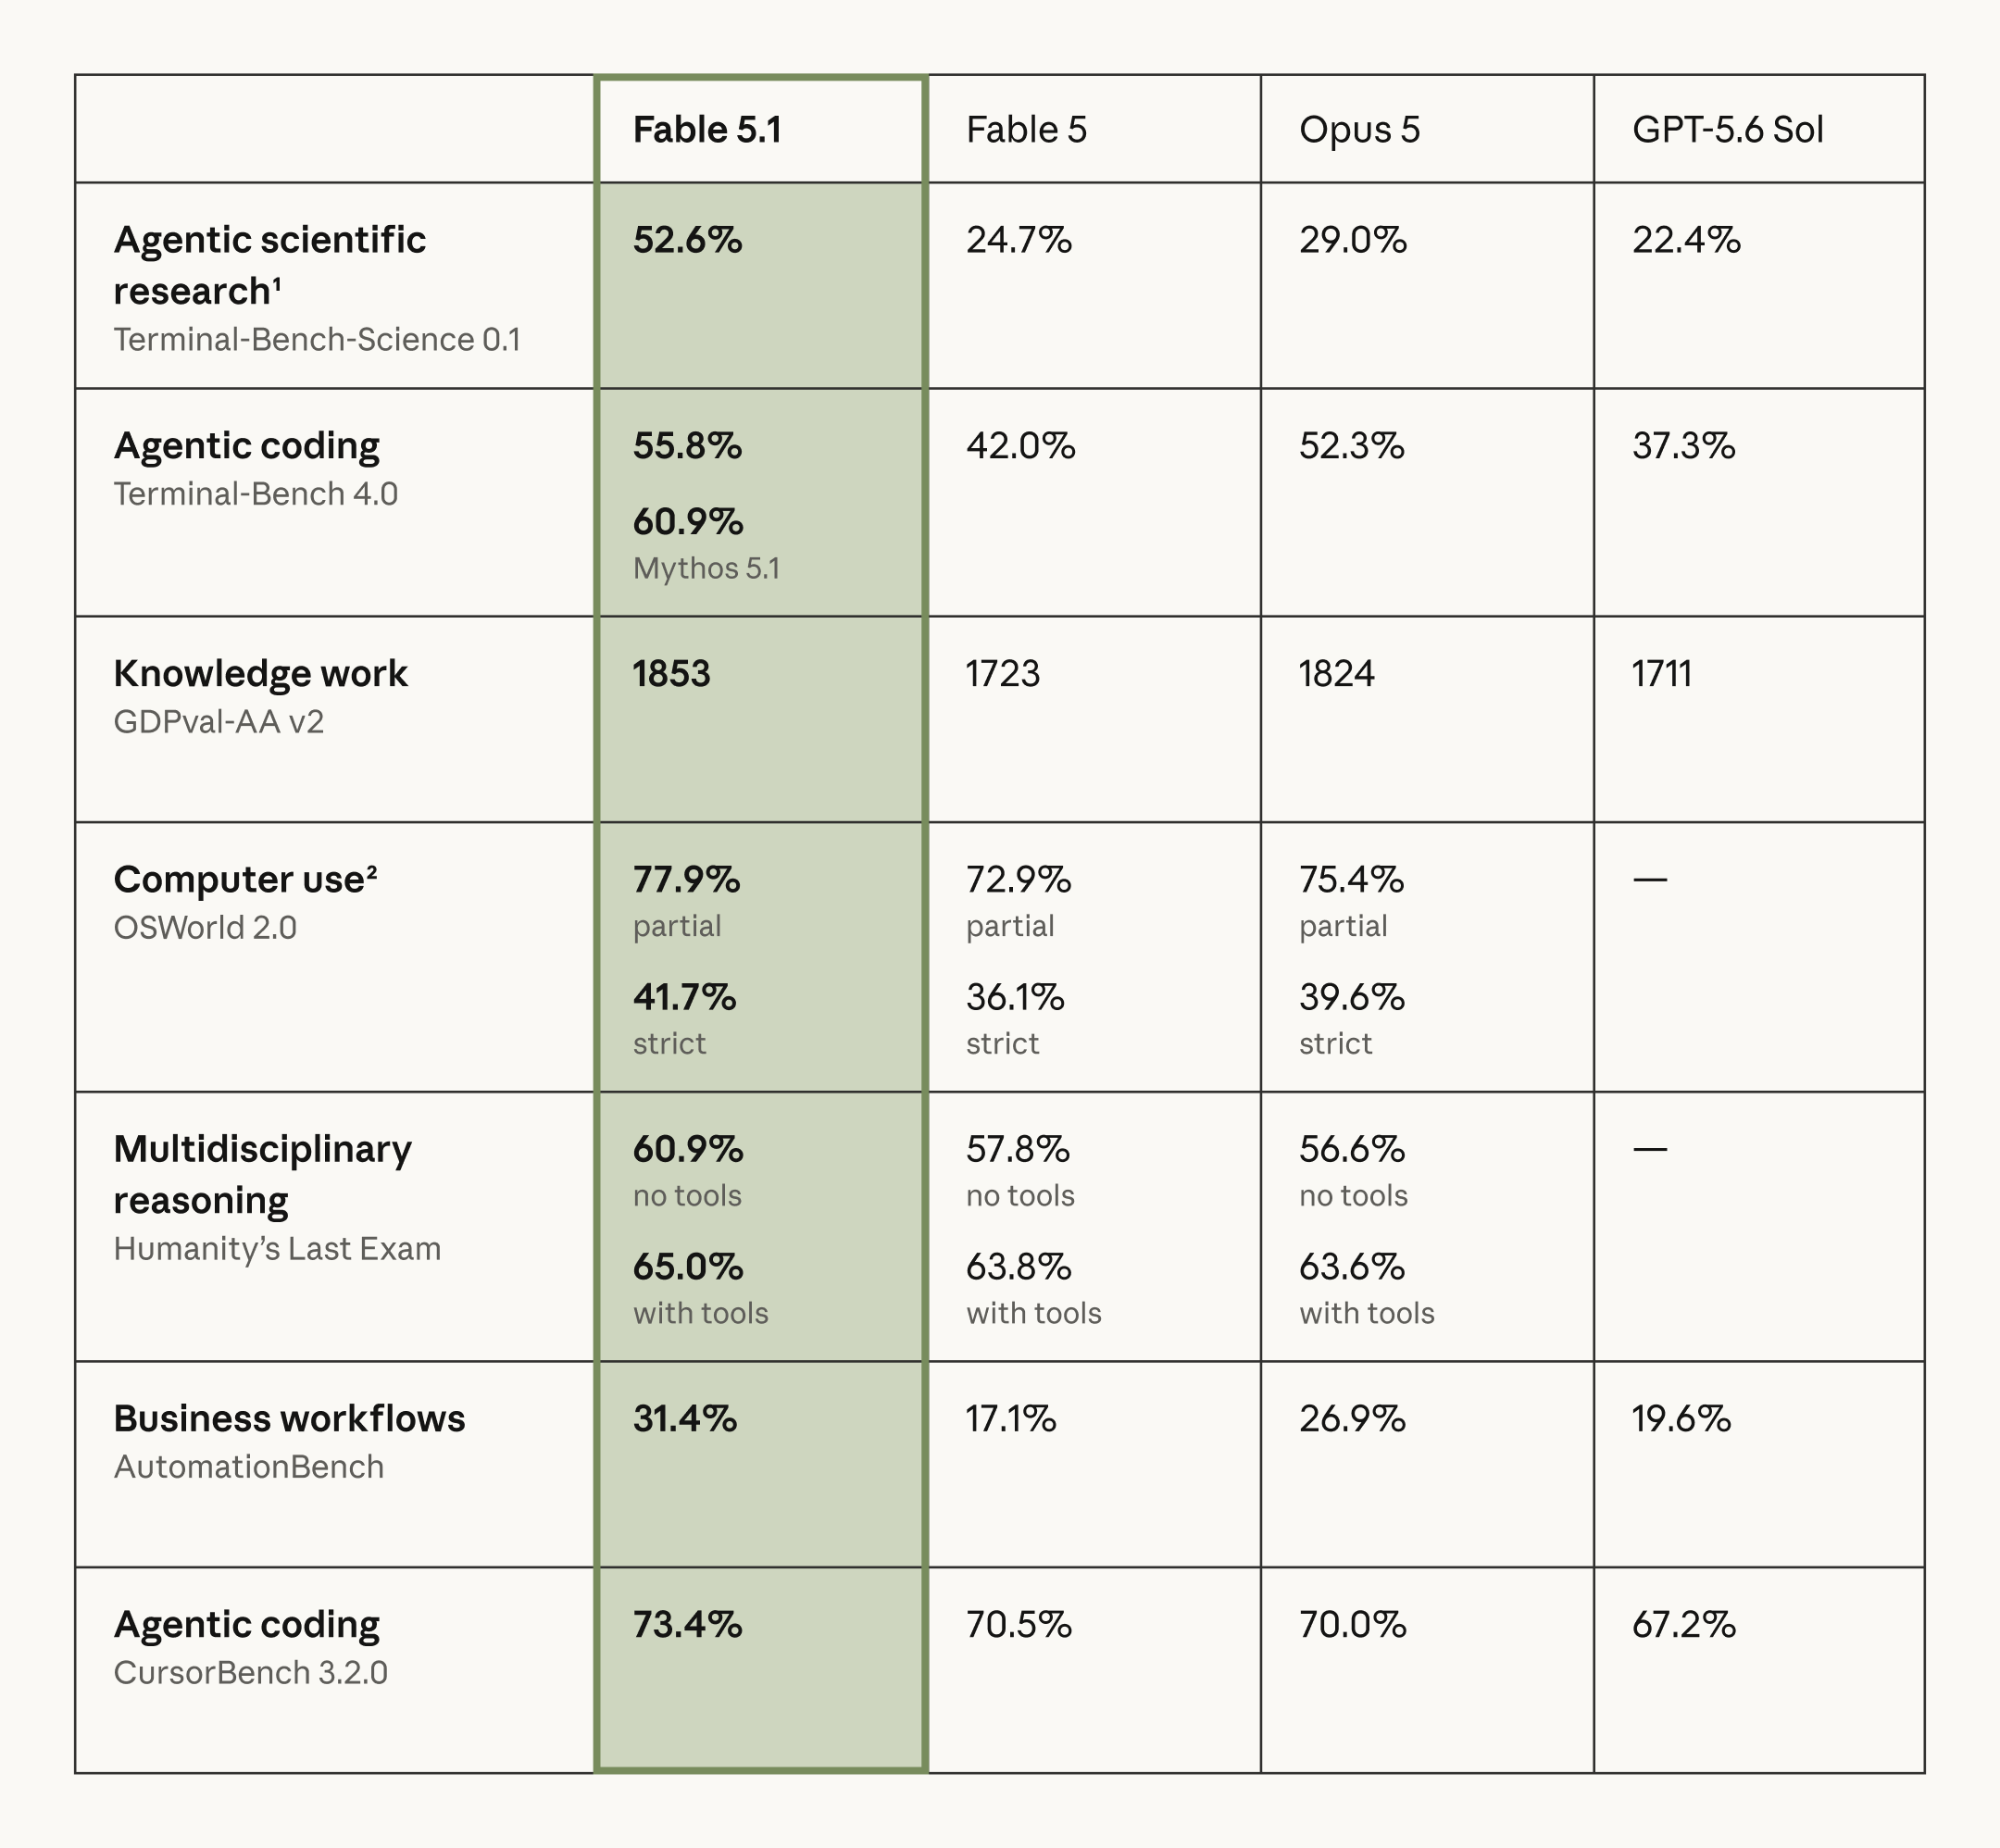
Os resultados oficiais de benchmark incluem cinco tarefas com pontuações relatadas para ambos os modelos. As diferenças em pontos percentuais e Elo abaixo são calculadas a partir desses valores publicados.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Vantagem do Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
O resultado é incomumente consistente: o Fable 5.1 supera o GPT-5.6 Sol em todas as linhas diretas publicadas pela Anthropic. As maiores diferenças aparecem em pesquisa científica agentic e codificação baseada em terminal, em vez de raciocínio curto comum.
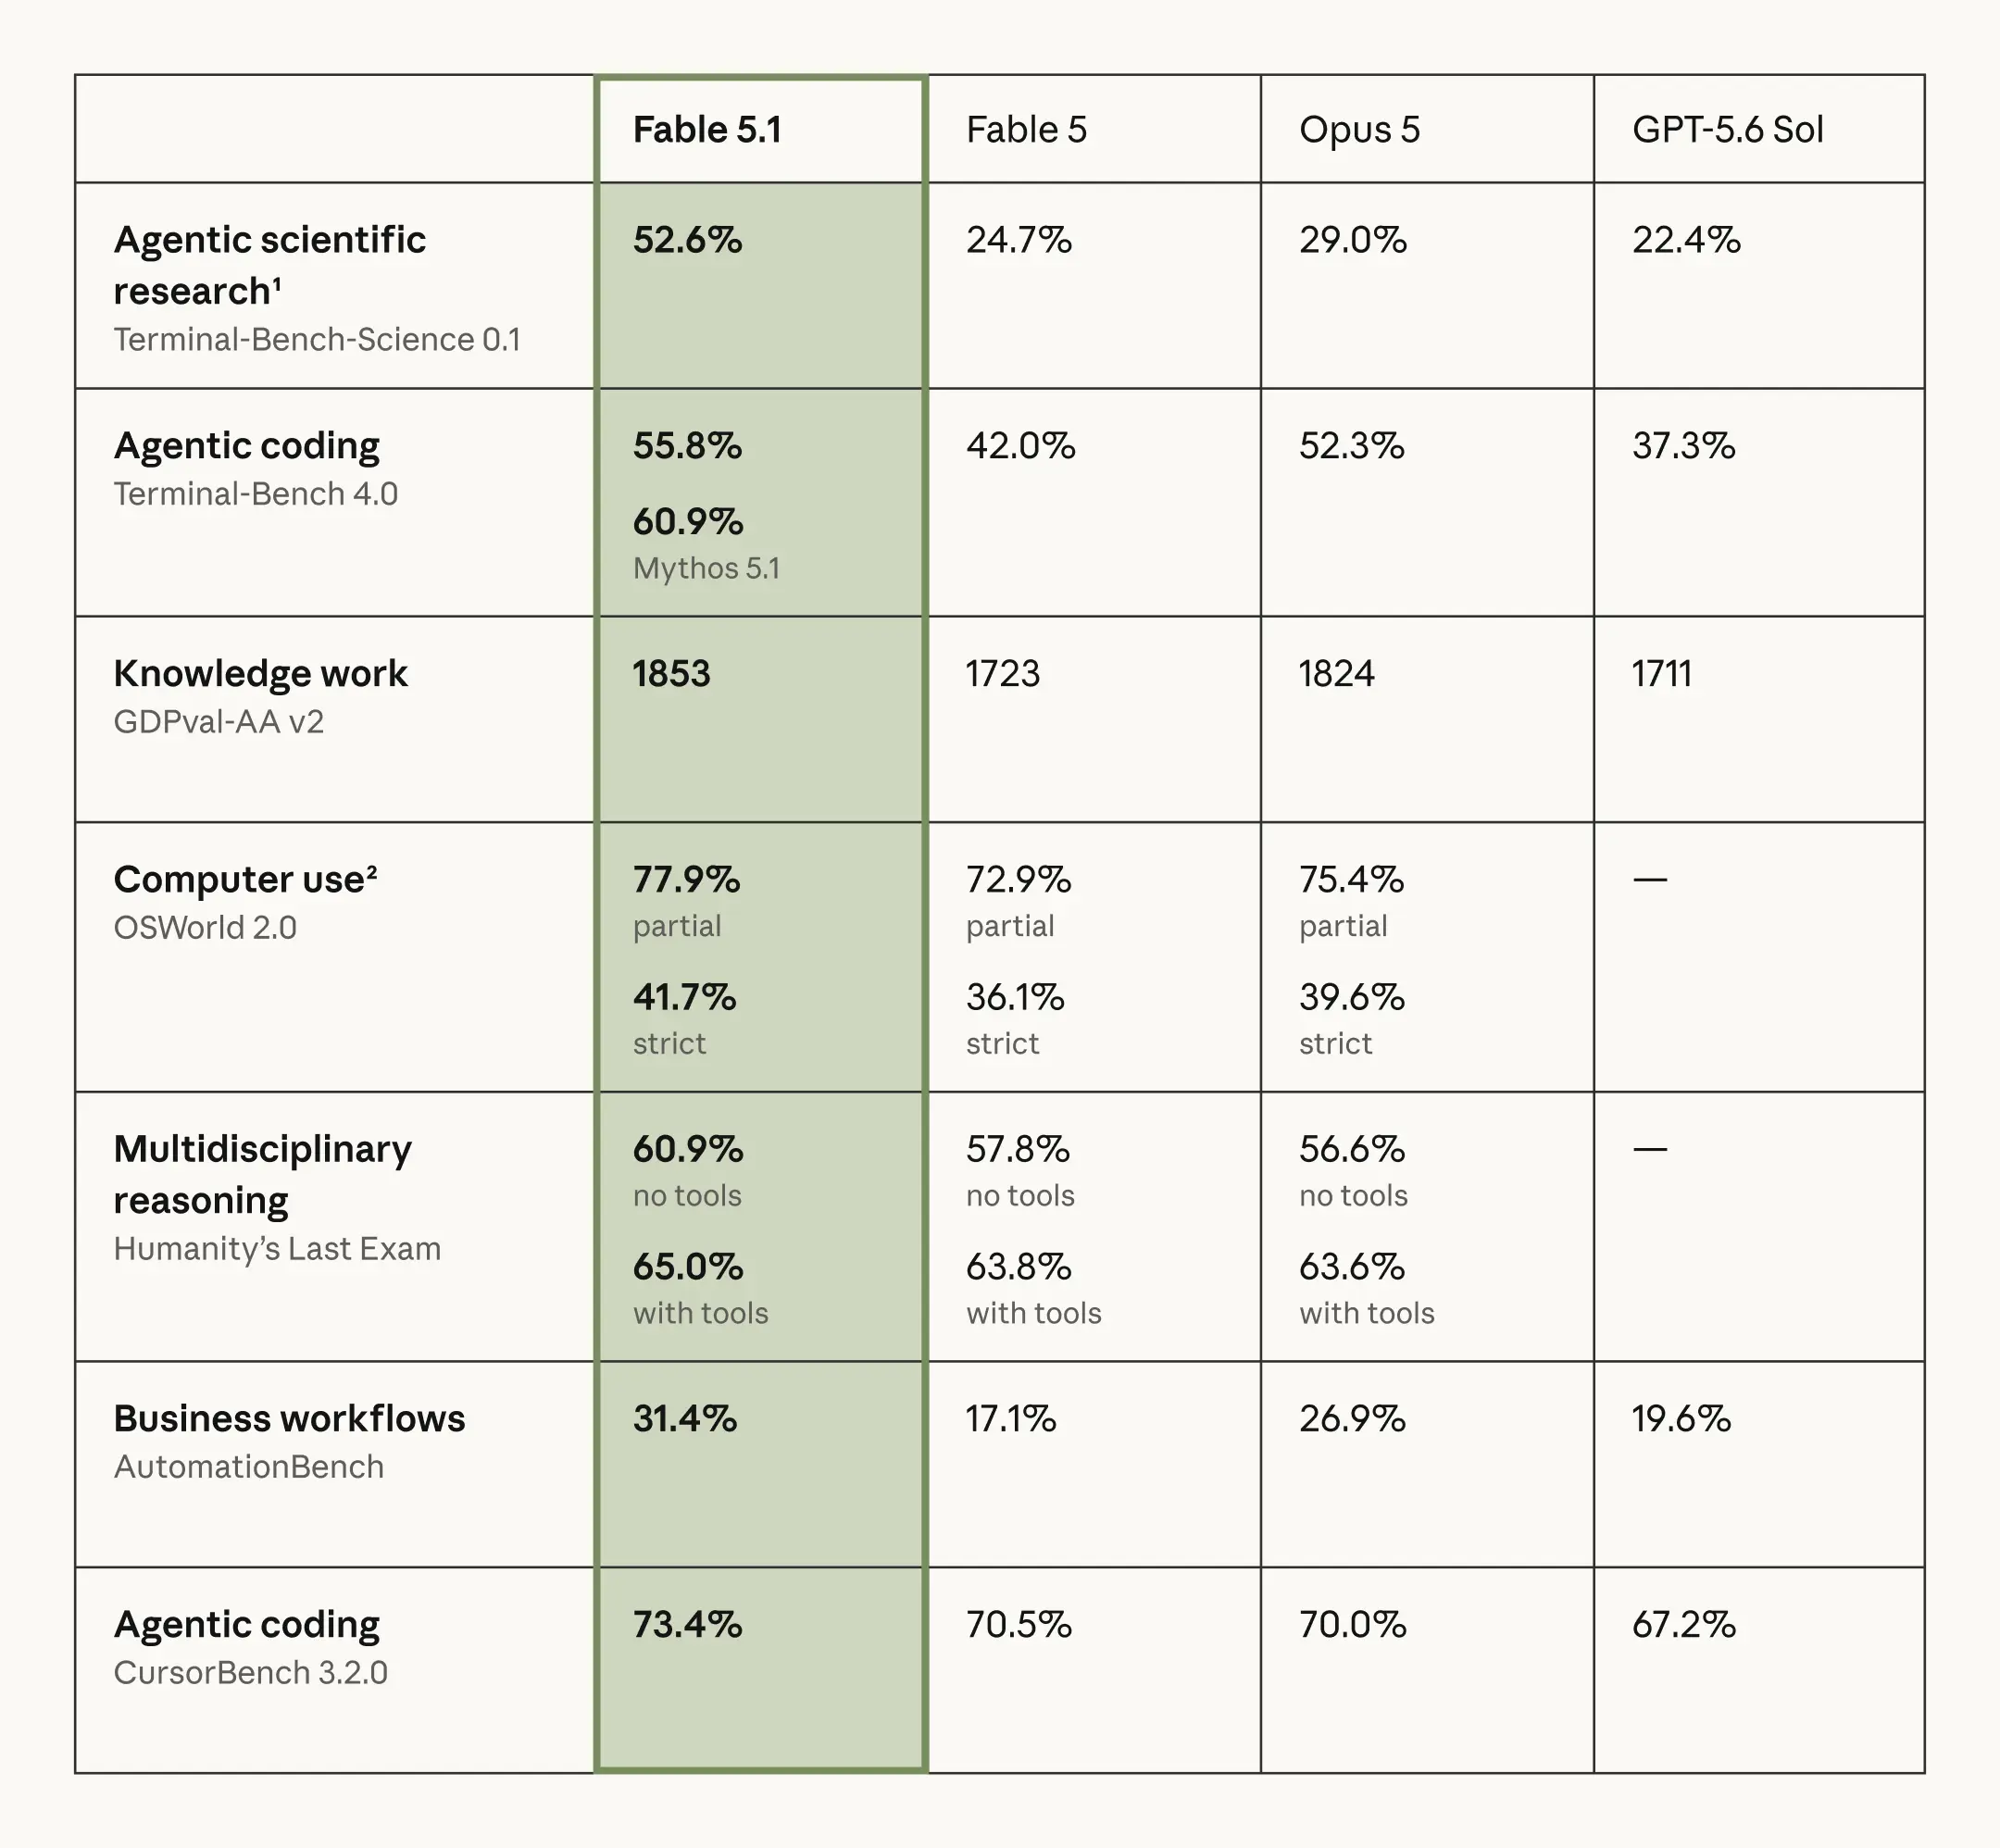
Fonte: Anthropic — gráfico de benchmark original.
São avaliações conduzidas pelo fornecedor: a Anthropic testou seu modelo e o concorrente. Elas fornecem evidência comparativa direta, mas não são testes independentes. A Anthropic relata um erro-padrão de ±3.5–4.5 pontos percentuais por modelo no Terminal-Bench-Science; a tabela acima mostra estimativas pontuais, não intervalos de confiança.
Os resultados do fornecedor favorecem o Fable 5.1, mas a evidência independente precisa de suas próprias datas e configurações.
Benchmarks independentes: separe resultados datados de medições ao vivo
A Artificial Analysis introduziu o Intelligence Index v4.3 em 7 de setembro, substituindo o Terminal-Bench 2.1 pelo Terminal-Bench 4.0 e adicionando o AutomationBench-AA. O lançamento reportou 53 para o Fable 5.1 e 47 para o GPT-5.6 Sol, correspondendo às pontuações arredondadas mostradas na comparação de 8 de setembro. A tabela distingue os resultados de terminal do lançamento dos da captura de desempenho posterior.
| Métrica independente (AA) / lançamento v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Resultado |
|---|---|---|---|
| Intelligence Index v4.3 (8 set.) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (lançamento 7 set.) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Velocidade de saída (8 set.) | 69.8 tok/s | 69.9 tok/s | Praticamente empatado |
| Tempo até o primeiro token (8 set.) | 132.10 s | 277.47 s | Sol |
| Preço normalizado do mix de tokens (AA) / MTok | $3.08 | $7.175 | Sol |
Instantâneo: 8 de setembro de 2026, exceto a linha explicitamente datada de 7 de setembro do Terminal-Bench. O Fable 5.1 usa Adaptive Reasoning, Max Effort, Default Fallback; o Sol usa max. Medições ao vivo podem mudar. O preço normalizado do mix de tokens da AA usa uma proporção de 7:2:1 de acertos de cache/entrada/saída; não é o custo de cada solicitação de API.
O OSWorld 2.0 é a maior vantagem relatada para o Sol nesta comparação: 62.6% contra 41.7% para o Fable 5.1, uma liderança de 20.9 pontos. Isso contrabalança os resultados mais fortes do Fable no Intelligence Index e no Terminal-Bench.
A evidência sustenta um trade-off específico: o Fable 5.1 tem o Intelligence Index mais alto, enquanto o Sol tem menor tempo até o primeiro token e preço normalizado mais baixo. A vazão de saída é praticamente igual. Essas medições sustentam escolhas distintas para trabalho em lote sensível à qualidade e aplicações interativas.
A comparação independente datada do Terminal-Bench aponta na mesma direção do teste da Anthropic: 52.0% contra 39.9%, comparado aos 55.8% contra 37.3% do fornecedor. As duas lacunas não são intercambiáveis porque as configurações de avaliação diferem.
O que os benchmarks da OpenAI ainda dizem sobre o GPT-5.6 Sol
As avaliações de lançamento da OpenAI fornecem contexto adicional para as capacidades do GPT-5.6 Sol. Elas são anteriores aos resultados mais novos, frente a frente, discutidos acima, então não devem ser usadas como comparação direta com o Fable 5.1.
A OpenAI relata 88.8% no Terminal-Bench 2.1 para o GPT-5.6 Sol. Isso é evidência de forte capacidade de codificação agentic na configuração de lançamento; a versão mais antiga do benchmark não deve ser comparada numericamente com as pontuações do Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 para codificação
Para geração de código direta, ambos os modelos são mais do que qualificados para muitos workloads de produção. A separação fica mais clara quando a codificação se torna engenharia de software agentic: inspecionar um repositório grande, editar múltiplos arquivos, executar comandos, diagnosticar falhas, escrever testes e iterar até a tarefa passar.
Aqui, o Claude Fable 5.1 tem o caso de benchmark atual mais forte. Ele lidera tanto as comparações do Terminal-Bench 4.0 conduzidas pelo fornecedor quanto as independentes, e o resultado do CursorBench da Anthropic também o favorece, 73.4% contra 67.2%.
Para uma avaliação prática de codificação, inclua mudanças em todo o repositório, testes, revisão e desempenho. Um snippet de código curto bem-sucedido é um proxy fraco para concluir uma tarefa que abrange vários arquivos e tentativas com falha.
O GPT-5.6 Sol continua atraente quando o ambiente de execução ao redor importa tanto quanto a qualidade bruta do modelo. Suporte nativo para shell execution, apply-patch, code interpreter, file search, computer use e MCP pode reduzir a quantidade de infraestrutura de orquestração que você precisa construir.
Veredito para codificação: escolha o Fable 5.1 quando suas avaliações enfatizarem o trabalho autônomo mais difícil em repositórios. Escolha o GPT-5.6 Sol quando uma capacidade ligeiramente menor em benchmarks for aceitável em troca de menor custo e um amplo stack de execução integrado.
Controles de raciocínio e experiência do desenvolvedor
As duas APIs expõem a inteligência de forma diferente.
A faixa de raciocínio de none a max do Sol permite que uma equipe teste qualidade e latência em vários ajustes. Esforço menor pode reduzir o trabalho de raciocínio, mas a configuração certa depende do custo da falha da tarefa.
O pensamento adaptativo sempre ativo do Fable torna a calibração de esforço um exercício diferente. Compare configurações que sua aplicação realmente implantará em vez de tratar rótulos idênticos de esforço como orçamentos de computação idênticos.
Consequentemente, não há comparação universalmente justa entre “Sol padrão” e “Fable padrão”. Suas configurações padrão de raciocínio diferem. Avaliações de produção devem comparar ou orçamentos de esforço equivalentes ou as configurações exatas que sua aplicação realmente usará.
GPT-5.6 Sol vs Fable 5.1: qual é melhor para agentes de IA?
A escolha depende de o gargalo ser um raciocínio difícil ou o runtime que o cerca.
A liderança do Fable nos benchmarks citados de terminal, automação e trabalho profissional o torna um candidato sensato para as tarefas mais difíceis. Meça a taxa de conclusão e a recuperação de etapas com falha antes de generalizar essa liderança para seu agente.
O portfólio de ferramentas do Responses documentado do GPT-5.6 Sol o torna atraente para aplicações construídas em torno de search, files, shell execution e patches. Essa é uma vantagem de integração a avaliar junto com a acurácia da tarefa, não um substituto para ela.
| Requisito do agente | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Raciocínio difícil de longo horizonte | Excelente | Melhor ajuste |
| Autonomia em terminal/repositório | Excelente | Evidência mais forte |
| Portfólio de ferramentas nativas | Mais forte | Forte |
| Seleção forçada de ferramenta | Suportado; verifique a API | Restrito; verifique modos de tool_choice |
| Integração de plataforma multiagente | Vantagem forte | Disponível via arquitetura de agentes |
| Comunicação de progresso em tarefas longas | Boa | Comportamento central |
| Agentes de alto volume sensíveis a custo | Melhor | Premium |
| Contexto massivo repetido em cache | Bom | Potencialmente muito atraente |
Usar ambos pode ser econômico quando apenas uma pequena parcela das tarefas precisa de escalonamento. Meça se as conclusões extras bem-sucedidas compensam o preço mais alto e a latência inicial do segundo modelo.
Contexto longo: 1.05M vs 1M não é a diferença importante
Os números em destaque parecem quase idênticos: o GPT-5.6 Sol oferece 1.05M tokens e o Fable oferece 1M. Uma diferença de capacidade de 5% dificilmente determinará se você pode analisar um repositório grande, corpus jurídico, acervo de pesquisa ou histórico de agente de várias horas. Ambos já estão na classe de um milhão de tokens.
No GPT-5.6 Sol, entrada acima de 272K aciona tarifas mais altas para contexto longo para a solicitação: $8/MTok de entrada, $0.80/MTok de entrada em cache e $30/MTok de saída. Gravações de cache também sobem de $5 para $10/MTok.
O Fable 5.1 mantém suas tarifas padrão de contexto de 1M: $10/MTok de entrada, $50/MTok de saída e $0.25/MTok em leituras de cache. Não há prêmio separado acima de 272K nesta configuração documentada.
Considere uma rodada com 100K tokens de entrada não em cache, 900K tokens de leitura de cache e 20K tokens totais de saída faturada. O GPT-5.6 Sol custa 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. O Fable 5.1 custa 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Essa rodada pesada em cache quase fecha a diferença de preço porque o Fable tem leituras de cache mais baratas. O resultado depende do mix de tokens do workload; isso não significa que os dois modelos custem o mesmo para uma sessão completa de agente.
Suposições de custo: o prefixo de 900K tokens já está em cache, e a entrada de 100K nova não é cobrada como nova gravação de cache. A estimativa exclui a gravação inicial de cache e taxas de ferramentas. A cota de 20K de saída inclui toda a saída faturada, incluindo quaisquer tokens de raciocínio faturados.
Preços: Sol vence workloads comuns, Fable vence uma métrica importante de cache
Nas tarifas verificadas, o Sol custa $4 entrada / $20 saída por MTok, com $0.40 em leituras de cache. O Fable 5.1 custa $10 de entrada, $50 de saída e $0.25 em leituras de cache. A tabela separa preços do provedor dos preços do GPT-5.6 Sol na CometAPI e do Claude Fable 5.1 na CometAPI.
| Componente de preço | Preços oficiais GPT-5.6 Sol | Preços oficiais Claude Fable 5.1 |
|---|---|---|
| Entrada oficial / MTok | $4.00 | $10.00 |
| Saída oficial / MTok | $20.00 | $50.00 |
| Leitura oficial de cache / MTok | $0.40 | $0.25 |
| Gravação oficial de cache / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| Acima de 272K de entrada: entrada / leitura / gravação / saída | $8 / $0.80 / $10 / $30 | Mesmas tarifas base documentadas |
| Entrada na CometAPI / MTok | $3.20 | $8.00 |
| Saída na CometAPI / MTok | $16.00 | $40.00 |
As durações de gravação de cache diferem: o Sol usa um período de retenção padrão de 30 minutos, enquanto a tarifa mostrada do Fable 5.1 é para uma gravação de 5 minutos. Verifique criação, atualização e expiração do cache para o provedor e rota que você realmente usa.
Nas tarifas diretas do fornecedor verificadas, o Fable 5.1 custa 2.5× mais que o Sol tanto para entrada não em cache ($10 vs $4/MTok) quanto para saída ($50 vs $20/MTok). Trate essas tarifas verificadas como comparação datada, pois promoções de fornecedor e preços de gateways podem mudar.
Uma solicitação de contexto curto com 100K de entrada e 10K de saída total faturada custa cerca de $0.60 com o Sol ou $1.50 com o Fable nas tarifas diretas do fornecedor. Nas tarifas da CometAPI mostradas acima, o mesmo mix custa $0.48 ou $1.20. Esses exemplos excluem gravações de cache e taxas de ferramentas.
A taxa de leitura de cache de contexto curto do Fable é 37.5% menor: ($0.40 − $0.25) ÷ $0.40. Isso pode importar para agentes que reutilizam um grande prefixo estável, mas a economia total ainda depende de entrada nova, frequência de gravação e volume de saída.
Veredito de preços: o Sol é o ponto de partida mais barato para tráfego de contexto novo. O Fable torna-se mais competitivo conforme a parcela de leituras de cache cresce; compare o custo da sessão inteira, incluindo criação e atualização do cache.
Velocidade e latência
Testes em esforço máximo podem gastar tempo substancial raciocinando antes do primeiro token visível.
As medições de vazão e latência de 8 de setembro mostram 69.9 tokens/s de saída para o Fable e 69.8 para o Sol. O tempo até o primeiro token é 277.47 segundos contra 132.10 segundos. A vazão de saída é praticamente igual; o Sol começa a produzir saída visível antes nessa configuração.
São medições de benchmark em esforço máximo, não latência prometida para toda chamada de API. Tamanho do prompt, configuração de raciocínio, carga do provedor, ferramentas e estado do cache podem mudar o resultado. Tempo até o primeiro token e tempo total de resposta são métricas diferentes.
Para trabalho interativo, a menor latência inicial observada pode favorecer o Sol. Para pesquisa assíncrona ou trabalho em repositório durante a noite, a conclusão bem-sucedida pode importar mais do que esperar pelo primeiro token. Faça benchmark de ambos os modelos nos ajustes e concorrência que você pretende usar.
Salvaguardas são uma diferença em produção
Ambos os modelos aplicam salvaguardas mais fortes porque suas capacidades se estendem a domínios sensíveis de cibersegurança e ciência, mas as implementam de forma diferente.
A OpenAI descreve proteções em camadas e monitoramento para a família GPT-5.6. Aplicações em domínios sensíveis devem avaliar as salvaguardas relevantes como parte do comportamento de implantação.
Os termos de redirecionamento e retenção da Anthropic descrevem o roteamento de algumas solicitações sensíveis de cibersegurança ou biologia para modelos menos capazes, sem cobrar a tarifa do Fable para essas solicitações redirecionadas. O período padrão de retenção de dados é de 30 dias, com exceções para acordos empresariais elegíveis.
Para codificação e trabalho de conhecimento comuns, essas diferenças podem nunca aparecer. Para produtos de segurança, workloads regulados ou implantações sensíveis à privacidade, elas pertencem ao checklist de avaliação ao lado de qualidade de benchmark e preço.
Qual modelo você deve escolher?
A comparação geral pode ser reduzida ao formato do workload.
| Workload | GPT-5.6 Sol | Claude Fable 5.1 | Recomendação |
|---|---|---|---|
| Codificação autônoma difícil | Excelente | Benchmarks atuais mais fortes | Fable 5.1 |
| Pesquisa de longo horizonte | Excelente | Ponto forte | Fable 5.1 |
| API de fronteira de alto volume | Muito mais barato | Caro | Sol |
| Assistente de código interativo | TTFT medido menor em esforço máximo | TTFT medido maior em esforço máximo | Teste os ajustes em produção |
| Agente de API intensivo em ferramentas | Stack nativo mais amplo | Forte | Sol |
| Agente com um milhão de tokens em cache | Competitivo | Preço de leitura de cache muito baixo | Teste ambos |
| Qualidade máxima de raciocínio | Excelente | Liderança independente | Fable 5.1 |
| Custo por solicitação comum | Vantagem clara | Premium | Sol |
| Raciocínio com imagem/documento | Forte | Forte | Teste no workload |
| Stack OpenAI de provedor único | Ajuste natural | Requer migração/gateway | Sol |
| Roteamento independente de modelo | Forte | Forte | Use ambos via CometAPI |
Uma política de roteamento deve justificar sua complexidade. Compare uma baseline de modelo único com uma política Sol-first que escala tarefas difíceis para o Fable 5.1, e mantenha o roteador apenas se ele melhorar o custo por tarefa bem-sucedida na qualidade exigida.
Como comparar GPT-5.6 Sol e Fable 5.1 via CometAPI
A CometAPI já integra o GPT-5.6 Sol e o Claude Fable 5.1. Acesse ambos os modelos com seus formatos nativos de solicitação, envie o mesmo conjunto de avaliação e compare os resultados retornados em configurações correspondentes.
Use solicitações em formato nativo para cada modelo e mantenha constantes prompts, datasets, ajustes de esforço, concorrência e regras de pontuação. Repita as execuções; uma única solicitação sequencial por modelo não basta para estimar latência ou qualidade de forma confiável.
Para uma avaliação de produção, use um conjunto de prompts fixo, repita as execuções em ordem alternada, registre o ajuste de esforço e pontue correção, taxa de aprovação de testes, sucesso de ferramentas, tentativas, uso de tokens, tempo decorrido e custo total por tarefa bem-sucedida. Ajuste cada modelo separadamente após a baseline comum.
Veredito final: GPT-5.6 Sol ou Claude Fable 5.1?
O Fable 5.1 tem a evidência direta mais forte para a codificação autônoma mais difícil e trabalho de longo horizonte. Ele lidera as cinco linhas compartilhadas do benchmark do fornecedor e a comparação independente de terminal datada. Isso o torna um forte candidato para escalonamento, sujeito à validação em suas próprias tarefas.
O Sol tem preços de tokens usuais mais baixos, controles de raciocínio mais granulares e um amplo stack de ferramentas nativas. Na configuração independente verificada em esforço máximo, ele também tem menor tempo até o primeiro token; a vazão de saída é praticamente igual.
Priorize o Fable 5.1 quando as tarefas autônomas mais difíceis determinarem sua taxa de sucesso. Comece com o Sol para inferência de fronteira consciente de custos ou aplicações intensivas em ferramentas. Para workloads interativos, teste os ajustes de esforço implantados para confirmar se a vantagem observada de latência inicial persiste.
Escolha um único modelo quando ele atender aos seus requisitos de forma simples. Adicione roteamento quando os resultados de avaliação mostrarem que alternar entre os dois melhora a qualidade ou o custo por tarefa bem-sucedida.
Perguntas frequentes
O Claude Fable 5.1 é melhor do que o GPT-5.6 Sol?
Ele tem o Intelligence Index independente mais alto no instantâneo de 8 de setembro: 53, contra 47 do Sol. Ele também lidera o teste de terminal independente datado. Isso sustenta uma vantagem de qualidade nessas avaliações, não a afirmação de que ele é melhor para todo workload.
O GPT-5.6 Sol é mais barato que o Claude Fable 5.1?
Para tráfego comum de API sem cache, sim: as tarifas diretas verificadas de entrada/saída são $4/$20 por MTok para o Sol e $10/$50 para o Fable 5.1. Workloads pesados em cache podem reduzir essa diferença porque a taxa de leitura de cache do Fable é menor. Inclua comportamento de gravação e expiração na estimativa.
Qual modelo é melhor para codificação?
O Fable 5.1 tem evidência de benchmark mais forte para codificação autônoma nesta comparação. O Sol continua atraente para workflows de menor custo e por suas ferramentas de execução integradas. Use tarefas em repositórios com testes executáveis para decidir se a diferença medida de capacidade importa para sua aplicação.
Qual modelo tem a janela de contexto maior?
O Sol tecnicamente lidera com 1.05M versus 1M tokens do Fable 5.1, enquanto ambos permitem até 128K de saída. Na prática, o limiar de preços >272K do Sol e as leituras de cache baratas do Fable costumam ser mais importantes do que a diferença de 50K tokens em capacidade.
Posso acessar ambos os modelos via CometAPI?
Sim. A API do GPT-5.6 Sol na CometAPI e a API do Claude Fable 5.1 na CometAPI oferecem um ponto de partida comum para avaliações de texto. Verifique suporte específico de rota para raciocínio, cache e ferramentas antes de estender a baseline para um agente de produção.