Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Benchmarks, Recursos, Preços
Compare o GPT-6.1 Terra e o DeepSeek V4.1 Flash quanto a benchmarks, programação, visão, contexto, preços da API e acesso ao CometAPI, para determinar qual é melhor.
TL;DR: O GPT-6.1 Terra é o ponto de partida mais robusto quando a qualidade de raciocínio e fluxos visuais complexos são o que mais importa; o DeepSeek V4.1 Flash é atraente quando o custo por token, a velocidade de geração ou a auto-hospedagem têm prioridade. Esta comparação usa a atualização de 17 de outubro do DeepSeek, Flash-1017.
O DeepSeek Flash-1017 tem preços de tokens mais baixos, mas o custo de uma tarefa concluída também depende do tamanho do raciocínio, de novas tentativas e de chamadas de ferramentas.
A comparação abaixo abrange arquitetura, contexto, raciocínio, programação, visão, velocidade, preços e implantação. Os preços e as páginas de avaliação em tempo real foram verificados em 28 de outubro de 2026.
Principais pontos
O Terra lidera a comparação independente do Intelligence Index citada, tornando-o um primeiro candidato lógico para tarefas exigentes de raciocínio.
O DeepSeek tem preços listados de tokens mais baixos. Compare a latência ponta a ponta e o custo por tarefa bem-sucedida, incluindo tarifas em horários de pico, uso de cache, tokens de raciocínio e novas tentativas.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Avalie programação pelos patches aceitos e fluxos visuais pelas tarefas concluídas. Pontuações de benchmarks publicados fornecem evidências úteis, mas as configurações de teste diferem.
O Terra é um modelo proprietário hospedado. O DeepSeek oferece pesos baixáveis licenciados sob MIT para auto-hospedagem, com custos de hardware e operação a considerar.
A CometAPI fornece uma interface de texto compartilhada para testar ambos os modelos. Verifique a versão do modelo efetivamente servida e o suporte a ferramentas, controles de raciocínio e saída estruturada antes de implantar.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Visão geral e especificações
As principais diferenças de especificações dizem respeito a limites de saída, controles de raciocínio, chamadas de ferramentas e implantação. A tabela abaixo resume os dois modelos.
Arquitetura proprietária; contagem de parâmetros não divulgada
552B MoE de Codificador–Decodificador Causal; aproximadamente 8B de parâmetros ativos para entrada e 16B para saída
Janela de contexto
1,050,000 tokens
1M tokens
Saída máxima
128,000 tokens
384K tokens
Modalidades de entrada
Texto, imagens
Texto, imagens
Modalidades de saída
Texto
Texto
Controles de raciocínio
none, low, medium, high, xhigh, max
Thinking toggle; low, high, max em Chat Completions
Chamadas de ferramentas
Suportado por meio da Responses API
Suportado; o comportamento depende do endpoint e do modo thinking
Pesos abertos
Não
Sim, licença MIT
Arquitetura e versões do modelo
O Terra usa uma arquitetura proprietária cuja contagem de parâmetros não é divulgada publicamente. O DeepSeek-V4.1-Flash usa uma arquitetura MoE de Codificador–Decodificador Causal, com orçamentos de parâmetros ativos diferentes para processamento de entrada e geração de saída.
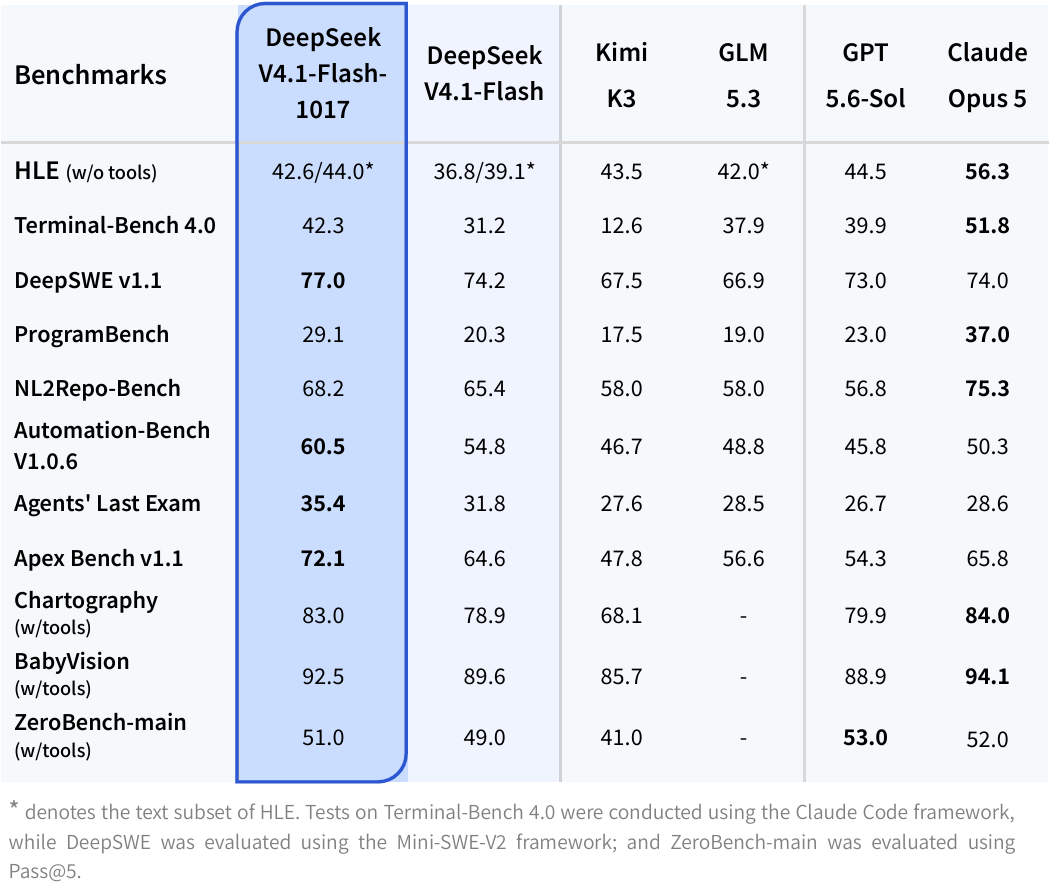
A versão V4.1 Flash do DeepSeek descreve um backbone MoE de Codificador–Decodificador Causal com 552B parâmetros, com cerca de 8B de parâmetros ativos durante o processamento de entrada e 16B durante a geração de saída. A atualização de 17 de outubro melhora seus resultados publicados em codificação, agentes e visão.
Ao longo deste artigo, Flash-1017 significa aquele checkpoint de outubro. Um alias genérico de API pode posteriormente apontar para outra versão, portanto um registro de avaliação deve incluir a versão do modelo efetivamente servida.
Cache KV e requisitos de implantação
O DeepSeek informa uma pegada global de cache KV de aproximadamente 890 bytes por token, cerca de um quarto da do DeepSeek-V4-Flash. Isso melhora a eficiência do cache, embora a auto-hospedagem ainda exija recursos substanciais para os pesos do modelo. O Terra está disponível por serviços hospedados, enquanto os pesos baixáveis do DeepSeek fornecem uma opção adicional de auto-hospedagem.
Controles de raciocínio e chamadas de ferramentas
Ambos os modelos suportam fluxos de trabalho com agentes, mas os controles de raciocínio e os requisitos de chamadas de ferramentas diferem. O suporte a chamadas de ferramentas do Terra documentado usa a Responses API. A ficha do modelo do DeepSeek descreve um esforço de raciocínio numérico de 1 a 100; os controles da API hospedada devem ser verificados separadamente. Ao alternar modelos, adapte os parâmetros de raciocínio e as definições de ferramentas ao endpoint selecionado.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Desempenho
A comparação abaixo abrange tarefas de raciocínio, programação, visão e contexto longo. Avaliações independentes e benchmarks relatados pelos fornecedores são identificados separadamente, com resultados interpretados juntamente com suas configurações de modelo e frameworks de agente.
Raciocínio e conhecimento
A Artificial Analysis relata uma pontuação de 51 no Intelligence Index v5.0 para GPT-6.1 Terra (Max) e de 32 para DeepSeek Flash-1017 (Max) nas configurações citadas, em 28 de outubro de 2026. O índice combina nove avaliações.
A pontuação agregada mais alta do Terra sustenta testá-lo primeiro para tarefas exigentes de raciocínio. Para cargas de trabalho mais estreitas, o DeepSeek ainda pode ser a melhor escolha se atender à precisão exigida a um custo menor por tarefa bem-sucedida.
Benchmarks oficiais de programação e agentes
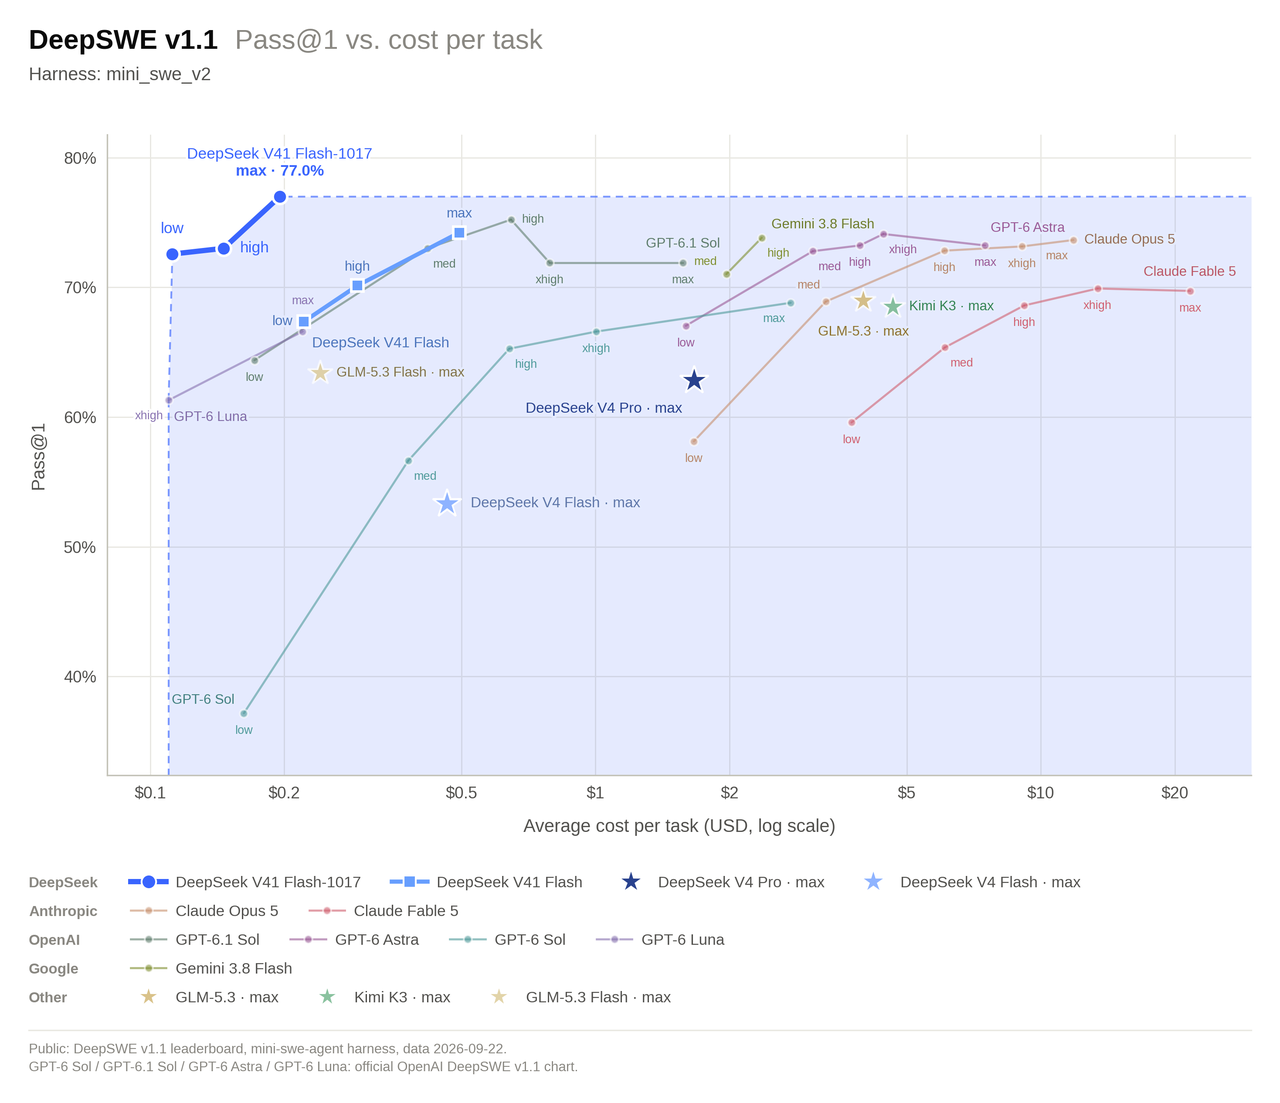
Terminal-Bench 4.0 e DeepSWE v1.1 fornecem evidências sobre desempenho em programação e agentes. Ao comparar resultados dos fornecedores, identifique a versão exata do modelo, a configuração de raciocínio, o framework de agente e a métrica de pontuação; diferenças nessas configurações podem afetar materialmente as pontuações.
Para trabalho prático de programação, compare se cada modelo produz patches que passam nos testes existentes, preservam interfaces públicas, lidam com casos extremos e evitam mudanças não relacionadas. A confiabilidade das chamadas de ferramentas e a recuperação de erros de execução também afetam quanto trabalho um agente consegue concluir.
Os preços listados mais baixos de tokens do DeepSeek o tornam um candidato útil para manutenção repetitiva de repositórios com critérios de aceitação claros. Para mudanças complexas, compare ambos os modelos pelos patches aceitos, custo total da tarefa e tempo de correção humana.
Visão e uso de computador
Ambos os modelos aceitam entradas de imagem, mas compreensão de imagem e interação com desktop exigem capacidades diferentes. O material de lançamento do Terra da OpenAI discute MMMU-Pro e OSWorld 2.1, enquanto a ficha do modelo do DeepSeek relata tarefas visuais incluindo Chartography e BabyVision, com configurações assistidas por ferramentas.
Para extração de documentos, compare a precisão de campos, textos perdidos e a estrutura de tabelas. Para automação de desktop, compare fluxos concluídos, ações incorretas e recuperação após mudanças na interface. Um modelo que descreve uma captura de tela com precisão ainda pode ter dificuldade para operar o aplicativo que ela mostra.
Escolha de acordo com o fluxo: a precisão de extração é o que mais importa no processamento de documentos, enquanto ações confiáveis e recuperação importam mais para agentes de uso de computador. Compare o custo apenas depois que ambos atenderem ao limiar de qualidade exigido.
Raciocínio e recuperação com contexto longo
Ambos os modelos suportam fluxos com documentos longos, mas a capacidade de contexto por si só não determina a qualidade de recuperação. Compare-os na mesma coleção de documentos, colocando evidências importantes perto do início, meio e fim.
Avalie a precisão das respostas, trechos de apoio, consistência entre documentos e a completude das respostas. Para pesquisa e análise de documentos, prefira o modelo que recupera e conecta de forma confiável as evidências relevantes dentro dos seus requisitos de latência e custo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Velocidade
Vazão de saída e tempo de conclusão da tarefa
A latência merece tratamento separado da qualidade de raciocínio.
Nas páginas da Artificial Analysis de 28 de outubro, a velocidade de saída do Flash-1017 (Max) é de 173.4 tokens por segundo, enquanto a velocidade de saída do Terra (Max) é de 90.9. Essas medições descrevem as configurações servidas pelo avaliador, não taxas garantidas em todos os provedores.
Um modelo que gera tokens mais rapidamente ainda pode demorar mais para terminar se produzir mais raciocínio, aguardar ferramentas ou refazer tentativas. Meça separadamente o tempo até o primeiro token, o tempo total de conclusão e a latência de tarefas aceitas.
Latência interativa na sua rota de API
Para um produto interativo, teste prompts curtos e longos com concorrência realista e registre a latência mediana e no 95º percentil. Mantenha região, rota de API, cache de prompt, configurações de raciocínio e política de repetição nos resultados. Esse registro dirá mais sobre a experiência do usuário do que um único número de tokens por segundo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Custo
Preços são uma das diferenças mais claras entre esses modelos.
A tabela de preços do Terra e a política de preços do DeepSeek indicam as seguintes tarifas de primeira parte conforme verificado em 28 de outubro de 2026. Todos os preços são em dólares americanos por milhão de tokens.
Tarifas oficiais de API
Categoria de tokens
GPT-6.1 Terra Standard
DeepSeek Flash fora do pico
DeepSeek Flash no pico
Entrada, cache miss
$1.00
$0.15
$0.30
Entrada, cache hit
$0.05
$0.003
$0.006
Saída
$5.00
$0.60
$1.20
A precificação de pico do DeepSeek aplica-se de segunda–sexta, 01:00–04:00 e 06:00–10:00 UTC, excluindo feriados públicos chineses. Isso corresponde a 09:00–12:00 e 14:00–18:00 no horário padrão da China (UTC+8). Outros períodos usam as tarifas fora do pico.
Para solicitações do Terra acima de 272.000 tokens de entrada, a OpenAI especifica 2× nas tarifas de entrada e de entrada em cache e 1,5× nas tarifas de saída para toda a solicitação. Compare essas condições com os tamanhos reais dos seus prompts antes de tratar o preço base como o preço efetivo.
Tarifas da CometAPI
Tarifa base da CometAPI por 1M de tokens
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Entrada sem cache
$0.80
$0.12
Saída
$4.00
$0.48
Entrada em cache
Não especificado separadamente
$0.0024
Multiplicador baseado no tempo
Não especificado na precificação base
2× durante as janelas de pico listadas
A CometAPI lista as janelas de pico como segunda–sexta, 01:00–04:00 e 06:00–10:00 UTC. Sua programação listada não estabelece a mesma exceção de feriados que a política de primeira parte do DeepSeek. Verifique os termos de cobrança da rota selecionada para o horário pretendido de execução.
Exemplo de custo com tokens fixos
Considere uma solicitação que consome 100,000 tokens de entrada sem cache e gera 10,000 tokens de saída.
Se esses forem os totais completos de tokens faturados, a cobrança por tokens é de $0.150 para o Terra, $0.021 para o DeepSeek fora do pico ou $0.042 para o DeepSeek no pico. A redução fora do pico é de 86%. O exemplo exclui taxas adicionais de ferramentas, infraestrutura e novas tentativas; quaisquer tokens de raciocínio contados separadamente também devem entrar no cálculo.
Nas tarifas base listadas da CometAPI, os mesmos 100,000 de entrada e 10,000 de saída custam $0.120 para o Terra ou $0.0168 para o Flash. Aplicando o multiplicador de pico de 2× listado dá $0.0336 para o Flash. Esses são cálculos apenas de tokens usando as contagens declaradas, não medições de uma tarefa real.
Quando uma saída extra apaga a vantagem de preço por token
Mantenha a entrada sem cache em 100,000 tokens e a saída total faturada do Terra em 10,000 tokens. A fatura padrão de tokens do Terra então é $0.150. O Flash atinge a mesma fatura com 225,000 tokens de saída faturados fora do pico, ou 100,000 nas tarifas de pico. Essa aritmética isola o volume de saída; cache, entradas repetidas, taxas de ferramentas e novas tentativas mudam a comparação.
Custo por tarefa bem-sucedida
Avalie um lote fixo de tarefas e divida todos os gastos faturados de API e ferramentas pelo número de tarefas que passam nos seus critérios de aceitação. Conte também os gastos com tentativas malsucedidas. Relate a taxa de sucesso ao lado desse custo para que um modelo não seja recompensado simplesmente por concluir apenas os trabalhos mais fáceis.
Custo por tarefa bem-sucedida = Custo total de API e ferramentas / Tarefas concluídas com sucesso
Qual você deve escolher: GPT-6.1 Terra ou DeepSeek-V4.1-Flash?
Escolha de acordo com os requisitos de qualidade da tarefa, metas de custo e necessidades de implantação. Use os resultados de benchmark acima para decidir qual modelo testar primeiro.
Caso de uso
Candidato inicial
O que deve decidir a escolha
Raciocínio exigente
GPT-6.1 Terra
Precisão e trabalho corretivo em tarefas difíceis representativas
Agentes de programação
Testar ambos
Patches aceitos, verificações de regressão, falhas de ferramentas e custo total
Fluxos visuais complexos
GPT-6.1 Terra
Fluxos concluídos e recuperação de erros de interface
Extração de texto ou imagem em alto volume
DeepSeek Flash-1017
Se a precisão de extração atende ao limiar exigido
Recuperação em documentos longos
Testar ambos
Recuperação de evidências e precisão das respostas ao longo das posições de entrada
Auto-hospedagem
DeepSeek Flash-1017
Hardware disponível, custos operacionais e controle sobre os pesos
Aplicações interativas
Testar ambos
Latência mediana e de cauda na rota de provedor selecionada
Quando escolher o GPT-6.1 Terra
Priorize o Terra na avaliação quando o raciocínio complexo for central à tarefa. Para fluxos visuais ou de uso de computador exigentes, inclua-o no conjunto de testes e meça tarefas concluídas, erros e recuperação.
A questão-chave é se o Terra reduz tentativas fracassadas e correções manuais o suficiente para justificar seu preço de token mais alto.
Quando escolher o DeepSeek-V4.1-Flash
Comece com o DeepSeek-V4.1-Flash para tarefas repetitivas e de alto volume, com critérios claros de aceitação e metas de custo apertadas. Escolha-o se as saídas atenderem aos seus requisitos de qualidade a um custo menor por tarefa bem-sucedida.
Os pesos licenciados sob MIT do DeepSeek também o tornam a opção relevante quando a auto-hospedagem é um requisito. Inclua custos de hardware e operação nessa decisão.
Quando testar ambos os modelos
Teste ambos quando qualidade de programação, confiabilidade de ferramentas, latência ou precisão em documentos longos for crítica. Use tarefas representativas com as mesmas entradas, ferramentas, limites de execução e critérios de aceitação.
Compare a taxa de conclusão bem-sucedida, o custo total por tarefa bem-sucedida, a latência ponta a ponta e o tempo de correção humana. Registre a versão do modelo e as configurações de raciocínio para que os resultados possam ser reproduzidos.
Uma configuração híbrida pode iniciar tarefas rotineiras com o DeepSeek e escalar falhas selecionadas para o Terra. Meça o custo e a taxa de conclusão do fluxo completo para confirmar se a chamada adicional de modelo vale a pena.
Onde você pode acessar o GPT-6.1 Terra e o DeepSeek V4.1 Flash?
Use a API hospedada da OpenAI para o Terra ou a API hospedada do DeepSeek para o Flash. Confirme o identificador de modelo atual, limites da conta e o endpoint suportado antes da integração. Os pesos baixáveis do Flash-1017 fornecem uma opção separada de auto-hospedagem.
Acesso via CometAPI
A CometAPI fornece uma interface compatível com a OpenAI que pode simplificar o desenvolvimento de aplicações multimodelo.
Use a API do GPT-6.1 Terra e a API do DeepSeek V4.1 Flash com um cliente de texto compartilhado e, depois, adicione controles específicos do modelo somente após verificar o suporte da rota.
Compare respostas de texto via CometAPI
Para experimentar ambos os modelos em um único cliente de texto, use o OpenAI Python SDK com sua chave da CometAPI e o endpoint https://api.cometapi.com/v1. Mantenha a chave em uma variável de ambiente, depois envie o mesmo prompt para as rotas gpt-6.1-terra e deepseek-v4.1-flash e compare as respostas retornadas e o uso de tokens.
Por exemplo, peça a cada modelo que revise um fluxo de pagamento que refaz tentativas de solicitações com timeout sem uma chave de idempotência e registra corpos completos de solicitações. Compare quão claramente as respostas identificam riscos de confiabilidade e privacidade e explicam correções práticas. Um prompt compartilhado torna as respostas mais fáceis de inspecionar, mas uma solicitação de texto padrão não equaliza orçamentos de raciocínio nem estabelece um ranking de desempenho. Confirme o checkpoint servido por cada rota antes de tratar um resultado como evidência sobre o Flash-1017.
Conclusão
O GPT-6.1 Terra oferece o resultado agregado de raciocínio mais forte no momento, enquanto o DeepSeek Flash-1017 combina preços de tokens mais baixos, geração de saída mais rápida medida e implantação com pesos abertos. A escolha útil é o modelo que atende aos seus requisitos de qualidade e latência com o menor custo total.
Comece com uma carga de trabalho representativa, mantenha o ambiente de ferramentas e os critérios de aceitação constantes e compare o custo de conclusões bem-sucedidas. Uma integração de texto compartilhada da CometAPI pode tornar essa avaliação mais fácil, enquanto recursos específicos de cada modelo ainda precisam de sua própria configuração.
Perguntas frequentes
Por que a mesma tarefa pode gerar cobranças de tokens diferentes no Terra e no Flash-1017?
Um prompt de texto não se converte necessariamente no mesmo número de tokens em dois modelos. As respostas geradas e os comprimentos de raciocínio também podem diferir. Compare o uso informado por cada rota para tarefas idênticas, incluindo tokens em cache e de raciocínio faturáveis quando informados, em vez de aplicar ambas as tabelas de preços a uma única contagem de tokens estimada.
O GPT-6.1 Terra e o DeepSeek V4.1 Flash podem compartilhar um cache de prompts?
Você pode reutilizar o texto do prompt no seu aplicativo, mas não presuma que um cache criado para um modelo ou provedor reduz a fatura do outro. A elegibilidade e a contabilização de cache são específicas da rota. Verifique os campos de uso de cada resposta e teste solicitações repetidas antes de incorporar economias a uma projeção.
Como devo validar a saída estruturada do Terra e do Flash-1017?
Defina os campos e tipos exigidos no seu aplicativo antes de escolher um modelo. Se uma rota oferecer JSON ou saída restrita por schema, verifique o modo exato que ela suporta, depois faça o parsing da resposta e valide-a contra o seu schema. Trate campos ausentes, valores inválidos, saída truncada e recusas como resultados separados. JSON válido por si só não estabelece que os fatos extraídos estão corretos.