Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
GPT-6.1 Terra vs GPT-6.1 Sol: benchmarks, preços e qual escolher
Compare o GPT-6.1 Terra e o GPT-6.1 Sol em benchmarks oficiais, capacidade de raciocínio, preços da API e cargas de trabalho práticas, incluindo um exemplo em Python com a CometAPI.
lesileEquipe de pesquisa de modelos e API de IA
Atualizado Oct 28, 2026 15 min de leitura
Resposta primeiro
Compare o GPT-6.1 Terra e o GPT-6.1 Sol em benchmarks oficiais, capacidade de raciocínio, preços da API e cargas de trabalho práticas, incluindo um exemplo em Python com a CometAPI.
Use este resumo para uma resposta rápida e depois leia o guia para contexto, exemplos e detalhes de implementação.
Comece com o GPT-6.1 Terra para tarefas de alto volume, verificáveis e sensíveis a custo. Avalie o GPT-6.1 Sol para codificação complexa, uso de ferramentas em várias etapas e fluxos de trabalho em que falhas são caras. Um padrão prático é usar primeiro o Terra e escalar para o Sol quando testes ou verificações de validação predefinidos falharem.
Principais conclusões
Precificação padrão por token: No OpenAI Standard, o Terra custa $1 por milhão de tokens de entrada e $5 por milhão de tokens de saída; o Sol custa $2 e $10, respectivamente.
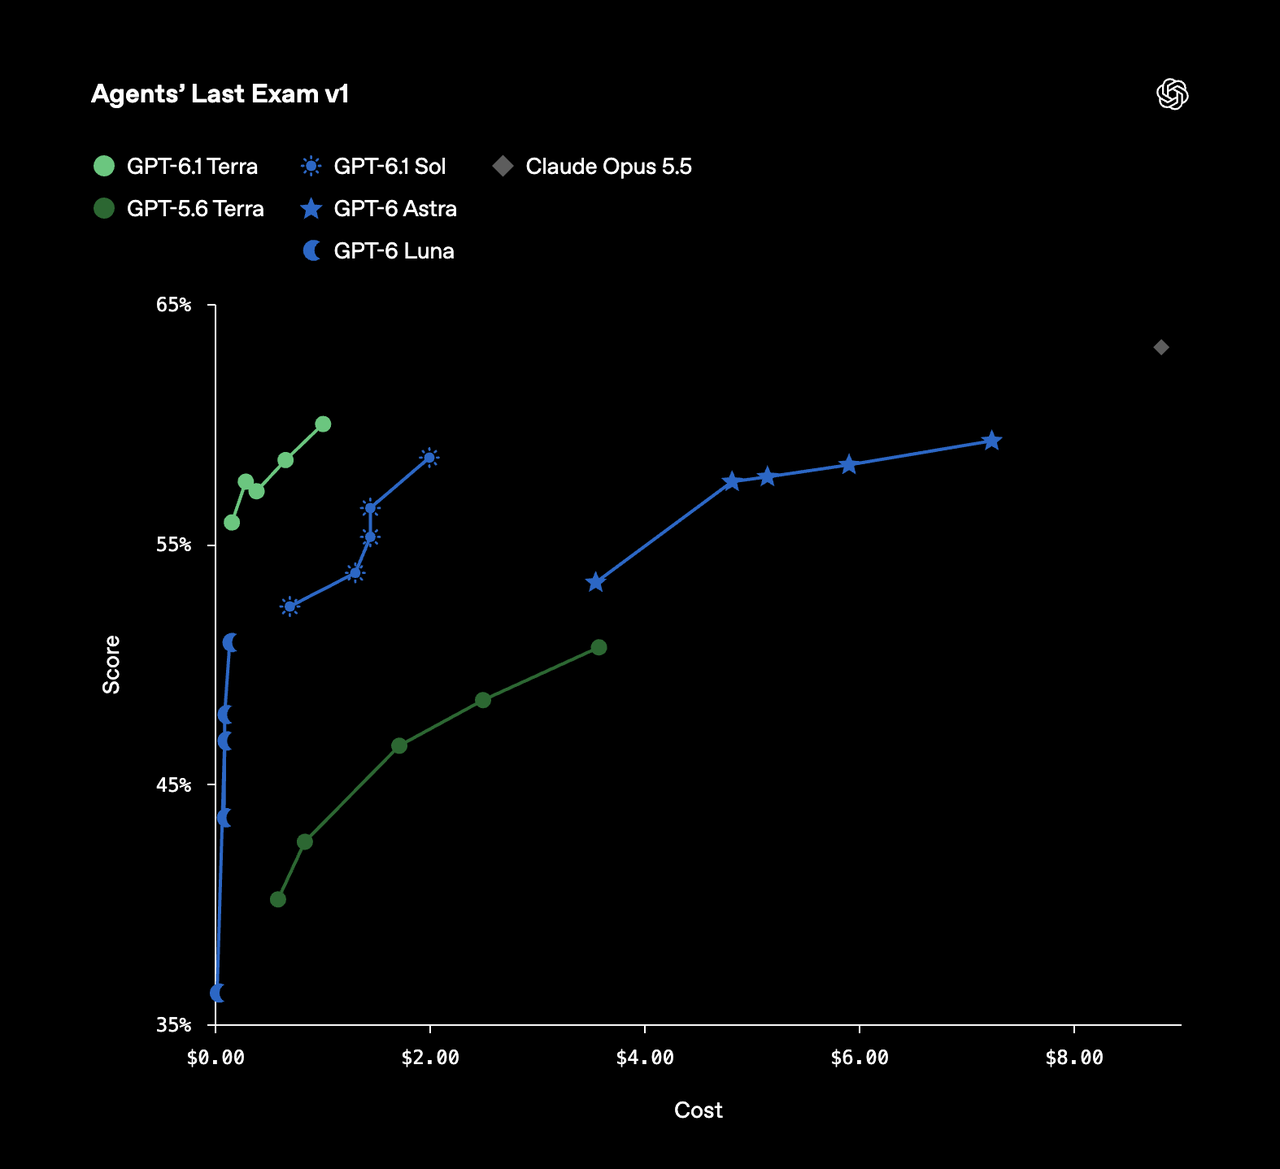
Desempenho específico por tarefa: No esforço máximo de raciocínio, o Terra lidera por pouco no Agents’ Last Exam v1 e no Terminal-Bench-Science 0.1, enquanto o Sol lidera no Terminal-Bench 4.0 e no OSWorld 2.1.
Ambos os modelos oferecem uma janela de contexto de 1,05 milhão de tokens e aceitam entradas de texto e imagem.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Capacidade de contexto compartilhada:
Controles de raciocínio diferentes: O Terra permite desativar o raciocínio com none; o Sol requer pelo menos esforço de raciocínio low.
O custo operacional importa: Compare o gasto por tarefa concluída com sucesso, incluindo novas tentativas e chamadas de ferramentas, e acompanhe separadamente os custos de revisão humana.
GPT-6.1 Terra vs GPT-6.1 Sol: Visão geral e especificações
A visão geral abaixo resume os trade-offs. As seções detalhadas explicam as evidências, premissas de cobrança e limites por trás de cada escolha.
GPT-6.1 Terra: fluxos de trabalho visuais e de agentes eficientes
A OpenAI apresentou o GPT-6.1 Terra em 26 de outubro de 2026. Ele combina raciocínio visual, uso de computador e geração de texto de uso geral para fluxos de trabalho profissionais rotineiros. Suas taxas de tokens mais baixas o tornam um ponto de partida útil quando as tarefas são frequentes e os resultados podem ser verificados.
GPT-6.1 Sol: codificação complexa e raciocínio profissional
O GPT-6.1 Sol foi lançado em 29 de setembro de 2026. Ele é voltado para trabalho exigente de codificação e atividades profissionais. Avalie-o quando um repositório desconhecido, uma longa cadeia de ações dependentes ou correções caras tornarem valiosa uma capacidade adicional de raciocínio.
Contexto, raciocínio e especificações da API
Recursos da API: Ambos os modelos oferecem Structured Outputs, streaming e o Batch API. O uso de ferramentas utiliza o Responses API e o fine-tuning não é compatível. Verifique se o provedor e o endpoint escolhidos oferecem os recursos de que sua aplicação precisa.
Ambos os modelos permitem até 128.000 tokens de saída dentro de uma janela de contexto de 1.050.000 tokens. Reservar a cota completa de saída deixa 922.000 tokens para o restante da troca, incluindo sua entrada, instruções do sistema e histórico de ferramentas. Esse é um cálculo de planejamento, não um limite fixo de entrada separado.
Divulgação de arquitetura: As especificações públicas vinculadas do modelo não fornecem detalhes internos suficientes para uma comparação confiável. Capacidade de contexto e configurações de raciocínio não devem ser tratadas como evidência de contagem de parâmetros ou arquitetura.
Controles de raciocínio: A configuração none do Terra é útil para transformações e extrações simples. Para a primeira comparação, use a mesma configuração de raciocínio compatível em ambos os modelos e, em seguida, ajuste cada modelo de acordo com a qualidade e a latência que seu fluxo de trabalho exige.
Ambos os modelos têm a mesma capacidade de contexto publicada, mas isso não implica precisão de recuperação ou qualidade de raciocínio em longos contextos. A seleção do modelo deve, portanto, considerar qualidade de raciocínio, eficiência do fluxo de trabalho, custo e desempenho de recuperação específico da tarefa.
GPT-6.1 Terra vs GPT-6.1 Sol: Desempenho
Os resultados relatados mostram um quadro misto: o Terra lidera por pouco em algumas avaliações de agentes e codificação científica, enquanto o Sol obtém pontuações mais altas em codificação geral em terminal, automação de desktop e visão. As comparações abaixo separam os resultados de lançamento da OpenAI das avaliações independentes e explicam o que cada uma pode — e não pode — indicar sobre o desempenho em produção.
Resultados oficiais de benchmarks e condições de teste
Os resultados a seguir vêm das avaliações de lançamento do Terra pela OpenAI. O Terra é exibido com esforço de raciocínio médio e máximo; o Sol é exibido com esforço máximo. A coluna final compara apenas as configurações de esforço máximo.
O OSWorld usa a avaliação offline 2.1. O teste de factualidade utiliza prompts internos da OpenAI projetados para induzir erros. Estes são resultados relatados pelo fornecedor em configurações de avaliação específicas, e não medições do seu fluxo de trabalho de produção.
Todas as pontuações são percentuais; diferenças são expressas em pontos percentuais (pp). Menor é melhor apenas para a taxa de erro factual. A diferença de 0,1 ponto na taxa de erro, sozinha, não estabelece uma vantagem de confiabilidade significativa.
Para engenharia de software, a liderança do Sol no Terminal-Bench e a pequena vantagem do Terra no Terminal-Bench-Science sugerem que os resultados dependem do tipo de tarefa de codificação. Para fluxos de trabalho de aplicação, a pontuação mais alta do Sol no OSWorld incentiva avaliá-lo para automação de desktop, enquanto o resultado do Terra no Agents’ Last Exam o torna um candidato para tarefas profissionais de agentes. Nenhum padrão estabelece um vencedor universal.
A estruturação de agentes, o acesso a ferramentas e a configuração do ambiente podem afetar esses resultados. Use os números para identificar candidatos à testagem e depois valide-os em relação às alterações de repositório e aos fluxos de trabalho de aplicação que você realmente precisa concluir.
O gráfico do Agents’ Last Exam v1 da OpenAI traça pontuações em função dos custos estimados por tarefa em diferentes configurações do modelo. Ele adiciona uma perspectiva de custo-eficiência à tabela de pontuações acima; os custos plotados são específicos da configuração de avaliação.
Avaliações independentes de inteligência e codificação
A avaliação de 26 de outubro da Artificial Analysis coloca o Terra quatro pontos abaixo do Sol em seu Intelligence Index no esforço máximo de raciocínio. Seu Coding Agent Index v2.0 dá ao Terra 48 e ao Sol 54. São avaliações separadas com seus próprios métodos e escalas de pontuação; elas não devem ser combinadas numericamente com os resultados de benchmarks da OpenAI.
A mesma análise identifica as configurações low e medium do Terra como particularmente eficientes em custo na avaliação de inteligência. Isso respalda testar configurações práticas ao lado de configurações de esforço máximo. Os custos de avaliação permanecem específicos da configuração de teste e não devem ser tratados como estimativas do gasto da sua aplicação.
Velocidade e latência: conclusão de tarefas vs. geração de tokens
A OpenAI relata que o Terra conclui as tarefas avaliadas do Agents’ Last Exam mais de três vezes mais rápido do que o Sol. Esta é uma medição de tarefa ponta a ponta que inclui raciocínio e interações de software. Ela não implica uma taxa de throughput de tokens de saída três vezes maior nem o mesmo ganho de velocidade para cada requisição de API.
Para aplicações interativas, distinga o tempo até o primeiro token, que mede a espera antes do início da saída, dos tokens de saída por segundo, que medem a velocidade com que a resposta continua. Para agentes, priorize o tempo de conclusão ponta a ponta, incluindo chamadas de ferramentas, novas tentativas e recuperação.
Compare ambos os modelos usando os mesmos prompts, ferramentas, configuração de raciocínio compatível e critérios de aceitação. Registre a latência juntamente com o sucesso das tarefas: uma resposta mais rápida tem valor limitado se exigir mais correções ou não concluir o fluxo de trabalho.
Visão e desempenho em longo contexto: o que os resultados estabelecem
A vantagem de 0,8 ponto percentual do Sol no MMMU-Pro em esforço máximo é um resultado de visão relatado, e não uma garantia de melhor desempenho em todo fluxo de trabalho visual. Teste rótulos pequenos, digitalizações ruins, diagramas densos e layouts desconhecidos com entradas representativas.
As avaliações acima não estabelecem qual modelo é melhor em recuperação de longo contexto ou raciocínio. Embora ambos tenham a mesma capacidade de contexto publicada, a capacidade por si só não demonstra precisão de recuperação ou memória entre sessões. Teste se cada modelo consegue localizar e usar evidências relevantes em seus documentos e mantenha o estado da aplicação explicitamente entre requisições.
GPT-6.1 Terra vs GPT-6.1 Sol: Custo
Os preços por token são o ponto de partida para comparar custos. Novas tentativas, tokens de raciocínio, chamadas de ferramentas e revisão humana também afetam quanto você gasta para concluir uma tarefa com sucesso.
As tarifas a seguir estão em USD por milhão de tokens e precificação.
Preços da OpenAI API
As tarifas Standard listadas do Terra são metade das do Sol nessas categorias. As cobranças reais dependem da configuração da requisição: pedidos de longo contexto, camadas de processamento, processamento regional e uso de ferramentas podem ter termos diferentes. Verifique a documentação de preços aplicável da OpenAI antes de estimar custos de produção.
Preços da CometAPI
A CometAPI é uma rota de acesso de terceiros com sua própria precificação e disponibilidade de recursos. Suas tarifas listadas de entrada e saída são mostradas separadamente abaixo.
Nessas tarifas, os preços de entrada e saída comuns da CometAPI são 20% abaixo das tarifas OpenAI Standard acima. Confirme os preços atuais, cobranças para longos contextos, suporte a cache e disponibilidade de ferramentas para sua conta antes da implantação.
Custo de exemplo para 1.000 requisições
Suponha que uma aplicação faça 1.000 requisições, cada uma usando 2.000 tokens de entrada não em cache e 500 tokens de saída faturáveis. Isso produz um total de 2 milhões de tokens de entrada e 500.000 tokens de saída.
Para 1.000 requisições, cada uma usando 2.000 tokens de entrada não em cache e 500 tokens de saída faturáveis, os custos estimados são:
Terra via OpenAI: $2.00 para entrada e $2.50 para saída, totalizando $4.50.
Sol via OpenAI: $4.00 para entrada e $5.00 para saída, totalizando $9.00.
Terra via CometAPI: $1.60 para entrada e $2.00 para saída, totalizando $3.60.
Sol via CometAPI: $3.20 para entrada e $4.00 para saída, totalizando $7.20.
Esses cálculos usam as tarifas comuns listadas acima, sem desconto do Batch API. Eles excluem gravações de cache, cobranças separadas de ferramentas e novas tentativas. Quaisquer tokens de raciocínio faturados como saída devem ser incluídos no total de saída.
Custo efetivo por tarefa bem-sucedida
Neste artigo, uma tarefa bem-sucedida é aquela que passa nas verificações predefinidas de qualidade, esquema quando aplicável, e conclusão sem correção humana adicional.
Preços mais baixos por token nem sempre produzem custos operacionais menores. As economias do Terra podem diminuir se ele precisar de mais tentativas, tokens de raciocínio ou intervenção humana. As tarifas mais altas do Sol podem valer a pena se ele concluir mais tarefas com sucesso na primeira tentativa.
Custo efetivo de modelo e ferramentas por tarefa bem-sucedida = gasto total de modelo e ferramentas em todas as tentativas ÷ número de tarefas bem-sucedidas.
Acompanhe separadamente os custos de revisão e correção humanas. Escolha o modelo que atende sua meta de qualidade ao menor custo combinado, em vez de comparar apenas os preços por token.
Qual modelo você deve escolher: GPT-6.1 Terra ou GPT-6.1 Sol?
Escolha com base na complexidade da tarefa, na qualidade de saída verificável e no custo total de conclusão. O Terra é um ponto de partida útil para fluxos de trabalho rotineiros; o Sol merece avaliação quando raciocínio difícil ou falhas caras justificam gasto adicional.
Quando escolher o GPT-6.1 Terra
Comece com o Terra para extração em alto volume, redação de documentos, correspondência de catálogos e fluxos de trabalho de aplicação previsíveis. Essas tarefas são boas candidatas quando os resultados podem ser verificados em relação aos documentos de origem, campos obrigatórios ou regras de validação automatizadas.
Escolha o Terra quando ele atender às suas metas de precisão e conclusão dentro do orçamento permitido de novas tentativas e revisão humana. Tarifas menores por token oferecem pouco benefício se falhas repetidas eliminarem as economias.
Quando escolher o GPT-6.1 Sol
Avalie o Sol para depuração difícil, mudanças em repositórios envolvendo muitas dependências e fluxos de trabalho de desktop com longas cadeias de ações dependentes.
Escolha o Sol quando os testes mostrarem que ele produz mais correções aceitas, passa em mais testes ou requer menos correção manual. Seu custo de token mais alto se justifica quando essas melhorias reduzem o custo total para concluir o trabalho.
Quando usar o Terra primeiro e escalar para o Sol
Um fluxo de trabalho híbrido pode usar o Terra para a tentativa inicial e escalar para o Sol quando verificações predefinidas falharem. Baseie a escalada em resultados observáveis, e não apenas na confiança do modelo.
Por exemplo, um fluxo de trabalho de geração de código poderia:
Pedir ao Terra que produza a alteração solicitada.
Executar os testes e verificações de validação relevantes.
Escalar para o Sol se a alteração falhar nessas verificações ou ficar fora da capacidade verificada do Terra.
Enviar casos não resolvidos para revisão humana quando o orçamento de novas tentativas for esgotado.
Ao escalar, preserve a solicitação original, o contexto relevante, a saída que falhou e os resultados da validação. Registre o uso de ambos os modelos para que a comparação de custos inclua todo o fluxo de trabalho.
Checklist de avaliação para produção
Antes de selecionar um modelo padrão ou implantar um fluxo de escalada:
Use tarefas representativas: Inclua solicitações rotineiras e casos em que a falha é cara.
Mantenha comparações controladas: Use instruções, evidências, ferramentas e critérios de aceitação comparáveis. Registre IDs de modelo, endpoints, configurações de raciocínio e datas de teste.
Meça resultados aceitos: Verifique precisão, validade de esquema quando aplicável, resultados de testes e conclusão sem correção manual.
Meça tempo e gasto: Acompanhe latência mediana e de cauda, tokens faturados, chamadas de ferramentas, novas tentativas e esforço de revisão humana.
Repita a comparação: Execute as tarefas múltiplas vezes e alterne a ordem dos modelos para reduzir a influência de resultados pontuais.
Onde você pode acessar o GPT-6.1 Terra e o GPT-6.1 Sol?
Acesso por provedor oficial
Ambos os modelos estão disponíveis pela OpenAI API. Para requisições de texto, o Chat Completions é compatível; o uso de ferramentas requer o Responses API. Confirme os parâmetros suportados do modelo, os limites da sua conta e as ferramentas disponíveis na rota que pretende usar.
Acesso pela CometAPI
Para usar qualquer um dos modelos pela CometAPI, siga seu guia de início rápido para configurar o SDK compatível com a OpenAI. Forneça sua chave da CometAPI de forma segura pela variável de ambiente COMETAPI_KEY e defina a base de URL como https://api.cometapi.com/v1. Escolha gpt-6.1-terra ou gpt-6.1-sol como identificador do modelo e confirme que a rota está habilitada para sua conta.
Para uma primeira comparação, forneça as mesmas tarefas representativas a ambos os modelos e use esforço de raciocínio médio. Mantenha as instruções e critérios de aceitação consistentes, repita cada tarefa e alterne a ordem dos modelos. Compare resultados bem-sucedidos, tempo decorrido, tokens faturados e novas tentativas em vez de julgar qualquer modelo a partir de uma única resposta.
Conclusão
Comece com o GPT-6.1 Terra para fluxos de trabalho frequentes e verificáveis em que preços mais baixos por token e conclusão mais rápida de tarefas importam. Avalie o GPT-6.1 Sol quando codificação difícil, uso de ferramentas em várias etapas ou falhas caras tornarem valiosa uma capacidade de raciocínio mais alta. A escolha final deve se basear no custo por tarefa aceita sob um conjunto de avaliação representativo, e não no preço ou em um único benchmark.
Para muitas aplicações, o próximo passo útil é um pequeno teste representativo com condições claras de aprovação e uma rota de escalada limitada. Deixe o resultado medido determinar o modelo, em vez de confiar no preço ou em um único benchmark.
Fator de decisão
GPT-6.1 Terra
GPT-6.1 Sol
Carga de trabalho inicial
Trabalho visual rotineiro e agentes repetíveis
Codificação complexa e raciocínio profissional contínuo
Contexto e modalidades
Mesma capacidade total de contexto; entrada de texto e imagem
Mesma capacidade total de contexto; entrada de texto e imagem
Controle de raciocínio
Inclui opção de desativar o raciocínio
Requer pelo menos esforço de raciocínio baixo
Padrão de desempenho publicado
Desempenho de menor custo em tarefas de agentes repetíveis
Mais forte em vários testes difíceis de codificação e desktop
Acesso à API
OpenAI e CometAPI
OpenAI e CometAPI
Especificação
GPT-6.1 Terra
GPT-6.1 Sol
Data oficial de lançamento
26 de outubro de 2026
29 de setembro de 2026
API model ID
gpt-6.1-terra
gpt-6.1-sol
Janela de contexto
1.050.000 tokens
1.050.000 tokens
Knowledge cutoff
1º de junho de 2026
30 de abril de 2026
Entrada / saída
Texto e imagens / texto
Texto e imagens / texto
Esforço de raciocínio
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Esforço de raciocínio padrão
medium
medium
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Comparação no esforço máximo
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1,4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0,8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3,8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5,6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1,3 pp
Taxa de erro factual em prompts difíceis
10.10%
4.30%
4.40%
Terra 0,1 pp menor
Provedor e categoria de tokens
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — entrada
$1.00
$2.00
OpenAI Standard — entrada em cache
$0.05
$0.10
OpenAI Standard — saída
$5.00
$10.00
OpenAI Standard — gravação de cache de 30 minutos
$1.25
$2.50
OpenAI Standard — gravação de cache de 12 horas
$2.50
$5.00
CometAPI — entrada
$0.80
$1.60
CometAPI — saída
$4.00
$8.00
Defina limites operacionais: Estabeleça orçamentos de novas tentativas, gatilhos de escalada e requisitos de aprovação humana antes da implantação.
Compare o fluxo de trabalho completo: Inclua tentativas sem sucesso e custos de escalada ao calcular o gasto por tarefa bem-sucedida.
GPT-6.1 Terra vs GPT-6.1 Sol: benchmarks, preços e qual escolher - CometAPI