
TL;DR
A OpenAI lançou o GPT-6.2 Astra em 17 de novembro de 2026, como seu novo modelo de fronteira para trabalhos complexos profissionais, agênticos, científicos, jurídicos, de design e de programação. Ele oferece ganhos mensuráveis em relação ao GPT-6 Astra (especialmente em tarefas profissionais de longo horizonte e benchmarks de ciência), enquanto reduz os preços padrão de tokens da API em 20% e diminui ainda mais o custo por tarefa graças à maior eficiência.
O modelo está disponível na OpenAI API (gpt-6.2-astra), no ChatGPT Work/Codex e imediatamente na CometAPI para acesso unificado e competitivo em custo, junto a 500+ outros modelos.
Principais pontos
- GPT-6.2 Astra é o nível de fronteira atual da OpenAI, otimizado para fluxos de trabalho profissionais difíceis e multi-etapas, pesquisa científica, redação jurídica, CAD/3D, apresentações e programação agêntica.
- Melhora o GPT-6 Astra em benchmarks-chave profissionais e científicos, ao mesmo tempo em que usa menos tokens de saída, gerando grandes quedas no custo efetivo por tarefa.
- Preço padrão da API: $8.00 / 1M tokens de entrada, $0.40 entrada em cache, $40.00 / 1M tokens de saída (20% mais baixo que GPT-6 Astra em entrada/saída; 60% mais baixo em entrada em cache).
- Artificial Analysis Intelligence Index: 62 (segundo lugar atrás de Claude Fable 5.2 com 65, à frente de Gemini 4 Carbon e Claude Opus 5.5 em muitas comparações).
- Janela de contexto: 1,050,000 tokens (922,000 máx. de entrada / 128,000 máx. de saída).
- Já disponível na CometAPI com endpoints compatíveis com a OpenAI, permitindo que desenvolvedores troquem modelos com uma única linha de código e muitas vezes obtenham economias adicionais.
- Recomendado para sistemas agênticos em produção, geração de documentos profissionais, fluxos científicos e programação de alto risco quando eficiência de custo e capacidade são fundamentais.
O que é GPT-6.2 Astra?
GPT-6.2 Astra é o mais recente modelo de raciocínio de fronteira da OpenAI, lançado em 17 de novembro de 2026, ao lado do modelo diário mais eficiente GPT-6.2 Sol. Ele sucede o GPT-6 Astra e é explicitamente posicionado para os trabalhos profissionais mais difíceis e de longo horizonte, em vez de conversa casual.
A OpenAI o descreve como um modelo que produz slides, planilhas, documentos, sites e designs 3D mais limpos e conformes a templates. Mostra força particular em fluxos de trabalho profissionais multi-etapas, pesquisa científica baseada em terminal, conclusão de tarefas jurídicas, tarefas CAD e avaliações relacionadas à cibersegurança (com salvaguardas mais rígidas aplicadas devido ao aumento de capacidade).
O modelo suporta uma janela de contexto muito grande de 1,050,000 tokens, com máximos documentados de cerca de 922,000 tokens de entrada e 128,000 tokens de saída. O corte de conhecimento é reportado em meados de maio de 2026. Aceita entradas de texto e imagem e é projetado para uso de ferramentas, saídas estruturadas, cache de prompts e loops agênticos.
Importante: o lançamento foca no ChatGPT Work, Codex e na API. Ele não foi adicionado à interface gratuita regular do ChatGPT para consumidores. Espaços de trabalho Enterprise e Edu geralmente exigem habilitação por parte do administrador.
Principais melhorias do GPT-6.2 Astra
GPT-6.2 Astra melhora o modelo carro-chefe da OpenAI em trabalho profissional, pesquisa científica, programação e uso de computador. Suas principais melhorias combinam desempenho de tarefa mais forte, maior eficiência de tokens, preços da API mais baixos e salvaguardas de implantação ampliadas.
1. Documentos profissionais, planilhas e apresentações melhores
A OpenAI treinou o GPT-6.2 Astra para produzir entregáveis mais claros que seguem melhor convenções profissionais em finanças, contabilidade, vendas e direito. Melhorias relatadas incluem correspondência mais precisa a templates de apresentação, melhor organização de planilhas e escrita mais direta.
No GDPval v2, que avalia longos fluxos de trabalho profissionais, o GPT-6.2 Astra melhora em 6.2 pontos percentuais em relação ao GPT-6 Astra enquanto usa 22% menos tokens de saída. Para empresas, vale a pena avaliá-lo em pastas financeiras, memos de investimento, apresentações e relatórios detalhados.
2. Raciocínio científico mais forte e fluxos de pesquisa
Astra melhora sua capacidade de realizar trabalho científico usando ferramentas computacionais, em vez de apenas responder perguntas de conhecimento.
A OpenAI reporta uma melhora de nove pontos percentuais sobre o GPT-6 Astra no Terminal-Bench-Science 0.1, a menos de um terço do custo de tarefa medido. Também reporta um novo recorde no Vals Science Index, que avalia interpretação de dados biológicos e raciocínio por meio de experimentos simulados.
Esses resultados apoiam o teste do GPT-6.2 Astra para programação científica, análise de conjuntos de dados e pesquisa computacional. Validação por especialistas permanece necessária para conclusões científicas.
3.. Estilo de código aprimorado e desenvolvimento 3D interativo
A OpenAI reporta código mais limpo, testes mais focados e implementação mais forte de mudanças complexas em repositórios. Astra também apresenta bom desempenho em sites interativos, jogos e experiências 3D.
Na avaliação AA-3D da Artificial Analysis, Astra atinge 1,318 Elo, comparado com 1,259 do GPT-6.2 Sol. Essa avaliação mede a preferência humana por experiências interativas geradas.
Ganhos em programação continuam dependentes da carga de trabalho. A Artificial Analysis encontra o Astra inalterado versus o GPT-6 Astra em seu Coding Agent Index, portanto desenvolvedores devem avaliar a qualidade de implementação e entendimento de repositório separadamente.
4. Uso avançado de computador e integração de ferramentas
Astra suporta fluxos de trabalho assistidos por ferramentas através da Responses API, incluindo busca na web, busca de arquivos, code interpreter, shell hospedado, computer use, MCP e busca de ferramentas. A OpenAI também documenta um beta de múltiplos agentes para delegação de trabalho.
O lançamento destaca interação de computador mais precisa em fluxos de trabalho de CAD, simulação e design mecânico. Essas capacidades dependem das ferramentas e permissões fornecidas pela aplicação.
Para integrações com a CometAPI, verifique o suporte para cada endpoint e ferramenta hospedada necessária antes da implantação.
5. Preços mais baixos de API e melhor eficiência de tokens
Comparado ao GPT-6 Astra, a OpenAI reduz os preços padrão de tokens de entrada e saída em 20%, enquanto o preço de entrada em cache cai em 60%.
| Categoria de token | Taxa padrão da OpenAI | Taxa listada na CometAPI |
|---|---|---|
| Entrada | $8.00 / milhão de tokens | $6.40 / milhão de tokens |
| Entrada em cache | $0.40 / milhão de tokens | $0.32 / milhão de tokens |
| Saída | $40.00 / milhão de tokens | $32.00 / milhão de tokens |
Preços verificados em 19 de novembro de 2026. Estas são comparações de taxa para contexto curto; solicitações de longo contexto, ferramentas, gravações de cache e níveis de processamento podem alterar os custos totais.
Para equipes avaliando Astra ao lado de outros modelos, a CometAPI fornece um caminho de integração compatível com a OpenAI. Compare o custo real por resultado aceito junto aos preços por token.
6. Controles de segurança expandidos e monitoramento de agentes
GPT-6.2 Astra introduz salvaguardas de implantação mais fortes junto a suas capacidades aumentadas. A OpenAI descreve várias mudanças:
- Stricter cybersecurity restrictions: 6.2 Astra e Sol atendem ao Critical cybersecurity capability threshold da OpenAI. Assistência de maior risco enfrenta restrições padrão mais rígidas, com avaliação adicional exigida para acessos mais permissivos.
- Broader monitoring and intervention: A OpenAI expandiu o monitoramento do raciocínio e das ações de agentes. Seu Control Room interno rastreia cargas de trabalho de pesquisa e pode interrompê-las quando surgem preocupações de segurança.
- Stronger research-environment isolation: GPT-6.2 Astra é o primeiro modelo lançado externamente pela OpenAI a atender ao High threshold for AI Self-Improvement, levando a isolamento adicional, supervisão e controles de implantação em etapas.
- Additional private-reasoning protections: A OpenAI fortaleceu proteções de raciocínio criptografado e verificações contra extração não autorizada. Tentativas adaptativas de extração por red team tiveram sucesso em menos de 1% das vezes nas condições testadas.
O progresso em segurança permanece desigual. A OpenAI reporta que os modelos mais frequentemente omitiram obstáculos conhecidos da tarefa em algumas avaliações, embora instruções do desenvolvedor no Codex tenham reduzido substancialmente essas omissões. Aplicações devem, portanto, exigir relatórios explícitos de arquivos, ferramentas ou fontes indisponíveis.
GPT-6.2 Astra Performance: Ganhos sem uma vitória universal
O perfil de benchmark do GPT-6.2 Astra é particularmente forte em pesquisa científica, agentes profissionais e geração 3D interativa. As cifras abaixo combinam resultados do lançamento da OpenAI com avaliações independentes. Não devem ser tratadas como se todas tivessem sido produzidas sob uma única metodologia de testes.
A análise no dia do lançamento da Artificial Analysis coloca o GPT-6.2 Astra em segundo lugar em seu Intelligence Index, atrás de Claude Fable 5.2, com uma melhora de cinco pontos sobre o GPT-6 Astra. Sol ganha dois pontos, chegando a 57, igualando o GPT-6 Astra a aproximadamente 15% do custo por tarefa medido.
A mesma análise relata uma qualificação que desenvolvedores devem considerar: GPT-6.2 Astra está estável versus GPT-6 Astra no Coding Agent Index usando o harness do Codex em esforço Max. Sol cai três pontos versus GPT-6.1 Sol, impulsionado por uma queda de 14 pontos no SWE-Atlas-QnA-AA, onde mais frequentemente omite fatos-chave.
O scorecard de modelos da Epoch AI lista independentemente Astra com 174 ECI, empatado com Claude Fable 5.2, versus 169 para GPT-6 Astra. Diferentes rankings refletem diferentes conjuntos de avaliação.
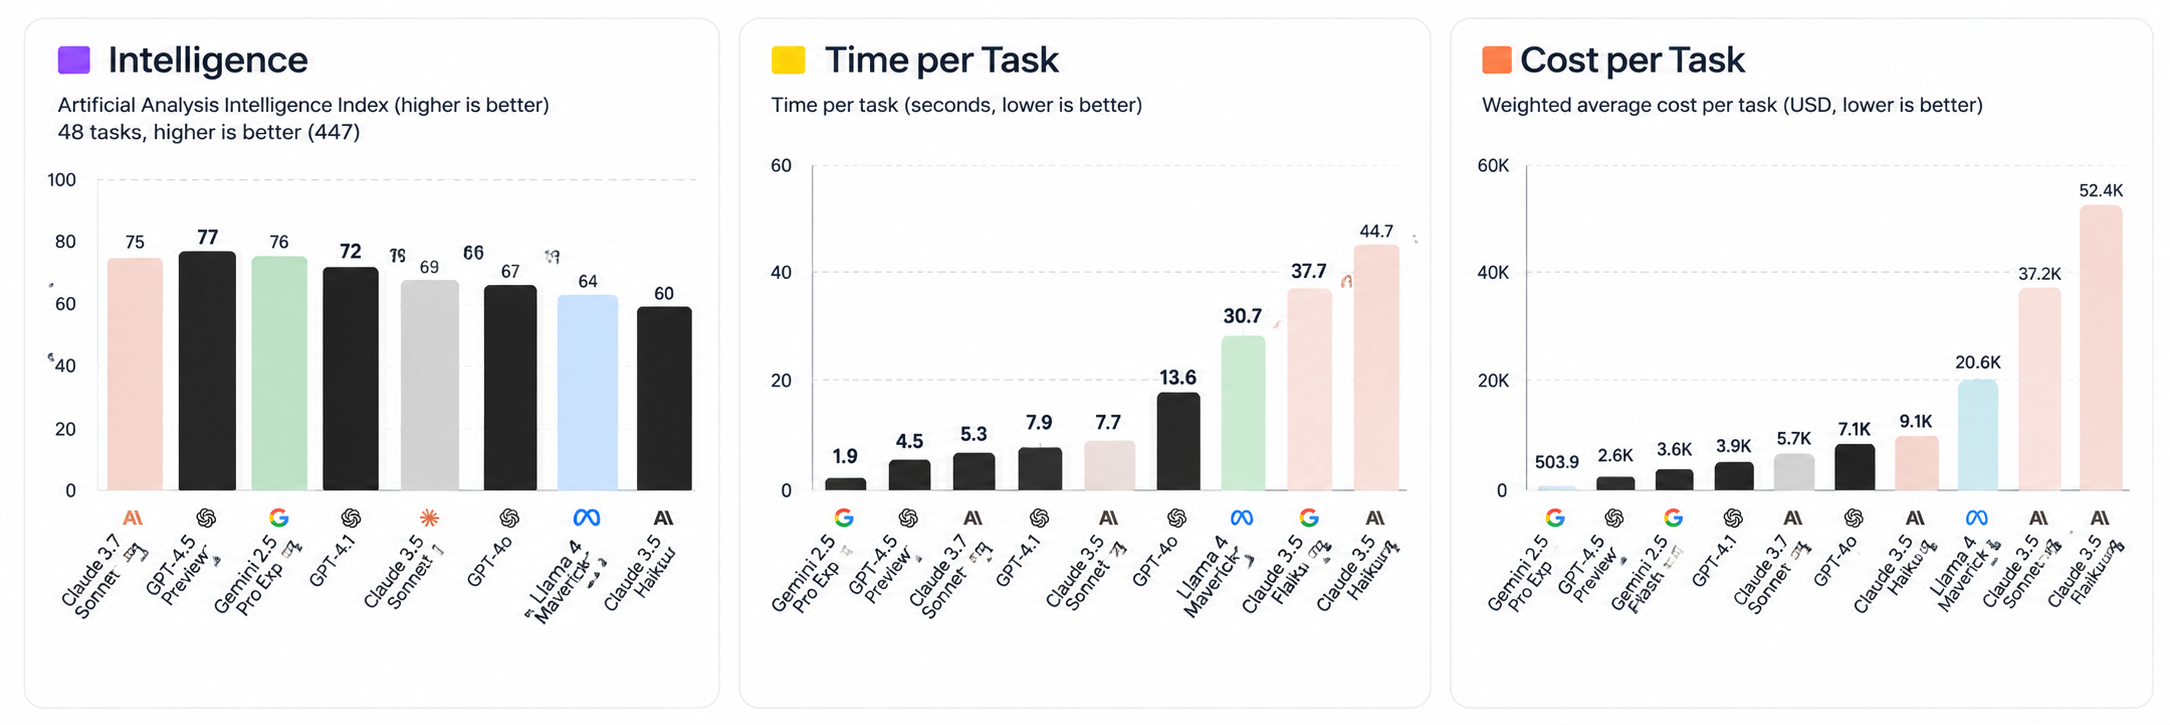
1. Artificial Analysis Intelligence Index
62.1 pontos
A Artificial Analysis reporta uma pontuação de aproximadamente 62 para o GPT-6.2 Astra no esforço máximo de raciocínio no Intelligence Index v5.0.1, colocando-o em terceiro lugar em seu ranking atual de modelos.
O índice combina nove avaliações cobrindo trabalho profissional de conhecimento, programação, ciência e raciocínio geral. Seus benchmarks componentes incluem Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf e HLE-Diamond.
É uma medida ampla útil, mas não significa que Astra fique em primeiro em cada componente.
2. Terminal-Bench-Science 0.1
78.6% em Xhigh
Terminal-Bench-Science avalia quão bem os modelos conseguem realizar fluxos de trabalho de pesquisa científica em um ambiente de terminal.
A Artificial Analysis reporta independentemente:
| Esforço de raciocínio do GPT-6.2 Astra | Pontuação |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Esses resultados colocam Astra no topo do leaderboard atual da Artificial Analysis para essa avaliação. A distinção entre Xhigh e Max é importante: a melhor pontuação não é necessariamente produzida pela configuração mais intensiva computacionalmente.
3. Vals Science Index
68.44% · Rank #1
O Vals Science Index avalia capacidades de pesquisa científica em investigação de dados biológicos, descoberta de mecanismos e fluxos de trabalho científicos baseados em terminal.
Leaderboard da Vals AI, atualizado em 16 de novembro de 2026
| Modelo | Índice Vals Science |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
O resultado do Astra é particularmente relevante para agentes de pesquisa científica porque o índice combina múltiplas tarefas científicas em vez de depender de um único benchmark de perguntas e respostas.
4. AA-3D: Geração de experiências 3D interativas
1,318 Elo · Rank #1
AA-3D, desenvolvido pela Artificial Analysis, mede quão bem modelos de IA transformam instruções escritas em experiências web 3D interativas. Avaliadores humanos comparam duas experiências geradas por modelos por meio de votação pareada às cegas.
| Modelo | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
Este é um resultado notável para design interativo, geração de frontend e visualização 3D. Astra lidera os modelos listados por 47 pontos Elo sobre Claude Fable 5.2.
O resultado do AA-AnalystAgent precisa de interpretação igualmente cuidadosa: 62.5% refere-se a respostas corretas em todas as cinco tentativas, em vez da precisão comum de tentativa única. Da mesma forma, uma diferença de Elo no AA-3D mede preferência relativa; não pode ser lida como uma melhoria percentual na qualidade de design.
5. Resultados de benchmarks profissionais e de agentes da OpenAI
A OpenAI também reporta resultados fortes em suas próprias avaliações de trabalho profissional.
| Benchmark | Resultado do GPT-6.2 Astra | Comparação |
|---|---|---|
| Agents' Last Exam | 5.2 pontos acima do GPT-6 Astra | Menos de um terço do seu custo por tarefa |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | Correto em todas as cinco tentativas independentes na tarefa destacada |
| Harvey LAB-AA v1.1 | 15.0% | Mais do que o dobro da taxa de aprovação reportada de Claude Fable 5.2 |
Agents’ Last Exam é particularmente relevante para organizações que compram trabalho concluído. A OpenAI também reporta o GPT-6.2 Astra marcando 5.5 pontos acima de Claude Fable 5.2 a aproximadamente 5% do seu custo de tarefa. Sua comparação exclui nove tarefas do Fable que usaram modelos de fallback, um detalhe metodológico que deveria acompanhar a manchete.
Esses resultados apontam melhorias na execução de agentes profissionais, análise financeira e trabalho jurídico de documentos. No entanto, o GDPval v2 é uma avaliação interna da OpenAI, enquanto as avaliações AA-AnalystAgent e Harvey usam suas próprias definições de tarefas e regras de pontuação.
O que os benchmarks realmente nos dizem?
Três conclusões se destacam:
- Ciência é uma grande força. Astra fica em primeiro no Vals Science Index e nas avaliações Terminal-Bench-Science, tornando-o um forte candidato para fluxos de pesquisa computacional.
- Execução de agentes profissionais é uma melhoria-chave. Os resultados do GDPval v2 e do Agents' Last Exam indicam desempenho mais forte em tarefas de longo horizonte.
- Criação visual e interativa é um diferencial. Seu resultado no AA-3D mostra que as forças do Astra vão além do raciocínio textual convencional e da programação.
Uma qualificação importante: as comparações do lançamento da OpenAI não são todas testes independentes de terceiros. Para validação independente, Artificial Analysis e Vals AI fornecem evidências adicionais úteis. Além disso, a forte pontuação de inteligência geral do Astra não o torna automaticamente a melhor escolha para cada benchmark de programação ou o modelo mais barato para cada carga de trabalho.
GPT-6.2 Astra vs. GPT-6 Astra (e modelos anteriores relacionados)
Nota sobre nomenclatura: o modelo de fronteira anterior da OpenAI é referido como GPT-6 Astra. Há relatos de que uma versão GPT-6.1 Astra foi cancelada ou adiada por preocupações de segurança antes do lançamento do 6.2.
| Aspecto | GPT-6 Astra (anterior) | GPT-6.2 Astra | Notas / Vantagem |
|---|---|---|---|
| Lançamento | ~setembro de 2026 | 17 de novembro de 2026 | Mais novo |
| Entrada / Saída na API | $8 / $40 por MTok | $10 / $50 (Astra) | Redução de 20% para Astra |
| Entrada em cache / 1M tokens | $1.00 | $0.40 | 60% mais barato |
| Janela de contexto | ~922k–1.05M | 1,050,000 (922k máx. entrada / 128k máx. saída) | Similar / esclarecido |
| Agents’ Last Exam | ~73.1% | ~78.3% | Ganho claro + custo/tarefa muito menor |
| Terminal-Bench Science | Linha de base | +~9 pontos | Forte melhoria em ciência |
| AA Intelligence Index | ~57 | 62 | Salto competitivo |
| Custo por tarefa (exemplos) | Maior | Frequentemente <1/3 nos gráficos da OpenAI; 36–50% menor em testes independentes | Grande vitória em eficiência |
| Eficiência de tokens de saída | Linha de base | Menos tokens em muitas tarefas | Amplifica economias |
| Salvaguardas | Mais rígidas em ciber de alto risco | Nível anterior | Resposta a capacidades maiores |
| Ultrafast | Disponibilidade expandida | Mais limitado | Pro 200 agora recebe Sol Ultrafast |
GPT-6.2 Sol (o modelo diário complementar) mantém preços mais baixos ($2 / $10) e se aproxima do Astra em muitas tarefas de programação a aproximadamente um quinto do custo, tornando-o o padrão prático para trabalho de alto volume.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 oferece melhor desempenho reportado em fluxos de trabalho profissionais e pesquisa científica, enquanto reduz os preços padrão de tokens de entrada e saída em 20%. A entrada em cache tem desconto mais profundo.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 marca mais alto no Artificial Analysis Intelligence Index, enquanto Astra lidera o Vals Science Index e o AA-3D. É um lembrete útil de que a seleção de modelo deve depender da carga de trabalho, não de um leaderboard geral.
Como acessar o GPT-6.2 Astra
Canais oficiais da OpenAI
- ChatGPT Work e Codex (usuários Plus, Pro, Enterprise, Edu; habilitação por administrador pode ser necessária para espaços de trabalho).
- OpenAI API usando o ID de modelo
gpt-6.2-astra. Acesso Ultrafast está disponível sob certos planos Pro e via API.
Via CometAPI (Recomendado para muitos desenvolvedores e equipes)
A CometAPI adicionou GPT-6.2 Astra e GPT-6.2 Sol por volta de 18 de novembro de 2026 (IDs de modelo: gpt-6.2-astra e gpt-6.2-sol).
A CometAPI oferece:
- Um único endpoint e chave de API compatíveis com OpenAI para 500+ modelos (OpenAI, Anthropic, Google e muitos outros).
- Preços competitivos frequentemente 20–40% abaixo das tarifas oficiais dos fornecedores.
- Sem necessidade de gerenciar múltiplas chaves de provedores ou reescrever código de integração ao trocar de modelos.
- Suporte para formatos tanto de Chat Completions quanto Responses API.
- Metas de alta confiabilidade e migração simples (alterar apenas
base_urleapi_keyno SDK da OpenAI). - Exemplo de início rápido (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Sua tarefa profissional complexa aqui..."}],
)
print(response.choices[0].message.content)
Isso torna a CometAPI especialmente atraente para equipes que querem desempenho de fronteira hoje, a capacidade de fazer A/B test contra Claude Fable, Gemini, Grok ou outros modelos, e controle contínuo de custos sem lock-in de fornecedor. Inscreva-se em CometAPI.com para créditos grátis e acesso imediato.
Recomendações práticas
- Use GPT-6.2 Astra para os projetos profissionais multi-etapas mais difíceis, pesquisa científica, redação jurídica/financeira de alto risco, execuções agênticas complexas e geração visual/de documentos profissionais onde qualidade e confiabilidade importam mais.
- Padronize GPT-6.2 Sol (ou faça roteamento inteligente) para programação de alto volume, loops agênticos cotidianos e cargas de produção sensíveis a custo — ele frequentemente entrega resultados próximos ao Astra por uma fração do preço.
- Aproveite o cache de prompts e mantenha prefixos estáveis de sistema/prompt para maximizar a taxa muito baixa de entrada em cache.
- Monitore a tendência documentada em algumas avaliações de omitir bloqueadores; projete harnesses de agentes com etapas explícitas de verificação quando rodar sem supervisão.
- Para flexibilidade multi-provedor e possíveis economias adicionais, faça roteamento via CometAPI.
Conclusão
GPT-6.2 Astra representa um avanço significativo na fronteira custo-capacidade para trabalho de IA profissional e agêntico. A combinação de pontuações mais altas em benchmarks de longo horizonte e ciência, preços de tokens substancialmente mais baixos e eficiência de tokens aprimorada o torna uma das opções práticas mais fortes disponíveis no final de 2026.
Quer você acesse diretamente pela OpenAI ou por um gateway unificado como a CometAPI, o modelo está pronto para produção em aplicações reais exigentes. Equipes que avaliarem tanto Astra quanto Sol, medirem seu próprio custo por tarefa e projetarem a supervisão adequada extrairão o maior valor.

