
TL;DR
Grok 4.7 e Xiaomi MiMo-V2.6 chegaram com um dia de diferença, mas representam duas abordagens distintas para IA de fronteira. O Grok 4.7 enfatiza um stack de agentes proprietário e altamente integrado para codificação e trabalho profissional com conhecimento, enquanto o MiMo-V2.6-Pro combina pesos abertos, uma janela de contexto maior, compreensão multimodal nativa e preços de API agressivos.
A SpaceXAI posiciona o Grok 4.7 como seu modelo de fronteira para codificação, tarefas agenticas e trabalho com conhecimento, com janela de contexto de 500 mil tokens e esforço de raciocínio configurável.
A Xiaomi posiciona o MiMo-V2.6-Pro como um flagship multimodal com 1M de contexto, com pesos abertos e suporte a compreensão de texto, imagem, áudio e vídeo.
Em resumo: o Grok 4.7 é o produto mais verticalmente integrado de agentes gerenciados; o MiMo-V2.6-Pro dá aos desenvolvedores mais controle de implantação e preços de tokens brutos muito mais baixos. A melhor escolha depende da carga de trabalho, e não de um único benchmark.
Principais conclusões
- O Grok 4.7 é feito para codificação de longo prazo e agentes profissionais. Na avaliação publicada pelo fornecedor da SpaceXAI, ele marca 46,3% no CursorBench 4.0, 71,0% no DeepSWE v1.1 em esforço alto e 1.657 no AA Briefcase v1.1.
- O MiMo-V2.6-Pro é incomumente competitivo para um modelo aberto. A Xiaomi publica os pesos do modelo e relata resultados próximos aos de sistemas proprietários de fronteira em vários benchmarks de codificação e agentes, mas pontuações entre fornecedores não são diretamente intercambiáveis.
- O MiMo tem vantagem em contexto e multimodalidade. O MiMo-V2.6-Pro suporta uma janela de contexto de 1M de tokens e compreensão de texto, imagem, áudio e vídeo, contra 500 mil tokens do Grok 4.7 com entrada de texto e imagem.
- O MiMo é substancialmente mais barato em tokens brutos de API. Os preços padrão oficiais são de $0,435/$0,87 por milhão de tokens de entrada/saída não em cache para o MiMo-V2.6-Pro, contra $2/$6 para o Grok 4.7.
- A arquitetura de implantação é a troca decisiva. O Grok oferece um stack de ferramentas de primeira parte mais forte; os pesos abertos do MiMo permitem implantação privada, serving customizado e controle de infraestrutura mais profundo.
Grok 4.7 vs MiMo-V2.6-Pro em um relance
| Dimensão | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Lançamento | 21 de setembro de 2026 | 22 de setembro de 2026 |
| Acesso e controle | API proprietária e ecossistema de agentes gerenciados | Pesos abertos, opção de auto-hospedagem e acesso via API |
| Evidências de desempenho | Força relatada pelo provedor em codificação e tarefas de agentes de longa duração; validar no mesmo harness de tarefas | Força relatada pelo provedor em raciocínio, codificação e tarefas multimodais; validar no mesmo harness de tarefas |
| Pontos fortes distintivos | Ferramentas de primeira parte, fluxos gerenciados e agentes conectados à Web/X | Controle de implantação, contexto de 1M de tokens e compreensão de texto/imagem/áudio/vídeo |
| Janela de contexto | 500 mil tokens | 1 milhão de tokens |
| Modalidades de entrada | Texto e imagem | Texto, imagem, áudio e vídeo |
| Preço oficial padrão por 1M tokens entrada/saída | $2 / $6 | $0,435 / $0,87 |
| Raciocínio | Baixo a xHigh | Raciocínio profundo |
| Pesos abertos | Não | Não |
| Melhor adequação | Fluxos gerenciados de codificação e agentes | Implantação privada, entrada multimodal e menor custo de tokens brutos |
O que é o Grok 4.7?
A SpaceXAI lançou oficialmente o Grok 4.7 em 21 de setembro de 2026 como seu modelo mais capaz para codificação e trabalho com conhecimento. O lançamento é relevante porque reportagens prévias misturaram fatos confirmados com alegações de arquitetura vazadas. A documentação final do lançamento não publica contagem total ou ativa de parâmetros, então estimativas prévias não devem ser tratadas como especificações oficiais.
Segundo o post oficial de lançamento, o Grok 4.7 usa um novo modelo base, maior, do que o Grok 4.6 e foi treinado com uma execução de aprendizado por reforço mais longa, ponderada para problemas que levam muitas horas para serem concluídos.
Os modelos otimizam camadas diferentes do stack. O Grok 4.7 fornece um ambiente gerenciado mais rico ao redor do modelo; o MiMo-V2.6-Pro expõe mais do modelo e da camada de implantação aos desenvolvedores.
Para prompts acima de 200 mil tokens, a SpaceXAI aplica precificação de contexto alto. A faixa publicada é de $4 por milhão de tokens de entrada, $1 por milhão de tokens de entrada em cache e $12 por milhão de tokens de saída.
Mudanças no Grok 4.7
A mudança mais significativa é o objetivo de treinamento, não apenas um número de benchmark mais alto. A SpaceXAI diz que sua mistura de aprendizado por reforço mudou para tarefas mais longas, de várias horas, enquanto o modelo foi treinado para verificar seu próprio trabalho com mais cuidado e para entender nativamente o harness do Grok Bot. Essa combinação mira a execução real de agentes: manter estado, usar ferramentas, checar trabalho intermediário e permanecer coerente em trajetórias longas de tarefas.
Desempenho do Grok 4.7
| Benchmark publicado pela SpaceXAI | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
* A SpaceXAI marca o DeepSWE do Grok 4.7 como esforço alto. Estas são avaliações publicadas pelo fornecedor e devem ser interpretadas conforme o harness e configurações de raciocínio documentados.
A SpaceXAI apresenta os gráficos do lançamento como conteúdo web nativo na página oficial do anúncio; a tabela acima preserva os valores de benchmark divulgados sem substituir por um gráfico redesenhado.
O que é o Xiaomi MiMo-V2.6?
A Xiaomi lançou oficialmente e abriu o MiMo-V2.6 em 22 de setembro de 2026. A família inclui MiMo-V2.6-Pro e MiMo-V2.6-Flash, com uma opção Pro-UltraSpeed de serving para cargas sensíveis à latência. Para comparação direta com o Grok 4.7, o MiMo-V2.6-Pro é o flagship apropriado.
Os materiais oficiais da Xiaomi documentam separadamente pesos abertos, entrada multimodal nativa e preços da API. Essa combinação torna o MiMo-V2.6 relevante além dos placares de benchmarks.
MiMo-V2.6 vs MiMo-V2.5: o que melhorou?
A manchete de arquitetura não é simplesmente um checkpoint maior. O lançamento público da Xiaomi foca fortemente em pós-treinamento e Live RL. Segundo as notas oficiais de lançamento, Pro e Flash completaram 30 passos de aprendizado por reforço cada e juntos geraram cerca de 750.000 trajetórias; os custos divulgados da etapa de RL foram aproximadamente $2,62 milhões para o Pro e $850.000 para o Flash.
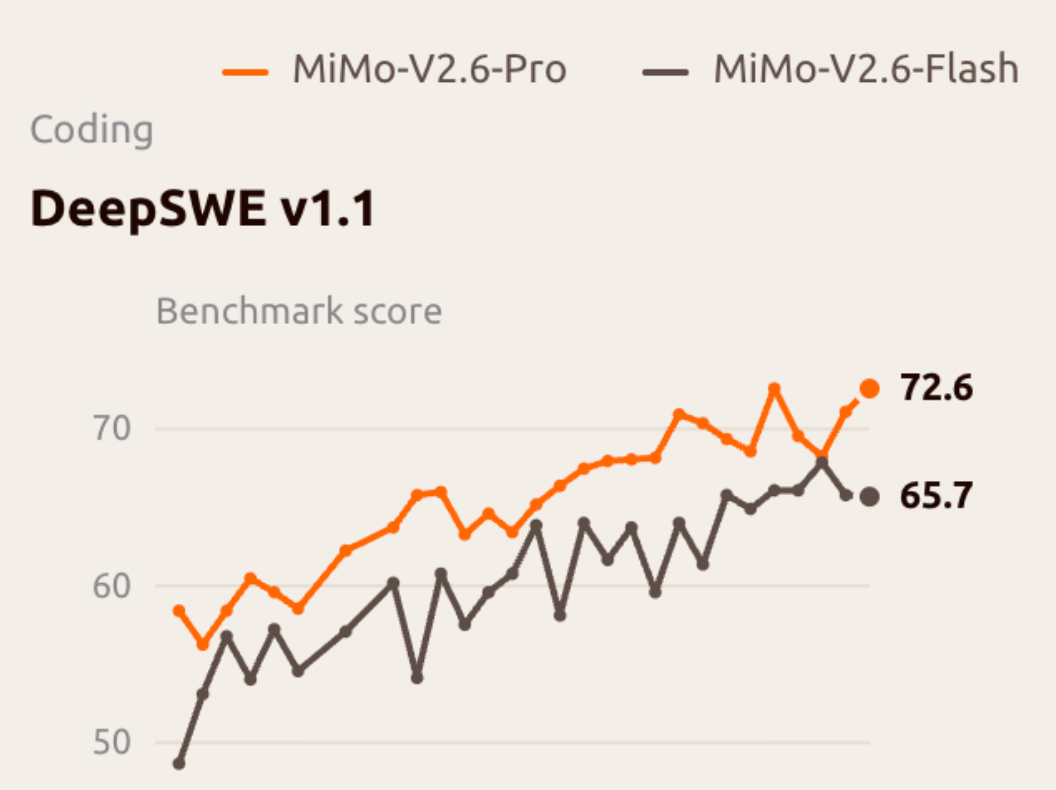
Um detalhe de benchmark merece cuidado: a curva de Live RL da Xiaomi mostra o MiMo-V2.6-Pro atingindo cerca de 72,6 no DeepSWE v1.1 durante a execução de treinamento, enquanto a tabela final de comparação reporta 71,9. Esses números referem-se a contextos de avaliação diferentes e não devem ser mesclados silenciosamente.
Grok 4.7 vs MiMo-V2.6-Pro: comparação de benchmarks
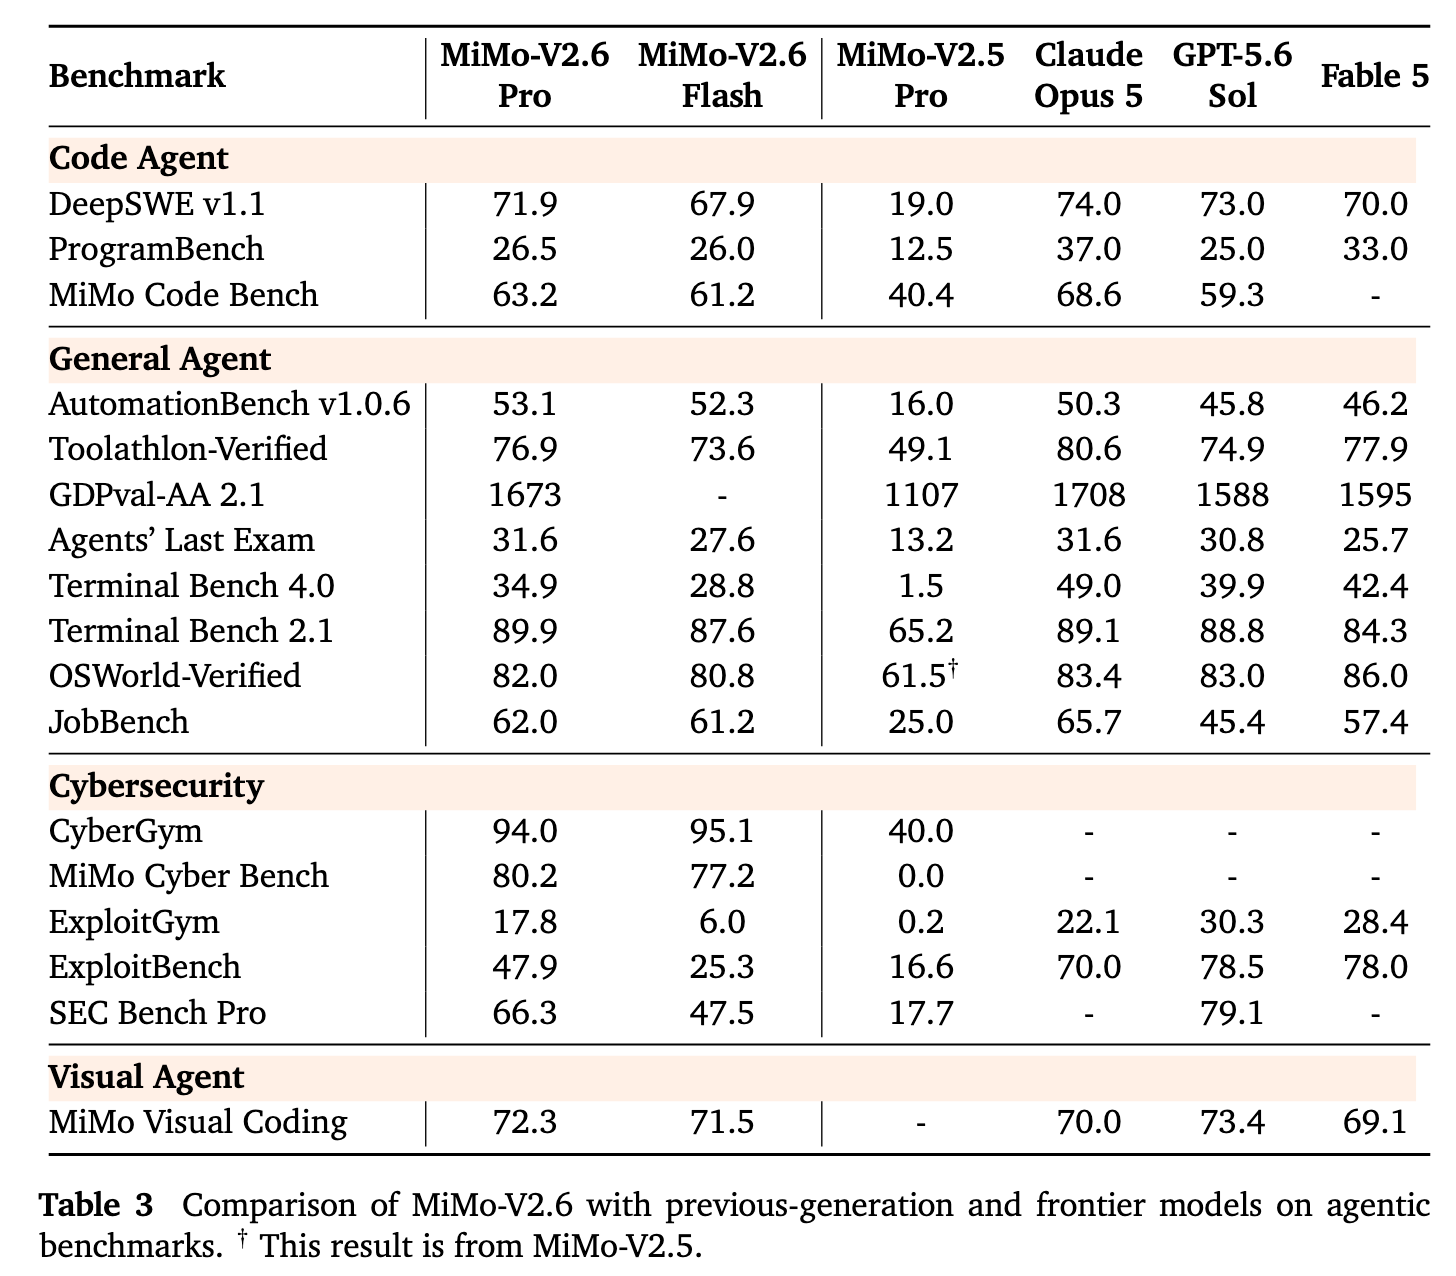
Comparações diretas de benchmark exigem cautela. Os fornecedores nem sempre usam harnesses, orçamentos de raciocínio, checkpoints ou configurações de ferramentas idênticos. Mesmo quando os nomes de benchmarks coincidem, pequenas diferenças de pontuação podem ser menos significativas do que aparentam. A comparação mais segura é separar medições genuinamente alinhadas de evidências direcionais.
Artificial Analysis Intelligence Index
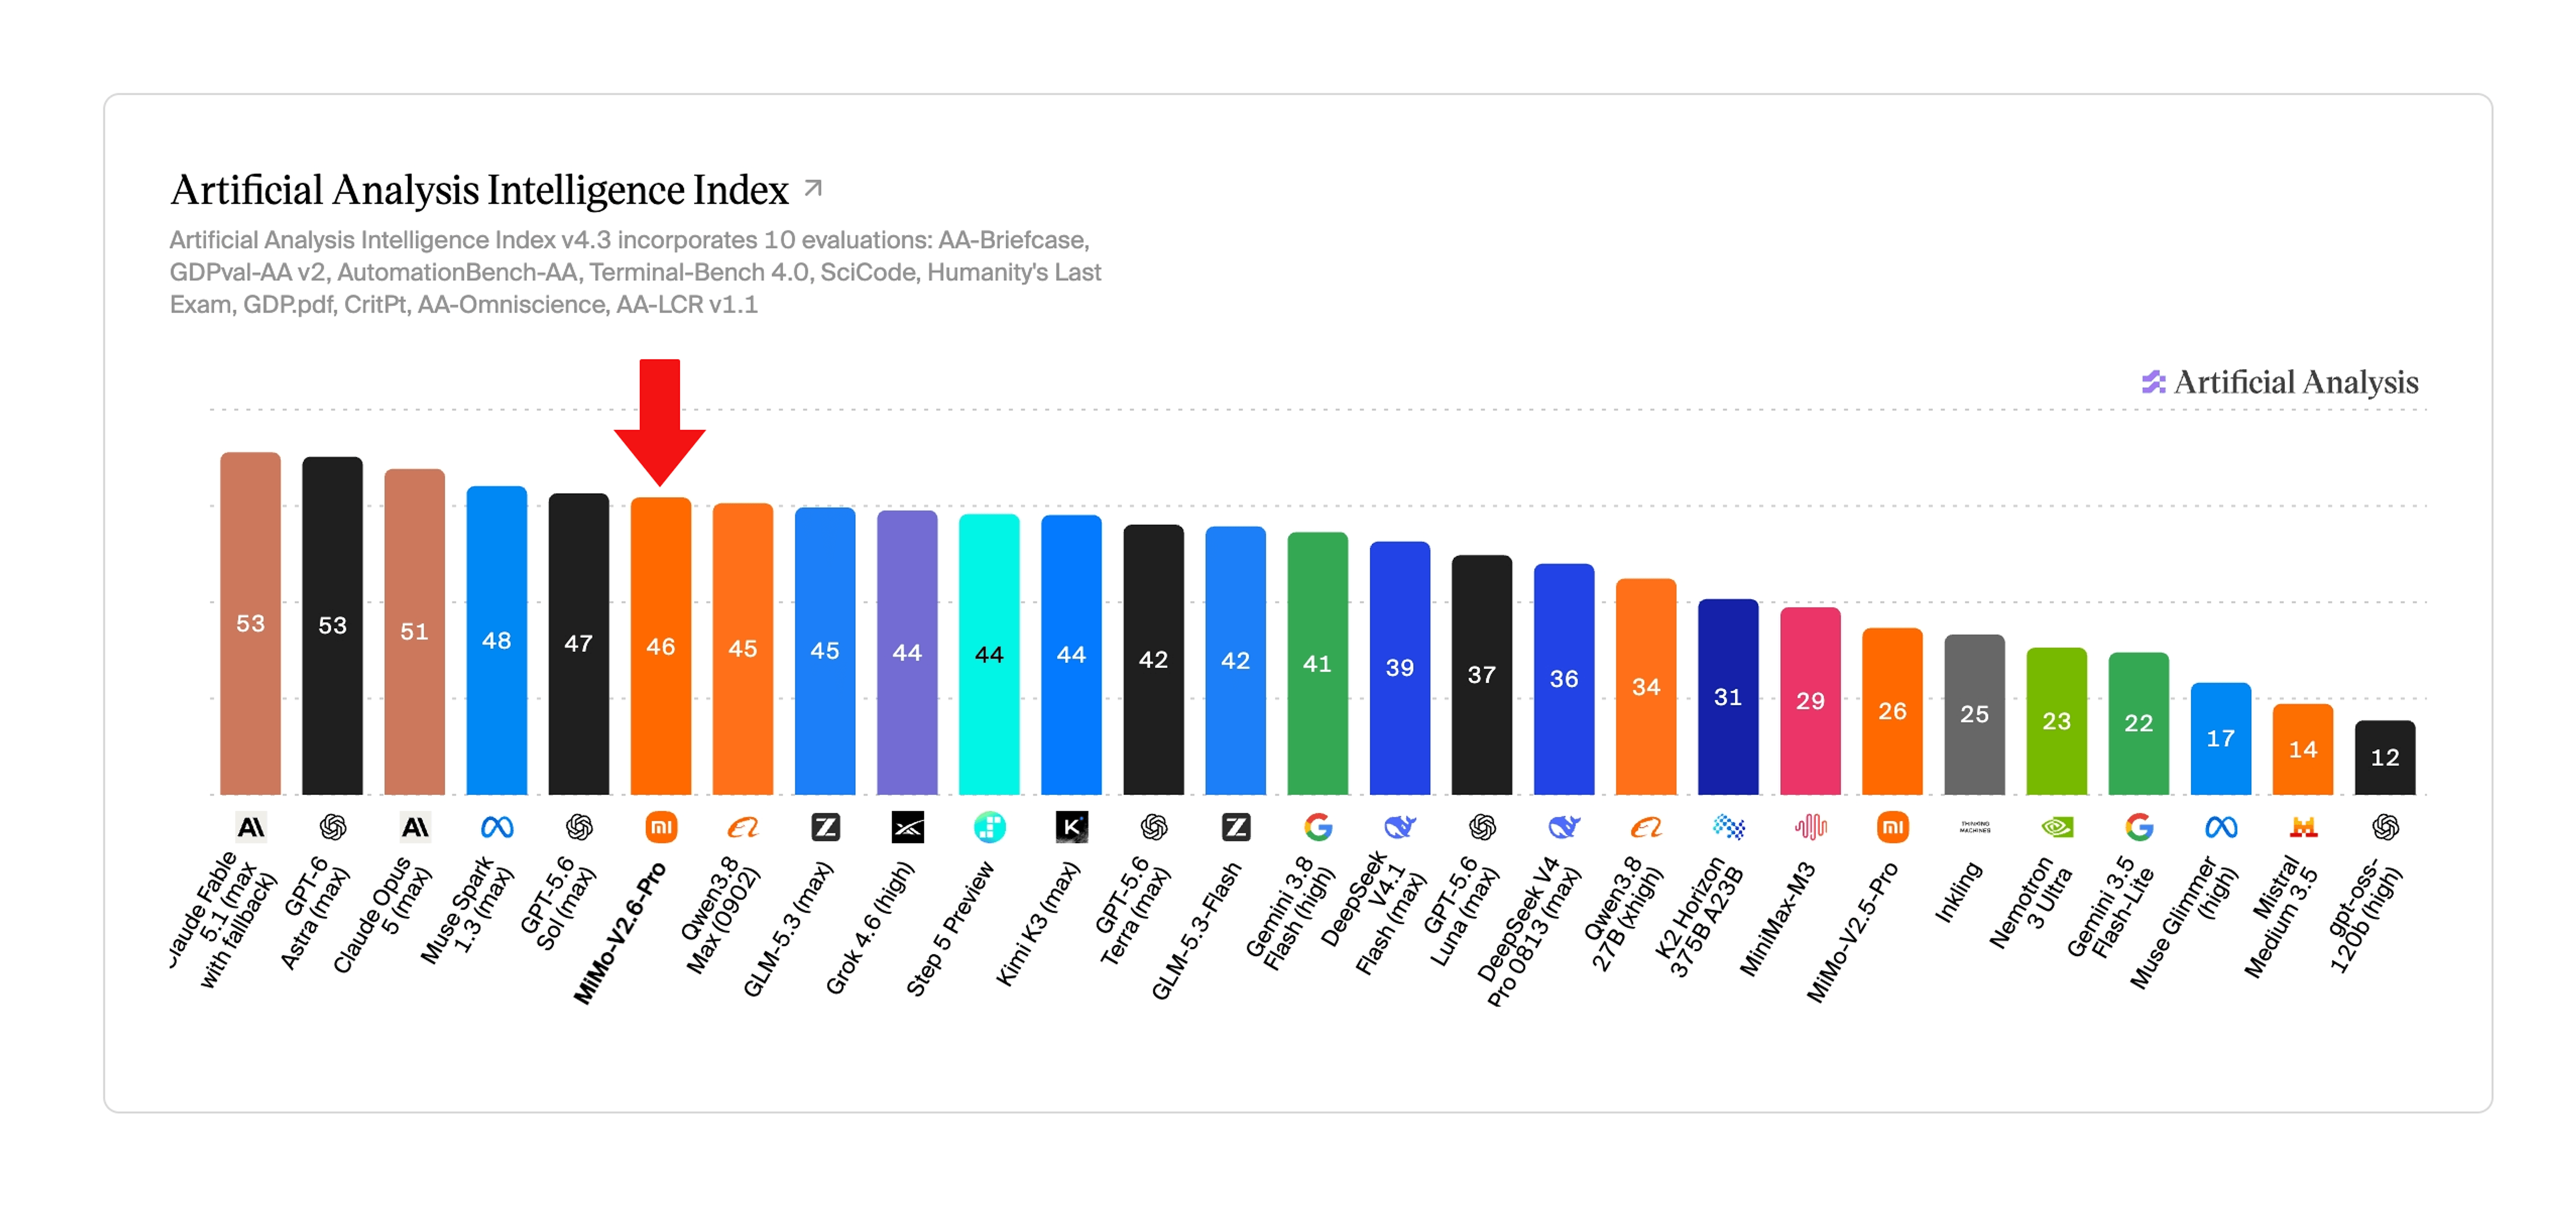
A Xiaomi reporta 46,32 para o MiMo-V2.6-Pro no índice composto Artificial Analysis. Qualquer comparação com o Grok deve estar vinculada ao snapshot exato do Artificial Analysis e à configuração de modelo usada; uma alegação de igualdade arredondada não deve ser apresentada sem essa fonte.
Desempenho em codificação e agentes
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretação |
|---|---|---|---|
| DeepSWE v1.1 | 71,0* | 71,9** | Próximos numericamente; execuções e configurações diferem |
| GDPval-AA | Ver gráfico da SpaceXAI | 1.673 | Apenas direcional, a menos que os harnesses estejam alinhados |
| AA Briefcase | 1.657 | Ver gráfico da Xiaomi | Use valores do fornecedor com o contexto de origem |
| Terminal-Bench 4.0 | 38,0 | 34,9 | Direção semelhante; o harness importa |
| Janela de contexto | 500K | 1M | MiMo suporta mais contexto de trabalho |
* A SpaceXAI reporta o DeepSWE do Grok 4.7 em esforço alto. ** A tabela final da Xiaomi reporta 71,9; sua curva de treinamento Live RL atinge cerca de 72,6. Essas cifras vêm de contextos de avaliação diferentes.
Adequação ao fluxo de trabalho de codificação
Para codificação, a distinção depende de se “codificação” significa resolver problemas de repositório bruto ou uma experiência completa de agente de codificação gerenciado. No DeepSWE v1.1, os números publicados são próximos o suficiente para que uma diferença inferior a um ponto não deva decidir sozinha a seleção de produção.
A vantagem do Grok 4.7 está mais acima no stack. Ele é integrado ao Grok Build, disponível no Cursor, projetado para entender o harness do Grok Bot e emparelhado com ferramentas de execução de código e busca de primeira parte.
A vantagem do MiMo-V2.6-Pro está mais abaixo no stack. Pesos abertos tornam prático construir um assistente de codificação privado, personalizar o serving, impor controles de residência de dados ou experimentar um harness de agente proprietário.
Para equipes escolhendo entre eles, um teste A/B de produção em repositórios representativos será mais informativo do que um único benchmark público de codificação.
Grok 4.7 vs MiMo-V2.6-Pro: diferenças de capacidade multimodal
Esta é uma das diferenças mais claras. O Grok 4.7 aceita entradas de texto e imagem e produz texto. A plataforma mais ampla do Grok oferece produtos de mídia separados, mas esses não devem ser confundidos com a superfície de modalidades do próprio modelo grok-4.7.
O MiMo-V2.6-Pro suporta compreensão de texto, imagem, áudio e vídeo. Combinado com uma janela de contexto de 1M de tokens, isso amplia a gama de fluxos de trabalho que podem ser tratados em um único contexto de modelo.
- Análise de captura de tela e código na mesma tarefa
- Compreensão de vídeo com instruções acompanhantes
- Processamento de áudio de longa duração
- Agentes de uso de computador com feedback visual
- Assistentes de pesquisa multimodais
- Extração multimodal em larga escala e QA
Grok 4.7 vs MiMo-V2.6-Pro: comparação de preços de API
| Preços oficiais da API | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Entrada / 1M tokens | $2,00 | $0,435 |
| Entrada em cache / 1M | $0,50 | $0,0036 |
| Saída / 1M | $6,00 | $0,87 |
| Sobretaxa de contexto longo | Sim, acima de 200K tokens de prompt | Sem faixa padrão comparável publicada |
| Pesos abertos/opção self-host | Não | Sim |
A preço de tabela, o MiMo-V2.6-Pro é várias vezes mais barato tanto na entrada normal quanto na saída gerada, com diferença especialmente grande para contexto em cache. Isso pode afetar materialmente a economia de agentes que processam repetidamente repositórios, documentos longos ou contexto persistente.
Nota importante sobre preços: a janela de contexto de 500 mil do Grok 4.7 não significa que todo o contexto seja faturado na taxa padrão. Solicitações acima de 200 mil tokens de prompt são cobradas na faixa de contexto longo.
Em 24 de setembro de 2026, a CometAPI lista o Grok 4.7 a $1,60 de entrada e $4,80 de saída por 1M de tokens, contra os oficiais $2,00 e $6,00. Lista o MiMo-V2.6-Pro a $0,348 de entrada e $0,696 de saída, contra os oficiais $0,435 e $0,87. Essas tarifas padrão listadas são 20% abaixo das correspondentes oficiais. Preços e elegibilidade podem mudar; confirme as páginas de modelo ao vivo antes de orçar.
Preço por token não é idêntico a custo por tarefa concluída. Modelos de raciocínio podem consumir volumes diferentes de tokens, usar números distintos de chamadas de ferramentas e exigir taxas de repetição diferentes. A avaliação de produção deve, portanto, acompanhar custo por tarefa concluída, latência e taxa de sucesso em conjunto.
Grok 4.7 vs MiMo-V2.6-Pro: acesso e disponibilidade
A diferença de acesso é direta: o Grok 4.7 está disponível via API e fluxos gerenciados do Grok, enquanto seus pesos de modelo não são oferecidos para auto-hospedagem. O MiMo-V2.6-Pro está disponível via API e como pesos abertos, dando às equipes uma rota adicional de auto-hospedagem.
Disponibilidade é separada de licenciamento ou flexibilidade de implantação. Em 24 de setembro de 2026, ambos os modelos também têm páginas de catálogo ativas na CometAPI. As equipes devem confirmar endpoint, região, limites de taxa e elegibilidade de conta antes da implantação em produção; um modelo listado não garante disponibilidade ou níveis de serviço idênticos para todas as contas.
| Pergunta de disponibilidade | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| API oficial | Disponível via xAI | Disponível via Xiaomi MiMo |
| Catálogo CometAPI | Listado como disponível | Listado como disponível |
| Pesos auto-hospedados | Não disponíveis | Opção de pesos abertos |
| Verificação operacional | Confirmar acesso da conta, região, limites de taxa e disponibilidade de ferramentas | Confirmar acesso da conta, prontidão do endpoint e requisitos de auto-hospedagem |
Pesos abertos e acesso proprietário
O MiMo-V2.6-Pro ser de pesos abertos muda a comparação mais do que uma diferença de um ponto em benchmark. Cria opções para implantação privada, ajuste do mecanismo de inferência, pós-treinamento customizado, controles de residência de dados e integração de infraestrutura mais profunda.
O Grok 4.7 faz a troca oposta: menos controle sobre os internos do modelo em troca de um serviço gerenciado, continuamente operado, e um ecossistema de primeira parte fortemente integrado. Para muitas organizações, requisitos de governança e infraestrutura determinarão a shortlist antes do desempenho em benchmarks.
Como usar as APIs do Grok 4.7 e do MiMo V2.6 na CometAPI
Os desenvolvedores podem acessar a API do Grok 4.7 na CometAPI por meio de um fluxo de API unificado, reduzindo a necessidade de manter integrações específicas por provedor.
Para equipes que fazem benchmark de vários modelos de fronteira, uma camada de API unificada é especialmente útil porque os mesmos prompts de produção, harness de teste, contabilização de tokens e código de aplicação podem ser reproduzidos entre modelos com menos variáveis de integração.
A CometAPI agora lista o MiMo-V2.6-Pro como disponível, com disponibilidade de API confirmada em 22 de setembro de 2026. Verifique o catálogo ao vivo e o acesso da conta antes do uso em produção.
Com ambas as páginas de modelo agora listadas como disponíveis, um teste A/B em nível de aplicação pode manter prompts, ferramentas, configurações de raciocínio e critérios de sucesso o mais consistentes possível e, em seguida, comparar conclusão de tarefas, latência, uso de tokens e modos de falha.
Grok 4.7 vs MiMo-V2.6-Pro: adequação por caso de uso
| Requisito | Adequação do modelo / orientação de avaliação |
|---|---|
| Busca de primeira parte na Web e no X | Grok 4.7 |
| Agentes de longa duração gerenciados | Grok 4.7 |
| Fluxos Grok Build / Cursor | Grok 4.7 |
| Contexto de 1M tokens | MiMo-V2.6-Pro |
| Compreensão nativa de áudio/vídeo | MiMo-V2.6-Pro |
| Pesos abertos, auto-hospedagem e controle | MiMo-V2.6-Pro |
| Menor custo bruto de tokens de API | MiMo-V2.6-Pro |
| Codificação de repositório | Fazer benchmark de ambos em repositórios representativos |
| Agentes profissionais de conhecimento | Fazer benchmark de ambos em tarefas de produção |
A decisão, portanto, deve ser enquadrada em torno da arquitetura da carga de trabalho. O Grok 4.7 é projetado para tornar um stack de agentes gerenciados mais capaz; o MiMo-V2.6-Pro é projetado para tornar a inteligência de ponta mais barata, mais multimodal e mais controlável.
Qual escolher?
Escolha o Grok 4.7 se você quer uma experiência de agente gerenciado com busca na Web e no X de primeira parte, execução nativa de código e menos infraestrutura para operar. É a opção mais prática para equipes que valorizam um stack de ferramentas integrado e fluxos de trabalho profissionais ou de codificação de longa duração.
Escolha o MiMo-V2.6-Pro se você precisa de pesos abertos, implantação privada, uma janela de contexto de 1M de tokens, compreensão nativa de áudio e vídeo ou preços de API substancialmente mais baixos. É a opção mais forte quando controle de implantação, cobertura multimodal e eficiência de custos são as principais restrições.
Se a escolha ainda não estiver clara, rode ambos os modelos nas mesmas tarefas representativas com prompts, ferramentas, orçamentos de raciocínio, timeouts e políticas de repetição idênticos. Selecione o modelo que oferece a melhor combinação de taxa de conclusão, latência, custo total por tarefa bem-sucedida e esforço de revisão humana.
Conclusão
Grok 4.7 vs MiMo V2.6 é revelador porque inteligência bruta não é mais o único diferenciador significativo. Ambos os modelos ocupam uma faixa de alta capacidade semelhante nas avaliações públicas atuais, mas suas estratégias de produto divergem fortemente.
O Grok 4.7 combina uma janela de contexto de 500 mil tokens, raciocínio configurável, treinamento forte para agentes de longo horizonte e um stack maduro de busca e execução de primeira parte. O MiMo-V2.6-Pro combina uma janela de contexto de 1M, entradas multimodais nativas, pesos abertos e preços de API muito abaixo de muitos sistemas proprietários de fronteira.
Para desenvolvedores, a questão prática é, portanto, menos “qual pontuação de benchmark é maior?” e mais “onde a inteligência deve residir?” Um ecossistema de agentes gerenciados e um stack de modelo aberto e personalizável resolvem problemas operacionais diferentes. A escolha certa é a que melhor corresponde à carga de trabalho de produção, às restrições de infraestrutura e ao modelo de custos.
Perguntas frequentes
O Grok 4.7 é um modelo de 2,1 trilhões de parâmetros?
Um número aproximado de 2,1T circulou antes do lançamento, mas a documentação final do Grok 4.7 da SpaceXAI não publica contagens totais ou ativas de parâmetros. A declaração confirmada é que o Grok 4.7 usa um modelo base maior que o Grok 4.6.
O MiMo-V2.6 é open source?
A Xiaomi lançou o MiMo-V2.6 como uma família de modelos abertos com pesos baixáveis e recursos de pesquisa associados. No planejamento de produção, as equipes ainda devem revisar a licença exata do modelo e os termos de redistribuição para o uso pretendido.
Quanto custa uma tarefa de agente concluída com Grok 4.7 vs MiMo-V2.6-Pro?
Normalize o conjunto de tarefas, prompts, permissões de ferramentas, política de repetição e critérios de sucesso. Acompanhe tokens totais de entrada, entrada em cache, raciocínio e saída, chamadas de ferramentas, latência, repetições e tempo de revisão humana. O preço por token bruto é apenas um componente do custo por tarefa concluída.
Quão confiáveis são as comparações de benchmarks entre Grok 4.7 e MiMo-V2.6-Pro?
Use o mesmo repositório ou conjunto de tarefas, harness de agente, ferramentas, orçamento de raciocínio, timeout, política de repetição e rubrica de pontuação. Relate intervalos de confiança ou variação de execuções repetidas e mantenha separados os números publicados pelos fornecedores dos resultados internos.
O Grok 4.7 cobra mais por prompts de contexto longo?
A SpaceXAI documenta tarifas mais altas quando os tokens de prompt excedem 200 mil. Como a faixa mais alta se aplica à solicitação, equipes que usam repositórios grandes ou contexto persistente de agentes devem modelar explicitamente esse limiar.