
TL;DR
DeepSeek-V4.1-Flash tem pesos abertos e pode ser auto-hospedado, mas “local” não significa “em um PC gamer”. A DeepSeek o descreve como um backbone Mixture-of-Experts de 552B parâmetros usando uma arquitetura Causal Encoder-Decoder, com apenas 8B parâmetros ativos durante o processamento do prompt e 16B durante a geração. O modelo completo permanece um alvo de implantação em escala de fronteira.
A receita atual de implantação com vLLM coloca o checkpoint em aproximadamente 511 GB em disco e cerca de 614 GB de VRAM mínima, tornando um servidor da classe 8×H200 ou sistema de memória alta comparável muito mais realista do que uma estação de trabalho de consumo.
Para equipes que só precisam de acesso, e não de controle no nível dos pesos, a API DeepSeek V4.1 Flash no CometAPI é substancialmente mais simples do que manter um servidor de inferência multi-GPU.
Principais pontos
- DeepSeek-V4.1-Flash usa um backbone MoE de 552B com 8B de parâmetros ativos durante prefill e 16B durante decode; parâmetros ativos não representam o requisito de memória residente.
- Sua janela de contexto de 1.048.576 tokens e KV cache global de 890 bytes por token reduzem a pressão do cache, mas os pesos do modelo ainda dominam o planejamento de capacidade.
- O checkpoint oficial tem cerca de 511 GB em disco. A receita do vLLM estima aproximadamente 614 GB de VRAM utilizável agregada como orçamento mínimo para carregar o modelo e sua sobrecarga de runtime; isso é uma estimativa de base, não uma garantia para todo tamanho de lote, comprimento de contexto ou configuração multimodal.
- vLLM é o caminho mais claro para serving em produção, enquanto SGLang mira inferência distribuída avançada; a rota atual do Ollama é hospedada na nuvem, e não inferência totalmente local.
- Auto-hospedagem é mais atraente para privacidade, operação air-gapped, pesquisa no nível dos pesos ou utilização sustentada do cluster; a maioria dos desenvolvedores achará uma API hospedada mais simples.
O que é DeepSeek-V4.1-Flash? Arquitetura, parâmetros e tamanho do modelo
A DeepSeek lançou oficialmente o V4.1-Flash em 10 de setembro de 2026 como o menor modelo em sua nova família de arquitetura, com compreensão visual nativa. Apesar do nome “Flash”, não é um modelo denso pequeno.
Sua principal mudança arquitetural é o design Causal Encoder-Decoder (CED). O modelo divide o cálculo de forma assimétrica entre ingestão do prompt e geração de tokens, reduzindo o compute ativo enquanto mantém um pool de especialistas muito grande.
| Especificação | DeepSeek-V4.1-Flash |
|---|---|
| Arquitetura | MoE multimodal com Causal Encoder-Decoder |
| Parâmetros do backbone | 552B |
| Parâmetros ativos, entrada | 8B |
| Parâmetros ativos, saída | 16B |
| Camadas Transformer | 40: 20 encoder + 20 decoder |
| Janela de contexto | 1,048,576 tokens |
| KV cache global | 890 bytes/token |
| Modalidades | Entrada de texto + imagem, saída de texto |
| Licença dos pesos | MIT |
| Amostragem recomendada | Temperature 1.0; top_p 0.95 ou 1.0 |
| Pesos oficiais | Hugging Face |
| Opções primárias de serving local | vLLM, SGLang, referência de inferência DeepSeek |
A distinção entre parâmetros ativos e residentes é essencial. O roteamento MoE reduz a quantidade de computação usada para um token individual, mas o servidor ainda precisa ter acesso aos pesos dos especialistas que podem ser selecionados. É por isso que um modelo “8B ativos” ainda pode exigir centenas de gigabytes de armazenamento e memória de acelerador.
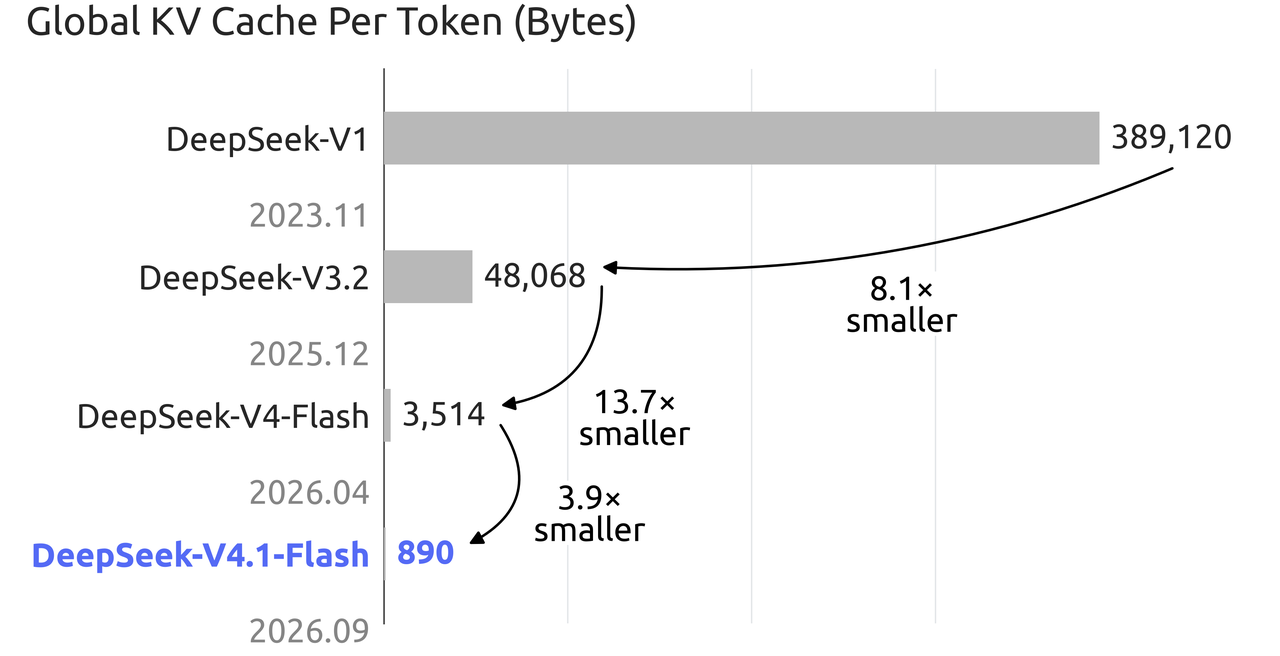
O gráfico oficial de KV cache da DeepSeek mostra o cache global caindo de 3.514 bytes por token no V4 Flash para 890 bytes por token no V4.1 Flash, uma redução de cerca de 3,9×. Isso importa para inferência com um milhão de tokens, mas não elimina o requisito de memória muito maior criado pelos próprios pesos do modelo.
Quão bom é o DeepSeek-V4.1-Flash antes de você implantá-lo?
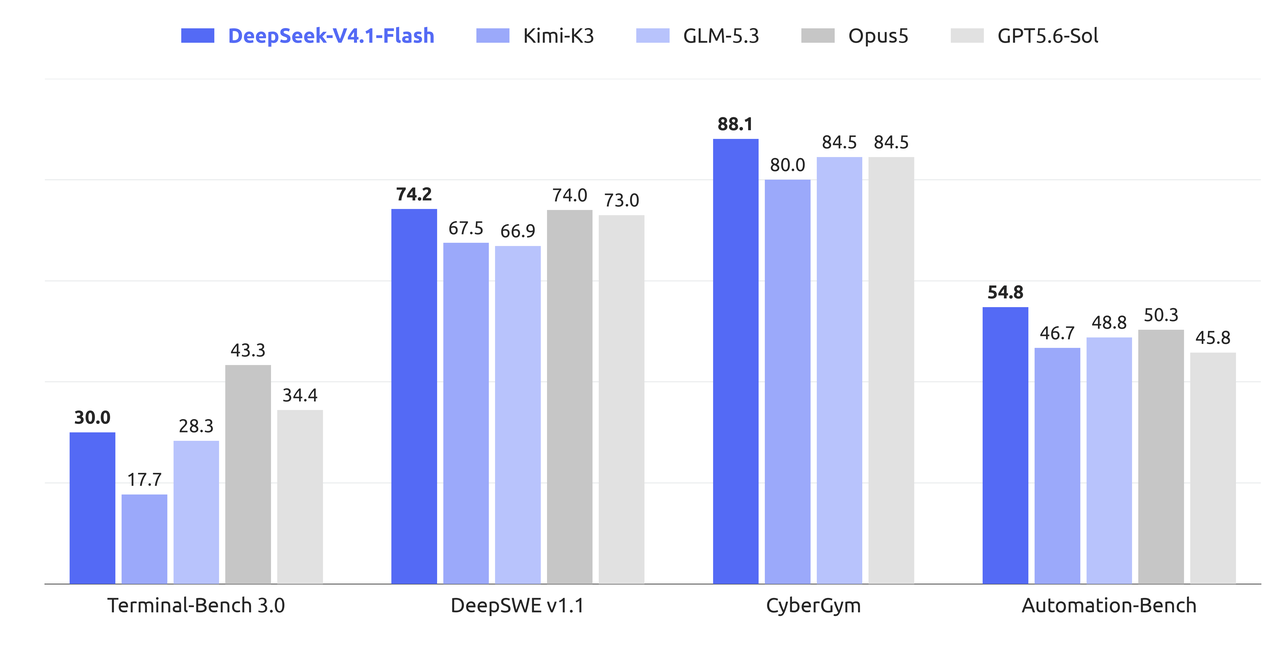
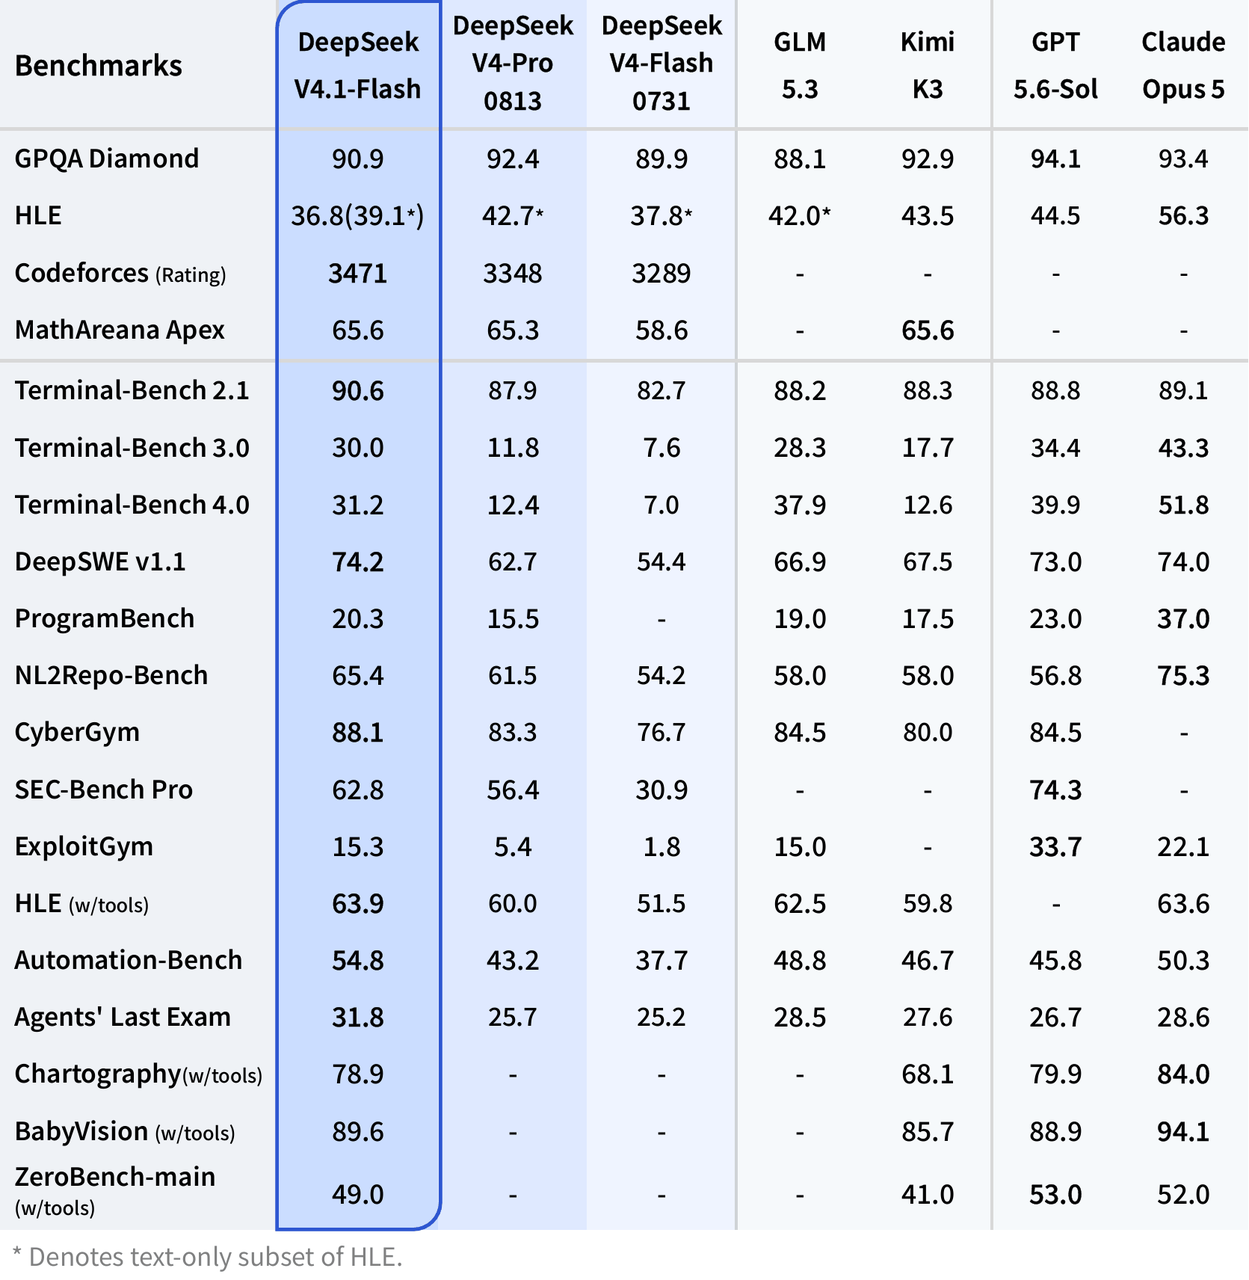
A tabela de benchmarks publicada pela DeepSeek posiciona o V4.1-Flash principalmente como uma grande atualização em coding agente, operação de terminal, automação e cargas de trabalho de engenharia de software. Estes são resultados de benchmark relatados pelo fornecedor, portanto devem ser tratados como medidas de referência e não como desempenho garantido em aplicações.
Para reprodutibilidade, o model card oficial recomenda temperature 1.0 e top_p 0.95, enquanto o esforço de raciocínio e os orçamentos de tokens variam por avaliação. As figuras abaixo são resultados de referência executados pelo fornecedor, não garantias de desempenho neutras de hardware; detalhes específicos do harness do benchmark devem ser consultados antes de reproduzi-los.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
O padrão é mais importante do que qualquer pontuação isolada. O V4.1-Flash não lidera todos os benchmarks, mas o salto em relação ao V4 Flash 0731 é especialmente grande em Terminal-Bench, DeepSWE, automação e cargas de trabalho de cibersegurança. Isso torna a implantação local particularmente relevante para agentes de código privados, análise em escala de repositório, automação interna e infraestrutura de agentes air-gapped.
Você realmente pode executar DeepSeek-V4.1-Flash localmente?
Sim, mas a palavra “localmente” precisa de qualificação. A última receita do vLLM para DeepSeek-V4.1-Flash decompõe o checkpoint em aproximadamente meio terabyte e recomenda um orçamento de VRAM muito maior quando a sobrecarga de runtime é incluída.
| Componente | Tamanho aproximado armazenado |
|---|---|
| Routed + especialistas DSpark | 259.5 GiB |
| Tabelas Engram | 183.1 GiB |
| Atenção, projeções densas e roteadores | 6.9 GiB |
| Embeddings, LM head e normas | 3.9 GiB |
| Escalas de bloco UE8M0 | 21.9 GiB |
| Checkpoint completo | ~476 GiB / ~511 GB |
| Orçamento mínimo de VRAM recomendado pelo vLLM | ~614 GB |
A principal surpresa é que o V4.1-Flash já é fortemente comprimido internamente. Pesos de especialistas roteados usam formatos de baixa precisão, portanto o checkpoint oficial não é simplesmente um modelo BF16 enorme esperando por uma conversão fácil para 4 bits.
Requisitos de hardware do DeepSeek-V4.1-Flash
| Configuração de hardware | Status prático | Comentários |
|---|---|---|
| 1× RTX 4090 / 5090 | Não | Muito abaixo do footprint de memória do modelo |
| 2–4 GPUs de consumo | Não para o checkpoint oficial completo | A VRAM agregada permanece insuficiente |
| Estação de trabalho 128 GB | Não | Parâmetros ativos não determinam a memória residente dos pesos |
| Estação de trabalho 256 GB | Não para a rota oficial de serving | Ainda bem abaixo do footprint do checkpoint oficial |
| 512 GB RAM do sistema + offload para GPU | Experimental | Território da comunidade/offload, não equivalente a serving de produção verificado |
| 4× GPUs de datacenter de alta memória | Dependente do hardware | Possível com aceleradores modernos suficientemente grandes; verifique a receita de runtime |
| 8× H200 | Sim, classe documentada | Cerca de 1.128 GB de HBM agregada |
| Sistema classe GB200 NVL4 | Sim | vLLM cita um tray de 768 GB como acomodando o modelo |
Importante: 8B de parâmetros ativos não significa 8 GB de VRAM. “Ativos” descreve quanto da rede MoE participa no cálculo de um token. O conjunto completo de especialistas ainda precisa ser armazenado em algum lugar acessível ao mecanismo de inferência.
Qual runtime você deve usar para o DeepSeek-V4.1-Flash?
| Runtime | Status atual do V4.1-Flash | Melhor uso |
|---|---|---|
| vLLM | Receita de implantação atual disponível; imagem recente necessária | Serving de produção compatível com OpenAI |
| SGLang | Suportado pelos builds atuais de implantação do DeepSeek-V4.1 | Inferência distribuída de alto desempenho |
| Referência de inferência DeepSeek | Implementação oficial TP8 de referência | Pesquisa de arquitetura e validação |
| Transformers | Integração do modelo exposta no Hugging Face | Desenvolvimento e experimentação; hardware ainda necessário |
| Ollama | A rota atual da biblioteca usa :cloud | Invocação na nuvem conveniente, não equivalente a auto-hospedagem |
Para auto-hospedagem em produção, vLLM é atualmente o ponto de partida mais claro. A orientação de implantação do SGLang fornece outro caminho suportado para inferência distribuída avançada.
Como executar DeepSeek-V4.1-Flash localmente com vLLM
Esta é a rota prática para um servidor Linux multi-GPU.
Todos os exemplos de comandos abaixo foram reformulados como blocos de código específicos da linguagem com descrições concisas em inglês.
Passo 1: Verifique seu ambiente
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Centenas de gigabytes livres de espaço em SSD.
- Uma configuração multi-GPU suportada.
- Cerca de 614 GB de memória de acelerador utilizável agregada para o perfil atual de serving com pesos oficiais.
- Uma rede rápida se o modelo ainda não estiver em cache local.
Passo 2: Baixe os pesos do DeepSeek-V4.1-Flash
Os pesos oficiais estão hospedados no repositório Hugging Face do DeepSeek-V4.1-Flash sob a licença MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Certifique-se de que o sistema de arquivos que contém ~/.cache/huggingface tenha substancialmente mais de 511 GB livres. Arquivos temporários e artefatos adicionais do mecanismo podem aumentar o uso de disco de pico.
Passo 3: Inicie o DeepSeek-V4.1-Flash com vLLM
Conforme a receita atual do vLLM, o suporte ao DeepSeek-V4.1 exige uma imagem do vLLM suficientemente recente. Uma configuração inicial somente texto com oito GPUs pode ser assim:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Há duas escolhas deliberadas aqui. Primeiro, --language-model-only desativa o codificador de visão para cargas de trabalho somente de texto. Segundo, começar com 131.072 tokens é mais seguro do que habilitar imediatamente a janela completa de um milhão de tokens. Quando o servidor estiver estável, você pode aumentar:
--max-model-len 1048576
A configuração apropriada de tensor-parallel depende da topologia do acelerador, então não copie --tensor-parallel-size 8 cegamente para todo servidor.
Passo 4: Teste o endpoint local do DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Passo 5: Chame seu servidor local DeepSeek-V4.1-Flash com Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Como habilitar o Thinking Mode do DeepSeek-V4.1-Flash localmente?
V4.1-Flash suporta controles explícitos de raciocínio através do chat template. Um exemplo é:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Se o modelo parecer retornar pouco ou nenhum conteúdo final com um valor pequeno de max_tokens, verifique se o thinking mode está consumindo o orçamento de geração antes de assumir que a implantação está quebrada.
Como executar o DeepSeek-V4.1-Flash com o código de referência?
A DeepSeek também inclui uma implementação mínima de inferência TP8 dentro do repositório do modelo. Ela é destinada principalmente como código de referência legível, e não como um servidor de produção de alto throughput.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Essa rota é útil para inspecionar CED, roteamento MoE, memória Engram, decoding especulativo e detalhes de implementação relacionados. Para serving normal em produção, vLLM ou SGLang é mais fácil de operar.
Você pode executar DeepSeek-V4.1-Flash localmente com Ollama?
Não no mesmo sentido de executar um modelo Ollama normal de 7B ou 32B. O Ollama atualmente expõe o V4.1-Flash através de:
ollama run deepseek-v4.1-flash:cloud
A parte importante é :cloud. A entrada atual da biblioteca do Ollama usa uma rota na nuvem, portanto esse comando não é equivalente a baixar o modelo completo e realizar inferência inteiramente na sua máquina.
Implantação local do DeepSeek-V4.1-Flash vs API: o que faz mais sentido?
| Dimensão | DeepSeek-V4.1-Flash local | API hospedada |
|---|---|---|
| Hardware inicial | Muito alto | Nenhum |
| Memória do acelerador | ~614 GB alvo oficial prático | Gerenciada pelo provedor |
| Controle do modelo | Total | Limitado |
| Dados permanecem on-premises | Sim | Não |
| Modificação dos pesos | Sim | Não |
| Manutenção | Sua responsabilidade | Gerenciada pelo provedor |
| Complexidade de setup | Alta | Baixa |
| Escalonamento | Requer infraestrutura | Baseado em API |
| Melhor para | Air-gapped, privado, pesquisa, clusters de alta utilização | A maioria dos desenvolvedores e apps de produção |
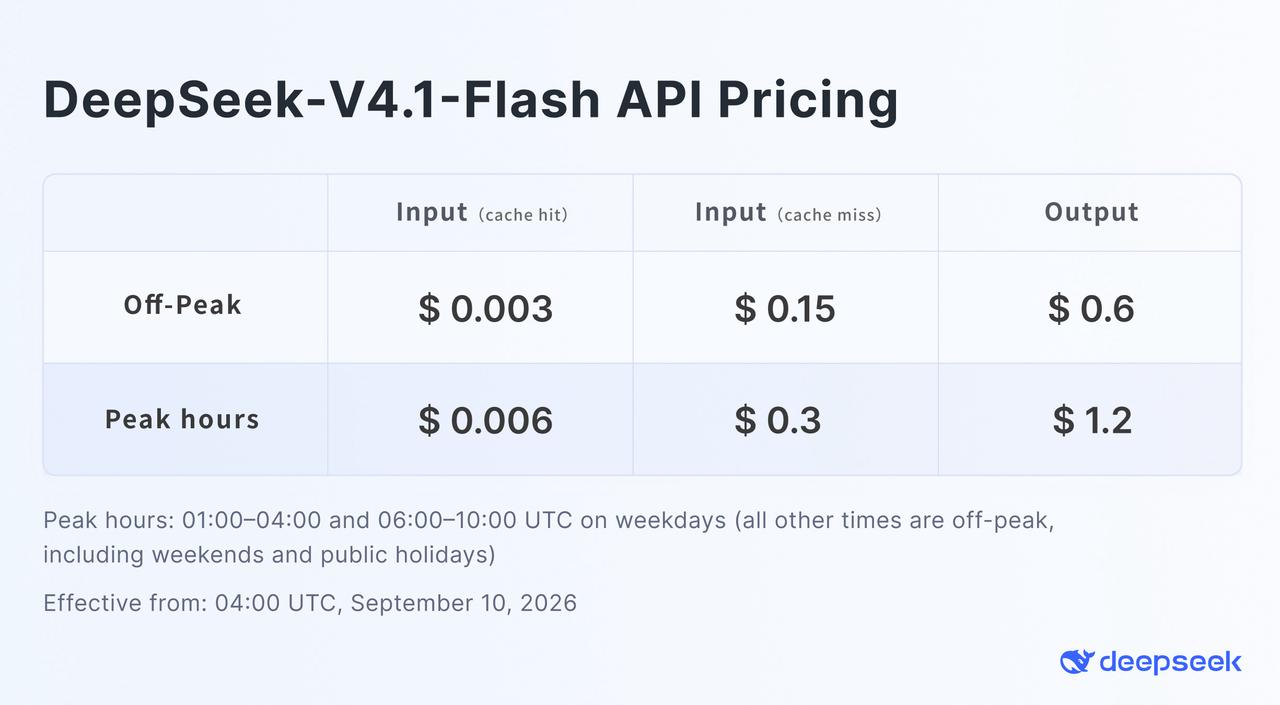
O preço oficial off-peak da DeepSeek é mostrado no gráfico de preços do V4.1-Flash. Para desenvolvedores que não precisam de posse física dos pesos, a DeepSeek V4.1 Flash API no CometAPI fornece uma alternativa compatível com OpenAI. O exemplo a seguir usa o identificador de modelo do CometAPI. Não é o identificador usado pela API oficial da DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
A decisão prática é direta: a implantação local se torna atraente quando privacidade, operação air-gapped, experimentação no nível dos pesos, utilização pesada previsível ou requisitos regulatórios superam o custo de infraestrutura. Para desenvolvimento de aplicação comum, um endpoint hospedado evita centenas de gigabytes de gestão de modelo e orquestração multi-GPU.
Quais problemas você pode encontrar ao executar DeepSeek-V4.1-Flash localmente?
O servidor fica sem memória antes de a geração começar
O checkpoint completo, e não o número de 8B/16B de parâmetros ativos, determina a maior parte do requisito de memória. Verifique o paralelismo de tensor, a utilização de memória da GPU, o carregamento de visão e a HBM disponível.
DeepSeek-V4.1-Flash leva muito tempo para iniciar
Um checkpoint de meio terabyte leva tempo para baixar, mapear, inicializar e fragmentar. Tempos longos para o motor ficar pronto são normais para essa classe de modelo.
A resposta está vazia ou termina com finish_reason=length
O thinking mode pode estar consumindo o orçamento de geração. Aumente max_tokens, reduza o esforço de raciocínio ou desative o thinking para solicitações simples.
Chamadas de ferramenta não são analisadas corretamente
Certifique-se de que o servidor está usando o tokenizer DeepSeek V4.1, o parser de tool-call, o parser de reasoning e as flags de auto-tool-choice.
Entrada de visão não funciona
Se você iniciou com --language-model-only, você desativou intencionalmente o codificador visual. Reinicie com suporte multimodal habilitado antes de testar imagens.
Você deve executar DeepSeek-V4.1-Flash localmente?
DeepSeek-V4.1-Flash é incomumente interessante do ponto de vista de auto-hospedagem porque sua arquitetura reduz substancialmente o compute por token e o custo do KV cache, mas não transforma um modelo de pesos abertos em escala de fronteira em um modelo de desktop.
Para um laboratório de pesquisa, plataforma corporativa de IA, stack de agentes de código privado ou ambiente air-gapped, vLLM e SGLang tornam a auto-hospedagem tecnicamente realista. Para um desenvolvedor com uma ou duas GPUs, não é um alvo prático de implantação do modelo completo. Nesse caso, usar a DeepSeek V4.1 Flash via CometAPI fornece acesso ao modelo sem transformar o serving em um grande projeto de infraestrutura.
FAQ
O DeepSeek-V4.1-Flash é open source?
Seus pesos e repositório são lançados sob a licença MIT, que permite amplo uso, modificação e redistribuição, sujeitos aos termos da licença.
Posso executar o DeepSeek-V4.1-Flash em uma RTX 4090 ou RTX 5090?
Não o modelo oficial completo. Uma única GPU de consumo possui apenas uma fração da memória necessária pelo checkpoint completo.
8B de parâmetros ativos significa que o DeepSeek-V4.1-Flash precisa apenas de 8 GB de VRAM?
Não. A figura de 8B descreve os parâmetros participantes durante o processamento do prompt. A rede completa de especialistas e o estado de suporte ainda precisam ser armazenados e acessíveis.
Quanta VRAM o DeepSeek-V4.1-Flash precisa?
A receita atual do vLLM usa cerca de 614 GB como figura de planejamento para o checkpoint oficial mais a sobrecarga de runtime. As necessidades reais variam com hardware, tamanho de lote, contexto, suporte a visão e configuração de serving.
Quão grande é o DeepSeek-V4.1-Flash em disco?
A decomposição atual do vLLM coloca o checkpoint em aproximadamente 476 GiB, ou cerca de 511 GB.
O DeepSeek-V4.1-Flash pode executar um contexto de 1M tokens localmente?
A arquitetura suporta até 1.048.576 tokens, mas o uso prático de memória também depende do tamanho do lote, buffers de runtime, estado de visão e outras sobrecargas.
Posso executar DeepSeek-V4.1-Flash localmente com Ollama?
A entrada atual do Ollama usa uma rota :cloud, o que não é o mesmo que executar os pesos completos inteiramente na sua própria máquina.
vLLM ou SGLang é melhor para o DeepSeek-V4.1-Flash?
Ambos miram serving de alto desempenho. vLLM atualmente possui uma receita particularmente detalhada específica do V4.1, enquanto SGLang também é adequado para implantações distribuídas avançadas.
Qual é a maneira mais fácil de usar o DeepSeek-V4.1-Flash sem hardware local?
Use uma API hospedada. A DeepSeek fornece sua própria API, enquanto o CometAPI fornece um endpoint DeepSeek-V4.1-Flash compatível com OpenAI ao lado de outros modelos de IA.