
A maneira mais rápida de usar a API do GLM-5.3 Flash é chamar o modelo pelo endpoint de chat-completions compatível com OpenAI da CometAPI. Os detalhes de conexão estão consolidados na tabela de especificações da API abaixo; mantenha a chave de API no servidor.
Resposta primeiro: crie uma chave CometAPI, instale um SDK compatível com OpenAI, envie uma solicitação POST para /v1/chat/completions, depois adicione streaming, visão, saída JSON ou ferramentas somente após a solicitação básica ter sucesso.
O que é a API do GLM-5.3 Flash?
GLM-5.3 Flash é o modelo multimodal nativo de eficiência em primeiro lugar da família GLM-5 da Z.ai. Ele expõe recursos de raciocínio, contexto longo, compreensão visual e orientação a agentes por meio de uma API de chat. O modelo contém 320B total de parâmetros mas ativa 18B por token; essa arquitetura é importante para o custo, mas os desenvolvedores principalmente percebem o resultado como um modelo que consegue se manter ativo ao longo de prompts longos e de chamadas de ferramenta repetidas.
Este guia deliberadamente mantém a cobertura de arquitetura e benchmarks curta. O artigo complementar de visão geral do modelo já explica o design de atenção híbrida, pesos abertos, a matriz completa de benchmarks de lançamento, o pano de fundo de preços e a comparação entre famílias de modelos. Aqui, o foco é o comportamento de integração e decisões de produção.
Especificações da API que afetam a integração
| Especificação da API | Valor | Significado prático |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Configure isso uma vez no cliente do lado do servidor. |
| Endpoint | POST /v1/chat/completions | Use a rota de chat-completions compatível com OpenAI. |
| SDKs compatíveis | Clientes Python e JavaScript compatíveis com OpenAI | Reutilize padrões de cliente familiares com a Base URL da CometAPI. |
| Autenticação | Chave de API Bearer | Mantenha a chave em uma variável de ambiente no servidor ou em um gerenciador de segredos. |
| Código do modelo | glm-5.3-flash | Use exatamente este valor no corpo da solicitação. |
| Janela de contexto | 1,048,576 tokens | Adequado para grandes repositórios, pacotes de documentos e históricos longos de agentes. |
| Saída máxima | Até 131,072 tokens | Defina um limite específico do aplicativo para controlar custo e latência. |
| Entradas nativas | Text, image, video, file | O suporte por rota hospedada pode variar; valide a rota exata da CometAPI antes de depender de cada modalidade. |
| Saída | Text | O modelo interpreta mídia, mas não retorna diretamente imagens ou vídeo gerados. |
| Reasoning | low, high, max | Use níveis de esforço para trocar latência e consumo de tokens por profundidade. |
| Thinking | Sempre habilitado | Não envie um parâmetro que tente desabilitar thinking. |
| Recursos do desenvolvedor | Streaming, function calling, caching, structured output | Úteis para apps interativos, agentes e pipelines legíveis por máquina. |
Capacidade do modelo e capacidade do gateway não são idênticas. Trate a página do modelo ao vivo da CometAPI e o esquema da API como o contrato para a rota que você realmente chama, especialmente para vídeo, arquivos, JSON Schema estrito e campos de thinking específicos do provedor.
Contexto breve de desempenho
A Z.ai relata resultados de lançamento fortes em tarefas que importam para construtores de APIs: trabalho em terminal, engenharia de software, uso de ferramentas e automação. São pontuações relatadas pelo fornecedor obtidas com harnesses específicos e políticas de ferramentas; portanto, ajudam a identificar prováveis pontos fortes em vez de estabelecer um ranking universal.
| Benchmark | GLM-5.3 Flash | O que sugere para cargas de trabalho de API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Boa adequação para agentes de codificação dirigidos por terminal. |
| DeepSWE v1.1 | 63.4 | Engenharia de software em escala de repositórios promissora. |
| Toolathlon Verified | 78.4 | Sinal forte de seleção e uso de ferramentas. |
| AutomationBench | 48.8 | Automação multi-etapas melhorada em relação ao predecessor. |
A implicação prática é mais estreita que a tabela de benchmark: GLM-5.3 Flash é um forte candidato quando o fluxo de trabalho combina contexto longo com ferramentas ou feedback visual. Para uma comparação completa do modelo, use a visão geral do modelo existente em vez de duplicá-la aqui.
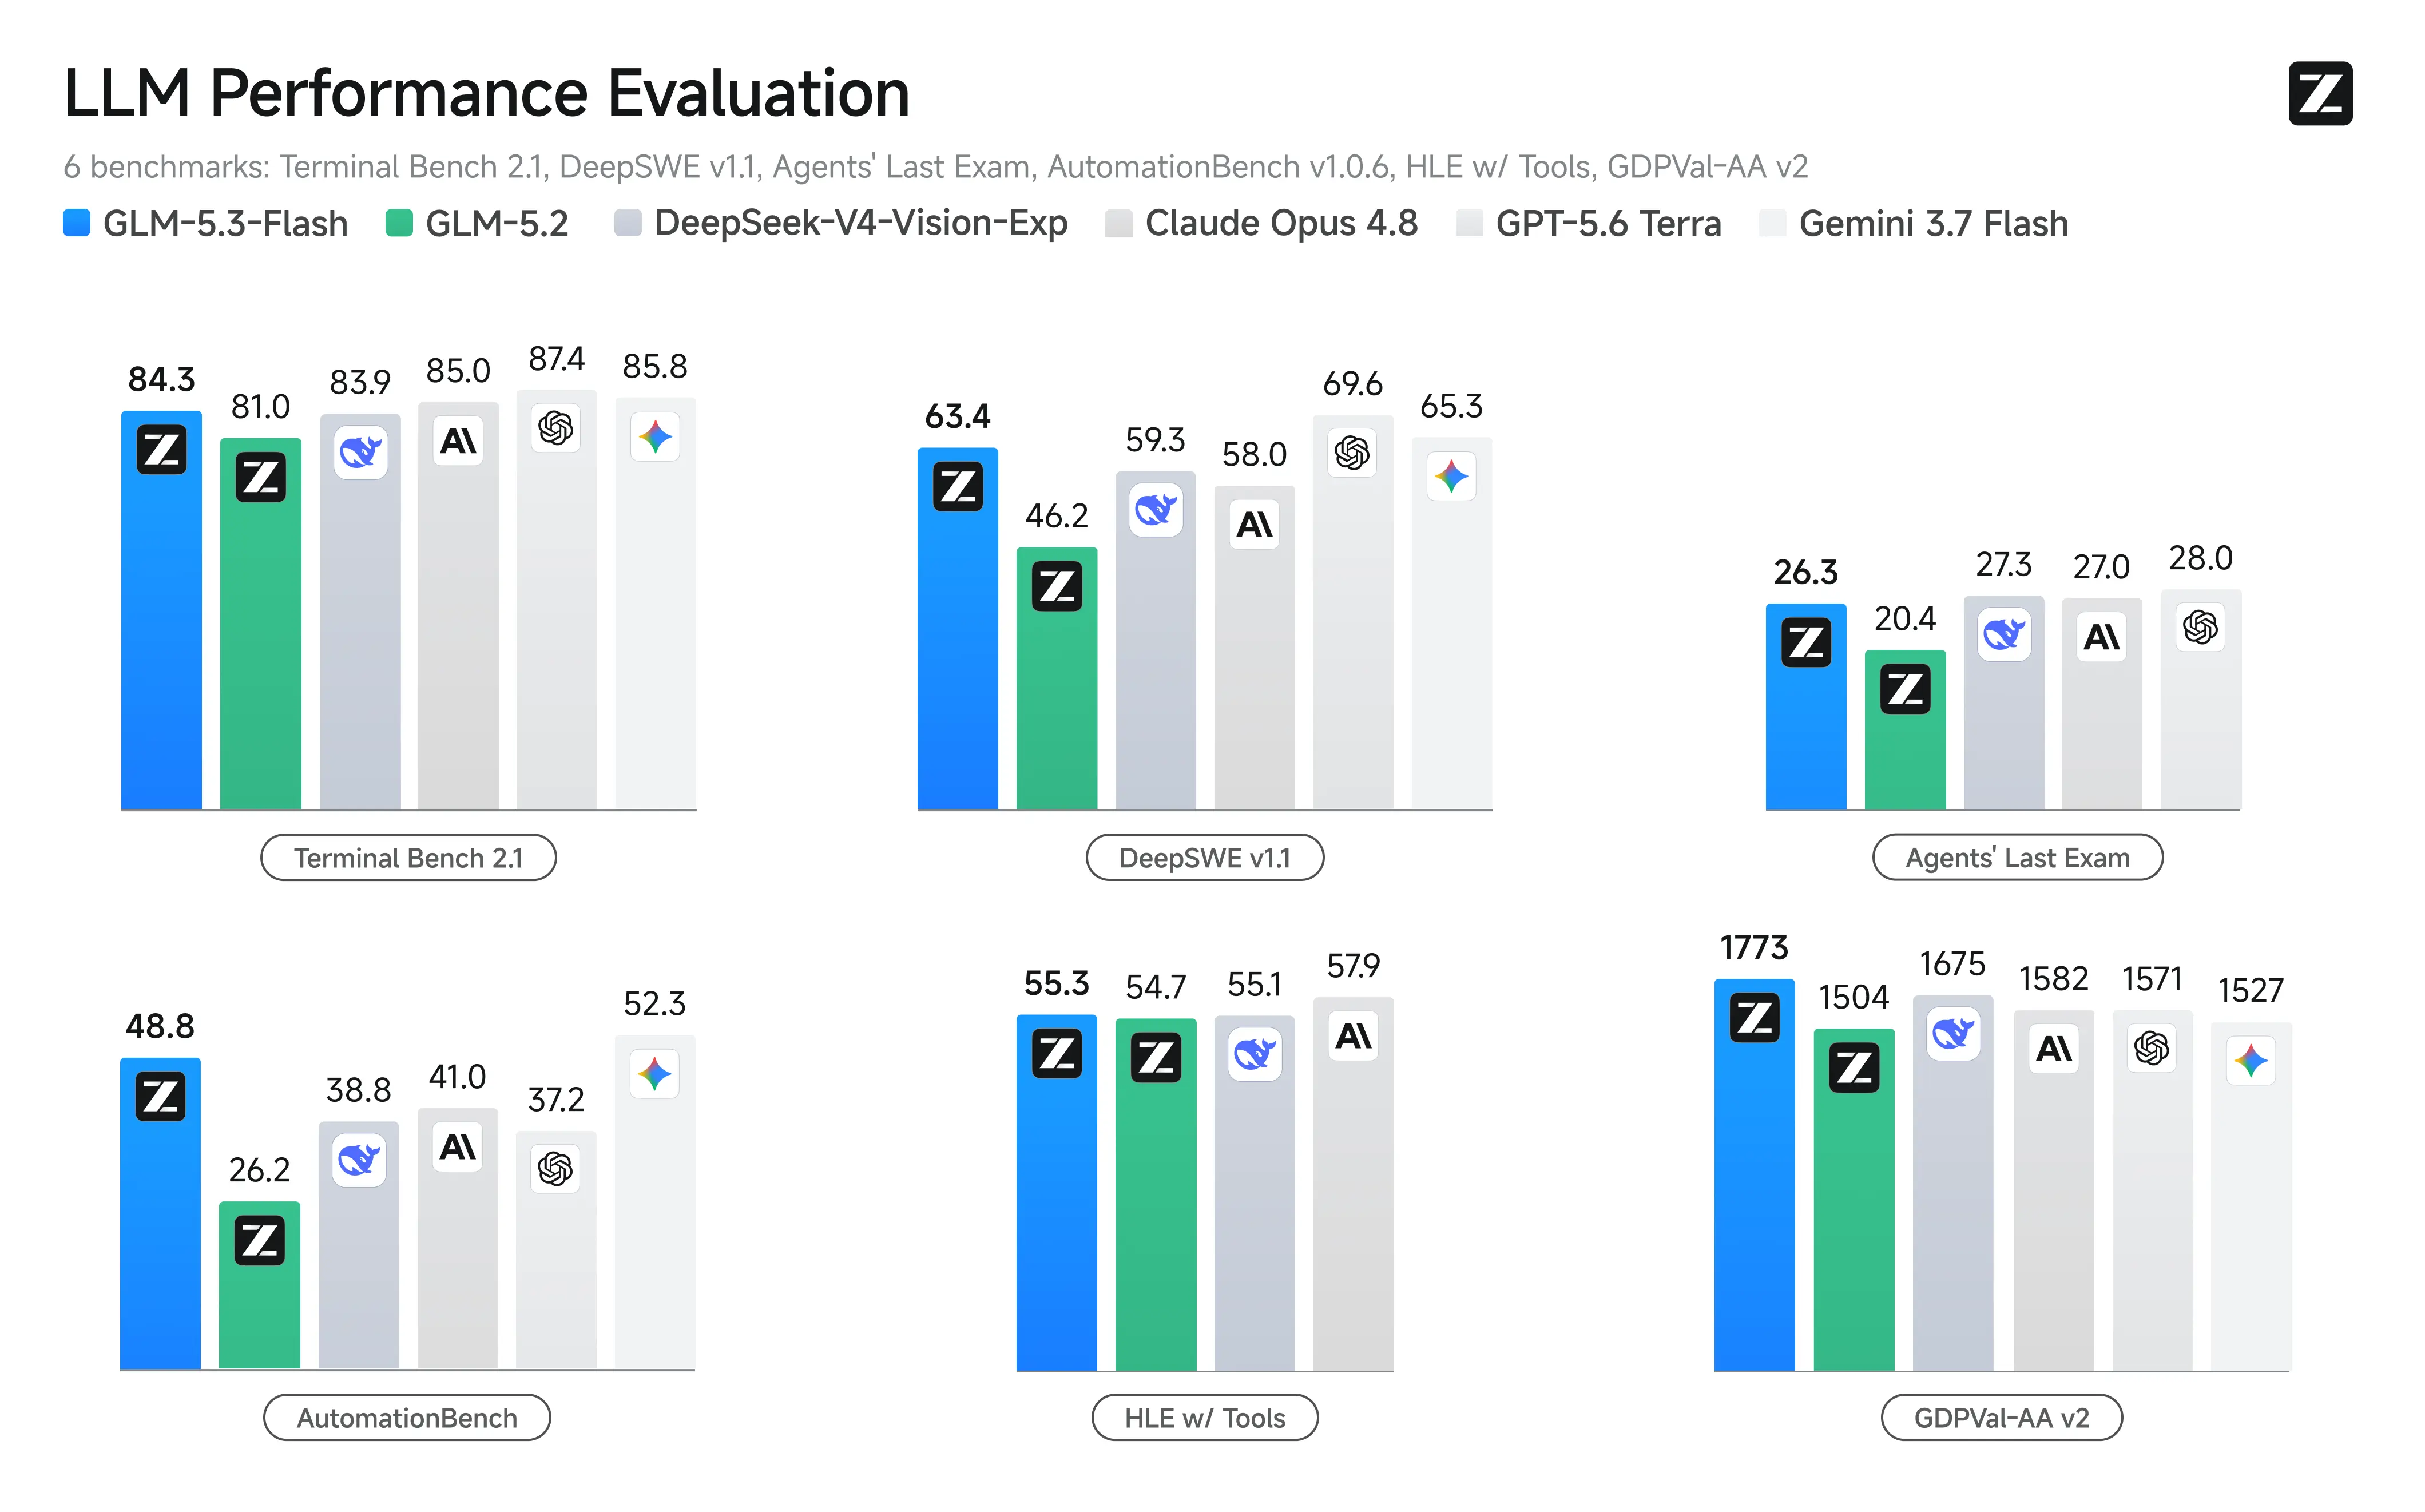
Fonte: Gráfico oficial de benchmark da Z.ai
O gráfico oficial de benchmark compara o desempenho do GLM-5.3 Flash entre modelos e configurações de esforço. Para este guia de API, ele fornece um contexto de desempenho conciso em vez de repetir a matriz completa de lançamento. Os aplicativos ainda devem medir sucesso da tarefa, latência ponta a ponta e uso total de tokens em seus próprios prompts.
Por que usar o GLM-5.3 Flash via CometAPI?
A CometAPI expõe o GLM-5.3 Flash por meio de uma interface compatível com OpenAI. Isso permite que uma equipe reutilize padrões de SDK familiares, centralize credenciais e faturamento, e troque modelos sem reconstruir toda a camada de requisições.
• Um padrão de integração. O mesmo cliente base pode chamar diferentes modelos suportados alterando o ID do modelo.
• Visibilidade centralizada de uso. As equipes podem revisar uso e custo sem manter um painel separado para cada provedor.
• Avaliação mais rápida. Um único harness de requisições pode comparar qualidade de resposta, latência e erros entre modelos candidatos.
• Design de fallback mais simples. Os aplicativos podem manter lógica de retry e roteamento em uma única camada de gateway.
• Preço de rota listado mais baixo. A página atual do modelo lista $0.06 por milhão de tokens de entrada e $0.20 por milhão de tokens de saída; verifique a página ao vivo antes de orçar.
Antes de começar
Você precisa de uma conta CometAPI, uma chave de API e um dos seguintes ambientes locais:
• Python 3.9 ou posterior com pip
• Node.js 18 ou posterior com npm
• cURL para um teste mínimo na linha de comando
Nunca coloque uma chave de produção da CometAPI em JavaScript do navegador, um aplicativo móvel, um repositório público, uma captura de tela ou logs no cliente. Chame a CometAPI a partir de um servidor confiável e mantenha a chave em uma variável de ambiente ou gerenciador de segredos.
Como usar a API do GLM-5.3 Flash com a CometAPI
Etapa 1: Crie uma chave de API da CometAPI
Faça login na CometAPI, abra o console de chaves de API, crie uma chave e copie-a uma vez para seu fluxo de trabalho de gerenciamento de segredos. Use uma chave separada para desenvolvimento e produção para poder rotacionar ou revogar um ambiente sem interromper o outro.
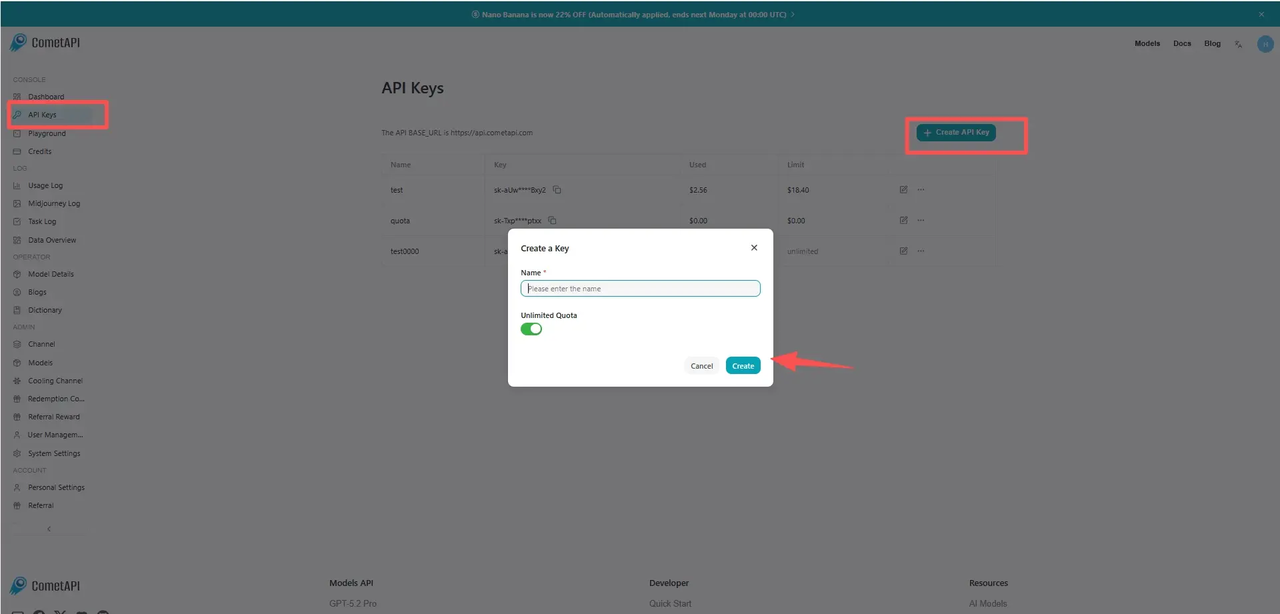
Fonte: Imagem oficial do guia de chaves de API da CometAPI
Etapa 2: Armazene a chave como uma variável de ambiente
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Para produção, substitua o histórico do shell por um segredo de implantação, segredo de contêiner ou cofre gerenciado.

### Etapa 3: Instale um SDK compatível com OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Etapa 4: Faça a primeira requisição com cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Uma resposta bem-sucedida contém uma mensagem do assistente em choices[0].message.content mais metadados de uso quando a rota os retorna. Comece com essa solicitação pequena antes de adicionar parâmetros opcionais.

### Etapa 5: Chame a API a partir de Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Etapa 6: Chame a API a partir de JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Como controlar o esforço de raciocínio

A documentação oficial do modelo suporta níveis de esforço low, high e max. Thinking permanece habilitado; a configuração de esforço muda quanto orçamento de raciocínio o modelo pode usar.

| Esforço | Cargas de trabalho iniciais recomendadas     | Trade-off                                                |
| ------- | --------------------------------------------- | -------------------------------------------------------- |
| low     | Classificação, reescrita, extração curta      | Menor latência e uso de tokens de saída; menos profundidade. |
| high    | Revisão de código, planejamento, análise de documentos | Padrão equilibrado para muitas tarefas de produção.          |
| max     | Depuração complexa, agentes com ferramentas, raciocínio difícil | Maior profundidade; potencialmente mais latência e custo.  |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Se o SDK instalado expuser reasoning_effort como argumento de primeira classe, você pode passá-lo diretamente. Se a rota da CometAPI rejeitar um campo específico do provedor, remova-o e use o padrão da rota. Não tente desabilitar thinking.

## Como transmitir respostas (streaming)

Streaming é útil para chat, assistentes de codificação e análises longas porque permite que a interface exiba a saída à medida que ela chega. Ele não reduz o número total de tokens gerados, portanto mantenha os mesmos limites de saída e controles de custo.

### Streaming em Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming em JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Trate cancelamentos. Pare de ler o stream quando o cliente desconectar e cancele o trabalho upstream quando suportado.

• Faça buffer com segurança. Não presuma que cada chunk contenha uma palavra completa, um token JSON ou um objeto de chamada de ferramenta.

• Registre o uso final. O uso pode aparecer apenas no evento final ou em metadados específicos da rota.

## Como enviar imagens

GLM-5.3 Flash aceita conteúdo visual por meio de blocos image_url em messages[].content[]. A documentação oficial recomenda uma URL de imagem acessível ou um Data URL Base64. A página do modelo na CometAPI identifica a capacidade de image-to-text, mas os aplicativos ainda devem testar formatos, tamanho de arquivo e comportamento da rota antes da produção.

### Analisar uma URL de imagem

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Enviar uma imagem local como Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Recorte espaços em branco irrelevantes antes de codificar a imagem.

• Reduza imagens que sejam muito maiores do que a informação sendo inspecionada.

• Faça uma pergunta visual específica em vez de solicitar uma descrição genérica.

• Não presuma que uma URL de página pública seja uma URL de imagem direta.

• Teste a ordenação de múltiplas imagens porque cada imagem deve ser claramente referenciada no prompt.

## Como solicitar JSON estruturado

Saída estruturada é valiosa quando o próximo componente é código e não um leitor humano. Use um esquema estreito, valide o resultado e mantenha um fallback para rotas que não exponham JSON Schema estrito exatamente na mesma forma.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

O modo JSON não elimina a necessidade de validação. Verifique campos obrigatórios, tipos, valores permitidos e comprimentos máximos antes de armazenar o resultado ou acionar outro sistema.

## Como usar Function Calling

Function calling permite que o modelo decida quando precisa de dados externos, enquanto o código do aplicativo permanece responsável por autorização e execução. O padrão seguro é: o modelo propõe uma chamada de ferramenta, o servidor a valida, o servidor executa a ferramenta, e o modelo recebe o resultado.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Valide argumentos. Trate o JSON de chamadas de ferramentas como entrada não confiável.

• Faça cumprir a autorização. O modelo não decide o que o usuário atual está autorizado a fazer.

• Separe ferramentas de leitura e escrita. Exija confirmação para ações destrutivas ou visíveis externamente.

• Limite o inventário de ferramentas. Exponha apenas as ferramentas relevantes ao fluxo de trabalho atual.

• Limite o loop. Defina máximos para rodadas de ferramentas, tokens totais, tempo decorrido e custo.

## Parâmetros da API do GLM-5.3 Flash

| Parâmetro              | Finalidade                        | Orientação prática                                     |
| ---------------------- | --------------------------------- | ------------------------------------------------------ |
| model                  | Seleciona a rota do modelo        | Use glm-5.3-flash.                                     |
| messages               | Conversa e entrada multimodal     | Mantenha a ordem de roles válida; preserve mensagens de ferramentas necessárias. |
| max_completion_tokens  | Limita a saída gerada             | Defina por fluxo de trabalho em vez de depender do máximo do modelo. |
| temperature            | Comportamento de amostragem       | A recomendação oficial é 1.                            |
| top_p                  | Amostragem por núcleo             | A recomendação oficial é 0.95.                         |
| reasoning_effort       | Orçamento de raciocínio           | Use low, high ou max; o suporte da rota deve ser testado. |
| stream                 | Saída incremental                 | Use true para respostas interativas.                   |
| tools                  | Definições de função              | Mantenha esquemas estreitos e valide cada chamada.     |
| tool_choice            | Controla seleção de ferramentas   | Comece com auto a menos que o fluxo exija uma ferramenta. |
| response_format        | Solicita saída legível por máquina | Valide o suporte e o JSON retornado.                   |

## API direta da Z.ai vs CometAPI

Ambas as rotas podem ser apropriadas. A decisão é principalmente sobre propriedade da integração, amplitude de modelos, faturamento e quão rapidamente o aplicativo precisa de recursos nativos do provedor.

| Dimensão        | API direta da Z.ai                        | CometAPI                                           | Resultado prático                                              |
| --------------- | ----------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------- |
| Conta e chave   | Conta e chave da Z.ai                     | Conta e chave da CometAPI                          | As chaves não são intercambiáveis.                             |
| Padrão de SDK   | Compatível com OpenAI                     | Compatível com OpenAI                              | Muito código de cliente pode ser reutilizado.                  |
| Cobertura de modelos | Família de modelos da Z.ai               | Múltiplos provedores e famílias de modelos         | A CometAPI é útil para roteamento e comparação.                |
| Recursos nativos | Acesso mais cedo a comportamento nativo do provedor | Depende da exposição e pass-through do gateway     | Teste campos avançados na rota selecionada.                    |
| Faturamento     | Específico do provedor                   | Centralizado entre modelos suportados              | Faturamento unificado pode simplificar operações multi-modelo. |
| Design de fallback | Requer integração com outro provedor        | Pode permanecer dentro de uma única camada de gateway | A CometAPI pode reduzir o atrito de troca.                     |
| Melhor ajuste   | Compromisso profundo com capacidades nativas da Z.ai | Acesso unificado, avaliação e roteamento de produção | Escolha com base na arquitetura do sistema, não em um vencedor genérico. |

Use a API direta quando o parâmetro mais novo do provedor ou um recurso de produto nativo for essencial. Use a CometAPI quando um único cliente, faturamento unificado e a capacidade de comparar ou substituir modelos forem mais importantes. Para produção, execute o mesmo conjunto de testes representativo contra a rota exata que você planeja implantar.

## Estimativa de custo e orçamento de tokens

A página atual do modelo da CometAPI lista $0.06 por milhão de tokens de entrada e $0.20 por milhão de tokens de saída. Nessas taxas, o custo estimado de requisição é:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Carga de trabalho         | Tokens de entrada | Tokens de saída | Custo estimado |
| ------------------------- | ----------------- | --------------- | -------------- |
| Pergunta curta            | 2,000             | 400             | $0.00020       |
| Revisão de código         | 50,000            | 4,000           | $0.00380       |
| Análise de documento grande | 250,000           | 10,000          | $0.01700       |
| Execução longa de agente  | 800,000           | 30,000          | $0.05400       |

Os preços são sensíveis ao tempo. Confirme as taxas ao vivo de entrada, entrada em cache e saída antes de publicação ou orçamento de produção. Raciocínio e loops de ferramentas podem aumentar a saída faturada e a entrada repetida, portanto estime fluxos de trabalho completos em vez de uma única resposta visível.

## Boas práticas de produção da API do GLM-5.3 Flash

### Controles de custo e latência

#### Limites de saída

As configurações de geração em benchmark e os limites da API em produção são diferentes. A avaliação HLE citada usou um comprimento máximo de geração de 163,840 tokens, enquanto algumas avaliações usaram saídas de 64K; nenhuma das configurações prova que toda rota de API hospedada pode retornar mais de 100,000 tokens. Defina o limite a partir do esquema da rota ao vivo e do orçamento do fluxo de trabalho. Use limites pequenos para classificação e extração, médios para análise e maiores apenas para tarefas explicitamente de forma longa ou de agentes.

Controle de contexto

Uma janela de um milhão de tokens é capacidade, não uma meta. Recupere arquivos relevantes, remova logs duplicados, coloque instruções estáveis próximo ao início e meça se contexto adicional melhora o sucesso da tarefa.

### Estado e confiabilidade

#### Preserve o estado

Armazene mensagens completas do assistente necessárias para a próxima rodada, incluindo chamadas de ferramentas e campos específicos da rota que seu aplicativo verificou. Perder histórico estruturado pode quebrar um loop de ferramentas multi-etapas mesmo quando o texto visível parece completo.

#### Tente novamente de forma seletiva

• Tente novamente falhas transitórias 429, 500, 502, 503 e timeouts de rede com backoff exponencial e jitter.

• Não tente novamente cegamente erros de autenticação, parâmetros inválidos ou requisições grandes demais.

• Anexe um ID de requisição do aplicativo para que trabalho duplicado possa ser reconhecido.

• Use controles de idempotência em operações de escrita externas, mesmo se a requisição do modelo em si for tentada novamente.

### Segurança e validação

#### Valide a saída legível por máquina

Validação de esquema, checagens de valores permitidos, limites de comprimento e regras de domínio devem ficar entre o modelo e todo banco de dados, fila ou API externa. Um objeto JSON sintaticamente válido ainda pode estar incompleto ou inseguro.

#### Autorize chamadas de ferramentas

Trate chamadas de ferramentas propostas pelo modelo como requisições não confiáveis: valide argumentos, faça cumprir a autorização do usuário, separe operações de leitura e escrita e exija confirmação para ações destrutivas.

### Observabilidade e fallback

#### Meça o fluxo de trabalho

• Sucesso da tarefa ou taxa de aceitação humana

• Tempo até o primeiro token e latência total

• Tokens de entrada, entrada em cache, raciocínio e saída

• Contagem de chamadas de ferramentas e taxa de falha de ferramentas

• Retries, limites de taxa e erros do provedor

• Custo por tarefa concluída em vez de custo por chamada isolada

#### Projete fallback

Escolha um fallback por carga de trabalho, não por reputação. Um fallback apenas de texto pode ser aceitável para extração de documentos, mas falhar em uma tarefa baseada em captura de tela. Defina quais entradas e esquemas de ferramentas são portáteis, quais parâmetros devem ser removidos e quando o usuário deve ver um erro recuperável em vez de uma troca automática de modelo.

## Erros comuns e solução de problemas

| Sintoma                 | Causa provável                                                   | O que verificar                                                                |
| ---------------------- | ---------------------------------------------------------------- | ------------------------------------------------------------------------------ |
| 401 Unauthorized       | Chave ausente, malformada ou revogada                           | Confirme o header Authorization e a variável de ambiente no servidor.          |
| 404 ou modelo não encontrado | ID de modelo errado ou rota indisponível                     | Use glm-5.3-flash e confirme a disponibilidade na página ao vivo do modelo.    |
| 429 Rate Limit         | Requisição ou cota de tokens excedida                           | Recuar, reduzir concorrência, inspecionar limites da conta e tentar novamente com jitter. |
| Parâmetro não suportado | Campo nativo do provedor não exposto pelo gateway               | Remova campos opcionais e depois adicione-os de volta um por um.               |
| Context length exceeded | Prompt mais saída solicitada excede o limite da rota            | Aparar, recuperar, resumir ou reduzir max_completion_tokens.                   |
| Imagem inválida        | URL inacessível, formato não suportado ou Base64 malformado     | Teste uma URL direta de imagem HTTPS e corrija o prefixo MIME.                 |
| JSON transmitido quebrado | Chunks foram analisados como objetos completos                 | Faça buffer do stream e analise apenas após o payload JSON completo chegar.    |
| Loop de ferramentas nunca termina | Sem orçamento de etapas ou resultados de ferramentas ambíguos | Limite as rodadas, melhore descrições de ferramentas e retorne erros explícitos das ferramentas. |

## Quando você deve usar a API do GLM-5.3 Flash?

### Bons encaixes

• Compreensão de código em escala de repositório e revisão multi-arquivo

• Codificação visual, análise de capturas de tela e QA de interface

• Pacotes de documentos longos e síntese com evidências

• Agentes que usam ferramentas com planejamento e verificação repetidos

• Fluxos de alto volume onde o custo de tokens afeta materialmente a economia unitária

• Aplicativos que se beneficiam de trocar ou comparar modelos por meio de um gateway único

### Use outra rota ou modelo quando

• O produto precisa de saída de imagem ou vídeo em vez de saída de texto.

• A tarefa é uma classificação pequena e de baixo risco que um modelo menor pode lidar de forma confiável.

• Um recurso nativo do provedor é obrigatório, mas não é exposto na rota do gateway.

• O fluxo de trabalho não tolera raciocínio sempre ativo nem seu perfil de latência associado.

• O aplicativo ainda não testou o modelo em suas próprias ferramentas, dados e casos de falha.

## FAQ

###

### O que devo verificar na rota exata da CometAPI antes do lançamento?

Verifique disponibilidade do modelo, formatos multimodais aceitos, saída máxima, campos de raciocínio, comportamento de saída estruturada, limites de taxa e preços atuais com requisições representativas.

### Quais métricas uma avaliação de produção deve rastrear?

Rastreie sucesso da tarefa, tempo até o primeiro token, latência total, tokens de entrada e saída, falhas de chamadas de ferramentas, taxa de retrys e custo por fluxo de trabalho concluído, não apenas custo por chamada de API.

### Como devo escolher entre Z.ai direta e CometAPI?

Use Z.ai direta quando o acesso imediato ao comportamento nativo do provedor for essencial. Use a CometAPI quando autenticação unificada, faturamento, comparação de modelos e fallback no nível do gateway forem mais importantes.

### O que torna um fallback seguro?

Um fallback seguro aceita a mesma modalidade de entrada, preserva esquemas de ferramentas necessários, remove parâmetros não suportados, permanece dentro dos limites de autorização da tarefa e falha de forma visível quando o comportamento não pode ser preservado.

## Conclusão

GLM-5.3 Flash é mais útil por meio de uma API quando contexto longo, entrada visual, raciocínio e uso de ferramentas fazem parte de um único fluxo de trabalho. A integração básica com a CometAPI é pequena: uma chave do lado do servidor, um cliente compatível com OpenAI, o ID de modelo glm-5.3-flash e o endpoint de chat-completions. Qualidade de produção vem de tudo ao redor dessa requisição: prompts com escopo, limites de saída, validação de esquema, autorização de ferramentas, retries, observabilidade e avaliação específica do fluxo de trabalho.

Comece com uma chamada curta de texto, adicione uma capacidade avançada por vez e teste a jornada completa do usuário antes de escalar. Confirme a página do modelo GLM-5.3 Flash ao vivo para disponibilidade atual, comportamento da rota suportada e preços.

## SEO Metadata

Meta title: How to Use GLM-5.3 Flash API: Developer Guide

Meta description: Learn how to use the GLM-5.3 Flash API with CometAPI, including Python and JavaScript examples, vision, streaming, tools, JSON output, and best practices.

Keywords: GLM-5.3 Flash API, how to use GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API tutorial, multimodal API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api