Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Hy4 vs GPT-6.1 Terra: benchmarks, preços da API e qual modelo escolher
Compare Hy4 e GPT-6.1 Terra em programação, pesquisa, especificações oficiais da API e preços do CometAPI. Encontre o modelo certo para sua carga de trabalho.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
Atualizado Nov 14, 2026 11 min de leitura
Resposta primeiro
Compare Hy4 e GPT-6.1 Terra em programação, pesquisa, especificações oficiais da API e preços do CometAPI. Encontre o modelo certo para sua carga de trabalho.
Use este resumo para uma resposta rápida e depois leia o guia para contexto, exemplos e detalhes de implementação.
Hy4 é um ponto de partida sólido para pesquisa financeira e geração de texto em alto volume; GPT-6.1 Terra é um ponto de partida sólido para codificação em terminal e depuração. Ambos aceitam texto e imagens e suportam o uso de ferramentas. As diferenças mais claras são desempenho em tarefas, capacidade de saída e preço: Terra lidera o teste de codificação em terminal abaixo, enquanto Hy4 lidera os testes de finanças e pesquisa e custa menos nas tarifas listadas da CometAPI.
Key Takeaways
Escolha pela carga de trabalho: Hy4 para pesquisa e aplicações intensivas em saída; Terra para codificação no terminal e depuração.
Ambos oferecem janelas de contexto de aproximadamente um milhão de tokens. Terra fornece um orçamento máximo de saída maior.
Terra lidera o Terminal-Bench 4.0 por 10.10 pontos percentuais; o modelo da Tencent lidera o Finance Agent v2.1 por 8.74 pontos nos resultados da Vals AI.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
O exemplo da CometAPI de 10M tokens de entrada e 2M tokens de saída custa $10.672 versus $16.00 nas tarifas base exibidas.
Ajuste o endpoint, o comportamento das ferramentas e as configurações de raciocínio ao seu aplicativo antes de trocar de provedor.
Especificações, instantâneos de benchmarks e preços verificados em 6 de novembro de 2026.
Hy4 vs GPT-6.1 Terra: Especificações e capacidades
Hy4 combina compreensão de texto e imagem com raciocínio e uso de ferramentas, incluindo fluxos de trabalho em interfaces de linha de comando e gráficas. GPT-6.1 Terra oferece raciocínio visual, uso de computador e escrita, com controles explícitos de esforço de raciocínio e um orçamento de saída maior. A tabela abaixo compara as especificações da Tencent e da OpenAI.
Especificações oficiais da API
Ambos os modelos podem trabalhar com grandes coleções de documentos e bases de código. Para prompts longos, reserve espaço para a resposta também: a Tencent lista uma entrada máxima de 960K para o Hy4. A pequena diferença na capacidade de contexto anunciada é menos útil para a seleção do que o quão precisamente cada modelo usa seu material.
Terra oferece mais espaço para uma resposta longa, com até 128.000 tokens de saída versus o limite publicado de 64K do Hy4. Isso ajuda quando um relatório ou entrega de código precisa caber em uma resposta. Tokens de raciocínio também consomem o orçamento de saída do Terra.
Controles de raciocínio
Terra oferece seis configurações de esforço de raciocínio: none, low, medium, high, xhigh e max, com medium como padrão. Isso dá aos aplicativos uma forma explícita de ajustar o esforço de inferência por tarefa. Uma solicitação de classificação e uma tarefa de depuração difícil não precisam usar o mesmo orçamento.
O lançamento da Tencent descreve raciocínio combinado com percepção visual e uso de ferramentas, mas não define um controle equivalente de seis níveis naquele anúncio. Trate os parâmetros de raciocínio como específicos do endpoint: não copie a configuração de esforço de um provedor para outro pedido presumindo que tenha o mesmo significado.
Hy4 vs GPT-6.1 Terra: Desempenho
A Vals AI fornece resultados diretos para ambos os modelos em tarefas de código, finanças, pesquisa jurídica e impostos. Essas pontuações mostram onde cada modelo é um candidato útil para sua carga de trabalho.
Resultados independentes de benchmarks e condições de teste
Os seguintes resultados do Vals Index v2.2 foram verificados em 10 de novembro de 2026. Pontuações mais altas são melhores.
A Vals AI lista temperature 0.9, top_p 1.0 e um limite de saída de 65.536 tokens para o Hy4; Terra usa esforço de raciocínio max e um limite de saída de 128.000 tokens. Essas configurações diferem, portanto leia os resultados como comparações das configurações testadas, e não como execuções com orçamento igual.
A liderança do Terra é maior em tarefas de terminal do que em geração de código: 10.10 pontos percentuais no Terminal-Bench 4.0 versus 2.99 pontos no Vibe Code Bench. Isso torna a depuração e o desenvolvimento em linha de comando os locais mais claros para começar a avaliar o Terra.
Hy4 lidera o Finance Agent, o Legal Research Bench e o Tax Agent Bench por 8.74, 15.39 e 17.32 pontos percentuais, respectivamente. Fluxos de trabalho de pesquisa que reúnem evidências e aplicam regras de domínio são, portanto, pontos de partida promissores para o Hy4.
A diferença geral é de 1.19 pontos percentuais, e os intervalos de incerteza publicados se sobrepõem.
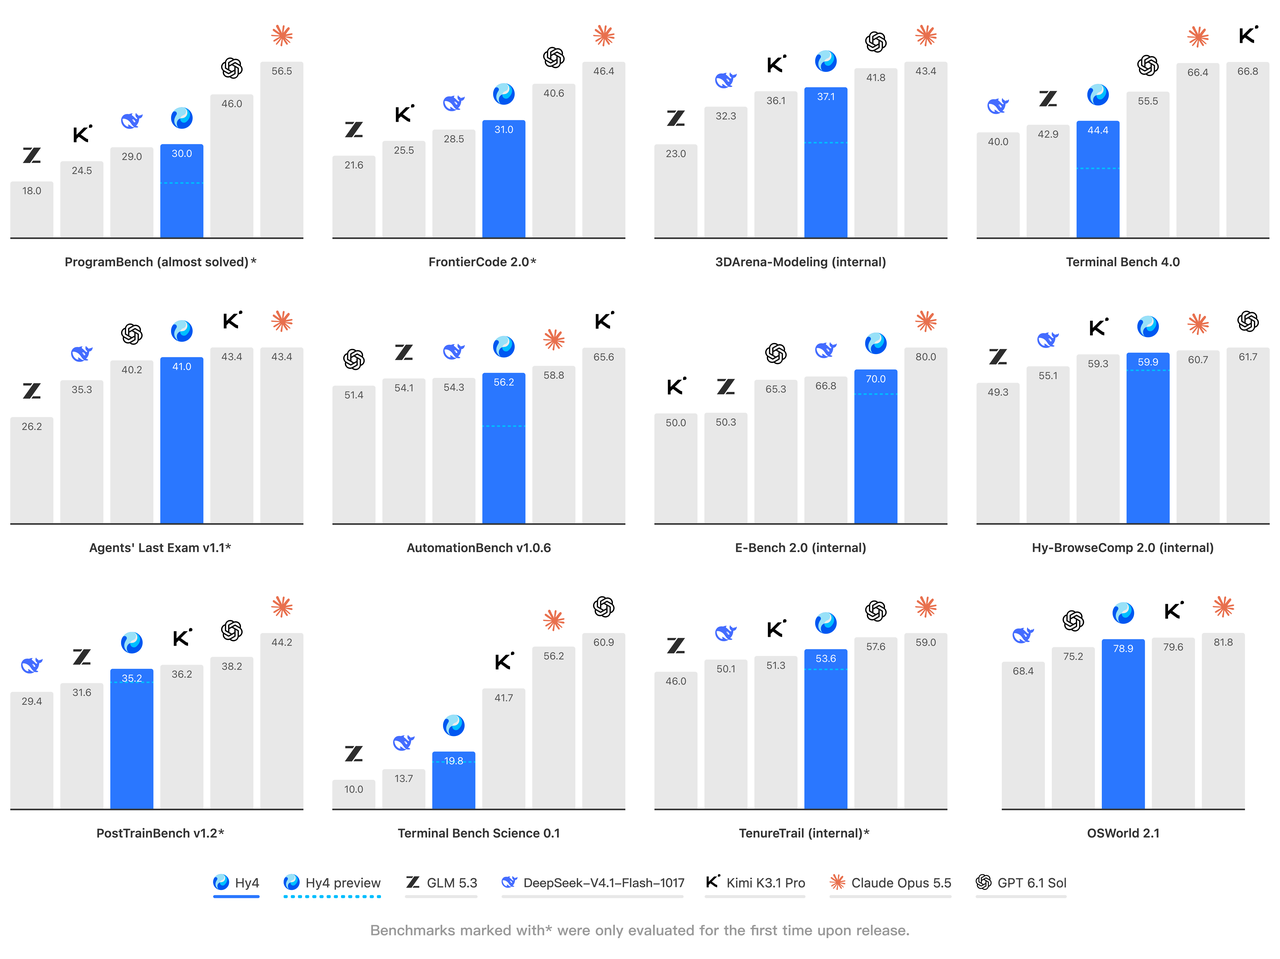
Benchmarks de lançamento do Hy4 da Tencent
O gráfico de lançamento da Tencent adiciona resultados para codificação e uso de computador. Ele compara o Hy4 com o GPT-6.1 Sol; use a tabela da Vals AI acima para a comparação direta com o GPT-6.1 Terra.
Resultados de benchmark do Hy4 reportados pela Tencent, novembro de 2026. O modelo da OpenAI mostrado é o GPT-6.1 Sol.
Fluxos de trabalho de visão e uso de computador
A Tencent introduz compreensão de imagens no lançamento oficial e descreve treinamento para fluxos de trabalho que abrangem ferramentas de linha de comando, interfaces gráficas, Blender e CAD. Isso torna a análise de gráficos e tarefas visuais de software centrais para seu posicionamento.
A OpenAI posiciona seu modelo para fluxos de trabalho baseados em tela, escrita concisa e correções de código com escopo definido. Para um aplicativo de catálogo, teste a correspondência de fotos de produtos; para trabalho técnico, use desenhos com pequenas legendas e medidas; para automação de desktop, verifique os arquivos salvos e o estado do aplicativo.
Um bom conjunto de testes visuais deve separar ler de agir. Primeiro, meça se o modelo extrai os valores corretos ou identifica o elemento de interface certo. Em seguida, meça se o fluxo de trabalho completo atinge o resultado exigido sem cliques incorretos, arquivos ausentes ou intervenção humana desnecessária.
Velocidade e latência de ponta a ponta
Para chat, as medidas relevantes de velocidade são quão cedo a resposta começa e quanto tempo leva para terminar. Para agentes, meça a tarefa completa, incluindo execução de ferramentas e quaisquer correções.
Compare ambos os modelos em tarefas típicas e exigentes na sua concorrência esperada. Acompanhe latência mediana e de cauda junto com a conclusão bem-sucedida: uma resposta rápida só é útil se realizar o trabalho.
Hy4 vs GPT-6.1 Terra: Custo
Compare primeiro as taxas por token e depois considere o trabalho necessário para obter um resultado utilizável. Os preços abaixo são tarifas base da CometAPI em dólares americanos por milhão de tokens; são separados dos valores de custo por teste reportados pela Vals AI.
Preços de entrada e saída na CometAPI
Item de custo
API Hy4 na CometAPI
API GPT-6.1 Terra na CometAPI
Entrada por milhão de tokens
$0.6672
$0.80
Saída por milhão de tokens
$2.00
$4.00
A tabela abaixo usa as tarifas base listadas da CometAPI em dólares americanos por milhão de tokens. Compare entrada e saída separadamente e depois calcule o custo da sua solicitação típica.
Exemplo de custo para 10.000 solicitações
Considere 10.000 solicitações, cada uma usando 1.000 tokens de entrada não armazenados em cache e 200 tokens de saída faturáveis. Em todas as solicitações, isso corresponde a 10 milhões de tokens de entrada e 2 milhões de tokens de saída. Usando os preços base da CometAPI acima:
Hy4 custa cerca de 33.3% menos neste exemplo. Esta estimativa cobre entrada não armazenada em cache e saída faturável; adicione custos de cache, ferramentas e novas tentativas ao orçar um fluxo de trabalho completo.
Cobrança direta do provedor e solicitações de contexto longo
Para documentos longos na API direta da OpenAI, prompts acima de 272K tokens de entrada acionam tarifas 2× para entrada e cache e 1.5× para saída em toda a solicitação. Aplique as regras de cobrança do serviço que você utiliza; o exemplo da CometAPI acima usa tarifas base da CometAPI. Detalhes de preços da OpenAI.
Custo por tarefa aceita
Uma tarefa aceita é aquela que atende às verificações de qualidade e conclusão do seu aplicativo. Conte todas as tentativas, o uso de ferramentas e o trabalho de revisão necessários para chegar a esse resultado, incluindo gastos com tentativas que falham.
Custo por tarefa aceita = custo total de modelo, novas tentativas, ferramentas e revisão humana ÷ tarefas que passam nos critérios de aceitação.
Uma chamada mais cara ainda pode ser econômica se eliminar várias tentativas de reparo. Por outro lado, quando um modelo de menor custo atende ao limite de qualidade, pagar uma taxa mais alta por cada tarefa pode agregar pouco valor.
Qual modelo você deve escolher: Hy4 ou GPT-6.1 Terra?
Comece com o modelo cujos pontos fortes correspondem à sua carga de trabalho principal. Use as escolhas a seguir para construir uma lista curta e, depois, compare a qualidade e o custo das tarefas concluídas.
Quando escolher Hy4
Escolha Hy4 primeiro para pesquisa financeira, análise de documentos jurídicos ou fiscais e aplicações que geram texto substancial. Suas lideranças nos três benchmarks de domínio o tornam um candidato útil para pesquisas intensivas em evidências. Nas tarifas listadas da CometAPI, seu preço de saída é metade do do Terra, o que pode fazer diferença material em redação e relatórios de alto volume.
Para trabalho de pesquisa, julgue a resposta final pela precisão das fontes, cálculos e cobertura da pergunta. Hy4 é a melhor opção quando atende a esses requisitos com menor custo total, incluindo revisão e novas tentativas.
Quando escolher GPT-6.1 Terra
Escolha GPT-6.1 Terra primeiro para codificação em terminal, depuração e correções de código. Sua liderança de 10.10 pontos no Terminal-Bench é o sinal mais forte de código nesta comparação. O orçamento de saída maior também o torna digno de teste para relatórios longos e respostas de código substanciais.
Julgue o Terra por saber se seus patches passam nos seus testes e se suas entregas estão completas. Para trabalho visual ou de desktop, compare ambos os modelos nas suas telas, gráficos e arquivos reais, verificando o resultado final salvo.
Roteando pesquisa e codificação para modelos diferentes
Uma carga de trabalho mista pode se beneficiar do uso de ambos os modelos. Um assistente de análise financeira poderia usar Hy4 para pesquisa e redação de relatórios e, depois, chamar o Terra quando um script de análise precisar de depuração:
Envie a coleta de evidências e a redação do relatório para o Hy4.
Verifique citações, valores de fontes e cálculos antes de aceitar o relatório.
Direcione um script de análise com falha para o Terra com o código, a saída de erro e o comportamento esperado.
Execute o script corrigido e aplique as mesmas verificações de evidência antes de retornar o resultado final.
Use um segundo modelo quando ele melhorar o resultado final o suficiente para cobrir o custo extra e o trabalho de integração.
Onde você pode acessar Hy4 e GPT-6.1 Terra?
Acesso pelos provedores oficiais
Acesse Hy4 via Tencent Cloud TokenHub e GPT-6.1 Terra via API da OpenAI. Use a documentação do provedor para autenticação, IDs de modelo e cobrança.
Acesso via CometAPI e compatibilidade de ferramentas
A CometAPI oferece ambos os modelos sob os IDs hy4 e gpt-6.1-terra. Suas páginas de modelo listam exemplos de requisição e preços para cada rota: Hy4 e GPT-6.1 Terra.
Para aplicativos com ferramentas, verifique o suporte da rota selecionada para chamadas de função e saídas estruturadas. Na API direta da OpenAI, a chamada de ferramentas do Terra requer a Responses API.
Como testar e implantar sua escolha
Antes de alterar o tráfego de produção, compare os modelos em tarefas representativas usando as mesmas entradas, ferramentas e critérios de aprovação. Registre conclusões bem-sucedidas, custo total e tempo decorrido e implemente gradualmente a rota mais forte.
Inclua solicitações rotineiras e casos difíceis que importam para seus usuários.
Verifique argumentos de ferramentas, saídas estruturadas, erros e status de conclusão.
Defina limites de novas tentativas e gatilhos de reversão antes de enviar tráfego ao vivo.
Conclusão
Escolha Hy4 quando qualidade de pesquisa e menores custos de geração de texto forem suas prioridades. Escolha GPT-6.1 Terra quando codificação em terminal, depuração e um orçamento de saída maior importarem mais.
Para um aplicativo misto, comece com um modelo por grande carga de trabalho e adicione uma segunda rota onde ela melhora os resultados. A melhor escolha é aquela que conclui suas tarefas com precisão a um custo que você consegue sustentar.
Especificação
Hy4 · especificações oficiais da Tencent Cloud
GPT-6.1 Terra · especificações oficiais da OpenAI
Desenvolvedor
Tencent
OpenAI
ID do modelo na API
hy4
gpt-6.1-terra
Entrada / saída
Texto e imagens / texto
Texto e imagens / texto
Janela de contexto
1024K tokens (notação da Tencent)
1,050,000 tokens
Saída máxima
64K tokens (notação da Tencent)
128,000 tokens
Chamada de ferramentas
Suportado (Function Calling)
Suportado; requer Responses API
Saídas estruturadas
Suportado
Suportado
Principais aplicações
Engenharia de software, análise financeira e tarefas de agentes de longa duração
Raciocínio visual, uso de computador, escrita e tarefas de código com escopo definido
Benchmark ou métrica
Hy4: resultados da Vals AI
GPT-6.1 Terra: resultados da Vals AI
Interpretação
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 pontos percentuais
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 pontos
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 pontos
Finance Agent v2.1
64.70%
55.96%
Modelo da Tencent +8.74 pontos
Legal Research Bench
41.35%
25.96%
Modelo da Tencent +15.39 pontos
Tax Agent Bench
34.40%
17.08%
Modelo da Tencent +17.32 pontos
Hy4 vs GPT-6.1 Terra: benchmarks, preços da API e qual modelo escolher - CometAPI