
TL;DR
Kimi K3.1 Pro é a atualização de 24 de outubro de 2026 da Moonshot AI para Kimi K3. O pós-treinamento adicional melhora a codificação autônoma, a pesquisa financeira e fluxos de trabalho estendidos de uso de ferramentas, mantendo a mesma capacidade de contexto de aproximadamente um milhão de tokens.
Avaliações independentes mostram desempenho geral mais forte, e as tarifas oficiais padrão de tokens de entrada/saída caem em um terço. A atualização ainda requer testes de carga: raciocínio mais profundo pode aumentar a latência da tarefa e o gasto total, enquanto o K3 mantém uma pequena vantagem no AA-LCR e pesos atualmente disponíveis para auto-hospedagem.
Key Takeaways
- As melhorias mais claras estão na execução agentic. A Artificial Analysis relata pontuações no Terminal-Bench 4.0 de aproximadamente 67% para o K3.1 Pro versus 13% para o K3; os resultados internos de Financial Research da Moonshot sobem de 58.8 para 70.4.
- Preços de tokens mais baixos não garantem custos de tarefa menores. As tarifas padrão de entrada/saída caem de $3/$15 para $2/$10 por milhão de tokens, mas raciocínio adicional, chamadas de ferramentas e novas tentativas podem compensar a economia.
- A janela de contexto permanece a mesma. Ambos os modelos suportam até 1,048,576 tokens. O K3 permanece ligeiramente à frente na avaliação AA-LCR v1.1 citada, portanto teste a precisão em longos contextos nos seus próprios documentos.
- A disponibilidade de pesos pode determinar a escolha. Em 24 de outubro de 2026, os pesos do K3 estão disponíveis; os pesos do K3.1 Pro estão programados para lançamento até 4 de novembro. Equipes que precisam de auto-hospedagem imediata devem considerar essa diferença.
Kimi K3.1 Pro vs Kimi K3: Visão geral e especificações
Kimi K3.1 Pro baseia-se no K3 via pós-treinamento adicional, com melhorias focadas em codificação, pesquisa financeira e fluxos de trabalho agentic estendidos. Ambos mantêm aproximadamente um milhão de tokens de contexto. As principais diferenças estão no desempenho em tarefas, precificação de tokens, opções de serving e disponibilidade de pesos.
| Specification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | 24 de outubro de 2026 | 16 de julho de 2026 |
| Architecture | MoE derivado do K3, pós-treinado | MoE com KDA, AttnRes |
| Model size | Classe 3T e 104B parâmetros ativos | 2.8T total e 104B parâmetros ativos |
| Context window | Até 1,048,576 tokens | Até 1,048,576 tokens |
| Standard API input / output price | $2 / $10 por milhão de tokens | $3 / $15 por milhão de tokens |
| Highspeed version | Disponível | Nenhuma variante K3 Highspeed separada |
| Weight availability | Lançamento previsto até 4/11/2026 | Disponível sob a Kimi K3 License |
Weight availability reflete as informações disponíveis em 24 de outubro de 2026. Os preços de API estão em USD para entrada e saída regulares, excluindo cobranças de cache-write, impostos e outras taxas aplicáveis.
Architecture and Post-Training
K3 introduziu uma arquitetura de 2.8 trilhões de parâmetros combinando Kimi Delta Attention, Attention Residuals e Stable LatentMoE. Ele ativa aproximadamente 104 bilhões de parâmetros por token.
A Moonshot descreve o K3.1 Pro como uma versão pós-treinada do K3 desenvolvida com computação de pós-treinamento substancialmente maior. A atualização foca em aplicar as capacidades do modelo em tarefas multi-etapas, incluindo uso de ferramentas, depuração e verificação de resultados. O anúncio não apresenta uma arquitetura base com nome separado.
Shared Capabilities and API Requirements
Ambos os modelos suportam entradas multimodais, chamadas de ferramentas, saídas estruturadas e cache de contexto. Formatos de imagem e vídeo dependem da rota de API selecionada. Ambos sempre raciocinam e suportam esforço de raciocínio low, high e max, com max como padrão.
Para conversas multi-turn e chamadas de ferramentas, as integrações devem preservar mensagens completas do assistente, incluindo conteúdo de raciocínio e chamadas de ferramentas, conforme exigido pela API. Limites reais de contexto e disponibilidade de recursos também devem ser verificados para o provedor, produto e nível de assinatura selecionados.
Kimi K3.1 Pro vs Kimi K3: Desempenho
As evidências vêm de testes internos da Moonshot e comparações relatadas, juntamente com avaliações independentes de terceiros.
Estas devem ser interpretadas separadamente porque harnesses de benchmark, conjuntos de teste, configurações de raciocínio e critérios de pontuação podem diferir.
A avaliação de lançamento da Artificial Analysis relata um aumento de 11 pontos em seu Índice composto de Inteligência, com melhorias particularmente grandes em codificação baseada em terminal e fluxos de trabalho agentic.
| Independent Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Difference |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 percentage points |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Estes são resultados de avaliações independentes. Valores arredondados são usados quando o avaliador relata pontuações arredondadas. Taxas de alucinação mais baixas são melhores.
A maior melhoria ocorre em codificação baseada em terminal. O K3.1 Pro tem desempenho substancialmente melhor em tarefas que exigem execução de comandos, interação com o ambiente, depuração e validação repetida.
O AutomationBench-AA também mostra um ganho significativo, sugerindo execução mais forte em fluxos de trabalho de software como serviço.
Os benchmarks de lançamento da Moonshot focam em codificação, ciência, reconstrução 3D, finanças, trabalho do conhecimento e agentes autônomos.
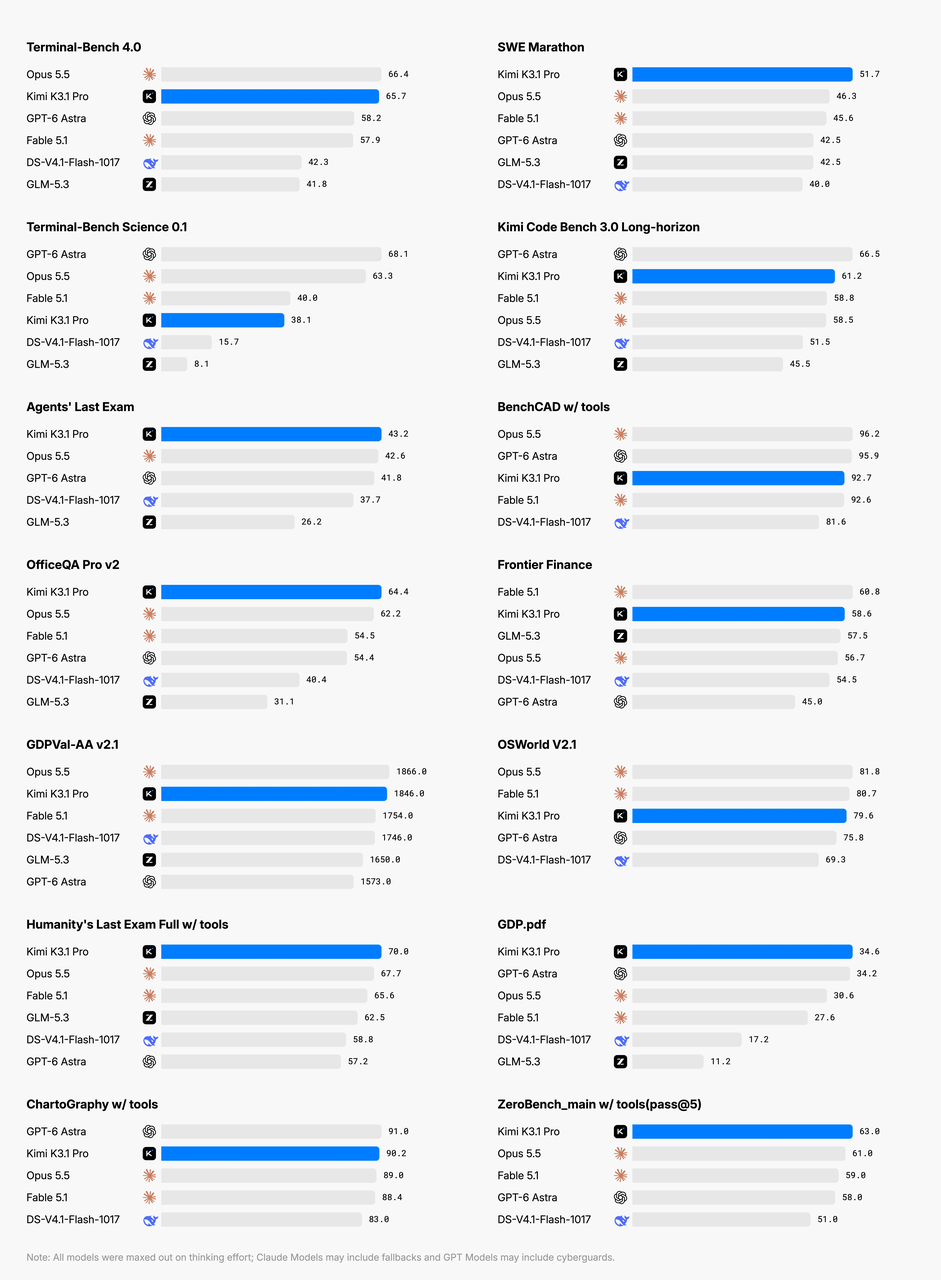
As comparações selecionadas incluem Claude Opus 5.5 e GPT-6 Astra. Compare cada resultado dentro do benchmark nomeado e configuração declarada.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Other Model | Comparison Model Score |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
O K3.1 Pro se aproxima ou supera vários modelos proprietários líderes em tarefas selecionadas. Mas ele não domina todas as categorias.
Por exemplo, permanece atrás do Claude Opus 5.5 nas comparações BenchCAD e OSWorld relatadas pelo fornecedor, e o gráfico oficial mostra uma fraqueza maior no Terminal-Bench Science.
As configurações de avaliação diferem: a Artificial Analysis usa o harness mini-swe-agent para o Terminal-Bench 4.0, enquanto a Moonshot usa o Claude Code. Compare pontuações dentro do mesmo setup de teste; harnesses, esforço de raciocínio e limites de tempo de execução podem afetar os resultados.
Coding and Software Engineering
Para codificação autônoma complexa, o K3.1 Pro é geralmente a escolha mais forte.
Os resultados internos do Kimi Code Bench 3.0 Long-horizon da Moonshot aumentam de 55.95% para o K3 para 61.2% para o K3.1 Pro, um ganho de aproximadamente 5.25 pontos percentuais.
Resultados independentes do Terminal-Bench também mostram um ganho substancial. Esses testes avaliam execução em múltiplas etapas: entender um repositório, alterar arquivos, executar comandos, diagnosticar erros e verificar o resultado.
O K3.1 Pro é o candidato mais forte para desenvolvimento multi-arquivo, trabalho autônomo em terminal e depuração estendida. Para geração de código simples, compare ambos os modelos nas suas próprias tarefas; o K3 permanece a opção imediata quando a auto-hospedagem é necessária.
Uma distinção importante é que as pontuações de benchmarks de codificação dependem fortemente do framework de agente. Ferramentas, prompts, limites de tempo de execução e ambientes de teste influenciam o resultado.
Para desenvolvimento de software em produção, a melhor avaliação ainda é uma comparação alinhada nos seus próprios repositórios.
Financial Research and Business Operations
A modelagem financeira oferece algumas das comparações diretas mais claras entre os dois modelos.
A Moonshot testou K3 e K3.1 Pro em avaliações internas cobrindo construção de planilhas, qualidade de pesquisa e operações comerciais simuladas.
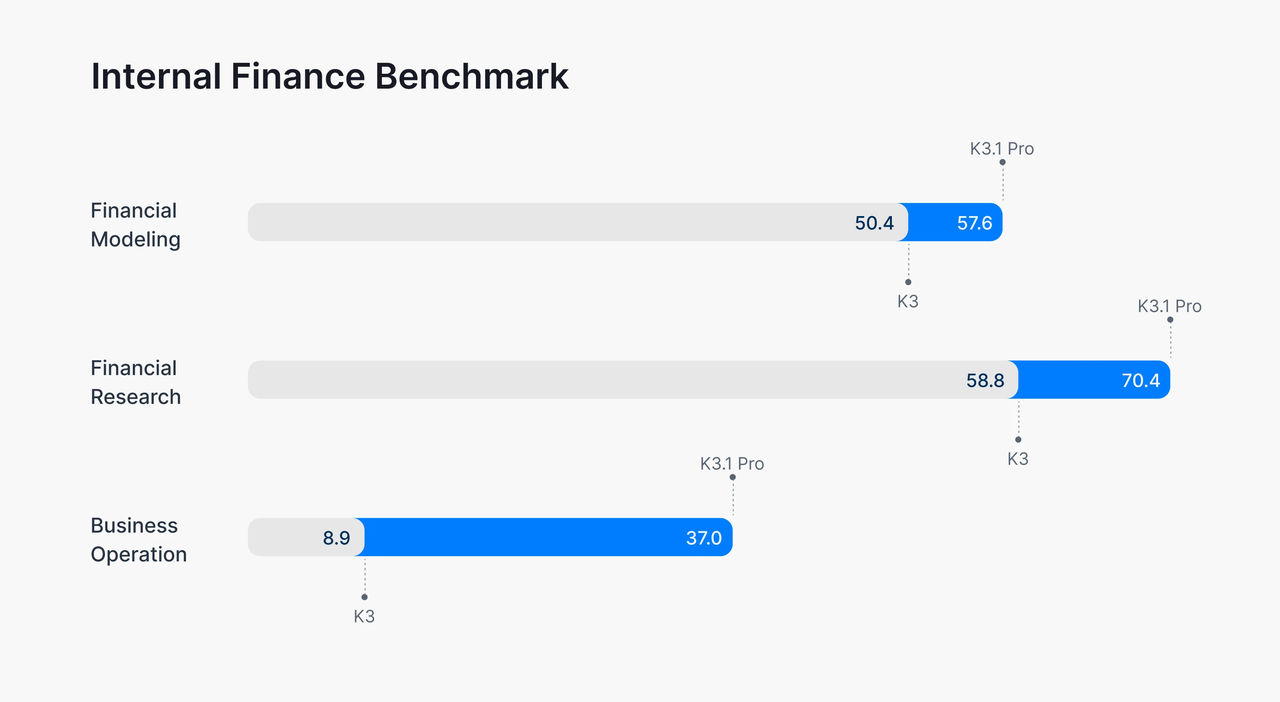
Os resultados internos de finanças da Moonshot cobrem modelagem financeira, pesquisa e operações comerciais simuladas. Essas pontuações de tarefa relatadas pelo fornecedor não são medidas de retornos de investimento. Configurações por tarefa não devem ser assumidas como idênticas a benchmarks não relacionados.
Nos testes internos da Moonshot, Financial Modeling sobe de 50.4 para 57.6, um ganho de 7.2 pontos, e Financial Research sobe de 58.8 para 70.4, um ganho de 11.6 pontos. Business Operation aumenta de 8.9 para 37.0, cerca de 4.2 vezes a pontuação do K3.
Esse benchmark avalia gestão e tomada de decisão de longo horizonte em um ambiente de negócios simulado. Portanto, está mais relacionado ao planejamento agentic do que à simples resposta a perguntas financeiras.
Financial Research mede a capacidade de produzir pesquisa baseada em evidências respeitando requisitos de fontes e limites de conhecimento. Financial Modeling foca em relações matemáticas, lógica de planilhas e qualidade de workbooks.
O padrão sugere que o K3.1 Pro é particularmente valioso quando tarefas financeiras exigem raciocínio sustentado, verificação e entregáveis estruturados.
Para investidores, analistas e usuários de negócios, o benefício prático é potencialmente melhor tratamento de fluxos de trabalho com múltiplos documentos. Nenhum dos modelos deve ser usado como autoridade incontestável para decisões financeiras.
Long-Context Reasoning and Factual Reliability
No entanto, os resultados AA-LCR de longo contexto mostram o K3 ligeiramente à frente. Isso é um lembrete útil de que um modelo mais novo pode melhorar substancialmente no geral sem vencer toda tarefa especializada.
As avaliações relatadas mostram menos erros factuais em seus respectivos conjuntos de teste.
No Kimi Hallu Bench Hard with tools, a Moonshot relata que a taxa de erro em nível de alegação caiu de 23.4% para o K3 para 8.3% para o K3.1 Pro.
Isso é cerca de uma redução relativa de 65% no teste de estresse deliberadamente difícil da Moonshot, em vez de uma estimativa de taxas de erro do dia a dia. Separadamente, a Artificial Analysis relata uma queda na taxa de alucinação AA-Omniscience de 53% para 44%. As duas avaliações usam métodos diferentes, então suas porcentagens não são diretamente comparáveis.
A lição prática é que o K3.1 Pro parece mais confiável nas tarefas avaliadas, mas melhorias factuais não eliminam a necessidade de recuperação, citações, checagens de cálculo e revisão humana em fluxos de trabalho consequentes.
Data Analysis: Evidence from Plotly’s Evaluation
A Plotly avaliou o K3.1 Pro padrão via OpenRouter usando um teste privado de 43 perguntas sobre um data warehouse sintético de energia eólica. Não testou o Highspeed. Os resultados ilustram o trade-off entre qualidade da resposta, tempo de conclusão e custo naquele fluxo de trabalho analítico específico baseado em SQL.
| Plotly Data Analytics Measure | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Correct answers | 35/43 | 42/43 |
| Accuracy | 81.4% | 97.7% |
| Hidden patterns discovered | 0/5 | 5/5 |
| Data-quality issues identified | 1/3 | 3/3 |
| Full evaluation cost | $5.01 | $13.47 |
| Median time per question | 43 seconds | 2.5 minutes |
Nesta avaliação, o K3.1 Pro respondeu mais perguntas corretamente e identificou mais padrões ocultos e problemas de qualidade de dados, mas incorreu em custo maior e tempo mediano de conclusão mais longo.
As cobranças relatadas são custos observados da avaliação, não estimativas calculadas com base nos preços padrão da API da Moonshot. A configuração publicada não estabelece que todas as definições do provedor foram idênticas entre as duas execuções do modelo, portanto as diferenças não podem ser atribuídas apenas ao modelo.
Esses resultados apoiam a avaliação do K3.1 Pro para tarefas analíticas onde descobertas adicionais possam justificar mais tempo e gasto. Eles não estabelecem a mesma precisão ou vantagem de custo em outros cenários.
Is Kimi K3.1 Pro Faster Than Kimi K3?
Distinguir vazão de tokens de saída da latência fim a fim da tarefa.
A Artificial Analysis relata 73.5 tokens de saída por segundo para o K3.1 Pro, comparado a 38.5 para o K3 com esforço de raciocínio máximo, usando a API da Kimi. Estas são medições de geração de tokens, verificadas em 24 de outubro de 2026; a latência total da tarefa também depende do comprimento do raciocínio e da execução de ferramentas.
No entanto, geração mais rápida de tokens não garante conclusão mais rápida da tarefa.
A Moonshot também oferece o K3.1 Pro Highspeed, que é anunciado como entregando aproximadamente duas a três vezes a velocidade de saída da variante padrão. Isso é uma melhoria na velocidade de serving, não uma atualização de inteligência verificada separadamente.
O K3.1 Pro tem maior vazão relatada de tokens de saída, mas não necessariamente conclui tarefas mais rápido. Distinga a velocidade de geração de tokens do tempo necessário para raciocinar, chamar ferramentas e finalizar o trabalho.
Output Speed vs. Task Completion Time
A Artificial Analysis relata velocidades de saída de 73.5 tokens por segundo para o K3.1 Pro e 38.5 para o K3 com esforço de raciocínio máximo, usando a API da Kimi. Essas medições foram verificadas em 24 de outubro de 2026 e descrevem vazão de geração de tokens, não a latência fim a fim.
Um modelo pode gerar tokens mais rápido e ainda levar mais tempo no total se produzir mais tokens de raciocínio ou realizar chamadas de ferramentas adicionais. Na avaliação da Plotly discutida acima, o tempo mediano de conclusão do K3.1 Pro foi de 2.5 minutos por pergunta, comparado a 43 segundos para o K3, junto com maior precisão.
Para aplicativos interativos, meça o tempo até o primeiro token e o tempo total de conclusão da tarefa na rota real do provedor. A vazão de saída sozinha não é suficiente para prever a capacidade de resposta.
Consider K3.1 Pro Highspeed
A Moonshot anuncia o K3.1 Pro Highspeed como entregando aproximadamente duas a três vezes a velocidade de saída do K3.1 Pro padrão. Essa afirmação diz respeito à velocidade de serving; não deve ser interpretada como uma redução de duas a três vezes no tempo total de conclusão da tarefa.
Considere o Highspeed para codificação interativa ou assistentes em que os usuários aguardam respostas. Compare latência fim a fim, sucesso da tarefa e custo total faturado com o endpoint padrão antes de escolhê-lo. O Highspeed tem preços mais altos para tokens de entrada e saída regulares, enquanto sua tarifa de entrada em cache é a mesma.
Kimi K3.1 Pro vs Kimi K3: Custo
Official API and CometAPI Rates
As tarifas oficiais de entrada, saída e acerto de cache do K3.1 Pro padrão são um terço menores do que as do K3. As tarifas listadas da CometAPI para entrada e saída ficam 20% abaixo das correspondentes tarifas oficiais.
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD por milhão de tokens; tarifas verificadas em 24 de outubro de 2026. As colunas de entrada mostram tarifas regulares de entrada sem cache. Impostos e cobranças faturadas separadamente são excluídos.
A precificação oficial da Kimi também lista cobranças de gravação de cache: $2/$4 por milhão de tokens para o Pro padrão com retenção de 5 minutos/1 hora, e $4/$8 para o Highspeed. Acertos de cache, gravações de cache e entrada regular são categorias de faturamento separadas e mutuamente exclusivas.
Kimi oficial e CometAPI são rotas de provedor separadas. Confirme a precificação atual e o suporte a cache para sua rota selecionada, incluindo disponibilidade do Highspeed. Compare o custo total faturado da tarefa, bem como as tarifas de tokens.
Fixed-Token Cost Example
Considere uma carga de trabalho que consome 100,000 tokens de entrada sem cache e 20,000 tokens de saída.
Para essa carga fixa, o custo na API oficial é $0.60 com o K3 e $0.40 com o K3.1 Pro. Nas tarifas listadas da CometAPI, as mesmas quantidades de tokens custam $0.48 e $0.32, respectivamente. Esses totais incluem apenas os tokens de entrada e saída declarados.
Mas esta é uma comparação com tokens fixos. Fluxos de trabalho agentic complexos podem consumir quantidades diferentes de tokens de raciocínio e chamadas de ferramentas dependendo do modelo.
Token Savings Disapears
Seja I a contagem idêntica de tokens de entrada sem cache, O a contagem de tokens de saída faturados do Kimi K3 e P a contagem de tokens de saída faturados do Kimi K3.1 Pro, todas medidas em milhões. Nas tarifas oficiais padrão da tabela de preços, as cobranças são 3I + 15O e 2I + 10P dólares. Elas são iguais quando P = 1.5O + 0.1I.
Para solicitações intensivas em saída, o K3.1 Pro pode, portanto, usar aproximadamente 50% mais tokens de saída faturados antes de perder sua vantagem de preço. Esse cálculo assume tarifas inalteradas e exclui cache, taxas de ferramentas e outros usos cobrados separadamente. Use as categorias reais de tokens faturados em vez do comprimento visível da resposta.
Cost per Successfully Completed Task
Calcule o custo por tarefa bem-sucedida como o custo total faturado de todas as tentativas de avaliação dividido pelo número de tarefas únicas que atendem a um critério de aceitação predefinido. Inclua cobranças de tentativas malsucedidas, novas tentativas e timeouts quando o provedor as faturar; dividir apenas o custo das execuções bem-sucedidas pela sua contagem pode subestimar o custo por sucesso.
Mantenha o conjunto de tarefas, critérios de aceitação, limite de novas tentativas e política de timeout fixos entre Kimi K3 e K3.1 Pro. Relate a taxa de sucesso juntamente com o custo por sucesso, de modo que eliminar tarefas difíceis não torne um modelo artificialmente econômico. Se nenhuma tarefa for bem-sucedida, o custo por sucesso é indefinido, não zero.
Kimi K3.1 Pro vs Kimi K3: Comparação e seleção
Para a maioria dos workloads agentic hospedados, o K3.1 Pro é o ponto de partida mais forte. No entanto, a decisão deve refletir a complexidade da tarefa e os requisitos de implantação.
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | Avalie mudanças em múltiplos arquivos, trabalho em terminal, depuração e resultados finais dos testes. |
| Multi-document financial research | Kimi K3.1 Pro | Melhoria nos benchmarks de pesquisa e operações de negócios |
| Complex data analysis | Kimi K3.1 Pro | Melhor descoberta de problemas e teste de qualidade de dados |
| 3D creation and CAD workflows | Kimi K3.1 Pro | Capacidades especializadas fortes com ferramentas |
| Straightforward text tasks | Benchmark both | Compare tarefas rotineiras de texto e codificação simples em ambos os modelos; raciocínio extra pode adicionar latência sem melhorar o resultado aceitável. |
| Long-context retrieval accuracy | Benchmark both | K3 lidera ligeiramente no AA-LCR |
| Immediate self-hosting | Kimi K3 | Pesos baixáveis já disponíveis |
| Interactive high-capability agents | K3.1 Pro Highspeed | Serving mais rápido, sujeito à validação de custo |
| Cost-sensitive production workflows | Benchmark both | Preços de tokens mais baixos podem não significar custo de tarefa menor |
Hosted Automation and Professional Workflows
Para agentes de codificação hospedados e fluxos de trabalho analíticos, avalie o K3.1 Pro nas partes difíceis do trabalho real: mudanças em múltiplos arquivos, coleta de evidências, checagens de cálculo e recuperação após uma chamada de ferramenta com falha. Prefira reduções medidas em tarefas com falha ou retrabalho corretivo a uma pontuação de manchete mais alta por si só.
Para aplicativos K3 estabelecidos, mantenha a rota existente como linha de base de comparação. Tarefas rotineiras podem já atender ao limiar de aceitação, enquanto tarefas especializadas de longo contexto podem se comportar de forma diferente dos benchmarks agregados. Priorize os segmentos do workload onde a atualização tem benefício mensurável.
Self-Hosting and Deployment Constraints
Em 24 de outubro de 2026, os pesos completos do K3 estão disponíveis para implantação, sujeitos à licença do modelo e aos requisitos de hardware. Os pesos completos do K3.1 Pro ainda não foram publicados.
A Moonshot planeja lançar os pesos do K3.1 Pro até 4 de novembro de 2026. Este é um plano de lançamento anunciado, não um checkpoint disponível; confirme os pesos publicados e os termos aplicáveis antes de agendar a auto-hospedagem.
Production Evaluation Criteria
Compare K3 e K3.1 Pro em tarefas representativas usando os mesmos prompts, ferramentas, critérios de aceitação, limites de novas tentativas e timeouts. Registre as configurações do provedor e de raciocínio e preserve mensagens completas do assistente conforme exigido pela API.
Meça sucesso da tarefa, latência, uso de tokens e custo por tarefa bem-sucedida, incluindo falhas faturadas e novas tentativas. Revise casos onde o K3 tem sucesso e o K3.1 Pro falha. Para avaliação humana, oculte os rótulos dos modelos e randomize a ordem das saídas.
Se o K3.1 Pro atender aos seus limiares de qualidade, latência e custo, faça o rollout gradualmente com um fallback testado do K3.
Controlled Migration and Fallbacks
Uma abordagem prática é começar com uma pequena porcentagem do tráfego de produção no K3.1 Pro.
Mantenha o K3 disponível como fallback durante a validação. Compare qualidade da tarefa, latência, taxas de falha e gastos antes de aumentar o uso do K3.1 Pro.
Preste especial atenção a esquemas de chamadas de ferramentas, campos de mensagens relacionados a raciocínio, entradas multimodais e parsing de saída. Compatibilidade de API não garante automaticamente comportamento idêntico do aplicativo.
Benchmark Gains and Regressions
Se ambos os modelos responderam às mesmas 43 perguntas e marcaram 35 e 42, o K3.1 Pro pode ter corrigido sete falhas do K3 sem regressões, ou oito falhas enquanto perdeu uma resposta anteriormente correta. A pontuação total sozinha não distingue esses resultados.
Inspecione respostas pareadas e classifique-as como ambos corretos, apenas K3 correto, apenas K3.1 Pro correto ou ambos incorretos. Revise os sucessos exclusivos do K3 em relação às suas tarefas de maior impacto antes de migrar. O resultado 42/43 descreve aquele conjunto de teste; não garante uma taxa de sucesso de 97.7% em outro workload.
Blind Evaluation of Model Outputs
Oculte os rótulos dos modelos e randomize a ordem em que os revisores veem as saídas. Defina o critério de aceitação antes de revisá-las: para código, use testes executáveis e checks de regressão; para pesquisa, verifique suporte das fontes, cálculos e se o entregável solicitado está completo. Pontue a correção antes de considerar apresentação ou estilo de escrita.
Revele a identidade do modelo, latência e custo faturado somente após o registro da avaliação de qualidade. Isso separa a qualidade da saída das expectativas sobre o modelo mais novo. Resolva divergências dos revisores com base nos mesmos testes ou material de origem e retenha as decisões para que uma mudança posterior de modelo ou prompt possa ser avaliada de forma consistente.
Where Can You Access Kimi K3.1 Pro and Kimi K3?
Official Provider Access
Use a Kimi K3 API ou a Kimi K3.1 Pro API documentadas pela Moonshot para integração direta ao provedor. Verifique o identificador de modelo do endpoint selecionado, campos de solicitação suportados e limites de conta. Acesso público à API e pesos de modelo baixáveis são opções de implantação separadas.
Access Through CometAPI
Desenvolvedores podem acessar a Kimi K3.1 Pro API e a Kimi K3 API pela interface unificada da CometAPI e comparar ambas as rotas com o mesmo workload do aplicativo.
Isso torna a migração de K3 para K3.1 Pro relativamente direta, especialmente para aplicativos que já usam uma interface de chat compatível com OpenAI.
Para usar a CometAPI, crie uma conta e uma chave de API, depois configure seu aplicativo com o endpoint e o identificador de modelo na documentação de integração. Selecione kimi-k3 para o K3, kimi-k3.1-pro para o K3.1 Pro padrão ou kimi-k3.1-pro-highspeed para a rota Highspeed quando suportada. Comece com uma solicitação pequena, depois compare o mesmo workload entre os modelos enquanto verifica resultados retornados, latência e uso faturado.
Conclusion
Kimi K3.1 Pro é o candidato mais forte para codificação autônoma exigente, pesquisa financeira e fluxos de trabalho agentic estendidos nas avaliações aqui revisadas. Kimi K3 permanece relevante para auto-hospedagem imediata e workloads onde seu perfil existente de precisão ou latência já atende aos requisitos.
Escolha usando tarefas representativas e a rota real do provedor. Compare resultados bem-sucedidos, latência e gasto total, depois migre gradualmente. Preços de tokens mais baixos e pontuações agregadas de benchmark mais altas são pontos de partida úteis, mas não estabelecem a melhor configuração para todo aplicativo.