
TL;DR
O MiniMax M3.1 Flash é um modelo de IA de alta velocidade projetado para agentes autônomos, engenharia de software, uso de computador e automação de fluxos de trabalho complexos. Lançado oficialmente em 19 de outubro de 2026, ele combina uma janela de contexto de 1 milhão de tokens com profundidade de raciocínio configurável e menores custos de inferência.
A MiniMax informa até 200+ tokens de saída por segundo, uma redução de 70% nos custos de workload de agentes em comparação com seu antecessor e desempenho competitivo em Automation-Bench, DeepSWE e OSWorld. A $0.15 por milhão de tokens de entrada e $0.60 por milhão de tokens de saída, o modelo torna fluxos de trabalho de agentes de IA multi-etapas mais econômicos.
Principais pontos
- Desempenho do MiniMax M3.1 Flash: Benchmarks informados pelo fornecedor incluem Automation-Bench 62.8, DeepSWE v1.1 73.7 e OSWorld 2.0 61.7, destacando suas capacidades em automação de agentes, codificação e uso de computador.
- Preços da API do MiniMax M3.1 Flash: As tarifas oficiais são $0.15/M para entrada, $0.60/M para saída e $0.015/M para entrada em cache. As tarifas da CometAPI são $0.80/M para entrada e $3.20/M para saída em 21 de outubro de 2026, sem taxa de cache publicada na página do modelo.
- Velocidade de inferência do MiniMax M3.1 Flash: A MiniMax informa 200+ tokens/s em condições favoráveis e throughput P50 acima de 170 tokens/s, suportando fluxos de trabalho de agentes responsivos.
- Eficiência de agentes do MiniMax M3.1 Flash: Cinco níveis de esforço de raciocínio permitem que desenvolvedores equilibrem conclusão de tarefas, latência e custos gerais de agentes de IA.
- Acesso à API do MiniMax M3.1 Flash: Desenvolvedores podem acessar o modelo lançado via MiniMax ou explorar a integração da CometAPI usando identificadores de modelo e preços específicos do provedor.
O que é o MiniMax M3.1 Flash?
MiniMax M3.1 Flash é um modelo de linguagem de próxima geração otimizado para raciocínio agentic, codificação, uso de ferramentas e execução autônoma de fluxos de trabalho. A MiniMax apresentou oficialmente o M3.1 Flash em 19 de outubro de 2026.
Em vez de focar exclusivamente em inteligência conversacional ou pontuações isoladas, ele mira o custo total de completar tarefas por meio de raciocínio repetido, chamadas de ferramentas e execução multi-etapas. A MiniMax também associou seu desenvolvimento inicial ao Space Bunny, um modelo implantado anonimamente que, segundo ela, processou mais de 200 trilhões de tokens antes do anúncio; este é um número de uso reportado, não uma contagem publicada de tokens de treinamento.
Para desenvolvedores que constroem assistentes de codificação autônomos, colegas de trabalho de IA corporativa e agentes baseados em navegador, o M3.1 Flash oferece três vantagens relevantes: ampla capacidade de contexto, geração rápida e uso de tokens barato.
Quais são as especificações do MiniMax M3.1 Flash?
| Especificações da API | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Official release | October 19, 2026 |
| Model family | MiniMax M3 |
| Context window | 1,000,000 tokens |
| Primary capabilities | Agent automation, coding, reasoning, computer use |
| Input modalities | Text, image, and video via MiniMax's OpenAI-compatible API; confirm support on other providers |
| Output modality | Text |
| Reasoning controls | Low, medium, high, xhigh, max |
| Reported output speed | Up to 200+ tokens/s |
| Reported P50 speed | 170+ tokens/s |
| Access channels | MiniMax API, M Plan, MiniMax Code |
| Open weights | Announced for future release |
| M3.1-specific parameter count | Not established in the announcement |
Uma grande janela de contexto é valiosa para codificação em escala de repositório e fluxos de trabalho pesados em documentos, mas não garante lembrança perfeita. Agentes em produção ainda devem usar recuperação seletiva, respostas de ferramentas estruturadas e compressão de contexto.
Cinco configurações de esforço de raciocínio permitem que os desenvolvedores reservem computação intensiva para planejamento e depuração complexos, em vez de aplicar esforço máximo a cada etapa de classificação, extração ou simples seleção de ferramentas. Como uma única solicitação de agente pode acionar dezenas de invocações de modelo, pequenas economias nas etapas rotineiras podem reduzir materialmente o custo total.
Como o MiniMax M3.1 Flash se sai em benchmarks?
A MiniMax reporta resultados de benchmark abrangendo automação de negócios, engenharia de software, uso de computador, segurança cibernética e raciocínio multimodal. São avaliações informadas pelo fornecedor, não um substituto para testes independentes de uma implantação real.
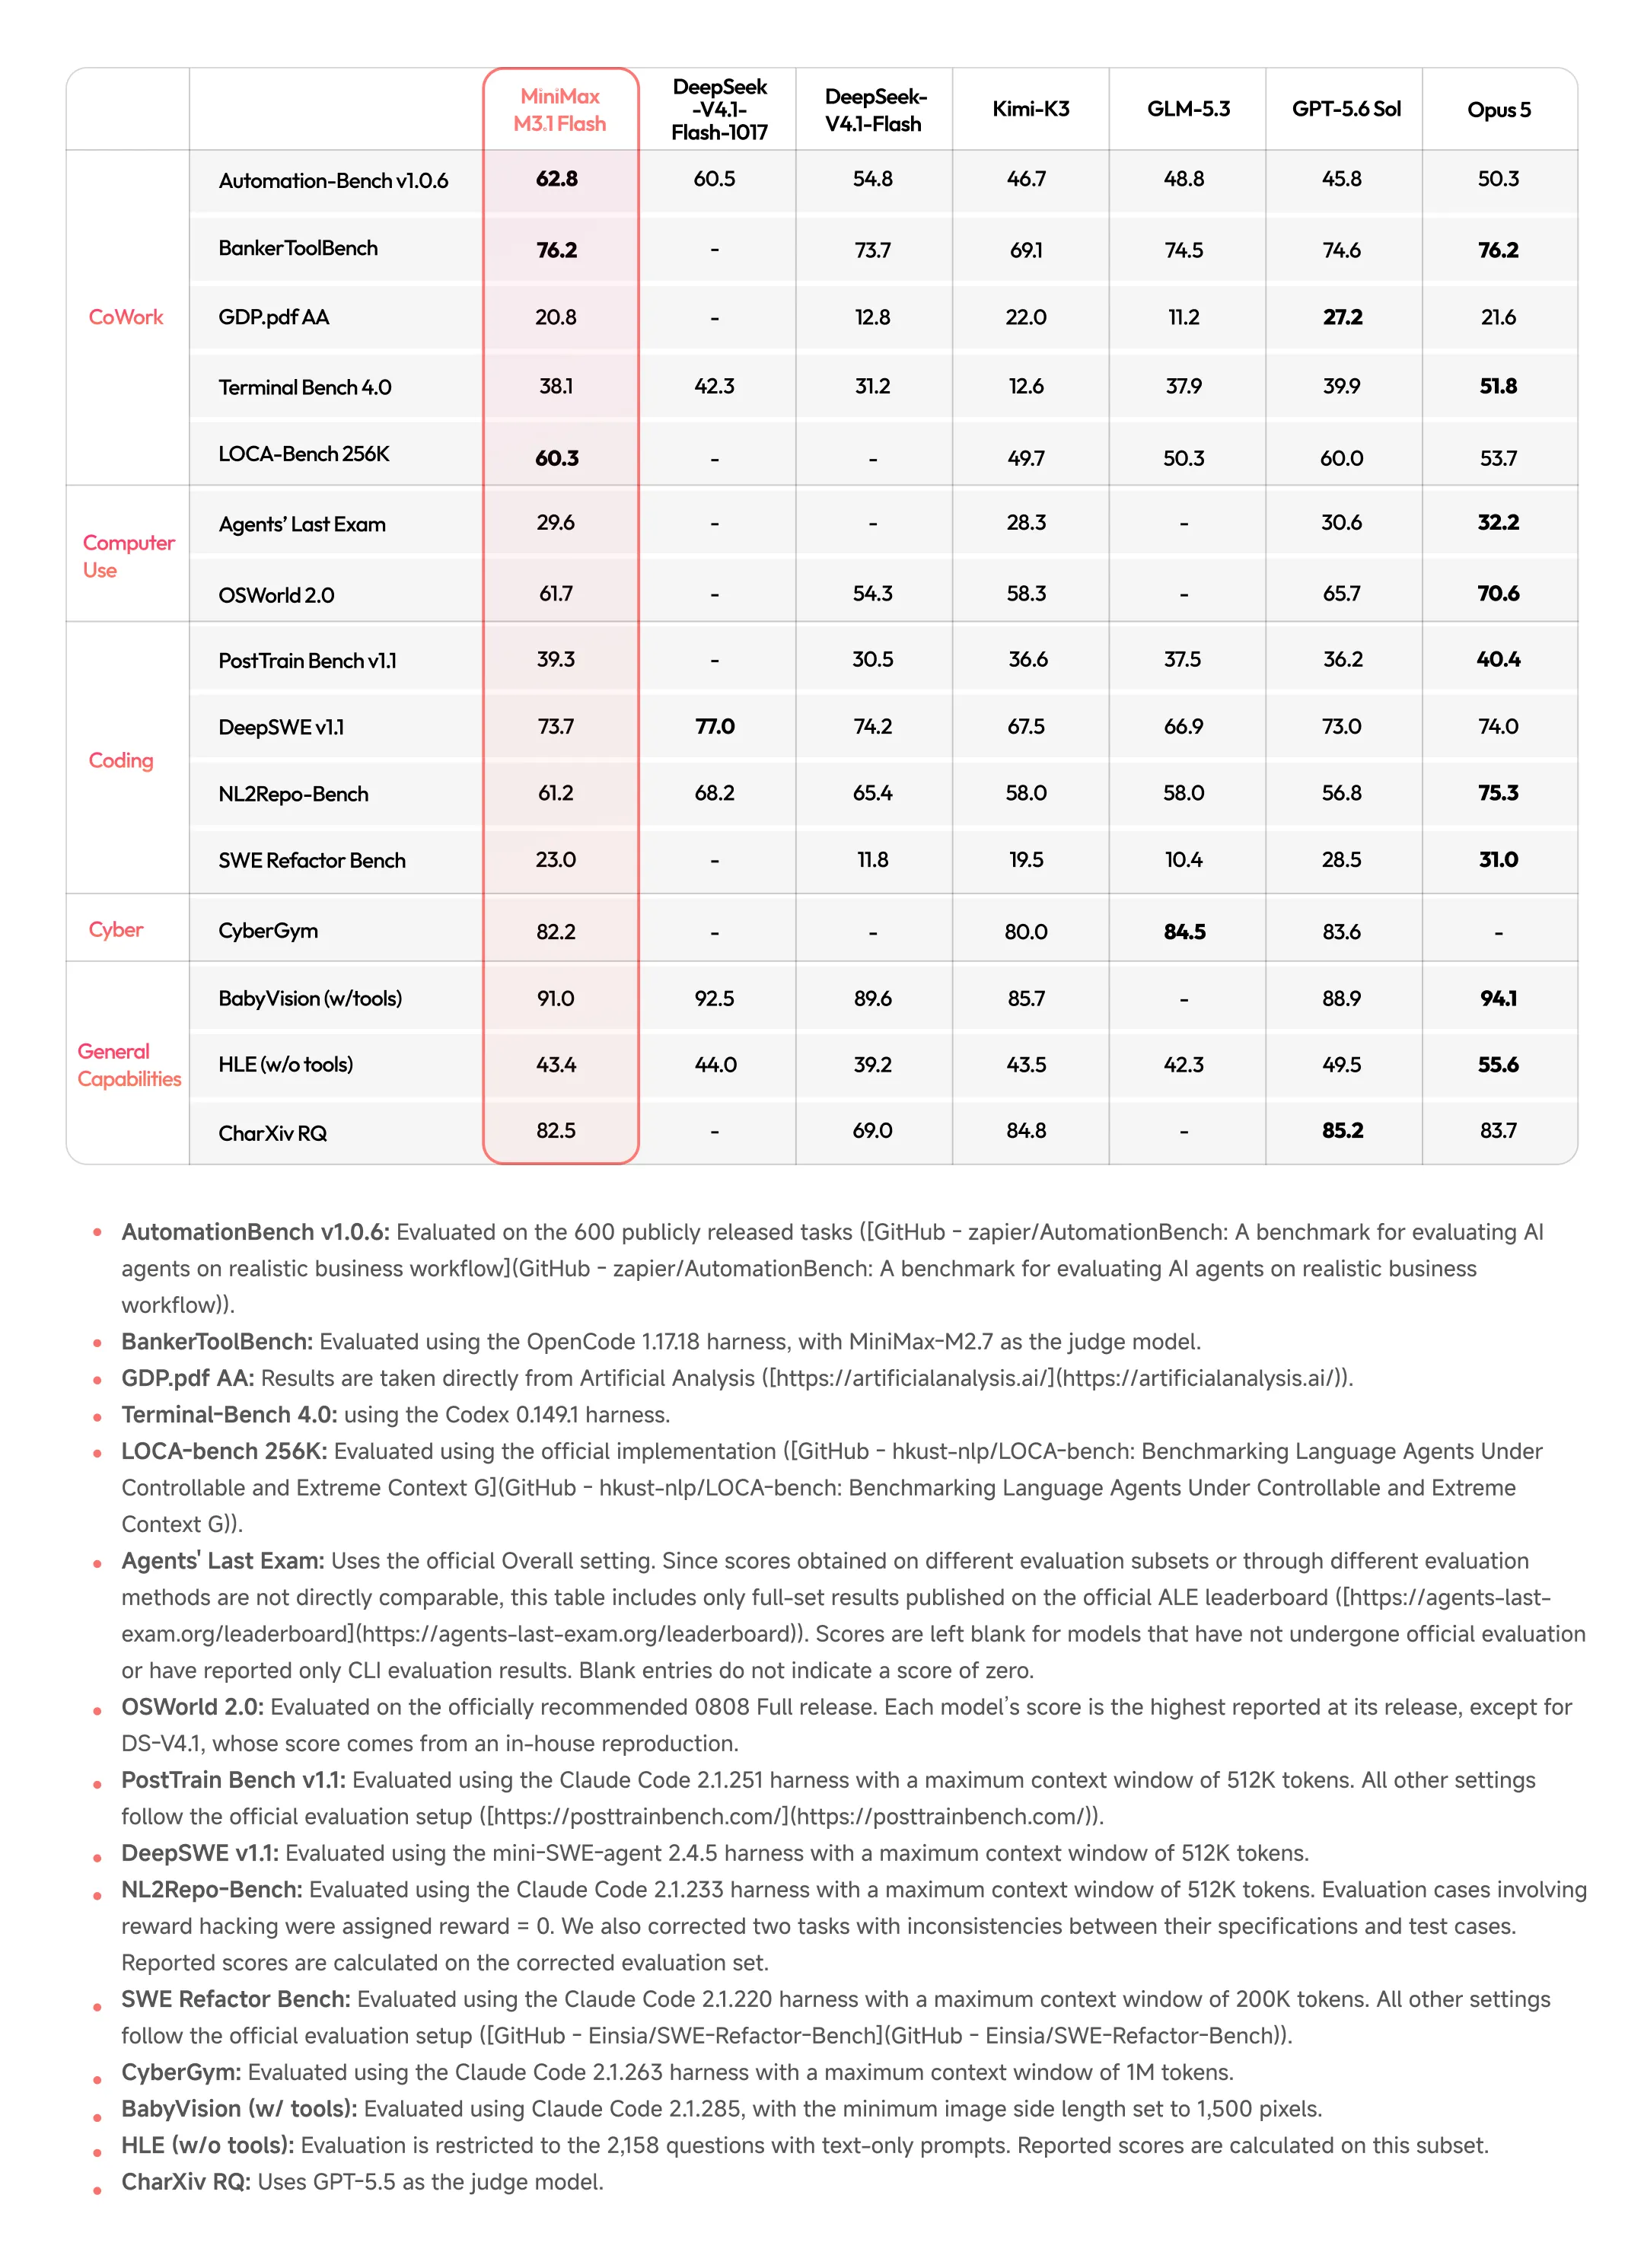
Comparação oficial de benchmarks da MiniMax, incluindo notas de avaliação. As pontuações são informadas pelo fornecedor e não representam um teste independente uniforme.
| Resultados oficiais de benchmark | M3.1 Flash | O que mede |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Automação empresarial de múltiplas etapas |
| BankerToolBench | 76.2 | Raciocínio financeiro e ferramentas |
| LOCA-Bench 256K | 60.3 | Execução de agente de longo contexto |
| DeepSWE v1.1 | 73.7 | Engenharia de software autônoma |
| Terminal Bench 4.0 | 38.1 | Resolução de problemas em terminal |
| OSWorld 2.0 | 61.7 | Interação com desktop/computador |
| Agents’ Last Exam | 29.6 | Tarefas econômicas complexas |
| CyberGym | 82.2 | Resolução de problemas de segurança cibernética |
| BabyVision with tools | 91.0 | Raciocínio visual com ferramentas |
| HLE without tools | 43.4 | Conhecimento e raciocínio desafiadores |
Automation-Bench v1.0.6 usa 600 tarefas públicas. BankerToolBench usa OpenCode 1.17.18 com MiniMax-M2.7 como juiz; Terminal Bench 4.0 usa Codex 0.149.1. DeepSWE v1.1 usa mini-SWE-agent 2.4.5 com limite de contexto de 512K. OSWorld usa a versão 0808 Full: a tabela combina a maior pontuação de cada modelo, exceto DeepSeek V4.1, que a MiniMax reproduziu internamente. Essas configurações diferentes limitam conclusões diretas entre modelos.
Para automação de negócios, priorize Automation-Bench e BankerToolBench; para agentes de codificação, examine DeepSWE e resultados baseados em terminal. OSWorld avalia interações com um ambiente de computador em vez de apenas gerar instruções. Uma única pontuação agregada não substitui a análise específica de tarefas.
Quão rápido é o MiniMax M3.1 Flash?
Sistemas de agentes frequentemente fazem muitas chamadas de modelo sequenciais, então o throughput sozinho não descreve a responsividade.
| Métrica de velocidade | Desempenho reportado |
|---|---|
| Throughput de saída de pico do dia a dia | 200+ tokens/s |
| Throughput mediano de saída (P50) | 170+ tokens/s |
| Melhoria de inferência online | Quase 3× vs geração anterior |
| Redução de custo de workload de agente | 70% vs predecessor |
Essas métricas de velocidade e custos de workload são reportadas pelo fornecedor e descrevem a avaliação de lançamento do MiniMax, não throughput ou economias garantidas para toda aplicação. Hardware de serving, concorrência, comprimentos de prompt e variabilidade entre execuções não são totalmente especificados no anúncio.
A latência de ponta a ponta também inclui atraso do primeiro token, overhead de raciocínio, tempo de ferramentas, novas tentativas e dependências entre etapas. Um gerador mais rápido pode perder a vantagem se um agente precisar de mais chamadas para concluir a mesma tarefa.
Quanto custa a API do MiniMax M3.1 Flash?
A MiniMax anunciou tarifas padrão fixas para o M3.1 Flash sem um nível separado mais alto para long context em sua descrição de preços inicial. Enquanto isso, a MiniMax M3.1 Flash Preview API na CometAPI oferece uma estrutura de preços separada com desconto de 20% em relação às suas tarifas de referência exibidas.
| Categoria de preço | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | Flat rate | Short-context tier | Long-context tier |
Os preços oficiais da API MiniMax tornam o M3.1 Flash particularmente atraente para workloads de agentes. Tokens de saída custam quatro vezes a taxa padrão de entrada, enquanto a entrada em cache custa um décimo. Instruções repetidas e históricos de ferramentas podem, portanto, se tornar um grande alvo de otimização.
Os preços Preview da CometAPI começam em $0.24 por milhão de tokens de entrada e $0.96 por milhão de tokens de saída, representando um desconto de 20% em relação aos seus preços de referência Preview exibidos. No entanto, essas tarifas permanecem mais altas do que os novos preços oficiais anunciados do M3.1 Flash porque as duas ofertas usam bases de preços diferentes.
Para desenvolvedores, a distinção principal é que a CometAPI fornece uma experiência de integração unificada, enquanto a versão oficial atualmente oferece menores taxas de tokens publicadas. Antes da implantação, verifique a versão ativa do modelo, o nível de comprimento de contexto e as regras de cobrança para estimar com precisão o custo de fluxos de trabalho de agentes autônomos.
Custo do MiniMax M3.1 Flash por tarefa de agente
Estimated inference cost = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Workload ilustrativo | Uncached input | Cached input | Output | Custo est. |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
Cálculos ilustrativos, não faturamento observado. Pressupõe que leituras em cache se qualifiquem para a taxa de cache anunciada; exclui cobranças de ferramentas, busca, navegador, infraestrutura e revisão humana.
Esforço de raciocínio e custo por tarefa
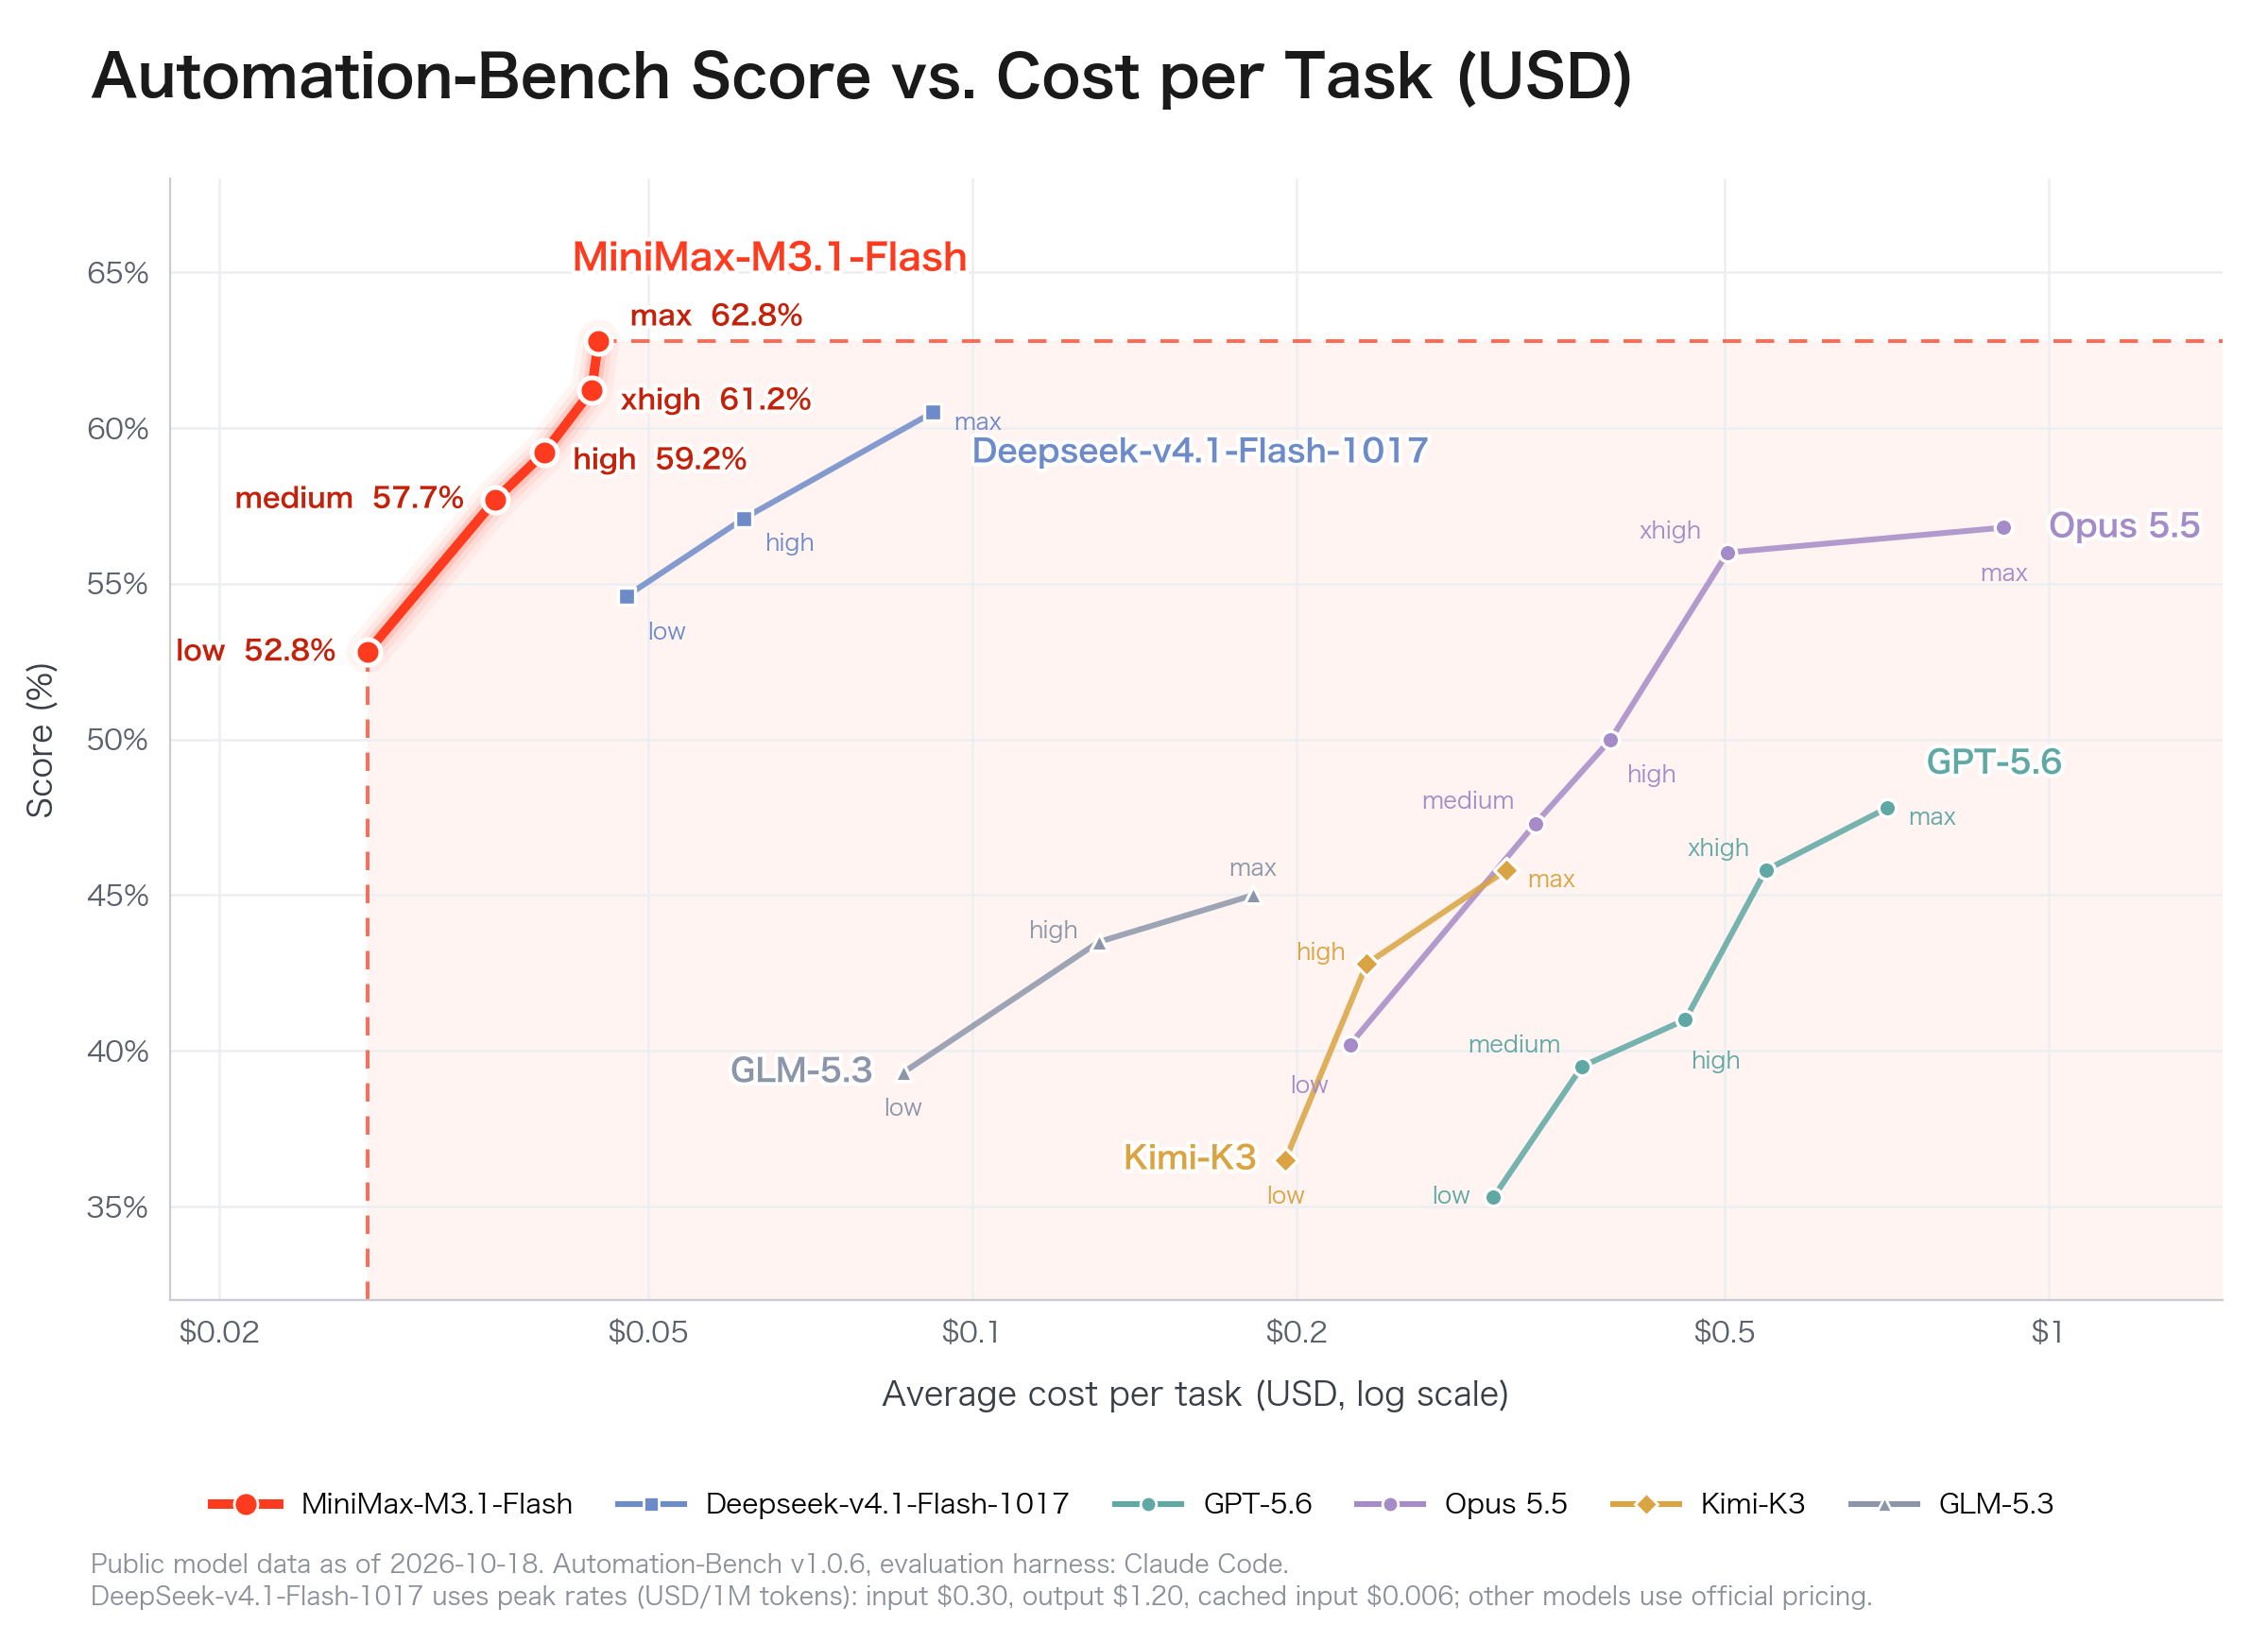
A análise de custos do Automation-Bench da MiniMax conecta esforço de raciocínio com sucesso no benchmark e gasto de inferência por tarefa.
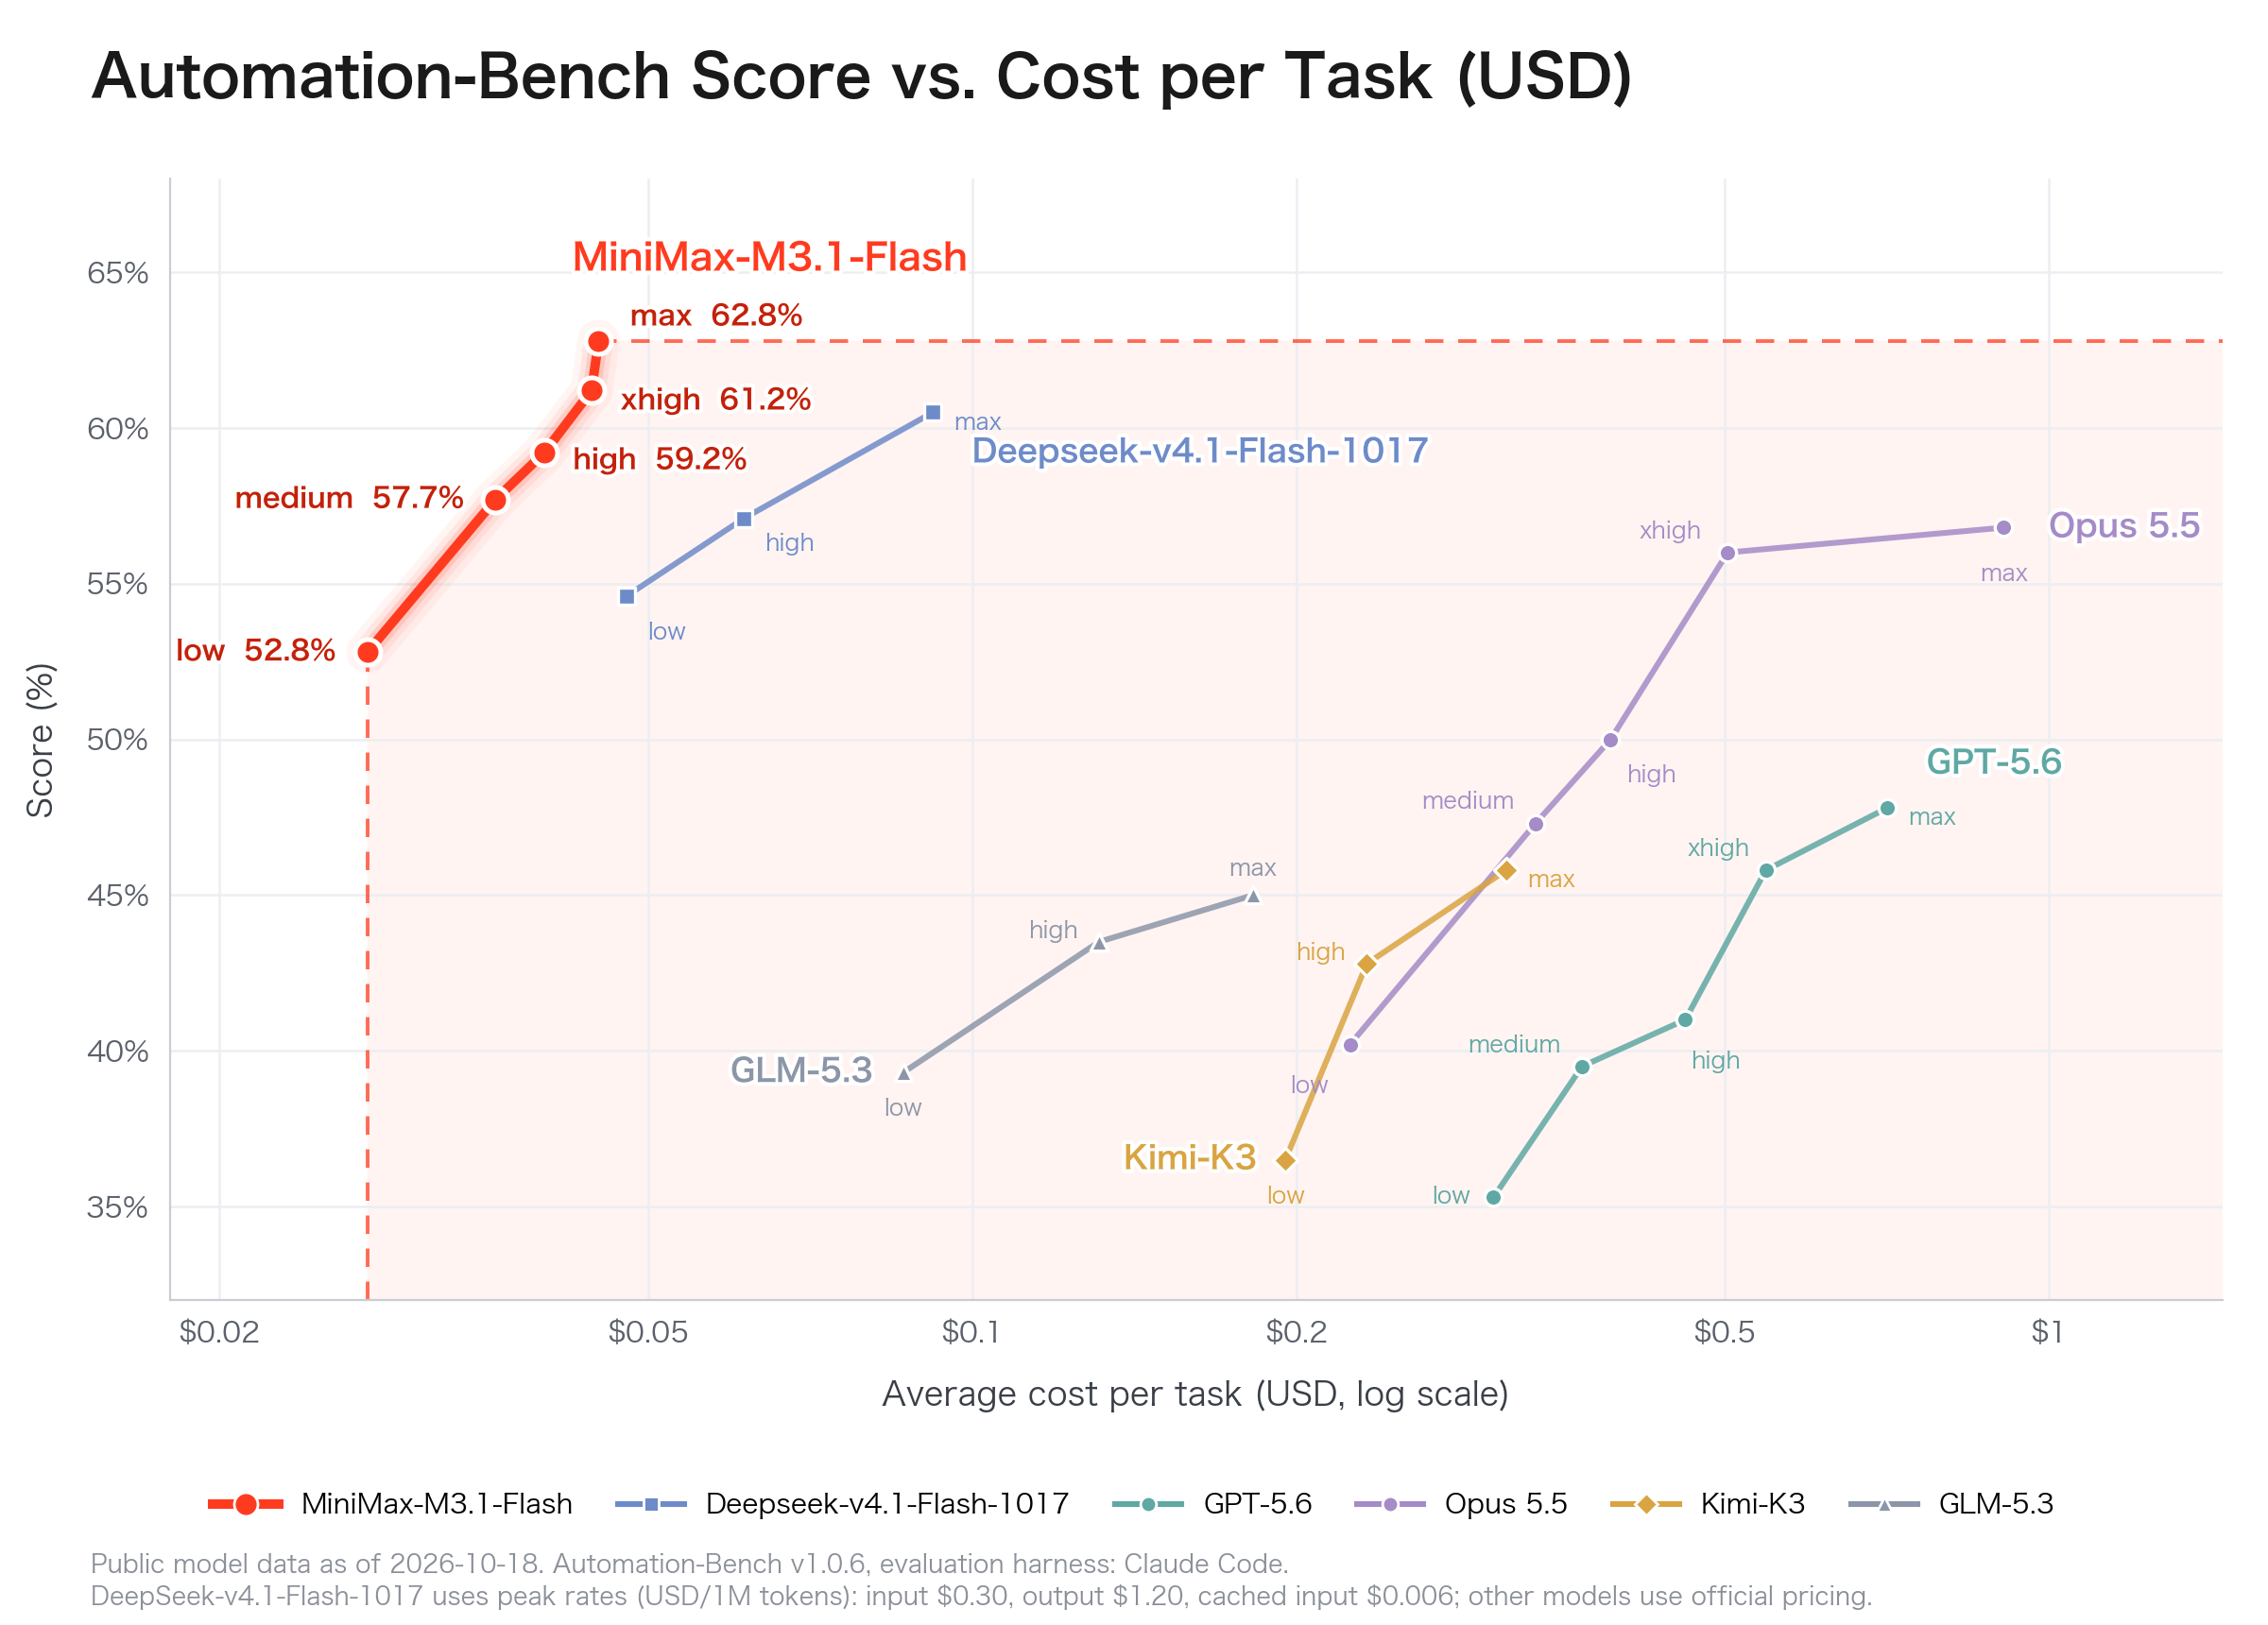
Gráfico oficial da MiniMax de pontuação versus custo no Automation-Bench. O eixo horizontal é logarítmico; custos exatos em dólares não são exibidos para os pontos da MiniMax.
As notas de avaliação do gráfico oficial especificam Automation-Bench v1.0.6 com o harness Claude Code e dados públicos de modelos em 18 de outubro de 2026. DeepSeek usa taxas de token de pico; os outros modelos usam preços oficiais. Detalhes de hardware e intervalos de confiança de execuções repetidas não são especificados.
| Esforço de raciocínio | Pontuação do Automation-Bench indicada |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
A tabela de comparação oficial atual e o ponto de esforço máximo mostram 62.8. A curva de custo compara configurações de esforço dentro do setup do fornecedor; ela não estabelece um custo fixo em dólares para um agente em produção.
A pontuação indicada sobe 10 pontos percentuais do esforço low ao max. Para implantação, compare medium e esforços mais altos em um conjunto de tarefas fixo, contando tentativas fracassadas e novas tentativas no gasto total. Escolha a configuração que atinja a meta de qualidade ao menor custo medido por tarefa aceita.
Como os desenvolvedores podem acessar o MiniMax M3.1 Flash via CometAPI?
Os desenvolvedores podem acessar a API do MiniMax M3.1 Flash na CometAPI. O catálogo público verificado em 20 de outubro de 2026 exibe o model ID minimax-m3.1-flash, embora sua URL mantenha um sufixo de preview. Use o model ID disponível para sua conta, em vez de derivar um identificador de API a partir da URL da página.
Envie uma solicitação POST para https://api.cometapi.com/v1/chat/completions com Authorization: Bearer YOUR_COMETAPI_KEY e Content-Type: application/json. No corpo JSON, defina model como minimax-m3.1-flash (se habilitado para sua conta) e forneça um messages array. Veja a documentação da CometAPI para detalhes da requisição.
Por que usar a CometAPI? Sua chave de API unificada, formato de requisição compatível e painel de uso podem simplificar o trabalho entre provedores de modelos. Para o MiniMax M3.1 Flash, pese essa conveniência de integração contra os preços específicos do provedor acima e verifique os recursos disponíveis para sua conta.
Quais agentes de IA se beneficiam mais do MiniMax M3.1 Flash?
| Caso de uso | Por que pode ser adequado | Consideração para implantação |
|---|---|---|
| Enterprise automation | Resultados fortes no Automation-Bench | Validar ferramentas e novas tentativas |
| Coding assistants | Desempenho competitivo no DeepSWE | Executar testes e revisar patches |
| Customer support | Preços baixos de entrada e cache | Monitorar a precisão |
| Research agents | Janela de contexto de 1M | Verificar evidências e fontes |
| Computer-use agents | Capacidade no OSWorld | Lidar com mudanças de UI e recuperação |
| Security code review | Resultado no CyberGym | Verificação independente |
Os benefícios são mais fortes quando um agente conclui tarefas suficientes corretamente para compensar custos de novas tentativas, orquestração e revisão. O uso em produção deve medir tanto o desempenho em nível de modelo quanto em nível de fluxo de trabalho.
O MiniMax M3.1 Flash é o melhor valor para agentes de IA?
O MiniMax M3.1 Flash é uma opção forte para agentes sensíveis a custo que envolvem contexto repetido e ferramentas estruturadas, mas o menor preço por token nem sempre produz o menor custo por tarefa bem-sucedida. Chamadas com falha, novas tentativas adicionais e intervenção humana podem eliminar as economias. Avalie taxa de conclusão aceita, tempo de ponta a ponta, custo total por tarefa bem-sucedida e taxa de intervenção humana.
FAQ
Por que o MiniMax M3.1 Flash pode retornar uma resposta vazia?
Na API nativa compatível com OpenAI da MiniMax, thinking tokens consomem o orçamento de geração. Um limite muito pequeno pode encerrar uma solicitação com finish_reason definido como length antes que texto de resposta visível seja produzido. Inspecione o motivo de término e o uso de tokens, aumente o orçamento de completion quando apropriado e trate reasoning_content separadamente da resposta final. Confirme a mesma semântica de resposta em uma rota de terceiros.
Como o histórico de chamadas de ferramentas do MiniMax M3.1 Flash deve ser armazenado?
Preserve a mensagem completa do assistant, incluindo tool calls e reasoning content, antes de anexar os resultados correspondentes das ferramentas. Salvar apenas a resposta visível pode remover informações necessárias para a próxima etapa. Mantenha os IDs das chamadas de ferramenta e a ordem das mensagens e valide o comportamento de replay usando o endpoint real do provedor. As diretrizes de histórico de conversas da MiniMax descrevem os requisitos da API nativa.
Como as equipes podem detectar mudanças de roteamento do MiniMax M3.1 Flash?
Mantenha um pequeno conjunto de regressão com entradas fixas, estrutura de saída esperada e assertivas de chamadas de ferramentas. Registre o model ID solicitado, o identificador de modelo retornado quando presente, o provedor, o timestamp e o uso faturado. Execute novamente após atualizações do provedor; um alias estável por si só não demonstra que o checkpoint subjacente ou o comportamento permanecem inalterados.
Como deve ser feita a migração para o MiniMax M3.1 Flash?
Comece com tarefas somente leitura ou reproduzidas e, em seguida, direcione uma pequena parcela do tráfego ao vivo mantendo um fallback testado. Defina limites de rollback para chamadas de ferramentas inválidas, timeouts e tarefas malsucedidas antes de aumentar o tráfego. Revise exemplos de regressões em vez de confiar apenas em pontuações médias, porque um pequeno número de falhas onerosas pode superar preços de token mais baixos.
Conclusão
O MiniMax M3.1 Flash melhora a economia de agentes de IA autônomos por meio de tokens baratos, raciocínio configurável, uma grande janela de contexto e fortes resultados relatados em automação e codificação. Sua principal vantagem é o equilíbrio entre desempenho, latência e custo por tarefa — não a superioridade absoluta em todos os benchmarks.
Os desenvolvedores devem validar taxas reais de conclusão de fluxos de trabalho e custos totais de agentes e, em seguida, escolher a rota do MiniMax M3.1 Flash cuja configuração ativa, recursos suportados e cobrança correspondam às suas necessidades.