
TLDR O MiniMax M4 não foi lançado. A MiniMax se comprometeu publicamente com uma nova geração de modelos da série M (e de vídeo Hailuo) no segundo semestre de 2026. O carro-chefe atual continua sendo o MiniMax M3 (lançado em 1 de junho de 2026: ~428B no total / ~23B de parâmetros ativos, contexto de 1M tokens via MiniMax Sparse Attention, multimodal nativo, pesos abertos, 59.0% no SWE-Bench Pro).
Um refresh de eficiência de meio de ciclo, Minimax M3.1 Flash, foi lançado em 19 de outubro de 2026, oferecendo aproximadamente 3× mais velocidade de inferência e ~70% de redução em custos de agentes. Desenvolvedores já podem acessar a linha MiniMax atual (incluindo M3 e M3.1 Flash) por meio de gateways unificados como o CometAPI para roteamento, monitoramento e controle de custos simplificados.
Principais pontos
- MiniMax M4 não foi lançado em 20 de outubro de 2026. A empresa apenas se comprometeu com “uma nova geração de modelos da série M e Hailuo no segundo semestre de 2026”.
- Modelos de produção atuais: MiniMax M3 (1º de junho de 2026) e o focado em eficiência M3.1 Flash (19 de outubro de 2026).
- O M3 apresentou MSA (MiniMax Sparse Attention), viabilizando contexto prático de 1M tokens, entendimento nativo de imagem/vídeo, pontuações fortes em programação/agentes e pesos abertos.
- O M3.1 Flash prioriza velocidade e custo (alega ~3× de aceleração de inferência e 70% de redução nos custos de agentes) mantendo contexto de 1M e entradas multimodais; espera-se a liberação dos pesos pouco após o lançamento.
- Um relatório de julho de 2026 descreveu um esforço interno de ~2,7 trilhões de parâmetros (internamente chamado de M3 Pro) com possível liberação de pesos abertos já no 3º trimestre de 2026; isso não se materializou publicamente e é distinto do compromisso mais amplo da “nova geração”.
- Melhorias esperadas do M4 (especulativas, com base na trajetória): ganhos adicionais em programação/agentes, eficiência refinada em longo contexto, capacidades multimodais ou de uso de computador mais fortes e continuidade de preços agressivos.
- Recomendação de acesso: use um gateway multiprovedor como o CometAPI para rotear tráfego entre MiniMax M3/M3.1 Flash (e futuro M4) juntamente com outros modelos de ponta, com faturamento unificado, observabilidade e lógica de fallback.
O MiniMax M4 realmente está chegando em breve?
Informações confirmadas
A questão principal não é se a MiniMax está desenvolvendo sistemas de IA futuros, mas se há evidências concretas de que um modelo chamado MiniMax M4 está próximo do lançamento.
A MiniMax lançou o M3 em junho de 2026 e lançou formalmente o M3.1 Flash em 19 de outubro de 2026. Esse é um lançamento intermediário confirmado, não prova de um cronograma do M4. Anúncio oficial de lançamento.
O arquivo de pesquisa oficial agora inclui o M3.1 Flash. Não foi encontrado anúncio de lançamento do M4 nas fontes oficiais revisadas em 20 de outubro de 2026.
| Categoria de evidência | Constatação | Avaliação |
|---|---|---|
| Anúncio oficial do M4 | Não verificado | Não confirmado |
| Identificador público do M4 | Não verificado | Não confirmado |
| Screenshot vazado de benchmark do M4 | Nenhuma evidência independentemente verificada encontrada | Não confirmado |
| Endpoint de API do M4 | Não verificado | Não confirmado |
| Preços do M4 | Não publicados | Desconhecido |
| Pesos do modelo M4 | Não verificado | Desconhecido |
| Lançamento do MiniMax M3 | 1 de junho de 2026 | Confirmado |
| Lançamento do M3.1 Flash | Lançado em 19 de outubro de 2026; disponível via MiniMax API, M Plan e MiniMax Code | Confirmado |
Relatos da comunidade / Vazamentos
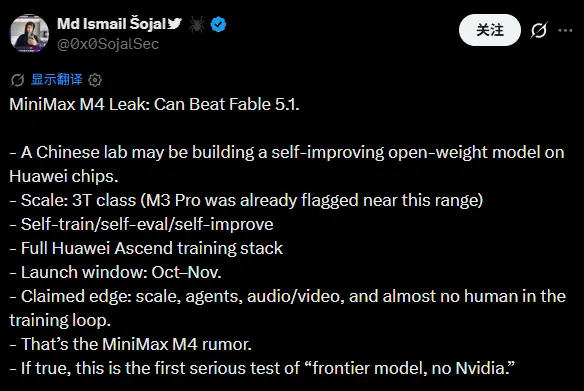
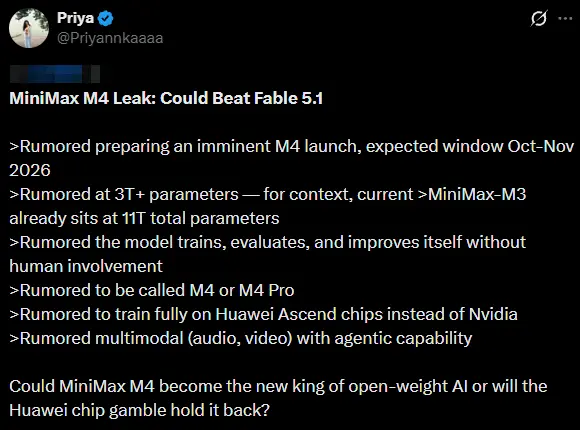
Dois posts no X datados de 27 de setembro de 2026 discutem um possível lançamento do M4. Eles mostram que essas alegações circulavam na comunidade, não que a MiniMax as tenha confirmado. Ambos são tratados aqui como relatos comunitários não verificados; o selo de verificação paga de nenhum dos autores estabelece a precisão das afirmações.
Em um post de @0x0SojalSec, o autor sugere um modelo de aproximadamente três trilhões de parâmetros, uma liberação com pesos abertos e treinamento em hardware Huawei Ascend. O trecho legível também descreve um loop em que o modelo participa de seu próprio treinamento e avaliação. Essas são afirmações do autor do post, não especificações verificadas do M4.
Um post de Priya (@Priyannkaaaa)sugere um possível lançamento entre outubro e novembro de 2026 e uma contagem de parâmetros superior a três trilhões. Também faz uma alegação não verificada sobre o tamanho do modelo M3 anterior. Essa comparação não é adotada como linha de base factual neste artigo.
Quando o MiniMax M4 poderia ser lançado?
Modelos anteriores continuam úteis como referência, incluindo a MiniMax M2.5 API no CometAPI. Suas datas estabelecem histórico, não uma previsão do próximo lançamento.
A MiniMax não confirmou uma data de lançamento do M4. A janela de outubro-novembro de 2026 mencionada no post comunitário da Priya é um rumor, não um cronograma oficial; o trecho subjacente e suas limitações são discutidos em Relatos da comunidade / Vazamentos. O histórico de lançamentos da família de modelos mostra tanto gerações principais quanto versões intermediárias, mas intervalos de lançamentos passados não conseguem prever de forma confiável a próxima versão.
| Marco | Cronograma oficial de lançamento | Importância |
|---|---|---|
| MiniMax M2.5 | 12 de fevereiro de 2026 | Programação e produtividade |
| MiniMax M2.7 | 18 de março de 2026 | Melhorias em fluxos de trabalho de agentes |
| MiniMax M3 | 1 de junho de 2026 | Contexto de 1M e multimodalidade |
| M3.1 Flash | 19 de outubro de 2026 — lançamento oficial | Modelo voltado à eficiência em código e agentes |
| MiniMax M4 | Não anunciado | Nenhuma linha do tempo verificada |
Um anúncio formal de produto da MiniMax seria o sinal mais forte. Documentação de API ou um identificador de modelo autenticado forneceriam suporte adicional. Resultados de benchmarks e fichas públicas do modelo permitiriam avaliar melhorias técnicas, enquanto preços oficiais e limites de taxa determinariam a viabilidade em produção.
Preço do MiniMax M4 — O que os vazamentos e gerações anteriores sugerem
Não há preços oficiais para o M4. Todos os números abaixo são extrapolações das tabelas de preços vigentes do M3 e M3.1 Flash (USD, por milhão de tokens, aproximados em meados de outubro de 2026):
| Modelo | Entrada / 1M | Saída / 1M | Entrada em cache | Contexto | Observações |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Preço de tabela com “50% off permanente”; nível superior para >512k de contexto |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% mais barato que o M3; otimizado para throughput de agentes |
| Faixa esperada para M4 (especulativo) | $0.20–$0.40 | $0.80–$1.50 | Estrutura de desconto similar | 1M+ | Provavelmente continuará entre as ofertas de pesos abertos de ponta mais baratas |
Fontes para os preços atuais: documentação da plataforma MiniMax, agregadores independentes e anúncios de lançamento.
A MiniMax tem posicionado repetidamente seus modelos a uma fração do custo dos principais modelos fechados ocidentais, igualando ou superando-os em benchmarks selecionados de programação e agentes. Espera-se que um M4 completo continue essa estratégia, com possíveis tiers premium para contexto estendido, latência prioritária ou maior esforço de raciocínio.
Recomendação do CometAPI: Em vez de gerenciar várias chaves de API e tabelas de preços da MiniMax diretamente, faça o roteamento por um gateway unificado como o CometAPI. Isso permite alternar sem atrito entre M3, M3.1 Flash e, quando disponível, M4, com fallbacks automáticos, análises de uso e frequentemente melhor preço efetivo via agregação de volume — especialmente valioso para workloads de agentes que consomem grandes quantidades de tokens.
O que o MiniMax M3.1 Flash revela sobre a próxima geração
MiniMax M3.1 Flash provides um ponto de referência mais atual para avaliar o que um futuro MiniMax M4 pode oferecer. Apresentado oficialmente em 19 de outubro de 2026, o M3.1 Flash foca em fluxos de trabalho agentivos, desenvolvimento de software, uso de computador e cibersegurança, enfatizando inferência mais rápida e menores custos de uso. Essas melhorias oferecem pistas úteis sobre as prioridades de engenharia atuais da MiniMax, embora não estabeleçam uma data de lançamento do M4 nem confirmem suas futuras especificações.
1. Confiabilidade de agentes está se tornando tão importante quanto inteligência bruta
Um dos temas mais claros no anúncio do M3.1 Flash é a ênfase em concluir tarefas complexas e de múltiplas etapas. A MiniMax reporta melhorias em fluxos de trabalho de agentes, programação, uso de computador e automação empresarial.
Essa direção sugere que a próxima geração de modelos pode ser julgada menos por desempenho isolado de perguntas e respostas e mais pela capacidade de concluir fluxos de trabalho inteiros de forma confiável.
Por exemplo, um agente de engenharia de software pode precisar inspecionar um repositório, identificar um defeito, modificar vários arquivos, executar testes, diagnosticar falhas e verificar o patch final. O sucesso depende não apenas da qualidade do raciocínio, mas também da seleção de ferramentas, rastreamento de estado, recuperação de erros e consistência ao longo de várias etapas.
Um futuro modelo M4 pode se basear nessa direção ao melhorar o planejamento de longo horizonte, reduzir chamadas de ferramentas desnecessárias e se recuperar de forma mais eficaz de ações com falha. Esses são alvos razoáveis de avaliação, não recursos confirmados do M4.
2. Eficiência de inferência pode se tornar uma grande vantagem competitiva
A MiniMax afirma que o M3.1 Flash entrega quase três vezes a velocidade de inferência online de seu antecessor e reduz os custos gerais de uso em 70% para tarefas agentivas. A empresa também atribui suas melhorias de eficiência a esparsidade mais agressiva.
Essas alegações destacam uma distinção importante entre inteligência do modelo e eficiência operacional prática. Um modelo que conclui uma tarefa com menos tentativas, menor latência e menor consumo de tokens pode ser mais valioso do que um modelo que obtém uma pontuação de benchmark ligeiramente maior, mas requer substancialmente mais recursos.
Para um possível M4, as questões relevantes incluirão se ele consegue sustentar alto throughput em tarefas de longa duração, preservar a qualidade de saída sob orçamentos de inferência mais restritos e reduzir o custo total de conclusão bem-sucedida da tarefa.
As melhorias relatadas do M3.1 Flash são alegações da empresa e devem ser avaliadas de forma independente sob cargas de trabalho comparáveis antes de serem tratadas como garantias gerais de desempenho.
3. Programação e uso de computador são áreas importantes a observar
The M3.1 Flash announcement reporta uma pontuação de 73.7% no DeepSWE v1.1, 61.7 no OSWorld V2 e 82% no CyberGym. Esses resultados cobrem diferentes aspectos de engenharia de software, interação com computador e cibersegurança, respectivamente.
Juntos, fornecem um ponto de partida mais útil para avaliar modelos futuros do que um único benchmark de uso geral.
Se a MiniMax introduzir o M4, os desenvolvedores devem buscar evidências de que ele melhora a conclusão prática de tarefas em vez de apenas produzir uma pontuação principal mais alta. Testes úteis podem incluir correções de bugs em nível de repositório, fluxos de trabalho entre aplicativos, automação de navegador, análise de vulnerabilidades e recuperação de chamadas de ferramentas com falha.
Comparações de benchmarks devem preservar a versão do conjunto de dados, o ambiente de execução, o arcabouço de agente, os limites de recursos e a metodologia de pontuação. Sem condições comparáveis, diferenças entre pontuações podem não refletir melhorias genuínas de capacidade.
4. Longo contexto e raciocínio multimodal ainda precisam de avaliação prática
O MiniMax M3 já suporta uma janela de contexto de até um milhão de tokens e entradas multimodais nativas, incluindo imagens e vídeo. O lançamento do M3.1 Flash mantém a janela de um milhão de tokens e combina entendimento multimodal com capacidades mais orientadas a agentes.
Isso significa que uma janela de contexto maior, por si só, não seria necessariamente um motivo convincente para atualizar para o M4.
Avanços mais significativos poderiam incluir melhor recuperação de repositórios grandes, maior consistência em documentos extensos, interpretação mais precisa de evidências visuais e coordenação mais confiável entre percepção e execução de ferramentas.
Por exemplo, um agente de desenvolvimento pode precisar inspecionar uma gravação de tela, identificar uma falha na interface do usuário, rastrear o código de aplicativo relevante, implementar uma correção e verificar o resultado. A qualidade do fluxo de trabalho completo importa mais do que a capacidade do modelo de processar uma entrada grande isoladamente.
Esses cenários representam possíveis prioridades de avaliação para o M4, não capacidades anunciadas pela MiniMax.
5. Lançamentos futuros podem ser avaliados por custo por tarefa concluída
O anúncio do M3.1 Flash reforça a importância de avaliar a economia do modelo no nível do fluxo de trabalho. Preços por token sozinhos não capturam o custo total de usar um agente.
Uma comparação mais útil considera a probabilidade de concluir uma tarefa com sucesso, o número de tentativas necessárias, o consumo de tokens, os custos de ferramentas, a latência e a intervenção humana.
Desenvolvedores que se preparam para um futuro M4 devem estabelecer uma linha de base com os modelos disponíveis atualmente e usar o mesmo conjunto de tarefas para comparar lançamentos subsequentes. Isso possibilita determinar se um novo modelo traz melhorias significativas de produtividade em vez de simplesmente alterar rankings de benchmarks.
Quão fortes são os benchmarks do MiniMax M3, e o que o M4 precisaria superar?
A MiniMax publicou um conjunto substancial de resultados de benchmark para o M3, fornecendo alvos mensuráveis para um modelo futuro. Os valores a seguir são resultados reportados do M3, não previsões do M4.
| Benchmark | Pontuação reportada do MiniMax M3 | O que avalia | Meta de verificação para o M4 |
|---|---|---|---|
| SWE-Bench Pro | 59.0% | Engenharia de software do mundo real | Maior resolução verificada de tarefas |
| Terminal-Bench 2.1 | 66.0% | Execução de agentes no terminal | Mais operações ponta a ponta bem-sucedidas |
| SWE-fficiency | 34.8% | Eficiência em tarefas de programação | Melhor desempenho sob orçamentos comparáveis |
| KernelBench Hard | 28.8% | Otimização de kernels de GPU | Kernels mais corretos e rápidos |
| MCP Atlas | 74.2% | Tarefas orientadas a ferramentas e MCP | Melhor seleção e execução de ferramentas |
Estes são resultados reportados pelo fornecedor no anúncio de 1 de junho de 2026, não reproduções independentes. As suítes medem resultados diferentes, portanto suas porcentagens não devem ser médias em uma única pontuação de acurácia.
Desempenho em programação e engenharia de software
O que temos confirmado (M3)
- SWE-Bench Pro: 59.0%
- Terminal-Bench 2.1: 66.0%
- Resultados fortes em correção de bugs do mundo real, desenvolvimento frontend/backend e otimização de kernels (avaliações internas da MiniMax mostraram iteração autônoma de múltiplas horas).
O que o M3.1 Flash adiciona: Alegações de ganhos adicionais em benchmarks de programação, agentes e cibersegurança, além de tokens por segundo dramaticamente mais altos e menor custo por trajetória de agente concluída.
O que permanece não confirmado / esperado para o M4: Pontuações absolutas mais altas em benchmarks do tipo SWE-Bench e de programação interativa multi-turn, melhor gestão de projetos de longo horizonte e maior capacidade de manter consistência ao longo de sessões com múltiplos arquivos e vários dias. Qualquer modelo em escala de 2,7T (se lançado) deve elevar ainda mais o teto de capacidade, embora a contagem de parâmetros ativos e a esparsidade determinem o custo no mundo real.
Eficiência de longo contexto e arquitetura
Confirmado: O M3 introduziu o MSA (MiniMax Sparse Attention), proporcionando contexto prático de 1M tokens com alegados 1/20 do cálculo por token da geração anterior de atenção densa, >9× de aceleração no preenchimento e >15× na decodificação em comprimentos extremos, mantendo desempenho próximo ao da atenção completa na maioria das capacidades.
Melhorias esperadas: Refinamentos nos padrões de esparsidade, melhor suporte a contextos ainda mais longos ou recuperação mais densa dentro da janela, menor pegada de memória para autohospedagem e melhor tratamento de documentos longos multimodais intercalados.
Capacidades multimodais e de uso de computador
Confirmado: Entendimento nativo de imagem e vídeo desde as primeiras etapas de treinamento, além de uso de computador (operação de desktop) demonstrado no MiniMax Code e em arcabouços de agentes.
Esperado para o M4: Integração mais estreita do entendimento de vídeo com o planejamento do agente, pipelines mais robustos de documento/screenshot para código e controle de computador multiaplicativo mais confiável ao longo de horizontes mais longos.
Fluxos de trabalho de agentes, uso de ferramentas e autoaperfeiçoamento
Confirmado: O M2.7 já experimentava loops de autoaperfeiçoamento recursivos. M3 e M3.1 Flash enfatizam colaboração multiagente, busca dinâmica de ferramentas, tarefas autônomas de longa duração e loops produtor-verificador no MiniMax Code.
Esperado: Equipes de agentes mais robustas de vários dias, melhor recuperação de falhas de ferramentas, suporte nativo a ecossistemas de ferramentas maiores e possivelmente continuação de técnicas de autoaperfeiçoamento ou busca evolucionária em escala maior.
Preço do MiniMax M4 — O que os vazamentos e gerações anteriores sugerem
Não há preços oficiais para o M4. Todos os números abaixo são extrapolações das tabelas de preços vigentes do M3 e M3.1 Flash (USD, por milhão de tokens, aproximados em meados de outubro de 2026):
| Modelo | Entrada / 1M | Saída / 1M | Entrada em cache | Contexto | Observações |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Preço de tabela com “50% off permanente”; nível superior para >512k de contexto |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% mais barato que o M3; otimizado para throughput de agentes |
| Faixa esperada para M4 (especulativo) | $0.20–$0.40 | $0.80–$1.50 | Estrutura de desconto similar | 1M+ | Provavelmente continuará entre as ofertas de pesos abertos de ponta mais baratas |
A MiniMax tem posicionado repetidamente seus modelos a uma fração do custo dos principais modelos fechados ocidentais, igualando ou superando-os em benchmarks selecionados de programação e agentes. Espera-se que um M4 completo continue essa estratégia, com possíveis tiers premium para contexto estendido, latência prioritária ou maior esforço de raciocínio.
Recomendação do CometAPI: Em vez de gerenciar várias chaves de API e tabelas de preços da MiniMax diretamente, faça o roteamento por um gateway unificado como o CometAPI. Isso permite alternar sem atrito entre M3, M3.1 Flash e, quando disponível, M4, com fallbacks automáticos, análises de uso e frequentemente melhor preço efetivo via agregação de volume — especialmente valioso para workloads de agentes que consomem grandes quantidades de tokens.
MiniMax M3 vs M3.1 Flash vs Direção esperada do M4
| Dimensão | M3 API no CometAPI (jun 2026) | MiniMax M3.1 Flash (out 2026) | Direção esperada do M4 (2º sem 2026+) |
|---|---|---|---|
| Status | Ativo, pesos abertos | Ativo, pesos iminentes | Não lançado |
| Parâmetros (aprox.) | 428B total / ~23B ativos | Escala semelhante | Desconhecido (possível MoE maior) |
| Contexto | 1M tokens (MSA) | 1M tokens | 1M+ com mais eficiência |
| Programação (SWE-Bench Pro) | 59.0% | Ganhos adicionais alegados | Esperam-se pontuações absolutas mais altas |
| Velocidade de inferência | Base forte | ~3× mais rápido (alegado) | Otimização adicional |
| Custo de agentes | Competitivo | ~70% menor (alegado) | Continuação de preços agressivos |
| Multimodal | Imagem + vídeo nativos | Mesmo + refinado | Integração mais profunda |
| Pesos abertos | Sim | Planejados em breve | Altamente provável |
| Preço da API (entrada/saída) | $0.30 / $1.20 | $0.15 / $0.60 | Faixa esperada de $0.20–$0.40 / $0.80–1.50 |
Seleção de modelo por fluxo de trabalho do desenvolvedor
Use o M3.1 Flash lançado como candidato de avaliação atual e mantenha o M3 e qualquer fluxo consolidado do M2.7 para comparação. Meça tarefas concluídas, tentativas adicionais, intervenções humanas e custo total no mesmo workload. Ajuste o esforço de forma deliberada em vez de assumir que o raciocínio máximo é sempre o melhor ponto de operação.
O M4 ainda não é uma escolha de produção acionável. A preparação mais útil é construir uma suíte de benchmarks reproduzível com os modelos existentes para que um futuro lançamento possa ser avaliado rapidamente.
Como acessar os modelos MiniMax atuais (e se preparar para o M4)
Enquanto aguarda o M4, o caminho prático é usar os modelos ativos:
- Obtenha uma chave de API da MiniMax na plataforma oficial.
- Ou, para confiabilidade em produção, faça o roteamento via um gateway multimodelo como o CometAPI. O CometAPI fornece um endpoint único e uma única chave que podem direcionar ao MiniMax M3, M3.1 Flash e outros provedores, com painéis de uso integrados, tratamento de limites de taxa e a capacidade de alternar modelos sem mudanças de código.
- Para agentes de programação, combine o modelo com o MiniMax Code (desktop/CLI) ou frameworks abertos que já suportam endpoints MiniMax compatíveis com Anthropic ou OpenAI.
- Monitore os canais oficiais da MiniMax e catálogos de agregadores; no momento em que um novo ID de modelo da série M aparecer, gateways como o CometAPI geralmente o disponibilizam rapidamente.
Essa abordagem minimiza lock-in e permite que as equipes avaliem M3 vs M3.1 Flash (e eventualmente M4) em workloads reais com observabilidade consistente.
Conclusão
O MiniMax M4 continua sendo um modelo futuro definido por um compromisso claro, porém de alto nível, da empresa, em vez de especificações concretas. A geração M3 já estabeleceu a MiniMax como uma concorrente séria de pesos abertos em programação, agentes e trabalho multimodal de longo contexto; o M3.1 Flash então empurrou a fronteira da eficiência. Qualquer que seja a forma que a “nova geração” do 2º semestre de 2026 assuma — seja rotulada M3.5, M4 ou outra — ela herdará uma base sólida de atenção esparsa, pesos abertos e preços agressivos.
Para desenvolvedores e equipes que constroem agentes de produção hoje, a recomendação acionável é direta: integre os modelos MiniMax ativos (M3 e M3.1 Flash) por meio de uma camada flexível multiprovedores como o CometAPI. Isso oferece vantagens imediatas de capacidade e custo enquanto posiciona você para adotar o M4 no momento em que ele aparecer em endpoints públicos — com mudanças mínimas de código e visibilidade total sobre desempenho e gastos.