Especificações técnicas do Qwen3.8-Flash
| Especificação | Qwen3.8-Flash |
|---|---|
| Provedor | Alibaba / Qwen |
| Família do modelo | Qwen3.8 |
| ID do modelo | qwen3.8-flash |
| Tipo de modelo | Modelo de raciocínio multimodal |
| Modalidades de entrada | Texto, imagem, vídeo |
| Modalidade de saída | Texto |
| Janela de contexto | 1,000,000 tokens |
| Saída máxima | 128,000 tokens |
| Orçamento máximo de raciocínio | 262,144 tokens |
| Modo de pensamento | Suportado |
| Chamada de função | Suportado |
| Ferramentas integradas | Suportado |
A documentação atual da API da Qwen lista qwen3.8-flash como um modelo Qwen3.8 de produção com uma janela de contexto de 1M tokens e saída máxima de 128K. Ele suporta entrada de texto, imagem e vídeo, chamada de função, ferramentas integradas e saída estruturada.
Para cargas de trabalho visuais, os limites documentados incluem até 16 megapixels por imagem, até 2,048 URLs de imagem ou 250 imagens Base64, e até 64 vídeos, com vídeos de até 2 horas.
O que é o Qwen3.8-Flash?
O Qwen3.8-Flash é o modelo de raciocínio multimodal de baixo custo da Alibaba na família Qwen3.8, projetado para programação, fluxos de trabalho baseados em agentes, análise de longo contexto e compreensão visual. Ele oferece a mesma classe de contexto de 1M tokens que o Qwen3.8-Max, visando um custo de API substancialmente menor. As orientações para desenvolvedores da própria Qwen recomendam explicitamente o Qwen3.8-Flash quando os usuários desejam capacidades semelhantes a um preço menor, enquanto o Qwen3.8-Max é posicionado como a opção com raciocínio mais forte.
O modelo é particularmente interessante porque “Flash” não significa um modelo pequeno e simples. O modelo de API de produção combina raciocínio de longo contexto, entrada multimodal, uso de ferramentas e saída estruturada em um endpoint relativamente econômico.
Quais são os principais recursos do Qwen3.8-Flash?
- Contexto de 1M tokens: O Qwen3.8-Flash pode processar documentos e bases de código extremamente longos, tornando-o adequado para análise de repositórios e sessões de agentes de longa duração.
- Compreensão multimodal: A API aceita texto, imagens e vídeo, permitindo que desenvolvedores combinem código, capturas de tela, gráficos, documentos e vídeo em um único fluxo de trabalho.
- Modo de raciocínio: O modelo suporta o modo de pensamento da Qwen, com um orçamento máximo de raciocínio documentado de 262,144 tokens.
- Suporte a agentes e ferramentas: Chamada de função e ferramentas integradas são suportadas, incluindo recursos como pesquisa na web, execução de código e ferramentas relacionadas hospedadas pela Qwen.
- Saída estruturada: Desenvolvedores podem solicitar respostas estruturadas, facilitando a integração do modelo em aplicativos que exigem JSON ou resultados restritos por esquema.
- Compreensão de vídeos longos: A documentação da API visual lista entradas de vídeo de até duas horas, tornando o Qwen3.8-Flash útil para análise de vídeo, e não apenas tarefas curtas de legendagem de imagens.
Quais são os melhores casos de uso para o Qwen3.8-Flash?
Programação e engenharia de software
A janela de contexto de 1M tokens é útil para grandes repositórios, longas sessões de depuração e análise de código com vários arquivos. O suporte a chamada de função e raciocínio também o torna adequado para agentes de programação, e não apenas para preenchimento de código.
Fluxos de trabalho baseados em agentes
O Qwen3.8-Flash suporta chamada de função e ferramentas integradas, permitindo que um aplicativo deixe o modelo recuperar informações, executar código ou interagir com sistemas externos.
Análise de documentos longos
Uma janela de contexto de um milhão de tokens torna o modelo apropriado para grandes contratos, documentação técnica, coleções de pesquisa e bases de conhecimento corporativas, onde, de outra forma, seria necessário dividir informações repetidamente.
Análise de vídeo e visual
O Qwen3.8-Flash aceita tanto imagens quanto vídeo. Os limites atuais da API visual permitem vídeos de até duas horas, tornando-o relevante para gravações de reuniões, tutoriais, aulas, demonstrações e análise de conteúdo visual de longa duração.
IA de produção sensível a custos
Este é, talvez, o maior diferencial comercial do modelo. A Qwen recomenda explicitamente o Flash como a alternativa de menor custo ao Qwen3.8-Max, tornando-o adequado para aplicações de alto volume em que o raciocínio de nível flagship não é necessário em todas as requisições.
Quais são as limitações do Qwen3.8-Flash?
O Qwen3.8-Flash não deve ser interpretado como o modelo de melhor desempenho na família Qwen3.8 apenas porque compartilha a janela de contexto de 1M com o Qwen3.8-Max.
O principal compromisso é capacidade versus custo: a própria Qwen recomenda o Qwen3.8-Max quando é necessário o desempenho de raciocínio mais forte.
Uma segunda consideração é que uma janela de contexto de 1M não significa que toda requisição deva conter um milhão de tokens. Contextos grandes aumentam os requisitos de processamento, e os desenvolvedores devem usar recuperação, cache e gestão de contexto quando o contexto inteiro não for necessário.
Por fim, os desenvolvedores devem distinguir o qwen3.8-flash hospedado do Qwen3.8-Flash-Next de pesos abertos. Este último é a prévia arquitetural e possui pesos e arquitetura documentados de forma independente; o modelo de API de produção deve ser documentado de acordo com suas próprias especificações de API.
O Qwen3.8-Flash é bom para aplicações de API em produção?
Sim, especialmente quando o aplicativo precisa de raciocínio multimodal, longo contexto, uso de ferramentas e custo de tokens relativamente baixo.
Ele é um candidato mais forte à produção do que o Flash-Next quando o requisito é simplesmente chamar uma API hospedada da Qwen, porque qwen3.8-flash é explicitamente exposto como um modelo de produção na documentação da API da Qwen, com limites definidos de contexto, saída, ferramentas e multimodalidade.
Para qualidade máxima de raciocínio, o Qwen3.8-Max continua sendo a escolha mais adequada. Para cargas de trabalho de alto volume em que custo e vazão importam mais, o Qwen3.8-Flash é a opção mais econômica.
Parâmetros da API do Qwen3.8-Flash
| Parâmetro | Finalidade |
|---|---|
| model | qwen3.8-flash |
| messages | Conversa e entrada multimodal |
| temperature | Controle de amostragem |
| max_tokens | Quantidade máxima de saída gerada |
| stream | Respostas em streaming |
| tools | Definições de funções/ferramentas |
| tool_choice | Comportamento de seleção de ferramenta |
| response_format | Configuração de saída estruturada |
| enable_thinking | Habilita o modo de raciocínio em APIs da Qwen compatíveis |
A documentação de início rápido usa o OpenAI SDK com o identificador de modelo qwen3.8-flash. O exemplo habilita o raciocínio com extra_body={"enable_thinking": True}.
Como usar a API qwen3.8-flash no CometAPI
Passo 1: Obter acesso à API
Faça login no cometAPI. Se você ainda não é nosso usuário, registre-se primeiro. Entre no seu console do CometAPI. Obtenha a chave de API de credencial de acesso da interface. Clique em “Add Token” no token da API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
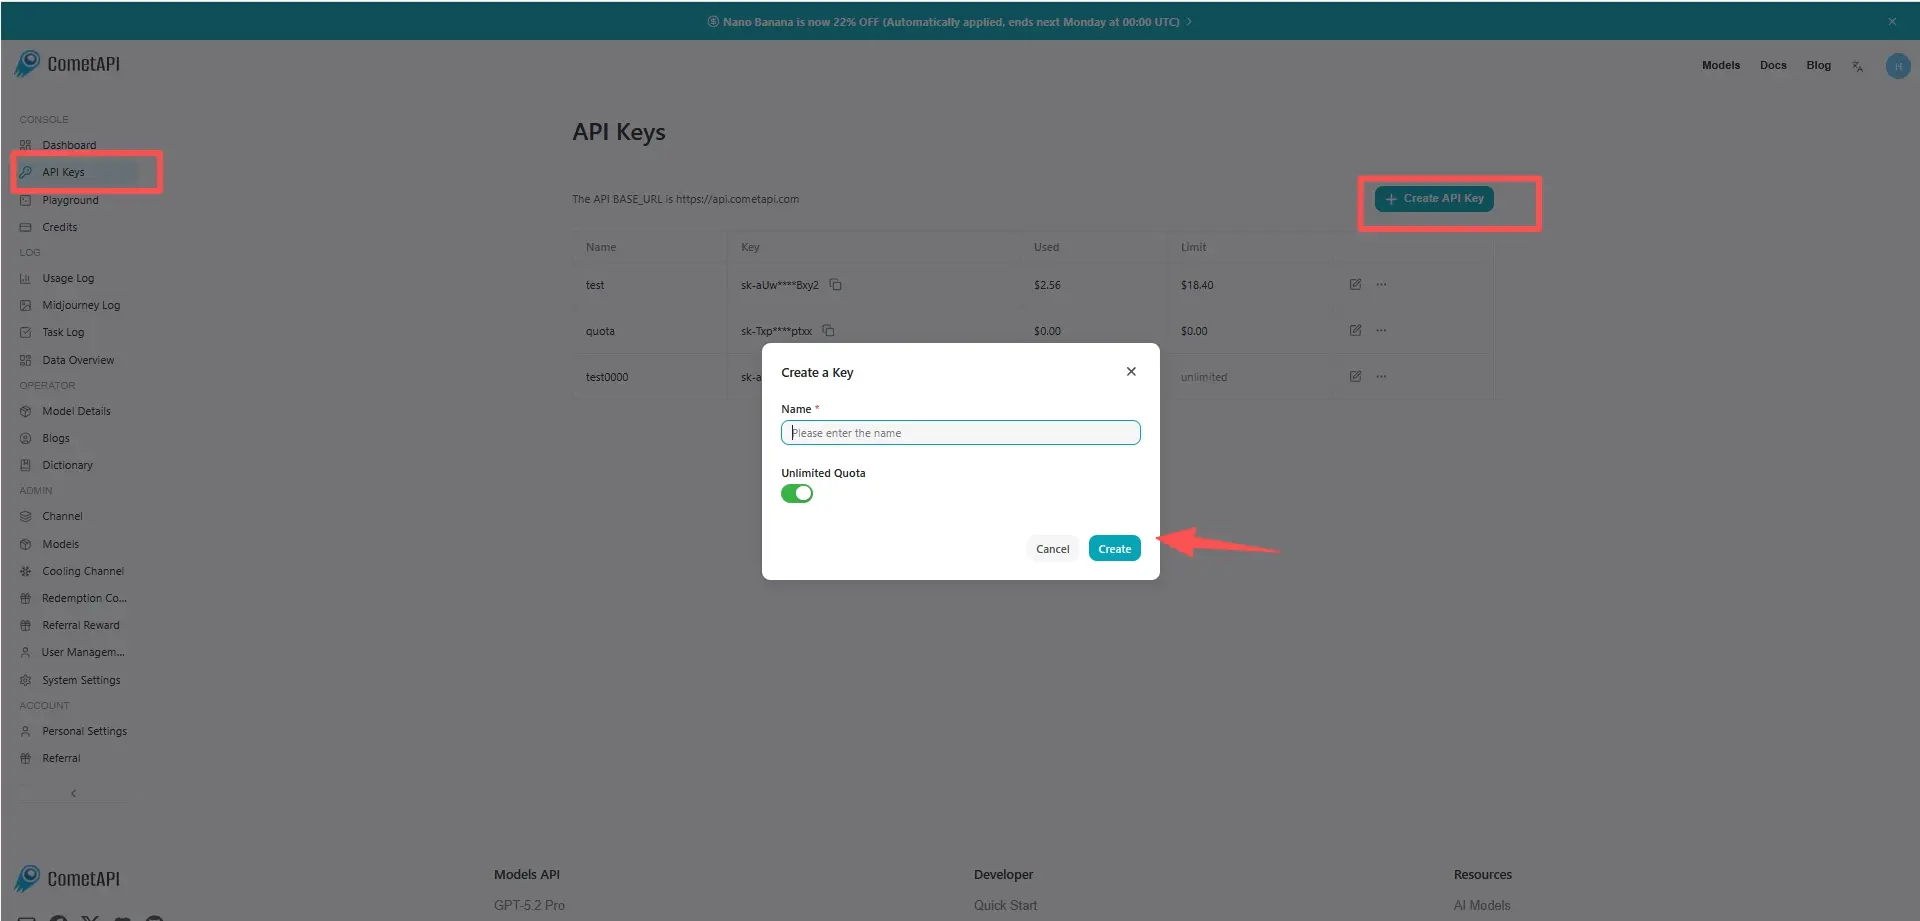
Passo 2: Enviar requisições para a API qwen3.8-flash
Selecione o endpoint “qwen3.8-flash” para enviar a requisição de API e defina o corpo da requisição. O método e o corpo da requisição são obtidos na documentação da API em nosso site. Nosso site também fornece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave real do CometAPI da sua conta.
Insira sua pergunta ou solicitação no campo content — é isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada. Há suporte a interfaces compatíveis com AI SDK, OpenAI Chat Completions, OpenAI Responses e Anthropic Messages.
Passo 3: Processar respostas
A API retorna respostas candidatas estruturadas, incluindo texto gerado, citações, metadados de segurança e saídas opcionais de ferramentas. Para requisições multimodais, o conteúdo da mensagem pode ser estruturado com entradas de texto e imagem quando o endpoint selecionado do CometAPI expuser a capacidade de visão do modelo.