Especificações técnicas do MiniMax M3.1-Flash
| Item | MiniMax M3.1-Flash |
|---|---|
| Model ID | MiniMax-M3.1-Flash |
| Model family | Série MiniMax M3.1, modelo de codificação |
| Release status | 27 de setembro de 2026 |
| Primary focus | Desenvolvimento de software do dia a dia, de correções de bugs a trabalho de recursos completos |
| Context window | 1,000,000 tokens |
| Input modalities | Texto, imagem e vídeo |
| Output modality | Texto |
| Reasoning control | reasoning_effort: low, medium, high, xhigh, max |
| Thinking behavior | Exige pensamento adaptativo; a documentação pública analisada não suporta desativar o pensamento |
| Maximum output | Não publicado separadamente nos materiais públicos analisados |
| Parameter count | Não divulgado publicamente |
| Open weights | Nenhum checkpoint/repositório de modelo público identificado |
A MiniMax anunciou o M3.1-Flash para MiniMax Code em 27 de setembro de 2026, posicionando-o em tarefas cotidianas de desenvolvimento, como correção de bugs e entrega de recursos completos. A cobertura pública atual identifica consistentemente uma janela de contexto de 1M tokens e esforço de raciocínio ajustável, observando que uma tabela de benchmark independente e o preço por token não foram publicados.
O que é o MiniMax M3.1-Flash?
MiniMax M3.1-Flash é um modelo de texto orientado à codificação, projetado para fluxos de trabalho iterativos de desenvolvimento de software em vez de apenas geração de código. A MiniMax descreve o fluxo como abrangendo compreensão de requisitos, localização de problemas, implementação, testes de regressão e verificação das alterações em relação à funcionalidade existente.
Seus controles diferenciadores documentados são o longo contexto e a escala de cinco níveis de esforço de raciocínio. Os níveis disponíveis são low, medium, high, xhigh e max, permitindo que os desenvolvedores troquem profundidade de raciocínio por latência conforme a complexidade da tarefa.
Principais recursos do MiniMax M3.1-Flash
- Contexto de 1M tokens: A descrição publicada do modelo atribui ao modelo uma janela de contexto de um milhão de tokens, tornando-o adequado para grandes repositórios, especificações extensas e sessões prolongadas de agentes de codificação.
- Entrada multimodal nativa: As descrições públicas do modelo listam texto, imagem e vídeo como entradas, enquanto o modelo retorna texto.
- Cinco níveis de esforço de raciocínio:
low,medium,high,xhighemaxoferecem controle mais fino sobre a profundidade do raciocínio do que um simples interruptor liga/desliga. - Fluxo de trabalho de codificação de ponta a ponta: A MiniMax posiciona especificamente o modelo para localização de bugs, implementação, tratamento de casos-limite, conclusão de testes de regressão e validação das alterações.
- Implantação orientada: A disponibilização pública inicial ocorre por meio do MiniMax Code e do Token Plan, em vez de uma oferta de modelo autônoma “pague conforme o uso” totalmente documentada.
- Adequação a agentes de codificação: O modelo é destinado a interações repetidas de desenvolvimento nas quais o contexto do repositório, a saída de ferramentas, testes e correções iterativas importam mais do que geração de código em uma única tentativa.
MiniMax M3.1-Flash vs outros modelos de codificação da MiniMax
| Modelo | Foco | Contexto | Dados de benchmark públicos | Acesso/status |
|---|---|---|---|---|
| M3.1-Flash | Codificação do dia a dia, desenvolvimento iterativo | 1M | Ainda não publicado | MiniMax Code / Token Plan |
| M3 | Codificação de ponta + trabalho com agentes, multimodalidade nativa | Até 1M | Publicado pela MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Engenharia de software + trabalho amplo com agentes/produtividade | Não usado aqui como uma especificação copiada do M3.1 | Publicado pela MiniMax | API, Token Plan, Agent |
M3 é o ponto de referência mais detalhado: a MiniMax publica sua arquitetura, metodologia de avaliação de codificação/agentes e disponibilidade de API. M2.7 também possui registro público de benchmarks e integração de API. M3.1-Flash é mais novo e atualmente tem um escopo de documentação pública mais estreito, portanto, as comparações devem se concentrar no posicionamento documentado em vez de declarar um vencedor em benchmarks. 4
Casos de uso representativos
- Correção de bugs em escala de repositório: Forneça ao modelo uma base de código grande, descrição do problema, logs e testes, e use seu longo contexto para preservar o contexto relevante do projeto.
- Implementação de recursos: Use o modelo para avançar de um requisito em linguagem natural até mudanças de código e testes de regressão.
- Revisão e remediação de código: Peça para identificar casos-limite, propor patches e verificar que as alterações não quebram o comportamento existente.
- Depuração multimodal: Forneça capturas de tela, diagramas ou vídeo juntamente com requisitos textuais quando o contexto visual fizer parte do problema de engenharia.
- Sessões longas de agentes de codificação: Use a grande janela de contexto para especificações, arquivos do repositório, saída de terminal e resultados de testes iterativos.
- Desenvolvimento sensível à velocidade: Selecione um nível menor de esforço de raciocínio para edições rotineiras e aumente o esforço para mudanças multietapas mais complexas.
Como acessar a API do MiniMax M3.1-Flash
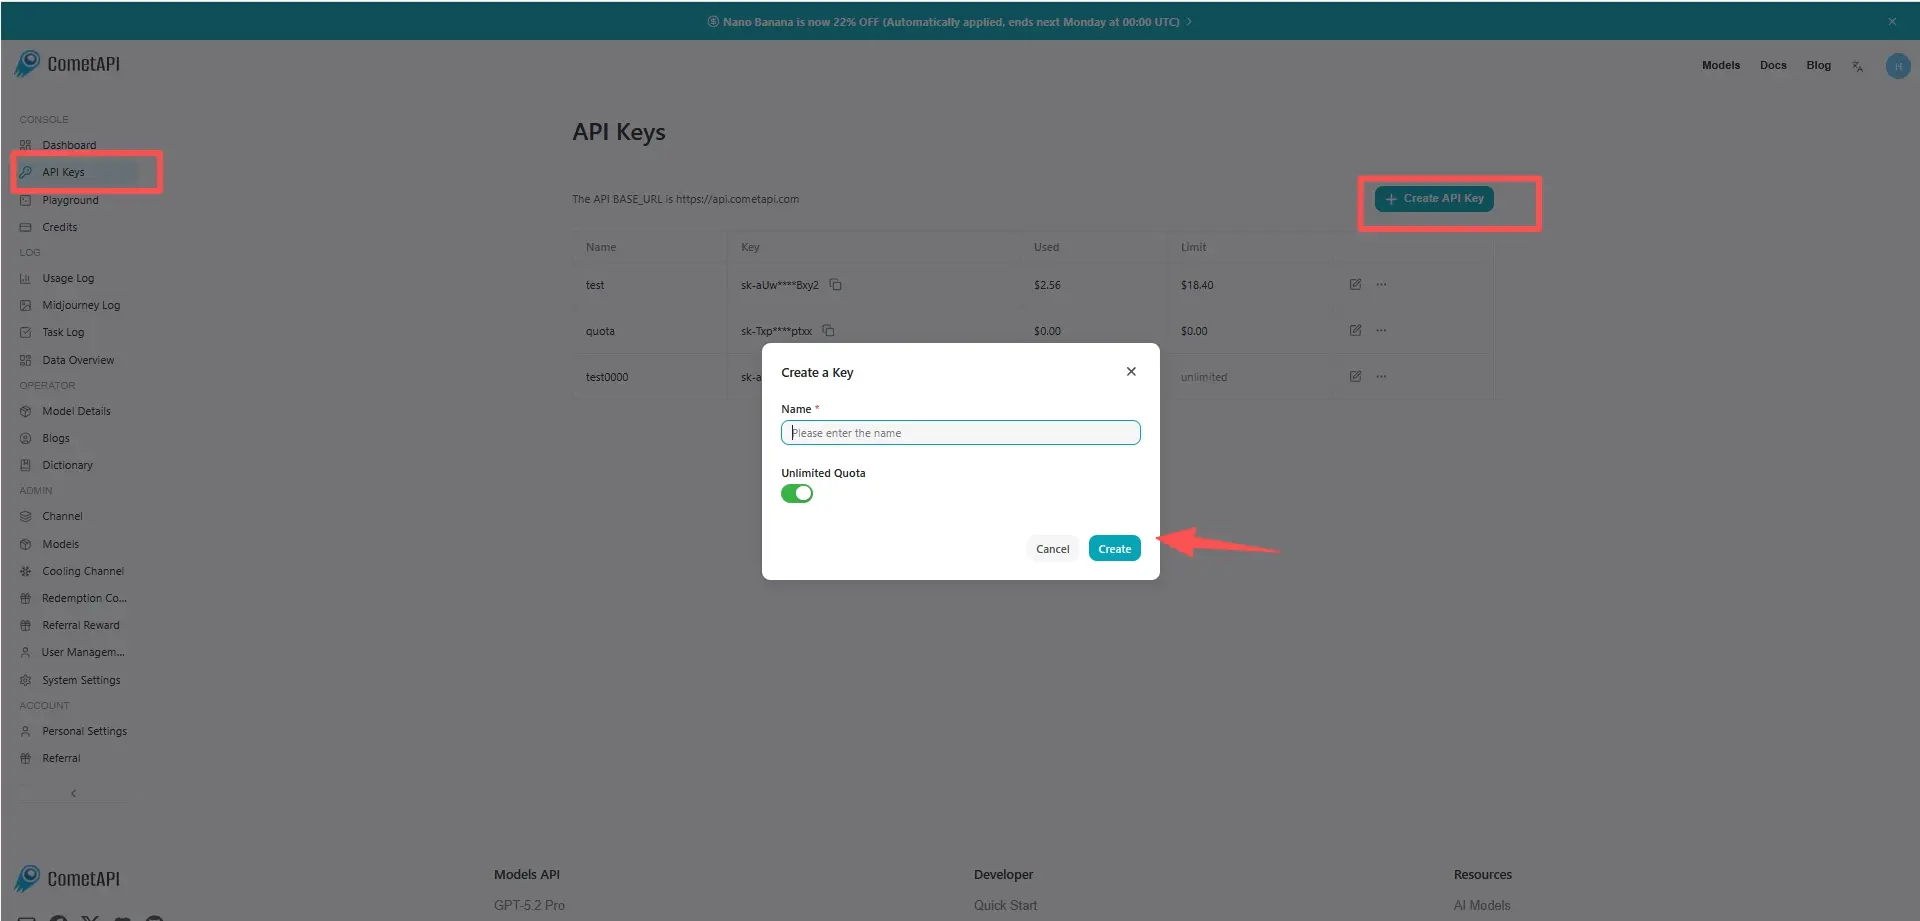
Etapa 1: Inscreva-se para obter a chave de API
Faça login em cometapi.com. Se você ainda não é nosso usuário, registre-se primeiro. Acesse seu console CometAPI. Obtenha a chave de API de credenciais de acesso da interface. Clique em “Add Token” no token de API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
Etapa 2: Envie solicitações para a API do MiniMax M3.1-Flash
Selecione o endpoint “minimax-m3.1-flash” para enviar a solicitação de API e defina o corpo da solicitação. O método e o corpo da solicitação são obtidos na documentação de API do nosso site. Nosso site também fornece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave CometAPI real da sua conta. A URL base é Chat Completions.
Insira sua pergunta ou solicitação no campo content — é isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Recupere e verifique os resultados
Processe a resposta da API para obter a resposta gerada. Após o processamento, a API responde com o status da tarefa e os dados de saída.