

Resumo
Muse Wonder, Claude Opus 5.5 e GPT-6 Sol são modelos de alta capacidade voltados para codificação e fluxos de trabalho com agentes. O novo Muse Wonder da Meta enfatiza memória persistente e execução sustentada; o Opus 5.5 lidera o índice agregado de inteligência citado; o GPT-6 Sol tem as menores tarifas padrão de entrada e saída para curto contexto nesta comparação, enquanto seu nível de longo contexto é tarifado separadamente. Escolha com base na qualidade em tarefas representativas, confiabilidade e custo total, em vez de um único placar.
Principais conclusões
- Inteligência geral: Claude Opus 5.5 marca 58 versus 52 do Muse Wonder no Intelligence Index v4.3 reportado.
- Codificação de longo horizonte: Muse Wonder registra 78.8 no DeepSWE 1.1 e 53.1 no SWE-Marathon; Opus 5.5 registra 74.2 e 46.3 na tabela da Meta.
- Raciocínio de baixo custo: GPT-6 Sol começa em $2 entrada / $10 saída por milhão de tokens via API padrão de curto contexto da OpenAI.
- Agentes com foco em memória: Muse Wonder introduz Active Memory e Active Focus.
- Disponibilidade importa: Muse Wonder Full é um produto separado e mais restrito do que o Muse Wonder padrão acessível a desenvolvedores.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol em um relance
Escolha o Muse Wonder para agentes persistentes e engenharia de longa duração, o Claude Opus 5.5 para codificação ampla e trabalho intenso em terminal, e o GPT-6 Sol para custos mais baixos de tokens em curto contexto padrão.
| Fator de decisão | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Comece testando com | Agentes persistentes e engenharia estendida | Codificação intensiva em terminal e fluxos profissionais | Codificação e automação sensíveis a orçamento |
| Janela de contexto | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Destaque publicado | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Entrada/saída padrão $2/$10 por 1M tokens |
| Entrada / saída padrão por 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; nível de curto contexto |
| Acesso ao provedor | Meta Model API; Full é um produto de assinatura separado | Anthropic API | OpenAI API |
| Métrica de seleção | Qualidade de tarefa aceita e custo total | Qualidade de tarefa aceita e custo total | Qualidade de tarefa aceita e custo total |
| Desenvolvedor | Meta | Anthropic | OpenAI |
| Lançamento | 12 de outubro de 2026 | 22 de setembro de 2026 | 16 de setembro de 2026 |
| Modalidades de entrada | Texto, imagem, áudio, vídeo; PDFs documentados | Texto, imagem | Texto, imagem |
| Saída | Texto | Texto | Texto |
| Capacidade distintiva | Active Memory e Active Focus | Fluxos com ferramentas e subagentes | Esforço de raciocínio configurável e ferramentas de API |
Esta visão geral resume as especificações datadas e os resultados publicados examinados abaixo. Linhas de benchmark usam métodos de avaliação diferentes, e tarifas baixas de tokens não estabelecem custo menor por tarefa bem-sucedida. Muse Wonder padrão e Muse Wonder Full são opções de acesso distintas.
As especificações foram verificadas em 13 de outubro de 2026. Modalidades e recursos suportados dependem do endpoint selecionado e da superfície de lançamento, incluindo disponibilidade de áudio. Capacidades no nível do modelo não garantem suporte em todas as rotas de gateway.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Visão geral e especificações
Muse Wonder: Fluxos de trabalho de agentes persistentes
A Meta introduziu o Muse Wonder e o Muse Wonder Full em 12 de outubro de 2026. O Muse Wonder padrão enfatiza tarefas profissionais de longa duração, memória persistente do agente e recuperação de obstáculos. Active Memory pretende recuperar contexto útil anterior, enquanto o Active Focus foi projetado para sustentar o progresso em trabalhos de múltiplas etapas. A Meta descreve codificação, pesquisa, análise financeira e assistência pessoal como cenários-chave.
Claude Opus 5.5: Codificação profissional e uso de ferramentas
O Claude Opus 5.5 tem como alvo codificação, raciocínio e fluxos de trabalho profissionais com múltiplas ferramentas. A Anthropic o lançou em 22 de setembro de 2026. Sua janela de contexto é de um milhão de tokens, enquanto os resultados de codificação relatados abaixo mostram pontos fortes que variam por benchmark.
GPT-6 Sol: Raciocínio voltado a custo
O GPT-6 Sol busca combinar raciocínio forte e uso de ferramentas com inferência comparativamente acessível. Ele suporta fluxos programáticos por meio do ecossistema de API da OpenAI. Suas tarifas padrão de curto contexto são menores que as listadas para o Claude Opus 5.5, embora a economia ponta a ponta também dependa de novas tentativas e do uso de tokens de raciocínio.
A OpenAI descreve o GPT-6 Sol como um modelo para codificação complexa e fluxos de trabalho agentivos; seu anúncio de lançamento fornece os resultados de avaliação usados abaixo. Este artigo compara as versões de modelo especificadas, não todos os modelos mais novos do portfólio de cada fornecedor.
Arquitetura e controles de raciocínio
As fontes citadas aqui não fornecem uma discriminação comparável de contagem de parâmetros e arquitetura para os três modelos. Portanto, não se justifica um ranking denso versus mixture-of-experts. Active Memory e Active Focus descrevem capacidades de agente da Meta; não substituem uma arquitetura neural divulgada. O GPT-6 Sol expõe esforço de raciocínio configurável, enquanto os escores relatados da Meta e do Claude também dependem de esforço e configuração de avaliação. Trate essas configurações como parte da comparação de configuração, não como medidas intercambiáveis de computação.
Resultado da comparação: Todos os três oferecem grandes janelas de contexto e APIs para desenvolvedores. O Muse Wonder documenta modalidades de entrada mais amplas no nível do modelo; Opus 5.5 e GPT-6 Sol enfatizam fluxos de texto e imagem. Capacidade de contexto e disponibilidade de recursos ainda precisam ser verificadas no endpoint selecionado.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Desempenho
Benchmarks publicados e limites de fonte
O card oficial do modelo da Meta oferece comparações diretas de Muse Wonder versus Claude Opus 5.5. A OpenAI publica resultados do GPT-6 Sol separadamente, portanto os três modelos não podem ser colocados em um único placar totalmente controlado sem harmonizar frameworks de avaliação, versões e configurações.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Maior pontuação |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
A metodologia oficial do card do modelo distingue testes internos, avaliações de terceiros e escores de concorrentes relatados por provedores. A tabela reproduz os valores reportados; ela não estabelece um ensaio uniforme e independentemente controlado em todas as linhas.
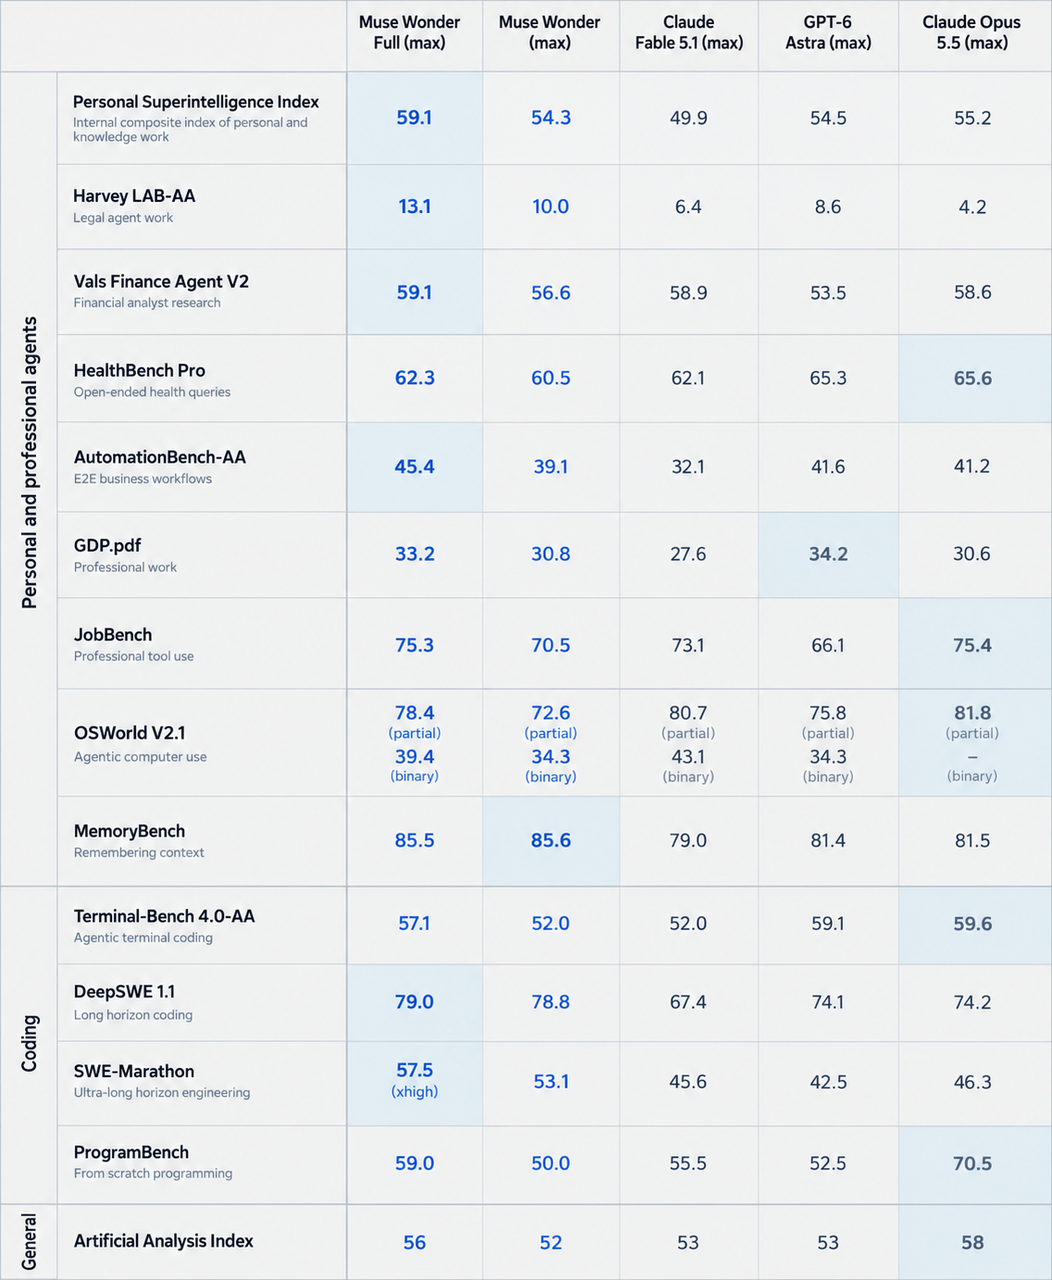
Placar original de benchmarks do card do modelo Muse Wonder da Meta, reproduzido sem redesenho. O modelo adicional da OpenAI mostrado nesta imagem oficial é o GPT-6 Astra, não o GPT-6 Sol. As tabelas adjacentes identificam os modelos relevantes para este artigo.
Condições de avaliação
O DeepSWE v1.1 abrange 113 tarefas em 91 repositórios e cinco linguagens, avaliadas por testes funcionais e de regressão usando pass@1; o placar da Meta usa resultados do Datacurve para Muse Wonder e Opus 5.5. O SWE-Marathon usa testes do projeto e reporta pass@1 da Abundant AI; os harnesses de agente variam, e a pontuação do Wonder Full é marcada como xhigh. O ProgramBench usa mini-swe-agent e mede execuções que passam pelo menos 95% dos testes ocultos, com a internet desabilitada após a configuração. O MemoryBench é o teste interno de conversação de 64K–100K tokens da Meta, pontuado por um LLM juiz. Esses ambientes e métricas não devem ser colapsados em uma única pontuação geral de acurácia.
Codificação e engenharia de software
O Muse Wonder lidera nos resultados reportados do DeepSWE 1.1 e do SWE-Marathon. O Claude Opus 5.5 lidera no Terminal-Bench 4.0-AA e no ProgramBench. Essa divisão sugere que engenharia de longo prazo, uso de ferramentas de linha de comando e reconstrução de programas exigem habilidades diferentes.
Resultados do GPT-6 Sol e comparabilidade entre fontes
| Avaliação publicada pela OpenAI | GPT-6 Sol | Configuração relatada |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
Os resultados de avaliação publicados pela OpenAI reportam as pontuações acima. Seu resultado no OSWorld é recompensa parcial no conjunto offline v2026.08.08, e não uma taxa estrita de conclusão de tarefas. A OpenAI observa que as avaliações usaram seu ambiente de pesquisa ou API; configurações de produção podem diferir.
Os escores reportados do DeepSWE implicam uma diferença de 10,0 pontos percentuais entre Muse Wonder e GPT-6 Sol, e de 5,4 pontos entre Opus 5.5 e GPT-6 Sol. São diferenças aritméticas entre publicações, não estimativas controladas de uma vantagem apenas do modelo. Diferentes setups de agente, prompts, níveis de esforço e orçamentos de ferramentas podem afetar o resultado.
Memória e agentes de longa execução
O Muse Wonder mira agentes que precisam lembrar decisões anteriores, recuperar contexto e continuar trabalhos interrompidos. Active Memory pode ajudar um assistente de pesquisa a lembrar fatos específicos do projeto, enquanto o Active Focus dá suporte a ação iterativa quando um plano anterior não tem sucesso. Essas capacidades de produto não substituem verificação de estado, permissões, trilhas de auditoria ou confirmação humana obrigatória para ações sensíveis.
Desempenho do Muse Wonder Full
O Muse Wonder Full é uma escolha de produto separada. A Meta oferece o Muse Wonder padrão via API, enquanto o Full é restrito às assinaturas Power Usage e Maximum Usage no Muse Code. Uma pontuação mais alta não torna o Full um substituto da API para o modelo padrão.
Os resultados reportados do Wonder Full pela Meta são 56 no Intelligence Index, 59.1 no Personal Superintelligence, 13.1 no Harvey LAB-AA e 45.4 no AutomationBench-AA. Ele também marca 79.0 no DeepSWE 1.1, 57.5 no SWE-Marathon, 85.5 no MemoryBench e 75.3 no JobBench. Esses resultados publicados descrevem o produto Full com acesso separado; não são novas medições de uma comparação em harness comum.
Comparado às pontuações do Muse Wonder padrão acima, o Full melhora em sete dessas oito medidas reportadas; o MemoryBench é ligeiramente menor em 85.5 versus 85.6. O Opus 5.5 ainda lidera o Intelligence Index reportado com 58.
Latência e confiabilidade
A evidência citada não fornece uma comparação de latência equiparada entre os três modelos. Meça o tempo até a primeira saída útil, o tempo de tarefa de ponta a ponta na mediana e no 95º percentil, a frequência de timeouts e a conclusão sem intervenção. Mantenha entradas de tarefa, permissões de ferramentas, concorrência e critérios de aceitação fixos; registre configurações de esforço e orçamentos de novas tentativas. Apenas gerar tokens mais rápido não estabelece conclusão mais rápida de uma tarefa de múltiplas etapas.
Resultado da comparação: Muse Wonder lidera os testes citados de engenharia sustentada, enquanto o Opus 5.5 lidera os testes citados de terminal e reconstrução de programas. GPT-6 Sol permanece um candidato com preço de token mais baixo, mas as publicações disponíveis não provam um ranking de qualidade ou velocidade em ambiente igual entre os três.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Custo
Preços oficiais por token de API
| Preço por 1M de tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Entrada padrão | $4 | $4 | $2 |
| Saída padrão | $20 | $20 | $10 |
| Entrada em cache | $0.20 | $0.20 | $0.20 |
| Entrada de contexto longo | $4 | $4 | $4 |
| Saída de contexto longo | $20 | $20 | $15 |
| Entrada em cache (contexto longo) | $0.20 | $0.20 | $0.40 |
A Meta publica $4 entrada, $20 saída e $0.20 de entrada em cache por milhão de tokens. A Anthropic lista o Opus 5.5 em $4 entrada, $20 saída e $0.20 por acertos de cache por milhão de tokens. A tabela de preços da OpenAI lista o GPT-6 Sol em $2/$10 para entrada/saída de curto contexto e $4/$15 para longo contexto; as tarifas de entrada em cache também variam por nível. Aplique o nível de contexto por solicitação relevante, o modo de processamento e as condições do endpoint antes de estimar um workload.
Para o GPT-6 Sol, solicitações contendo mais de 272,000 tokens de entrada são cobradas a tarifas mais altas:
- Tokens de entrada: 2× a tarifa padrão, aumentando de $2 para $4 por milhão de tokens.
- Tokens de entrada em cache: 2× a tarifa padrão, aumentando de $0.20 para $0.40 por milhão de tokens.
- Tokens de saída: 1.5× a tarifa padrão, aumentando de $10 para $15 por milhão de tokens.
Essas tarifas mais altas se aplicam à solicitação inteira, não apenas aos tokens que excedem 272,000. Uma solicitação com 272,001 tokens de entrada, portanto, entra no nível de preços de contexto longo para todos os seus tokens de entrada, entrada em cache e saída.
Em comparação, Muse Wonder e Claude Opus 5.5 não impõem um ágio equivalente para contexto longo em suas tarifas padrão de API.
Essa distinção é particularmente importante para análise de documentos grandes, codificação em nível de repositório e agentes de IA de longa execução, onde a vantagem de preço de curto contexto do GPT-6 Sol pode diminuir à medida que as solicitações ficam maiores.
Preços e condições de faturamento da CometAPI
No momento da análise, a CometAPI listava o Opus 5.5 em $3.20 entrada / $16 saída e o GPT-6 Sol em $1.60 entrada / $8 saída por milhão de tokens. Essas são tarifas independentes da CometAPI e não devem ser confundidas com os preços oficiais dos provedores acima. Confirme a rota aplicável, o nível de contexto e as condições de faturamento da conta antes de estimar o custo; preços e condições podem mudar.
Custo por tarefa aceita
Calcule o custo por tarefa aceita como o gasto total faturado de modelo e ferramenta, incluindo novas tentativas cobradas e fallbacks, dividido pelo número de saídas que atendem a critérios de aceitação predefinidos. Registre o tempo de revisão humana separadamente ou converta-o usando uma taxa de trabalho explícita. Acompanhe solicitações com falha e cobranças reais de forma independente: falha por si só não estabelece se uma solicitação foi cobrada.
Resultado da comparação: GPT-6 Sol tem as menores tarifas padrão listadas de entrada e saída para curto contexto, enquanto Muse Wonder e Opus 5.5 compartilham as mesmas tarifas-base listadas. O custo real por tarefa aceita depende da rota de cobrança selecionada, uso de cache, níveis de contexto, taxas de ferramentas, novas tentativas e esforço de revisão.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Comparação e seleção
Seleção por capacidade e workload
- Para codificação ampla e fluxos de trabalho em terminal, comece com o Claude Opus 5.5 porque ele lidera os resultados citados do Intelligence Index, Terminal-Bench e ProgramBench. Valide refatoração, execução de ferramentas e consistência em nível de programa.
- Para projetos de engenharia estendidos, comece com o Muse Wonder porque seus resultados reportados no DeepSWE e SWE-Marathon são mais fortes que os do Opus 5.5. Meça conclusão de tarefas, recuperação de obstáculos e custo total da tarefa.
- Para agentes pessoais persistentes, comece com o Muse Wonder porque ele oferece Active Memory e Active Focus e tem pontuação maior no MemoryBench do que o Opus 5.5. Teste lembrança, correções, continuidade e isolamento de projetos.
- Para fluxos de trabalho com múltiplas ferramentas, avalie os três modelos. A Meta oferece Active Focus, o Opus enfatiza orquestração de ferramentas e o GPT-6 Sol suporta ferramentas da Responses API. Compare toda a pilha do agente, incluindo permissões de ferramentas, novas tentativas e tratamento de estado.
- Para documentos profissionais e análise, avalie Muse Wonder ou Claude Opus 5.5. O Muse tem pontos fortes especializados, enquanto o Opus tem o índice agregado mais forte citado. Use documentos representativos e critérios de aceitação específicos da tarefa.
- Para automação de alto volume e sensível a custos, comece com o GPT-6 Sol porque ele tem as menores tarifas padrão de curto contexto listadas. Verifique custo por tarefa aceita, níveis de contexto, latência e novas tentativas.
- Para a opção de mais alto nível da Meta, avalie o Muse Wonder Full se ele estiver acessível. Ele tem escores mais altos em várias tarefas especializadas, mas é separado do modelo da API padrão. Confirme o acesso por assinatura e a adequação antes de testar.
Codificação profissional
Claude Opus 5.5 é uma boa opção padrão para equipes que precisam de um assistente de engenharia amplo, particularmente onde execução de ferramentas, refatoração e consistência em nível de programa importam. Suas vantagens reportadas no Terminal-Bench e ProgramBench reforçam esse caso, embora as equipes devam validar a pilha completa do agente e não apenas o modelo.
Automação de alto volume
GPT-6 Sol é atraente quando as solicitações são numerosas e a sensibilidade a custos é alta. Mesmo um pequeno déficit de qualidade pode ser aceitável para tarefas de baixo risco e facilmente verificáveis, como redação de documentação, extração de campos estruturados ou explicação de código. Para execuções autônomas longas, acompanhe qualidade, tokens, latência e novas tentativas em conjunto.
Checklist de avaliação de produção
A avaliação de produção deve acompanhar seis métricas: correção, medida por respostas aceitas ou testes aprovados; confiabilidade, medida por tarefas concluídas sem resgate humano; latência, medida pela duração ponta a ponta da tarefa; uso de tokens, medido pelo total de entrada e saída faturados; eficiência do agente, medida por invocações de ferramentas e novas tentativas corretivas; e custo efetivo, calculado como gasto total dividido por tarefas aceitas.
Resultado da comparação: Priorize o Muse Wonder para comportamento de agente persistente e tarefas de engenharia estendidas, o Opus 5.5 para fluxos de trabalho de codificação amplos com forte demanda de terminal, e o GPT-6 Sol quando o custo de token é uma grande restrição. Promova um candidato apenas depois que ele atender aos limites de qualidade e confiabilidade específicos da tarefa.
Onde acessar Muse Wonder, Claude Opus 5.5 e GPT-6 Sol?
Acesso oficial do provedor
Use Meta Model API para o Muse Wonder padrão, Anthropic API para o Opus 5.5 ou OpenAI API para o GPT-6 Sol. Muse Wonder Full está disponível por meio dos planos de assinatura especificados do Muse Code, e não como um substituto plug-and-play para o modelo de API padrão. Verifique acesso à conta, limites de uso e recursos de solicitação suportados para a rota escolhida.
Acesso pela CometAPI
Um gateway unificado pode simplificar autenticação, faturamento e roteamento. Use um modelo de maior desempenho para revisão de arquitetura complexa e um modelo mais barato para rascunhos repetitivos e de baixo risco. O identificador do modelo e o formato de solicitação suportado devem sempre ser verificados no endpoint da API de destino.
Desenvolvedores podem acessar a API do Claude Opus 5.5 na CometAPI e a API do GPT-6 Sol na CometAPI para avaliar workloads representativos. Confirme a superfície de API suportada para cada modelo, em vez de assumir que um gateway compartilhado torna todos os formatos de solicitação intercambiáveis.
As rotas da CometAPI citadas neste artigo cobrem Opus 5.5 e GPT-6 Sol. Este artigo não estabelece uma rota CometAPI para o Muse Wonder ou o Wonder Full; use a rota do provedor confirmada ao avaliar esses produtos.
Conclusão
Nenhum modelo vence em todo workload. Muse Wonder é o candidato mais forte para testar comportamento de agente persistente e tarefas de engenharia de longa duração. Claude Opus 5.5 é um forte candidato para codificação ampla, fluxos de trabalho intensivos em terminal e trabalho do conhecimento, e lidera o valor do Artificial Analysis Intelligence Index reportado pela Meta. GPT-6 Sol oferece os menores preços padrão de tokens em curto contexto e é atraente para automação sensível a custos. Equipes de produção devem fazer a escolha final usando qualidade de tarefas aceitas, confiabilidade, latência, novas tentativas, uso de ferramentas e custo total em workloads representativos.
FAQ
Como as equipes podem testar de forma justa Muse Wonder, Opus 5.5 e GPT-6 Sol?
Use um conjunto de tarefas reais reservado, com critérios de aceitação fixos, artefatos de entrada idênticos e permissões de ferramentas documentadas. Registre cada versão de modelo, configuração de esforço, harness do agente, timeout e orçamento de tokens. Execute ensaios repetidos onde as saídas variam, reporte falhas assim como sucessos e separe uma comparação em harness comum de uma comparação do sistema melhor configurado. Isso produz evidências que se aplicam ao seu fluxo de trabalho, e não ao setup de benchmark de outra equipe.
Um gateway de API pode preservar o estado do agente ao alternar modelos?
Um endereço de gateway compartilhado não garante por si só estado de conversa portátil, identificadores de chamadas de ferramenta ou referências de respostas armazenadas. Mantenha um registro canônico no lado da aplicação de mensagens, saídas de ferramentas e estado de tarefa validado. Teste o estado e as semânticas de ferramentas de cada rota antes de rotear um job em andamento para outro modelo; caso contrário, um fallback mais barato pode perder informações necessárias para terminar corretamente.
Como as equipes devem orçar novas tentativas e revisão humana?
Defina um resultado aceito antes de testar, depois divida o gasto total faturado de modelo e ferramentas por resultados aceitos. Relate o trabalho de revisão separadamente ou inclua-o usando uma taxa horária declarada. Conte tentativas com falha, chamadas corretivas e modelos de fallback, e compare tarefas típicas e de alto custo. Isso evita tratar um preço de token mais baixo como garantia de redução no custo do trabalho útil.
O que uma avaliação de agente sensível à memória deve incluir?
Teste se o agente recorda fatos relevantes, incorpora correções, ignora instruções obsoletas e mantém projetos separados isolados. Inclua acompanhamentos tardios e atualizações contraditórias, e não apenas um único prompt longo. Verifique o comportamento de memória no nível da aplicação assim como no nível do modelo, porque persistência, recuperação e exclusão dependem do sistema implantado.