
TLDR OpenAI Bel é uma execução interna de pré-treinamento não confirmada (codinome) relatada pela primeira vez no X em 25 de agosto de 2026 por @synthwavedd. A alegação descreve um modelo base concluído com mais de 10 trilhões de parâmetros totais — sucessor de uma execução anterior chamada Doug — destinado a servir de base para sistemas pós-GPT-6 e, potencialmente, um modelo de “limiar de AGI” após mais aprendizado por reforço.
Em 13 de outubro de 2026, a OpenAI nunca utilizou o nome Bel (ou Doug em materiais públicos de produto), não publicou contagem de parâmetros, data de lançamento, benchmarks ou system card, e Bel não está disponível via API ou ChatGPT.
Principais pontos
- Bel se origina de uma única publicação no X de @synthwavedd em 25 de agosto de 2026; a OpenAI nunca o confirmou.
- Escala alegada: >10T parâmetros totais, semelhante em classe de tamanho ao GPT-4.5 segundo a publicação original.
- Posicionado no boato como sucessor de “Doug” e base para sistemas pós-GPT-6/Astra após RL.
- GPT-6 Astra está disponível publicamente desde o início de setembro de 2026 e é o carro-chefe atual da OpenAI.
- Não existem benchmarks independentes, data de lançamento, API, preços ou pesos para Bel.
- Claude Fable 5.5 permanece não anunciado; o Claude topo de linha atual é o Fable 5.1.
- Para uso em produção hoje, encaminhe GPT-6 Astra/Sol/Luna e modelos Claude por uma única chave na CometAPI para menor custo e zero lock-in de fornecedor.
O que é o OpenAI Bel?
OpenAI Bel (às vezes estilizado como “BEL”) é o codinome que circula em discussões da comunidade de IA para uma suposta execução de pré-treinamento em larga escala que a OpenAI teria concluído na segunda metade de agosto de 2026. Segundo o relato original, Bel é um modelo de base bruto — não um produto final — com mais de 10 trilhões de parâmetros totais. É enquadrado como o sucessor de um projeto interno anterior chamado Doug e como a base pretendida que, após aprendizado por reforço adicional e pós-treinamento, poderia alimentar sistemas além do GPT-6 Astra, potencialmente alcançando o que alguns insiders supostamente chamam de nível de capacidade de “limiar de AGI”.
Importante: Bel não é o GPT-7, não é um modelo do ChatGPT com o qual usuários podem conversar e não está disponível via API da OpenAI. É descrito estritamente como um artefato de pré-treinamento — a enorme rede neural treinada em texto (e possivelmente outros dados) que ainda requer extensos ajustes finos, alinhamento e trabalho de segurança antes de se tornar um produto entregável.
Bel é o codinome relatado de um esforço de modelo de base da OpenAI. A alegação é atribuída à publicação de 25 de agosto de 2026 de @synthwavedd sobre um pré-treinamento concluído. A postagem reproduzida alega mais de 10 trilhões de parâmetros totais e uma relação de sucessor com Doug. Esses detalhes permanecem como afirmações de uma única fonte: a captura de tela registra uma alegação, não um resultado de treinamento da OpenAI autenticado.
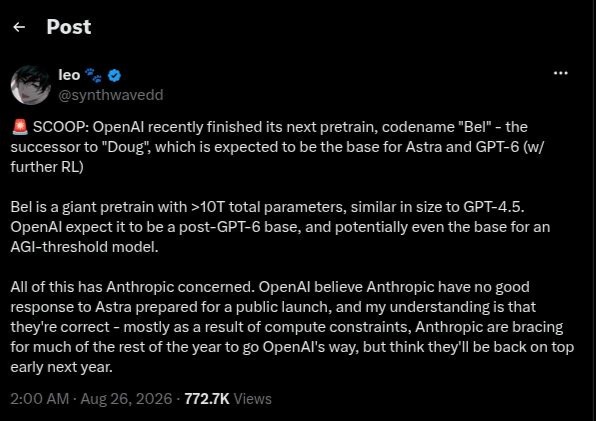
A captura de tela é reproduzida a partir da captura de Mukhtada da publicação atribuída no X. Exibe 26 de agosto às 2h00 no contexto do fuso horário de Jacarta da fonte, correspondendo a 25 de agosto às 19h00 UTC. É uma captura de terceiros, não uma confirmação independente da contagem de parâmetros, do status de treinamento ou de reivindicações competitivas privadas.
Linha do tempo de evidências Doug–Bel
O pano de fundo de Doug é separado: a publicação de 7 de agosto da SemiAnalysis reproduz uma nota de 9 de julho mencionando um modelo maior da OpenAI chamado Doug. Isso antecede a postagem sobre Bel, mas não autentica Doug → Bel nem conecta qualquer codinome a um produto lançado.
- 9 de julho de 2026: Uma nota de pesquisa mencionando um modelo maior da OpenAI chamado Doug foi posteriormente reproduzida no artigo da SemiAnalysis publicado em 7 de agosto. A data da nota e a data de publicação são marcos diferentes; isso é contexto sobre Doug, não confirmação de Bel.
- 7 de agosto de 2026: A SemiAnalysis publicou o artigo reproduzindo a referência a Doug. Ele antecede a alegação sobre Bel, mas não estabelece uma linhagem Doug-para-Bel nem um nome de produto público.
- 25 de agosto de 2026: A publicação atribuída de @synthwavedd alegou pré-treinamento de Bel concluído e mais de 10 trilhões de parâmetros totais. Uma captura de terceiros reproduz a alegação; não é verificação independente.
- 1º de setembro de 2026: O relatório Path to Astra citado neste artigo fornece contexto sobre um programa separado de desenvolvimento de modelos. Não estabelece a identidade de Bel, sua contagem de parâmetros ou uma conexão com o GPT-7 ou um possível nome GPT-6 Bel.
- 23 de setembro de 2026: Um relato circulante atribui uma espera de meses a uma publicação de acompanhamento da mesma conta. Como o texto original não estava diretamente acessível na revisão da fonte, isso permanece como orientação de tempo não verificada e não fornece compromisso de lançamento.
- 12 de outubro de 2026 — ponto de verificação da revisão do artigo: A publicação atribuída sobre Bel, as reportagens sobre Doug e o relatório oficial separado citados aqui não estabelecem uma identidade comercial para Bel. Nem GPT-7 nem GPT-6 Bel são confirmados por esta cadeia de evidências; esta data registra a revisão do artigo, não um anúncio de modelo.
Por volta do mesmo período, a OpenAI discutiu publicamente um modelo interno sem nome “significativamente mais capaz do que o GPT-6 Astra” em conexão com trabalho matemático (incluindo resultados relacionados às equações de Navier-Stokes).
Duas hipóteses de nomenclatura: GPT-7 ou GPT-6 Bel?
Pré-treinamento e lançamento de produto são marcos diferentes. Um checkpoint de base ainda pode exigir instrução, aprendizado por reforço, avaliação de segurança, treinamento para uso de ferramentas e otimização de serving. Vários produtos podem derivar de uma mesma base, e uma versão pública não identifica uma execução de treinamento. O relatório Path to Astra fornece o pano de fundo oficial de aprendizado por reforço, sem estabelecer a identidade de Bel.
Hipótese 1 — GPT-7: Se Bel representar uma base materialmente nova além da geração GPT-6, a OpenAI poderia comercializar um modelo dele derivado como GPT-7. Essa interpretação depende de uma nova geração de capacidades e de uma decisão pública de nomenclatura; nem a contagem de parâmetros alegada nem a conclusão de pré-treinamento relatada estabelecem esse desfecho.
Hipótese 2 — GPT-6 Bel: A OpenAI poderia, em vez disso, manter um produto derivado de Bel dentro da família GPT-6, potencialmente usando um rótulo como GPT-6 Bel para uma oferta atualizada ou especializada. Este é um cenário de nomenclatura editorial para comparação, não um produto anunciado nem um vazamento com fonte independente. Um codinome interno não necessariamente aparece no nome comercial.
O que permanece em aberto: O mesmo esforço de treinamento pode sustentar vários produtos, outro nome ou nenhum lançamento público. A linha do tempo fornece contexto para ambas as interpretações, mas não pode escolher entre elas. A confirmação exigiria documentação vinculando o esforço de treinamento de Bel a um modelo público real e seu nome.
OpenAI Bel comparado à geração anterior: o que melhora?
Como faltam detalhes técnicos concretos sobre Bel, qualquer discussão de melhorias deve se basear em (1) as alegações de alto nível do vazamento, (2) a trajetória conhecida de GPT-4o → GPT-5.x → GPT-6 Astra e (3) as capacidades demonstradas pelo modelo interno sem nome usado para trabalho científico em escala de Navier-Stokes. Cada área potencial de melhoria é tratada separadamente abaixo.
Escala e computação de pré-treinamento
A alegação central é um salto além das execuções internas anteriores para o regime de >10T parâmetros. Se correta, isso representaria adesão contínua às leis de escala em dados, parâmetros e computação. Confirmado: a OpenAI continuou realizando grandes execuções de treinamento e referenciou publicamente modelos mais capazes do que o Astra. Não confirmado: qualquer contagem específica de parâmetros, FLOPs de treinamento, mistura de dados ou mudanças de arquitetura (densa vs. mixture-of-experts, atenção nova etc.). Expectativa realista com base no histórico: melhor eficiência amostral e cobertura de conhecimento mais ampla, mas retornos decrescentes sem avanços correspondentes em pós-treinamento e qualidade de dados.
Pós-treinamento e alinhamento para agência de longo horizonte
GPT-6 Astra já melhorou substancialmente fluxos de trabalho em múltiplas etapas, uso de computador e manutenção dentro dos limites da tarefa. Uma base mais forte, somada a mais RL, poderia levar a operação agentiva confiável de horas para horizontes de vários dias ou semanas, com menos direção humana. O experimento multiagente de Navier-Stokes (milhares de agentes coordenando) demonstra que a OpenAI já opera em escala de enxame de agentes em problemas difíceis. Direção de capacidade confirmada: sim. Contribuição específica de Bel: não confirmada.
Raciocínio científico e matemático
Astra em si contribuiu para o progresso matemático; o modelo interno mais forte produziu um resultado formalizado em um problema do Prêmio Millennium. Uma base maior e melhor treinada poderia comprimir ainda mais o tempo e o custo de explorar espaços de busca difíceis em STEM. Confirmado: a OpenAI está investindo pesado aqui. Específico de Bel: não confirmado.
Uso de computador, uso de ferramentas e confiabilidade multimodal
Astra estabeleceu novas marcas em benchmarks de uso de computador e de navegador. Espera-se que bases futuras reduzam taxas de erro em trajetórias longas, melhorem o grounding visual e lidem com ambientes de software mais complexos. Especulativo, mas direcionalmente consistente com o roadmap do produto.
Eficiência, velocidade de inferência e custo
Mesmo que a base seja maior, destilação, arquiteturas melhores e silício personalizado (a OpenAI discutiu seus próprios ASICs) ainda poderiam entregar custo/desempenho utilizável. Não existem alegações específicas de eficiência para Bel.
Quando OpenAI Bel ou GPT-7 podem ser lançados?
Não há data oficial de lançamento para Bel ou um GPT-7 derivado de Bel estabelecida pelas fontes revisadas. Um relato circulante do acompanhamento de 23 de setembro de @synthwavedd descrevendo uma espera de meses é atribuído à mesma fonte não oficial do vazamento original. Seu texto completo não estava diretamente acessível durante esta revisão, portanto não deve ser usado para prever uma janela de lançamento. Pré-treinamento concluído, se for o caso, ainda poderia ser seguido por pós-treinamento, avaliações, trabalho de serving e implantação em fases.
| Cenário | O que aconteceria | O que isso implica |
|---|---|---|
| Conclusão mais rápida | As avaliações e a implantação restantes são concluídas relativamente rápido | Um sucessor poderia chegar mais cedo |
| Desenvolvimento estendido | Mais treinamento, mitigação e trabalho de serving são necessários | O cronograma se desloca mais para frente |
| Implantação alternativa | A base alimenta sistemas especializados ou com marca diferente | Não há necessariamente um produto chamado Bel |
O hipotético Fable 5.5 não tem cronograma verificado nas fontes revisadas, portanto uma previsão de ordem de lançamento não é suportada.
Bel poderia mudar o equilíbrio entre OpenAI e Anthropic?
Três resultados plausíveis permanecem em aberto. Primeiro, Bel poderia introduzir um salto amplo no pré-treinamento e melhorar sistemas subsequentes de codificação e raciocínio. Segundo, a vantagem poderia ser estreita, com outros provedores mantendo vitórias em confiabilidade de agentes, latência ou custo. Terceiro, a escala enorme relatada poderia não se traduzir em ganhos práticos proporcionais. Até que existam evidências reproduzíveis, o enquadramento correto é o de uma possível resposta competitiva, e não de um vencedor declarado.
Recomendações práticas para desenvolvedores e equipes (CometAPI)
Enquanto o setor aguarda qualquer confirmação oficial de Bel ou do próximo grande modelo base da OpenAI, sistemas de produção precisam de acesso confiável aos modelos que realmente existem hoje. A CometAPI fornece um único endpoint compatível com OpenAI (https://api.cometapi.com/v1) e uma única chave de API que alcança 500+ modelos, incluindo toda a família GPT-6 atual (Astra, Sol, Luna e atualizações) e a linha Claude da Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5 etc.).
Conclusão
A fronteira da IA continua avançando rapidamente. Bel pode, em última análise, provar ser um marco interno importante, um codinome mal reportado ou algo entre os dois. Até que a OpenAI publique informações concretas, a postura responsável é tratar as alegações como não verificadas enquanto se extrai o máximo valor dos modelos que já estão disponíveis — e manter a infraestrutura flexível o suficiente para incorporar a próxima geração no momento em que se tornar real. Para muitas equipes, essa flexibilidade é mais facilmente alcançada hoje por meio de uma plataforma unificada como a CometAPI.