
TL;DR
OpenAI Decisions API e TypeSafe Jev retornam decisões limitadas, apoiadas por probabilidades, em vez de prosa gerada comum. A OpenAI usa GPT-6 Luna por meio de um endpoint dedicado; Jev é um modelo System One especializado. Jev é mais barato nas tarifas publicadas por token de entrada ($0.042 versus $0.10 por milhão), enquanto a OpenAI tem suporte nativo a imagens. As cifras dos fornecedores aqui analisadas não estabelecem um vencedor em precisão ou velocidade em comparação direta.
Key Takeaways
- Preços: Jev é 58% mais barato por token de entrada nas tarifas base publicadas.
- Arquitetura: OpenAI Decisions API usa GPT-6 Luna; Jev é desenvolvido especificamente para processamento de decisões.
- Modalidade: OpenAI suporta texto e imagens; Jev foca em texto e entrada estruturada.
- Benchmarks: As alegações de velocidade usam bases diferentes; compare no mesmo conjunto rotulado.
- Seleção: Priorize suporte multimodal e integração com OpenAI, ou throughput de texto e custo, conforme sua aplicação.
At Glance: OpenAI Decisions API vs Jev
A visão geral abaixo compara os endpoints de decisão documentados e as tarifas base publicadas, verificadas em 12 de outubro de 2026. Acesso ao modelo, limites e termos de serviço devem ser verificados para a conta de implantação.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (probabilidade da condição), choice (categoria), score (rúbrica) | Noul (probabilidade da condição), choice (categoria), score (níveis) |
| Request questions | Array com nomes | Objeto indexado por ID |
| Context limit | Não especificado no guia de Decisions vinculado | 64K total; state + pergunta mais longa ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | Sem cobrança | Sem cobrança |
| Vendor speed statement | Cerca de 10× mais rápido que Responses API | 70–500 ms fim a fim |
| Availability | Beta público | Acesso antecipado no anúncio; verifique o acesso da sua conta |
| Distinct advantage | Decisões baseadas em imagem | Menor custo de entrada publicado |
| Generative reasoning / coding | Não é o contrato de saída deste endpoint | Não é o contrato de saída deste endpoint |
Muitos fluxos de trabalho de IA precisam de uma categoria, probabilidade ou pontuação — não de um parágrafo. Um ticket de suporte precisa de roteamento; um agente precisa selecionar uma ação aprovada; uma fila de revisão precisa identificar entradas incertas. Ambos os produtos tornam tais decisões saídas de API de primeira classe.
A OpenAI lançou o Decisions API em beta em 6 de outubro de 2026 (https://developers.openai.com/api/docs/changelog). Seu endpoint GPT-6 Luna aceita texto e imagens. Jev é o modelo System One especializado da TypeSafe AI para avaliação não generativa, com uma abordagem de treinamento descrita como Reinforcement Learning for Calibrated Decisions (RLCD) (https://docs.typesafe.ai/introduction/machine-learning-primer).
Os tipos de pergunta na tabela cobrem três tarefas comuns. O predicate da OpenAI e o noul do Jev (https://docs.typesafe.ai/api) estimam se uma condição é verdadeira, como intenção de reembolso ou elegibilidade. Choice seleciona entre categorias predefinidas, como Billing, Technical e Shipping, para roteamento. Score avalia uma entrada conforme uma rúbrica ou níveis, como urgência ou prioridade. Essas descrições consolidam as duas visões gerais de produto; os esquemas de requisição e a semântica de probabilidade ainda exigem tratamento específico do provedor.
What is OpenAI Decisions API and Jev?
OpenAI Decisions API e TypeSafe Jev são serviços de IA focados em decisões projetados para transformar dados de entrada em saídas estruturadas e limitadas, em vez de texto aberto. Diferente de modelos de linguagem tradicionais que geram explicações ou respostas conversacionais, essas APIs avaliam perguntas predefinidas e retornam decisões, probabilidades ou pontuações. Isso as torna especialmente úteis para fluxos de trabalho automatizados como roteamento de solicitações de clientes, classificação de conteúdo, avaliação de risco e seleção de ferramentas por agentes de IA, onde saídas previsíveis e processamento eficiente são essenciais.
OpenAI Decisions API é alimentada por GPT-6 Luna e opera pelo endpoint /v1/decisions. Ela suporta entradas de texto e imagem, com três tipos de decisão: predicate, choice e score. Sua principal vantagem é combinar o entendimento contextual de um modelo de IA de uso geral com uma interface dedicada a decisões, tornando-a adequada para classificação multimodal e aplicações já integradas ao ecossistema da OpenAI.
TypeSafe Jev, em contraste, é um modelo de decisão especializado acessado pelo endpoint /v1/systemone. Ele foca na avaliação baseada em texto usando três tipos de pergunta: noul, choice e score. Jev enfatiza inferência eficiente, previsões estruturadas e calibração de probabilidade, tornando-o uma opção atraente para classificação em alto volume e pipelines de decisão automatizada. Embora ambos os serviços abordem problemas semelhantes, suas diferenças em arquitetura, capacidades de entrada, preços e design de API podem influenciar significativamente qual é mais adequado a uma aplicação específica.
Model Approach, Input Limits, and Scope
A comparação diz respeito ao comportamento documentado da API e ao posicionamento do produto. A OpenAI expõe GPT-6 Luna por meio de um endpoint de decisão, enquanto a TypeSafe posiciona o Jev como um modelo System One especializado. Essas descrições por si só não estabelecem uma vantagem de precisão nem revelam todos os detalhes de implementação.
Jev permite 64K tokens em toda a requisição, com um limite separado de 32K para state mais a pergunta mais longa. Conte as instruções e critérios das perguntas, bem como a entrada compartilhada. O guia de Decisions da OpenAI vinculado não informa um limite numérico de contexto separado para esse endpoint; verifique os limites aplicáveis em vez de assumir que a janela de contexto de um modelo geral se aplica sem mudanças.
Benchmarks de raciocínio generativo e de codificação estão fora do escopo desses endpoints de decisão limitados. Para geração de explicações ou de código, avalie um endpoint generativo adequado separadamente. Resultados do modelo de uso geral subjacente não estabelecem desempenho para o endpoint de Decisions.
Accuracy and Latency
Os materiais citados dos fornecedores não fornecem um teste pareado que estabeleça um vencedor em precisão ou latência. A declaração de ~10× mais velocidade da OpenAI compara Decisions com sua Responses API. A TypeSafe reporta 70–500 ms de latência fim a fim e afirma que suas avaliações publicadas geralmente rodaram em um laptop no oeste dos Estados Unidos.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | Nenhum teste pareado nas fontes citadas | Nenhum teste pareado nas fontes citadas | Sem vencedor |
| Speed | Alegação relativa do fornecedor | Faixa absoluta do fornecedor | Não diretamente comparável |
| Calibration | Probabilidades; confiança separada para choice/score | Probabilidades; confiança derivada para choice/score | Teste a calibração observada |
| Text categorization | Suportado | Suportado | Ambos viáveis |
| Visual categorization | Imagens nativas | Sem imagens nativas | Vantagem da OpenAI |
Probability Calibration and Review Thresholds
Um modelo pode ser preciso, mas mal calibrado. Entre previsões com probabilidade 0.90 para a classe selecionada, aproximadamente 90% devem estar corretas se essa probabilidade estiver calibrada na distribuição de avaliação. Não substitua um campo de API chamado confidence por essa probabilidade sem verificar sua definição. Jev deriva sua confiança de Choice da distribuição de probabilidade: confidence = (p_max − 1/n) / (1 − 1/n), onde n é o número de escolhas. Seu resultado Noul não possui campo de confiança separado. Meça ECE e Brier score a partir das probabilidades apropriadas, junto com precisão, recall e F1 macro; escolha limiares de revisão com base em exemplos rotulados.
Pricing and Cost per Accepted Decision
A OpenAI lista $0.10 por milhão de tokens de entrada para /v1/decisions; Jev lista $0.042 por milhão de tokens de entrada. Ambos listam zero cobrança por tokens de saída para esses serviços de decisão. Nessas tarifas base, Jev é 58% mais barato por token de entrada. Prêmios regionais de processamento e multiplicadores de contexto longo da OpenAI podem se aplicar; novas tentativas, pré-processamento e revisão podem adicionar custos ao fluxo.
Suponha que cada requisição use 500 tokens de entrada faturáveis em ambos os serviços. Estes são cálculos ilustrativos, não faturas de fornecedores.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Custo por decisão correta aceita = (gasto com API + gasto com novas tentativas + gasto com revisão humana) / número de decisões corretas aceitas. Uma tarifa baixa por token pode ser compensada por uma taxa mais alta de roteamentos incorretos ou escalamentos.
Para um fluxo convencional com GPT-6 Luna, a tabela de preços de modelos da CometAPI lista as seguintes tarifas em USD por milhão de tokens, verificadas em 12 de outubro de 2026. São tarifas por modelo/endpoint; a página vinculada mostra um exemplo da Responses API e não estabelece suporte nativo a /v1/decisions nem seus preços.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Os tokens de saída do GPT-6 Luna convencional na CometAPI são cobrados. Mantenha essa estimativa separada dos dois serviços de decisão acima, cujos tokens de saída publicados têm custo zero. Por exemplo, 500 tokens de entrada mais 20 tokens de saída custam $0.000048 por requisição de contexto curto, ou $48 por milhão de requisições, antes de outras cobranças. Confirme o nível aplicável e a tarifa da conta no catálogo de modelos ao vivo antes de orçar.
Agent Workflows and Modality Tradeoffs
Ambos podem rotear uma chamada de ferramenta, avaliar se uma condição de guarda é atendida ou pontuar uma ação. Nenhum substitui autorização, validação de entrada ou permissões explícitas de ferramentas. Para automação visual, o suporte nativo a imagens da OpenAI simplifica o pipeline; para roteamento puramente textual, o menor custo base do Jev pode ser atraente.
O tratamento de saída difere na fronteira da resposta. A OpenAI retorna um array answers, com names identificando as perguntas; Jev retorna um objeto answers indexado pelo ID da pergunta. Normalize essas estruturas antes de aplicar regras de negócio compartilhadas. Jev deriva confidence de sua distribuição de probabilidade; não presuma que campos com nomes idênticos tenham significados equivalentes entre fornecedores. Valide rótulos e calibre limiares de revisão com dados da aplicação.
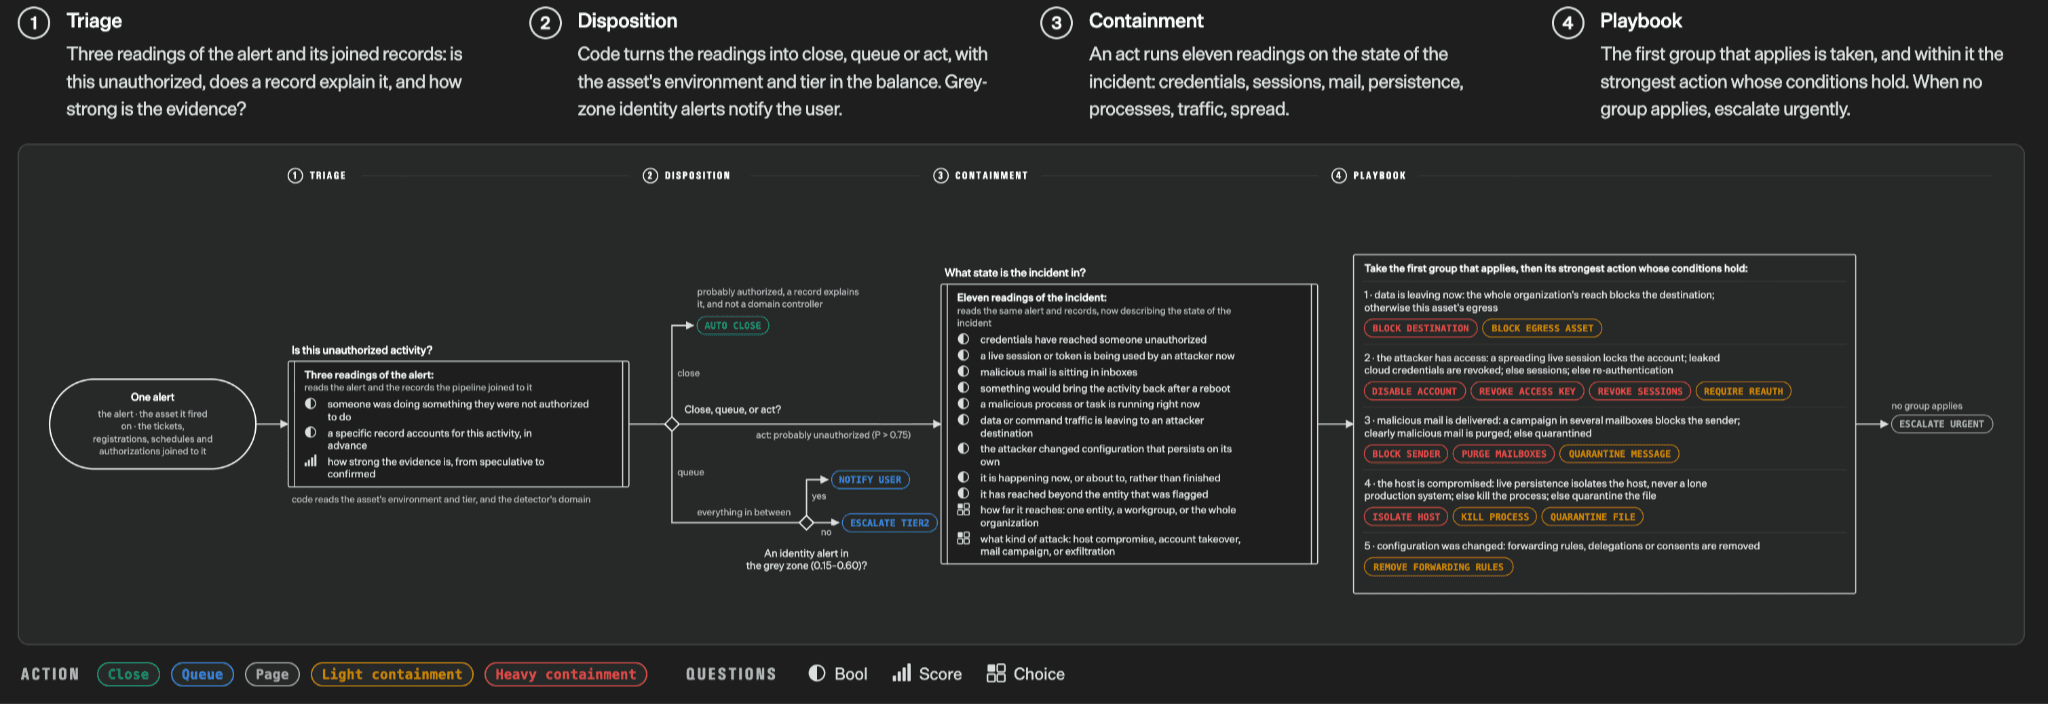
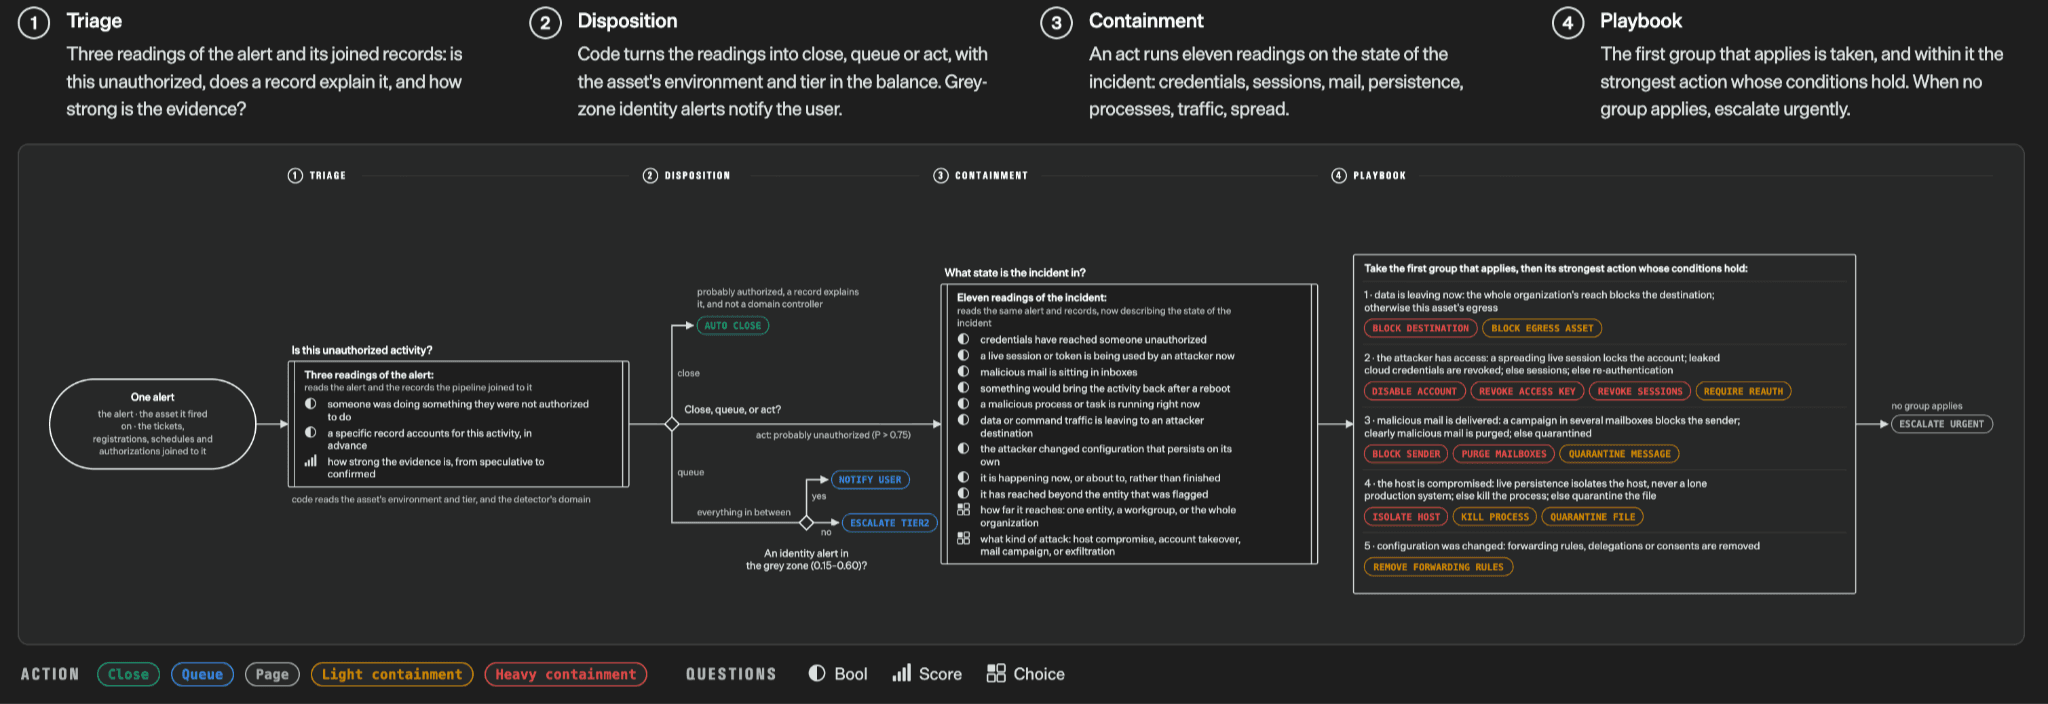
Fonte: Introducing System One Models & Jev; imagem original. Isto ilustra a composição do fluxo, não um benchmark pareado contra a OpenAI Decisions API.
How API Usage Differs: OpenAI Decisions API vs Jev
O acesso deve ser configurado separadamente para cada fornecedor: cada exemplo abaixo usa seu próprio host e chave de API. A OpenAI documenta Decisions como um endpoint em beta público. Para o Jev, confirme o acesso e as credenciais atuais com a TypeSafe antes da implantação. Para qualquer serviço, verifique permissões da conta, disponibilidade regional, cotas e termos de serviço; um exemplo de requisição não garante acesso em produção. O acesso de terceiros a um modelo generativo não confirma por si só suporte ao endpoint nativo de decisão.
How to use OpenAI Decisions API
Os conceitos se sobrepõem, mas os esquemas de requisição diferem. A OpenAI envia input e um array de perguntas nomeadas; o Jev usa state e um objeto questions indexado por ID. Implemente um adaptador específico do provedor antes de aplicar uma política de decisão compartilhada.
Route a support ticket with OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
How to use Jev API
A requisição cURL a seguir usa o endpoint System One do Jev para classificar um ticket de suporte. Defina TYPESAFE_API_KEY no seu ambiente, coloque o ticket em state e defina department dentro do objeto questions. Seu mapa criteria lista os rótulos de roteamento permitidos e suas descrições. Após a requisição ser bem-sucedida, leia a entrada department em answers e valide o rótulo selecionado antes de rotear o ticket. Confirme que o identificador do modelo está disponível para sua conta.
Route a support ticket with TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Objeto indexado |
| Question ID | name | Chave do objeto |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Shared Review Policy for Selected-Class Probabilities
Aplique um limiar explicitamente calibrado à probabilidade da classe selecionada.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Este exemplo em Python 3.10+ é uma camada de política da aplicação, não um parser de resposta de API. Cada adaptador de provedor deve validar a resposta e extrair a probabilidade da classe selecionada. Não passe o campo confidence bruto do Jev como selected_probability. Forneça um limiar calibrado para esse provedor, pergunta e conjunto de avaliação; trate recusas e erros de transporte antes de chamar a política.
OpenAI Decisions API vs Jev: How to choose
Escolha em duas etapas. Primeiro, faça um filtro por requisitos de implantação: entrada de imagem, acesso à conta, limites de entrada e esforço de integração. Depois, faça benchmark dos serviços elegíveis no mesmo trabalho rotulado. Para roteamento apenas de texto, teste se o menor preço publicado por entrada do Jev se traduz em menor custo total; para decisões dependentes de imagem, avalie o caminho nativo de imagem da OpenAI. Compare roteamentos incorretos, calibração, latência de cauda, novas tentativas e revisão humana em um alvo de qualidade acordado. A tabela abaixo é uma shortlist inicial, não evidência de um vencedor geral de desempenho.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Suportado | Suportado | Faça benchmark do Jev primeiro pelo custo |
| Text categorization | Suportado | Suportado | Compare a calibração |
| Screenshot inspection | Nativo | Requer pré-processamento de visão | OpenAI |
| Agent tool selection | Suportado | Suportado | Meça resultados fim a fim |
| Multimodal moderation | Texto e imagens | Apenas texto | OpenAI |
| Existing OpenAI stack | Nativo | Nova integração | OpenAI |
Para automação de negócios em alto volume, como roteamento de suporte e classificação de texto, vale priorizar o Jev quando custo de entrada e throughput são fatores-chave. Para aplicações multimodais, incluindo inspeção de screenshots, moderação visual e decisões baseadas em imagem, a OpenAI Decisions API é a opção mais prática devido ao suporte nativo a imagens. Para agentes de IA e fluxos corporativos, a escolha depende da infraestrutura existente, complexidade de integração e das consequências de decisões incorretas. A OpenAI pode oferecer um caminho mais suave para equipes que já usam seu ecossistema, enquanto o Jev merece consideração para cargas de trabalho de texto em grande escala. Em todos os cenários, a decisão final deve se basear em precisão medida, calibração de probabilidade, latência e custo operacional total, e não apenas em preços de vitrine.
How Should You Benchmark OpenAI Decisions API Against Jev?
Execute ambos os serviços no mesmo conjunto real de entradas rotuladas, com definições de pergunta e regiões de cliente combinadas. Acompanhe precisão, F1 macro, ECE, Brier score, latência p50/p95/p99, timeouts, recusas, taxa de revisão e custo em dólares por decisão correta aceita.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Qualidade dos rótulos |
| Calibration | ECE, Brier score | Confiabilidade das probabilidades |
| Latency | p50 / p95 / p99 | Capacidade operacional |
| Reliability | Taxa de 429 / timeout / recusa | Comportamento em produção |
| Economics | Custo por decisão correta aceita | Despesa operacional real |
Procedimento sugerido: construa um conjunto rotulado representativo; inclua casos ambíguos e fora de distribuição; envie tarefas semanticamente idênticas; repita requisições o suficiente para medir variância; calibre os limiares de cada sistema de forma independente; e compare o custo fim a fim incluindo escalonamento e novas tentativas.
Conclusion
Escolha a OpenAI Decisions API quando a decisão depende de evidência visual ou quando uma integração existente com a OpenAI reduz o trabalho de implantação. Avalie o Jev para cargas de trabalho de decisão apenas em texto nas quais sua tarifa publicada mais baixa por token de entrada pode reduzir os gastos de inferência. Meça a qualidade dos rótulos, calibração, latência de cauda e carga de revisão nos mesmos dados da aplicação antes de escolher.
Jev tem o menor preço base publicado por token de entrada; a OpenAI Decisions API tem entrada nativa de imagens. As cifras dos fornecedores citadas não estabelecem um vencedor geral em precisão ou velocidade. A melhor escolha depende do custo e da qualidade das decisões aceitas no fluxo completo.
Desenvolvedores podem usar a GPT-6 Luna API na CometAPI para prototipar classificação leve em um fluxo multimodelo mais amplo. A página do modelo vinculada fornece um exemplo de Responses API. O acesso a esse endpoint generativo não estabelece suporte para o endpoint dedicado /v1/decisions. Este é um protótipo convencional de geração de texto. Ele não retorna o esquema nativo de resposta de Decisions nem uma distribuição de probabilidade calibrada por classe. Valide o rótulo retornado contra as categorias permitidas e trate erros de API antes de conectá-lo a ações downstream. Confirme separadamente o suporte nativo a /v1/decisions caso esse endpoint seja necessário.